Bahasa Indonesia
Biaya Inferensi dan Margin Kotor di Perusahaan AI
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Perangkat lunak tradisional memiliki satu keistimewaan yang menguntungkan: setelah produk selesai dibangun, melayani satu pelanggan tambahan hampir tidak memerlukan biaya. Itulah sebabnya margin kotor perangkat lunak menjadi hal yang dikagumi investor. Produk AI mematahkan keistimewaan itu. Setiap kali pelanggan meminta produk melakukan sesuatu, sebuah model dijalankan, dan menjalankan model membutuhkan uang sungguhan. Biaya itu disebut inferensi, dan inilah alasan terbesar mengapa margin kotor perusahaan AI bisa sama sekali tidak mirip dengan margin perusahaan perangkat lunak klasik.
Artikel ini menjelaskan mekanismenya. Apa itu inferensi, mengapa ia berperilaku seperti biaya variabel, bagaimana biaya satu permintaan berubah menjadi angka margin, mengapa segelintir pengguna berat dapat merusak rata-rata, dan bagaimana model harga Anda menentukan siapa yang menanggung risikonya. Artikel ini ditulis untuk founder dan CEO pemilik perusahaan B2B yang memiliki tim. Contoh perhitungannya menggunakan angka bulat dan hipotetis, serta tidak mencerminkan harga model nyata mana pun.
Untuk cara biaya ini diklasifikasikan dalam laporan laba rugi, lihat cara perusahaan AI mencatat COGS. Untuk cara menguranginya, lihat manajemen biaya model AI. Tulisan ini berfokus pada cara kerja biaya dan bagaimana biaya itu sampai ke margin.
Pelatihan versus inferensi
Ada dua aktivitas berbeda yang mengonsumsi komputasi dalam bisnis AI, dan keduanya berperilaku sangat berbeda.
Pelatihan adalah membangun atau mengadaptasi model. Ini terjadi sebelum (atau secara berkala bersamaan dengan) melayani pelanggan. Biayanya mahal, tidak merata, dan sebagian besar tidak bergantung pada berapa banyak orang yang menggunakan produk Anda. Jika Anda membangun model sendiri, satu putaran pelatihan lebih mirip proyek pengembangan daripada biaya untuk menyampaikan sebuah penjualan.
Inferensi adalah menjalankan model yang sudah dilatih untuk menghasilkan jawaban. Ini terjadi setiap kali pelanggan melakukan suatu tindakan. Jika Anda melakukan fine-tuning pada model atau memanggil model milik pihak lain, pembagian yang sama berlaku: membangun kemampuan adalah satu biaya, dan melayaninya adalah biaya lain.
Perbedaan ini penting karena keduanya berskala pada sumbu yang berbeda. Biaya pelatihan berskala sesuai seberapa ambisius modelnya. Biaya inferensi berskala sesuai seberapa banyak pelanggan Anda menggunakannya. Startup yang menjual produk AI ke lebih banyak pelanggan, atau membuat pelanggan yang sudah ada lebih sering menggunakannya, tidak menambah tagihan pelatihannya. Yang bertambah adalah tagihan inferensinya, hampir satu banding satu.
Itulah sebabnya inferensi adalah biaya yang muncul di margin kotor. Biaya ini timbul dalam tindakan menyampaikan produk, dan naik ketika penyampaian meningkat.
Mengapa inferensi berperilaku seperti biaya variabel
Dalam produk perangkat lunak klasik, biaya marginal sebuah permintaan hanyalah angka pembulatan. Anda membayar server dalam satuan besar, dan lalu lintas mengisi satuan-satuan itu. Dalam produk AI, setiap permintaan menjalankan potongan komputasinya sendiri, dan ukuran potongan itu bergantung pada isi permintaannya. Beberapa hal menentukannya.
Token masuk dan token keluar. Model bahasa membaca dan menulis teks dalam satuan kecil yang disebut tokens. Pertanyaan pendek dengan jawaban pendek itu murah. Dokumen panjang dengan ringkasan panjang tidak. Penyedia maupun pengaturan yang di-hosting sendiri cenderung memperlakukan sisi membaca (masukan) dan sisi menulis (keluaran) secara berbeda, dan keluaran yang panjang umumnya lebih mahal untuk dihasilkan dibandingkan biaya membaca masukan dengan jumlah yang sama.
Panjang konteks. Banyak produk menjejalkan materi tambahan ke dalam setiap permintaan: percakapan sejauh ini, dokumen yang diambil, instruksi, contoh. Konteks itu dibaca ulang setiap kali. Obrolan yang sudah berjalan dua puluh giliran lebih mahal per pesan dibandingkan pesan pertama, karena seluruh riwayatnya ikut terbawa.
Ukuran model. Model yang lebih besar dan lebih mampu lebih mahal per token dibandingkan model yang lebih kecil. Memilih satu model untuk setiap tugas adalah desain paling sederhana dan sering kali paling mahal.
Langkah penalaran. Sebagian model menghabiskan token tambahan untuk "berpikir" sebelum menjawab. Token berpikir itu biasanya termasuk dalam yang Anda bayar, meskipun pelanggan tidak pernah melihatnya. Pertanyaan yang sulit dapat menghasilkan token berkali-kali lipat lebih banyak daripada yang tersirat dari jawaban yang terlihat.
Siklus agen. Agen AI tidak menjawab sekali saja. Ia merencanakan, memanggil alat, membaca hasilnya, memutuskan langkah berikutnya, dan mengulanginya. Setiap putaran adalah satu panggilan model lagi, dan setiap panggilan membaca ulang konteks yang terus bertambah. Tim engineering Anthropic, saat menjelaskan sistem riset multi-agen miliknya, melaporkan bahwa agen biasanya menggunakan sekitar 4 kali lebih banyak token dibandingkan interaksi obrolan, dan sistem multi-agen sekitar 15 kali lebih banyak. Itu adalah data satu perusahaan tentang satu jenis beban kerja, jadi perlakukan rasio tersebut sebagai ilustrasi seberapa tajam biaya bisa naik ketika Anda beralih dari menjawab ke bertindak, bukan sebagai pengali universal.
Pengulangan dan kegagalan. Ketika sebuah keluaran gagal dalam pemeriksaan, ditolak oleh validator, atau panggilan alat mengalami galat, produk sering kali mencoba lagi. Setiap pengulangan membutuhkan biaya yang sama dengan percobaan awal. Produk dengan tingkat pengulangan 10% menanggung belanja inferensi sekitar 10% lebih besar daripada yang tersirat dari "jalur idealnya".
Gabungkan semua ini dan Anda akan melihat mengapa dua tindakan yang tampak identik di antarmuka produk Anda, misalnya "jalankan analisis," dapat berbeda biayanya sepuluh atau seratus kali lipat. Untuk pembahasan lebih dalam tentang pengendalian biaya khusus pada sistem agen, lihat optimasi biaya agen AI.
Bagaimana biaya per permintaan menjadi margin kotor
Margin kotor adalah pendapatan dikurangi biaya langsung untuk menyampaikan produk, dibagi pendapatan. Bagi perusahaan AI, inferensi adalah biaya langsung terbesar dalam pengurangan itu, biasanya ditambah hosting, pemantauan, dan dukungan pelanggan. Referensi kami tentang margin kotor membahas rumus umumnya. Di sini kita hanya membutuhkan bentuk hubungannya.
Jika pendapatan per pelanggan Anda tetap dan biaya inferensi per pelanggan bervariasi sesuai penggunaan, maka margin kotor bervariasi per pelanggan. Margin bukanlah sifat produk. Margin adalah sifat produk dikalikan cara setiap pelanggan menggunakannya, pada harga tertentu.
Hal itu memiliki konsekuensi praktis. Anda tidak dapat membaca angka margin gabungan dan langsung mengetahui apakah bisnisnya sehat. Margin gabungan 70% bisa berarti sebagian besar pelanggan berada di 80% dan beberapa berada di 20%. Atau bisa juga berarti semua pelanggan berada di sekitar 70%. Kedua perusahaan itu memiliki risiko yang sangat berbeda, dan hanya yang pertama memiliki masalah pengguna berat.
Contoh perhitungan dengan angka ilustratif
Mari kita susun satu contoh. Setiap angka di sini hipotetis dan bulat. Tidak ada yang merupakan harga nyata.
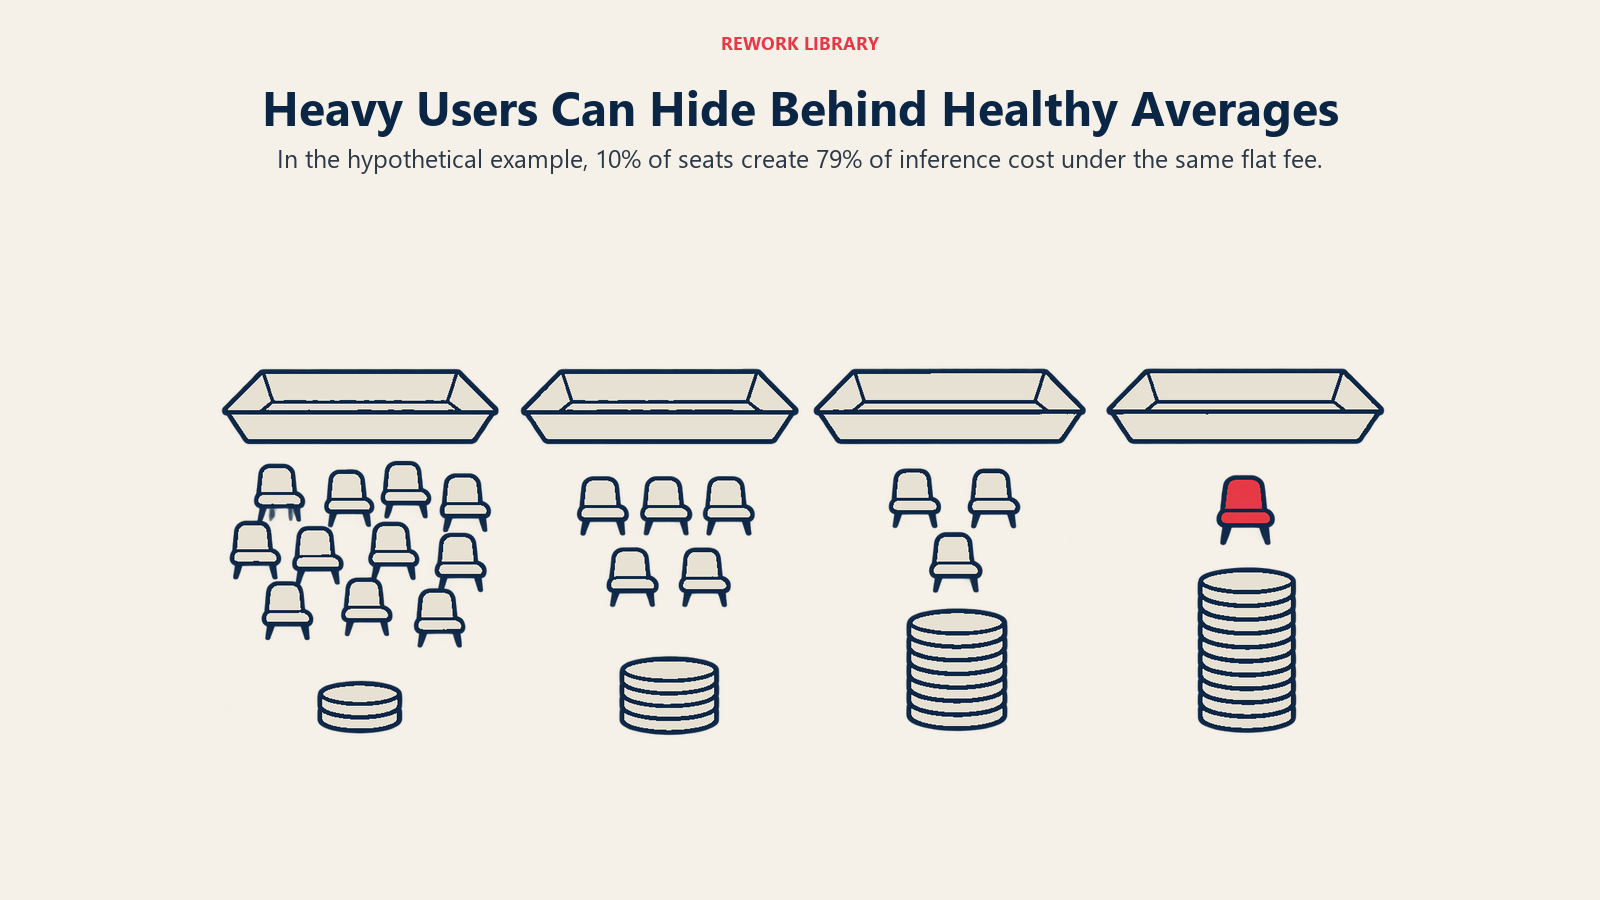
Misalkan Anda menjual asisten AI dengan harga tetap $30 per seat per bulan. Asumsikan satu permintaan membutuhkan biaya inferensi 1 sen. Anda memiliki 100 seat, dan penggunaannya tidak merata, seperti yang hampir selalu terjadi:
| Kelompok pelanggan | Seat | Permintaan per seat per bulan | Biaya inferensi per seat | Total biaya inferensi |
|---|---|---|---|---|
| Ringan | 60 | 50 | $0,50 | $30 |
| Sedang | 30 | 400 | $4,00 | $120 |
| Berat | 9 | 4.000 | $40,00 | $360 |
| Ekstrem | 1 | 20.000 | $200,00 | $200 |
| Total | 100 | $710 |
Pendapatan adalah 100 seat dikali $30, yaitu $3.000. Inferensi adalah $710. Dengan mengabaikan semua biaya lain, margin kotor adalah (3.000 dikurangi 710) dibagi 3.000, atau sekitar 76%.
Tampak sehat. Sekarang lihat bagian dalamnya.
- Masing-masing dari 60 seat ringan menghasilkan margin sekitar $29,50.
- Masing-masing dari 9 seat berat merugi $10, karena inferensi senilai $40 melampaui $30 yang mereka bayar.
- Satu seat ekstrem merugi $170.
- Ke-10 seat berat dan ekstrem itu (10% pelanggan) menghasilkan $560 dari biaya $710, yaitu sekitar 79% dari seluruh belanja inferensi.
Angka gabungan menyembunyikan subsidi silang. Pengguna ringan membayar untuk pengguna berat. Itu tidak masalah selama komposisinya stabil, dan menjadi rapuh begitu komposisinya bergeser.
Apa yang terjadi ketika penggunaan per tugas meningkat
Sekarang misalkan Anda merilis peningkatan: asisten berubah menjadi agen yang mengambil beberapa langkah per permintaan. Katakanlah hal itu melipatgandakan biaya setiap permintaan menjadi lima kali, sehingga satu permintaan kini berbiaya 5 sen. Pelanggan tidak mengubah jumlah permintaan yang mereka kirim. Biaya kini menjadi $3.550 dibandingkan pendapatan $3.000, sehingga margin kotor sekitar negatif 18%.
Anda membuat produk lebih baik, penggunaan tidak berubah, dan Anda beralih dari margin setara perangkat lunak menjadi merugi di setiap seat. Harga tetap tidak dapat menyerap perubahan biaya per permintaan, karena harga itu tidak mengenal permintaan.
Ekor pengguna berat
Contoh tersebut menunjukkan pola yang disebut ekor pengguna berat. Penggunaan antarpelanggan jarang berbentuk kurva lonceng. Penggunaan cenderung miring, dengan sebagian besar pelanggan menggunakan dalam jumlah sedang dan sekelompok kecil menggunakan jauh lebih banyak. Dengan harga tetap, pendapatan dari setiap pelanggan dibatasi, tetapi biayanya tidak.
Ada tiga hal yang membuat ekor ini lebih buruk di AI dibandingkan di perangkat lunak lama.
- Pelanggan terbaik adalah yang paling mahal. Orang-orang yang menyukai produk adalah yang paling sering menggunakannya. Mereka memperpanjang langganan, berekspansi, dan merekomendasikan kepada rekan kerja. Namun tagihan inferensi mereka tumbuh seiring antusiasme mereka.
- Agen menaikkan batas atas. Manusia hanya dapat mengirim sekian banyak permintaan per jam. Agen terjadwal dapat mengirim ribuan. Otomatisasi menghapus batas alami penggunaan per seat.
- Ekor bertambah panjang seiring produk membaik. Keluaran yang lebih baik berarti pelanggan memercayakan tugas yang lebih besar, dokumen yang lebih panjang, dan pekerjaan yang lebih otonom kepada produk. Masing-masing hal itu menaikkan biaya per tugas.
Semua ini tidak membuat harga tetap menjadi salah. Artinya, harga tetap menempatkan risiko biaya pada Anda, dan Anda perlu tahu bahwa itulah kesepakatan yang Anda buat.
Bagaimana pilihan model harga menentukan siapa yang menanggung risiko
Cara paling jernih untuk memikirkan harga produk AI adalah dengan mengajukan satu pertanyaan: ketika biaya per pelanggan naik, siapa yang membayar?
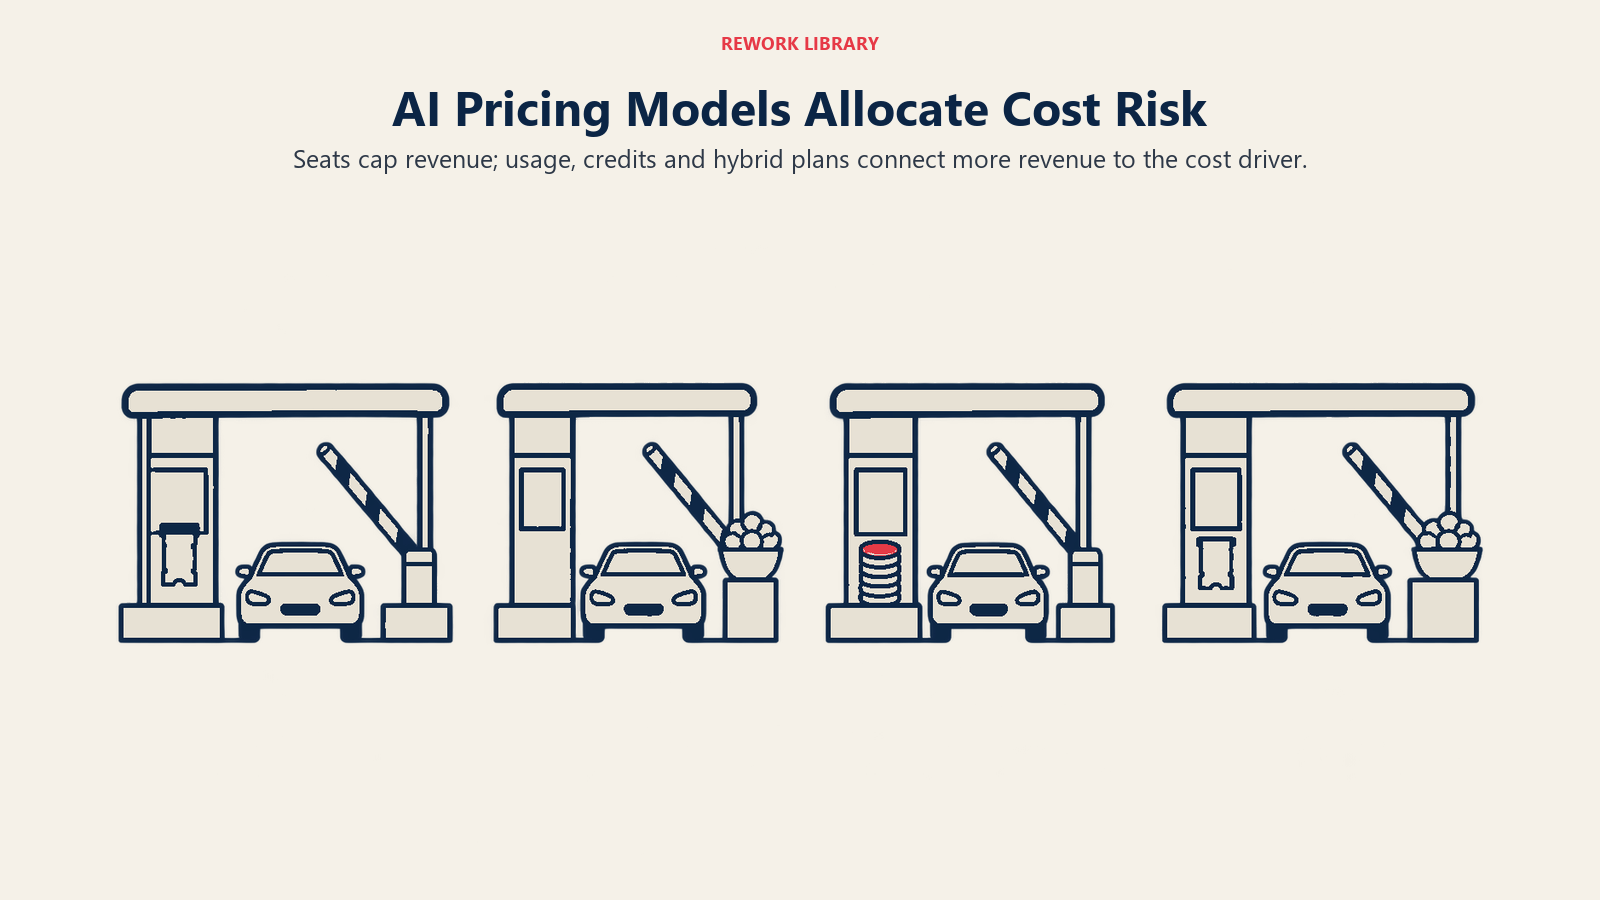
| Model harga | Apa yang dibayar pelanggan | Siapa yang menanggung risiko biaya inferensi | Kapan margin terlindungi |
|---|---|---|---|
| Tetap per seat | Akses untuk satu pengguna | Sebagian besar Anda | Ketika penggunaan per seat stabil dan ringan |
| Berbasis penggunaan | Unit yang dikonsumsi (permintaan, tugas, menit) | Sebagian besar pelanggan | Ketika harga unit menutupi biaya dengan ruang yang cukup |
| Kredit | Saldo prabayar yang dibelanjakan untuk tindakan | Dibagi, tergantung tabel tarif | Ketika kredit per tindakan mengikuti biaya nyata |
| Hibrida (biaya platform ditambah penggunaan yang sudah termasuk) | Biaya dasar ditambah kelebihan pemakaian | Dibagi | Ketika kuota yang termasuk ditetapkan jauh di bawah ekor |
Seat tetap mudah dijual dan mudah diperkirakan oleh pembeli. Model ini juga yang paling terpapar pada ekor. Artikel kami tentang harga per pengguna di era AI membahas mengapa unit seat melemah ketika pekerjaan dilakukan oleh perangkat lunak, bukan manusia.
Harga berbasis penggunaan mengikat pendapatan pada pendorong yang sama dengan pendorong biaya. Jika setiap permintaan menghasilkan 3 sen dan berbiaya 1 sen, Anda mempertahankan margin 67% pada setiap permintaan, berapa pun jumlah permintaan yang masuk. Harga yang Anda bayar sebagai gantinya adalah ketidakpastian bagi pembeli.
Kredit adalah harga berbasis penggunaan dengan pembungkus. Jika tabel tarifnya disusun dari biaya nyata, margin terlindungi per tindakan. Jika biaya per tindakan berubah dan tabel tarifnya tidak, Anda menciptakan kembali masalah harga tetap di dalam sistem kredit. Kami membahas pilihan desainnya dalam penjelasan harga berbasis kredit.
Hibrida memasangkan biaya dasar yang dapat diprediksi dengan kuota, lalu mengukur pemakaian di luarnya. Model ini memberi pembeli angka untuk dianggarkan dan memberi Anda batas seberapa jauh ekor dapat memanjang. Lihat harga hibrida untuk produk AI.
Kembali ke contoh, solusinya tidak misterius. Jika Anda beralih ke $10 per seat ditambah 3 sen per permintaan setelah 300 permintaan pertama yang sudah termasuk, seat ekstrem akan membayar sekitar $600 alih-alih $30, dan biayanya sebesar $200 akan tertutupi. Seat ringan akan membayar biaya dasar $10 dan tetap berada dalam kuota. Anda perlu menguji apakah harga yang lebih rendah di label masih menghasilkan konversi, dan itu adalah kompromi yang nyata. Namun strukturnya menyelaraskan pendapatan dengan biaya di titik di mana biaya itu benar-benar muncul.
Tren jangka panjang: lebih murah per unit, lebih banyak unit per tugas
Founder sering mendengar bahwa inferensi makin murah, sehingga masalah margin akan terselesaikan dengan sendirinya. Ada kebenarannya, tetapi ada juga jebakannya.
Kebenarannya terdokumentasi dengan baik. Analisis Andreessen Horowitz tentang tren ini, yang disebutnya LLMflation, menyatakan bahwa untuk LLM dengan kinerja setara, biayanya turun 10x setiap tahun. Epoch AI, yang meneliti model-model mutakhir pada enam benchmark selama sekitar tiga tahun, menemukan bahwa laju penurunannya sangat bervariasi tergantung pada tonggak kinerja, berkisar dari 9x hingga 900x per tahun. Epoch AI menambahkan bahwa penurunan tercepat terjadi pada tahun terakhir, sehingga kurang jelas apakah penurunan itu akan berlanjut. Kedua pernyataan tersebut membahas harga untuk mencapai tingkat kemampuan yang tetap. Keduanya tidak menyebutkan berapa yang akan Anda bayar untuk model terbaik yang tersedia tahun depan.
Jebakannya ada pada separuh kedua persamaan. Biaya per tugas sama dengan biaya per unit kemampuan dikali jumlah kemampuan yang dikonsumsi tugas tersebut. Suku pertama telah turun dengan cepat. Suku kedua cenderung naik, karena alasan-alasan yang dibahas sebelumnya dalam artikel ini:
- Pelanggan menginginkan model yang paling mampu, bukan model tahun lalu, sehingga mereka terus membeli di garis depan.
- Langkah penalaran menambah token pada setiap jawaban.
- Siklus agen mengubah satu permintaan menjadi banyak panggilan.
- Konteks yang lebih panjang dan dokumen yang lebih besar menjadi praktis, sehingga orang menggunakannya.
Angka Anthropic di atas menunjukkan skala sisi penggunaan: peralihan dari obrolan ke agen melipatgandakan token per tugas beberapa kali. Penurunan tahunan 10x pada harga per unit kemampuan dapat habis dimakan oleh produk yang menggunakan jauh lebih banyak unit per tugas. Efek bersihnya pada margin Anda bergantung pada kekuatan mana yang menang untuk beban kerja Anda, dan itu adalah pertanyaan empiris yang harus Anda jawab dari data Anda sendiri.
Sikap perencanaan yang mengikutinya bersifat konservatif. Jangan menetapkan harga produk hari ini dengan asumsi bahwa biaya akan turun cukup jauh untuk menyelamatkannya. Tetapkan harga sehingga margin setiap pelanggan bertahan pada biaya hari ini, dan perlakukan penurunan biaya unit sebagai potensi keuntungan yang dapat Anda bagi dengan pelanggan atau simpan sendiri.
Apa yang perlu diukur
Mekanisme hanya membantu jika Anda dapat melihatnya dalam angka Anda sendiri. Lacak hal-hal berikut:
- Biaya inferensi per pelanggan aktif, per bulan. Rata-rata kurang berguna dibandingkan distribusinya. Lihat median, persentil ke-90, dan sepuluh akun teratas.
- Margin kotor per pelanggan, atau per kelompok penggunaan. Cari tahu berapa banyak pelanggan yang berada di bawah target Anda.
- Biaya per tugas yang diselesaikan, bukan per permintaan. Jika pengulangan dan langkah agen tersembunyi di dalam "satu tugas," angka per permintaan akan meremehkan biayanya.
- Porsi biaya dari 10% pengguna teratas. Dalam contoh, angkanya 79%. Jika milik Anda sama terkonsentrasinya, harga adalah tempat pertama yang perlu diperiksa.
- Biaya per permintaan dari waktu ke waktu dengan perilaku yang konstan. Ini memisahkan penurunan harga unit dari jejak penggunaan yang meningkat.
Jika Anda belum dapat menghitung ini hari ini, membangun pencatatan untuk melakukannya lebih berharga daripada sebagian besar eksperimen harga, karena setiap keputusan harga bertumpu pada pengetahuan tentang dari mana biaya berasal.
Fakta Utama: Biaya Inferensi dan Margin Kotor
- Pelatihan membangun model dan sebagian besar tidak bergantung pada volume pelanggan. Inferensi menjalankan model untuk setiap tindakan pelanggan dan berskala sesuai penggunaan, itulah sebabnya ia masuk ke margin kotor.
- Biaya per permintaan bergantung pada token masuk dan keluar, panjang konteks, ukuran model, langkah penalaran, siklus agen, dan pengulangan.
- Agen biasanya menggunakan sekitar 4x lebih banyak token dibandingkan interaksi obrolan, dan sistem multi-agen sekitar 15x (engineering Anthropic, tentang sistem risetnya sendiri).
- Untuk LLM dengan kinerja setara, biaya turun 10x setiap tahun (a16z).
- Epoch AI menemukan penurunan harga berkisar dari 9x hingga 900x per tahun tergantung pada tonggak kinerja, dengan penurunan tercepat pada tahun terakhir.
- Dengan harga tetap, pendapatan per pelanggan dibatasi sementara biaya inferensi tidak, sehingga pengguna berat dapat berjalan dengan margin negatif sementara angka gabungannya tampak sehat.
- Dalam contoh ilustratif di artikel ini, 10% seat menghasilkan sekitar 79% biaya inferensi, dan kenaikan 5x pada biaya per permintaan mengubah margin 76% menjadi kerugian.
- Harga berbasis penggunaan, kredit, dan hibrida memindahkan lebih banyak risiko biaya kepada pelanggan dibandingkan seat tetap.
Kesimpulannya singkat. Inferensi mengubah biaya penyampaian perangkat lunak dari angka pembulatan menjadi pos yang bergerak di setiap permintaan, dan model harga Anda menentukan apakah pergerakan itu jatuh pada pelanggan atau pada margin Anda. Ketahui distribusi penggunaan di seluruh akun Anda, dan tetapkan harga berdasarkan biaya yang Anda miliki saat ini.
Pertanyaan yang Sering Diajukan tentang Biaya Inferensi dan Margin Kotor
Apa itu inferensi dalam AI?
Inferensi adalah menjalankan model yang sudah dilatih untuk menghasilkan keluaran bagi pengguna, seperti menjawab pertanyaan atau menyelesaikan tugas. Ini terjadi setiap kali pelanggan melakukan tindakan, sehingga biayanya tumbuh seiring penggunaan. Sebaliknya, pelatihan adalah pekerjaan satu kali atau berkala untuk membangun model.
Mengapa inferensi merupakan biaya variabel?
Setiap permintaan memicu komputasinya sendiri, dan ukuran komputasi itu bergantung pada token masuk dan keluar, panjang konteks, ukuran model, langkah penalaran, siklus agen, dan pengulangan. Lebih banyak permintaan, atau permintaan yang lebih berat, berarti tagihan yang lebih besar. Ini berbeda dari perangkat lunak klasik, di mana permintaan tambahan hampir tidak berbiaya.
Bagaimana biaya inferensi memengaruhi margin kotor?
Inferensi biasanya merupakan biaya langsung terbesar untuk menyampaikan produk AI, sehingga secara langsung mengurangi margin kotor. Karena biaya ini bervariasi per pelanggan sementara pendapatan langganan sering kali tidak, margin menjadi angka per pelanggan. Margin gabungan yang sehat dapat menyembunyikan pelanggan yang biayanya lebih besar daripada yang mereka bayar.
Apa itu masalah pengguna berat dalam penetapan harga AI?
Dengan harga tetap, pendapatan per pelanggan dibatasi, tetapi biaya inferensi tidak. Sekelompok kecil pengguna berat, sering kali pelanggan Anda yang paling aktif, dapat menyumbang sebagian besar biaya dan berjalan dengan margin negatif. Pengguna ringan akhirnya menyubsidi mereka, dan ini hanya berhasil selama komposisi penggunaan tetap stabil.
Apakah penurunan harga inferensi akan memperbaiki masalah margin dengan sendirinya?
Tidak secara andal. Harga untuk tingkat kemampuan yang tetap telah turun dengan cepat, dengan a16z menyebut sekitar 10x per tahun dan Epoch AI menyebut rentang 9x hingga 900x per tahun. Namun pelanggan juga menggunakan model yang lebih mampu, konteks yang lebih panjang, penalaran, dan agen, yang menaikkan jumlah komputasi per tugas. Kekuatan mana yang menang bergantung pada beban kerja Anda.
Model harga mana yang paling melindungi margin dari biaya inferensi?
Model yang mengikat pendapatan pada penggunaan, seperti harga berbasis penggunaan atau kredit dengan tabel tarif yang akurat, melindungi margin per permintaan. Hibrida dengan kuota yang sudah termasuk membatasi ekor sambil mempertahankan biaya dasar yang dapat diprediksi. Seat tetap menyisakan risiko terbesar pada Anda. Pilihan yang tepat juga bergantung pada seberapa besar ketidakpastian yang dapat diterima pembeli Anda.
Apa yang sebaiknya saya ukur terlebih dahulu?
Mulailah dengan biaya inferensi per pelanggan dan distribusinya di seluruh akun, terutama porsi biaya dari 10% pengguna teratas Anda. Kemudian lacak biaya per tugas yang diselesaikan alih-alih per permintaan, serta margin kotor per kelompok penggunaan. Ketiga hal itu menunjukkan apakah harga Anda sesuai dengan titik di mana biaya muncul.
Bacaan Terkait

Co-Founder & COO
On this page
- Pelatihan versus inferensi
- Mengapa inferensi berperilaku seperti biaya variabel
- Bagaimana biaya per permintaan menjadi margin kotor
- Contoh perhitungan dengan angka ilustratif
- Apa yang terjadi ketika penggunaan per tugas meningkat
- Ekor pengguna berat
- Bagaimana pilihan model harga menentukan siapa yang menanggung risiko
- Tren jangka panjang: lebih murah per unit, lebih banyak unit per tugas
- Apa yang perlu diukur
- Bacaan Terkait