Kos Inferens dan Margin Kasar dalam Syarikat AI
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Perisian tradisional mempunyai satu keistimewaan yang menggembirakan: setelah produk siap dibina, melayani seorang lagi pelanggan hampir tidak menelan kos. Itulah sebabnya margin kasar perisian menjadi perkara yang dikagumi pelabur. Produk AI memecahkan keistimewaan ini. Setiap kali pelanggan meminta produk melakukan sesuatu, sebuah model dijalankan, dan menjalankan model memerlukan wang sebenar. Kos itu dipanggil inferens, dan ia satu-satunya sebab terbesar mengapa margin kasar syarikat AI boleh kelihatan sangat berbeza daripada syarikat perisian klasik.
Artikel ini menerangkan mekanismenya. Apakah inferens, mengapa ia berkelakuan seperti kos berubah, bagaimana kos satu permintaan bertukar menjadi angka margin, mengapa segelintir pengguna berat boleh merosakkan purata, dan bagaimana model harga anda menentukan siapa yang menanggung risiko. Ia ditulis untuk pengasas dan CEO pemilik syarikat B2B yang mempunyai pasukan. Contoh yang dikira menggunakan angka hipotetikal yang dibundarkan dan tidak mencerminkan harga mana-mana model sebenar.
Untuk cara kos ini diklasifikasikan dalam penyata pendapatan, lihat cara syarikat AI mengakaunkan COGS. Untuk cara mengurangkannya, lihat pengurusan kos model AI. Tulisan ini hanya memberi tumpuan kepada cara kos berfungsi dan bagaimana ia sampai ke margin.
Latihan berbanding inferens
Dua aktiviti berbeza menggunakan pengkomputeran dalam perniagaan AI, dan kelakuan kedua-duanya sangat berbeza.
Latihan ialah membina atau menyesuaikan model. Ia berlaku sebelum (atau secara berkala seiring dengan) melayani pelanggan. Ia mahal, tidak sekata, dan sebahagian besarnya tidak bergantung pada bilangan orang yang menggunakan produk anda. Jika anda membina model sendiri, satu larian latihan lebih menyerupai projek pembangunan berbanding kos menyampaikan jualan.
Inferens ialah menjalankan model yang telah dilatih untuk menghasilkan jawapan. Ia berlaku setiap kali pelanggan mengambil tindakan. Jika anda melakukan fine-tuning pada model atau memanggil model pihak lain, pembahagian yang sama terpakai: membina keupayaan ialah satu kos, dan melayaninya ialah kos lain.
Perbezaan ini penting kerana kedua-duanya berskala pada paksi berbeza. Kos latihan berskala mengikut cita-cita model. Kos inferens berskala mengikut tahap penggunaan oleh pelanggan anda. Syarikat permulaan yang menjual produk AI kepada lebih ramai pelanggan, atau menyebabkan pelanggan sedia ada menggunakannya lebih banyak, tidak menambah bil latihannya. Ia menambah bil inferensnya, hampir satu lawan satu.
Itulah sebabnya inferens ialah kos yang muncul dalam margin kasar. Ia ditanggung semasa menyampaikan produk, dan ia meningkat apabila penyampaian meningkat.
Mengapa inferens berkelakuan seperti kos berubah
Dalam produk perisian klasik, kos marginal sesuatu permintaan hampir boleh diabaikan. Anda membayar pelayan secara berketul, dan trafik mengisi ketulan itu. Dalam produk AI, setiap permintaan melakukan sejumlah pengkomputeran tersendiri, dan saiznya bergantung pada jenis permintaan. Beberapa perkara menentukannya.
Token masuk dan token keluar. Model bahasa membaca dan menulis teks dalam unit kecil yang dipanggil token. Soalan pendek dengan jawapan pendek adalah murah. Dokumen panjang dengan ringkasan panjang tidak. Penyedia dan persediaan yang dihoskan sendiri cenderung melayan bahagian membaca (input) dan bahagian menulis (output) secara berbeza, dan output yang panjang secara amnya lebih mahal untuk dihasilkan berbanding kos membaca jumlah input yang sama.
Panjang konteks. Banyak produk menyumbat bahan tambahan ke dalam setiap permintaan: perbualan setakat ini, dokumen yang diambil semula, arahan, contoh. Konteks itu dibaca semula setiap kali. Perbualan yang sudah mencapai dua puluh giliran lebih mahal bagi setiap mesej berbanding mesej pertama, kerana keseluruhan sejarah turut dibawa.
Saiz model. Model yang lebih besar dan lebih berkeupayaan lebih mahal bagi setiap token berbanding model yang lebih kecil. Memilih satu model untuk setiap tugasan ialah reka bentuk paling mudah dan sering paling mahal.
Langkah penaakulan. Sesetengah model menggunakan token tambahan untuk "berfikir" sebelum menjawab. Token pemikiran itu biasanya sebahagian daripada apa yang anda bayar, walaupun pelanggan tidak pernah melihatnya. Soalan yang sukar boleh menghasilkan token berkali-kali ganda lebih banyak daripada yang dicadangkan oleh jawapan yang kelihatan.
Gelung ejen. Ejen AI tidak menjawab sekali sahaja. Ia merancang, memanggil alat, membaca hasilnya, memutuskan langkah seterusnya, dan mengulanginya. Setiap pusingan ialah satu lagi panggilan model, dan setiap panggilan membaca semula konteks yang semakin panjang. Pasukan kejuruteraan Anthropic, ketika menerangkan sistem penyelidikan berbilang ejennya sendiri, melaporkan bahawa ejen biasanya menggunakan kira-kira 4 kali lebih banyak token berbanding interaksi sembang, dan sistem berbilang ejen kira-kira 15 kali lebih banyak. Itu data satu syarikat bagi satu jenis beban kerja, jadi anggap nisbah ini sebagai ilustrasi betapa curamnya kos boleh meningkat apabila anda beralih daripada menjawab kepada bertindak, bukan sebagai pengganda universal.
Cubaan semula dan kegagalan. Apabila output gagal dalam semakan, ditolak oleh pengesah, atau panggilan alat mengalami ralat, produk sering mencuba lagi. Setiap cubaan semula menelan kos sama seperti cubaan asal. Produk dengan kadar cubaan semula 10% menanggung kira-kira 10% lebih banyak perbelanjaan inferens berbanding yang dicadangkan oleh "laluan lancar"nya.
Gabungkan semua ini dan anda akan nampak mengapa dua tindakan yang kelihatan sama dalam antara muka produk anda, misalnya "jalankan analisis," boleh berbeza kos sebanyak sepuluh atau seratus kali ganda. Untuk tinjauan lebih mendalam tentang kawalan kos dalam sistem ejen secara khusus, lihat pengoptimuman kos ejen AI.
Bagaimana kos setiap permintaan menjadi margin kasar
Margin kasar ialah hasil tolak kos langsung menyampaikan produk, dibahagi dengan hasil. Bagi syarikat AI, inferens ialah kos langsung terbesar dalam penolakan itu, biasanya disertai pengehosan, pemantauan dan sokongan pelanggan. Rujukan kami tentang margin kasar membincangkan formula umumnya. Di sini kita hanya memerlukan bentuk hubungannya.
Jika hasil anda bagi setiap pelanggan adalah tetap dan kos inferens bagi setiap pelanggan berubah mengikut penggunaan, maka margin kasar berbeza mengikut pelanggan. Margin bukan sifat produk. Ia sifat produk didarab dengan cara setiap pelanggan menggunakannya, pada harga tertentu.
Ini membawa akibat praktikal. Anda tidak boleh membaca angka margin gabungan dan terus tahu sama ada perniagaan itu sihat. Margin gabungan 70% boleh bermakna kebanyakan pelanggan berada pada 80% dan segelintir pada 20%. Atau ia boleh bermakna semua orang berada hampir 70%. Kedua-dua syarikat itu mempunyai risiko yang sangat berbeza, dan hanya yang pertama mempunyai masalah pengguna berat.
Contoh yang dikira dengan angka ilustrasi
Mari kita bina satu. Setiap angka di sini adalah hipotetikal dan dibundarkan. Tiada satu pun harga sebenar.
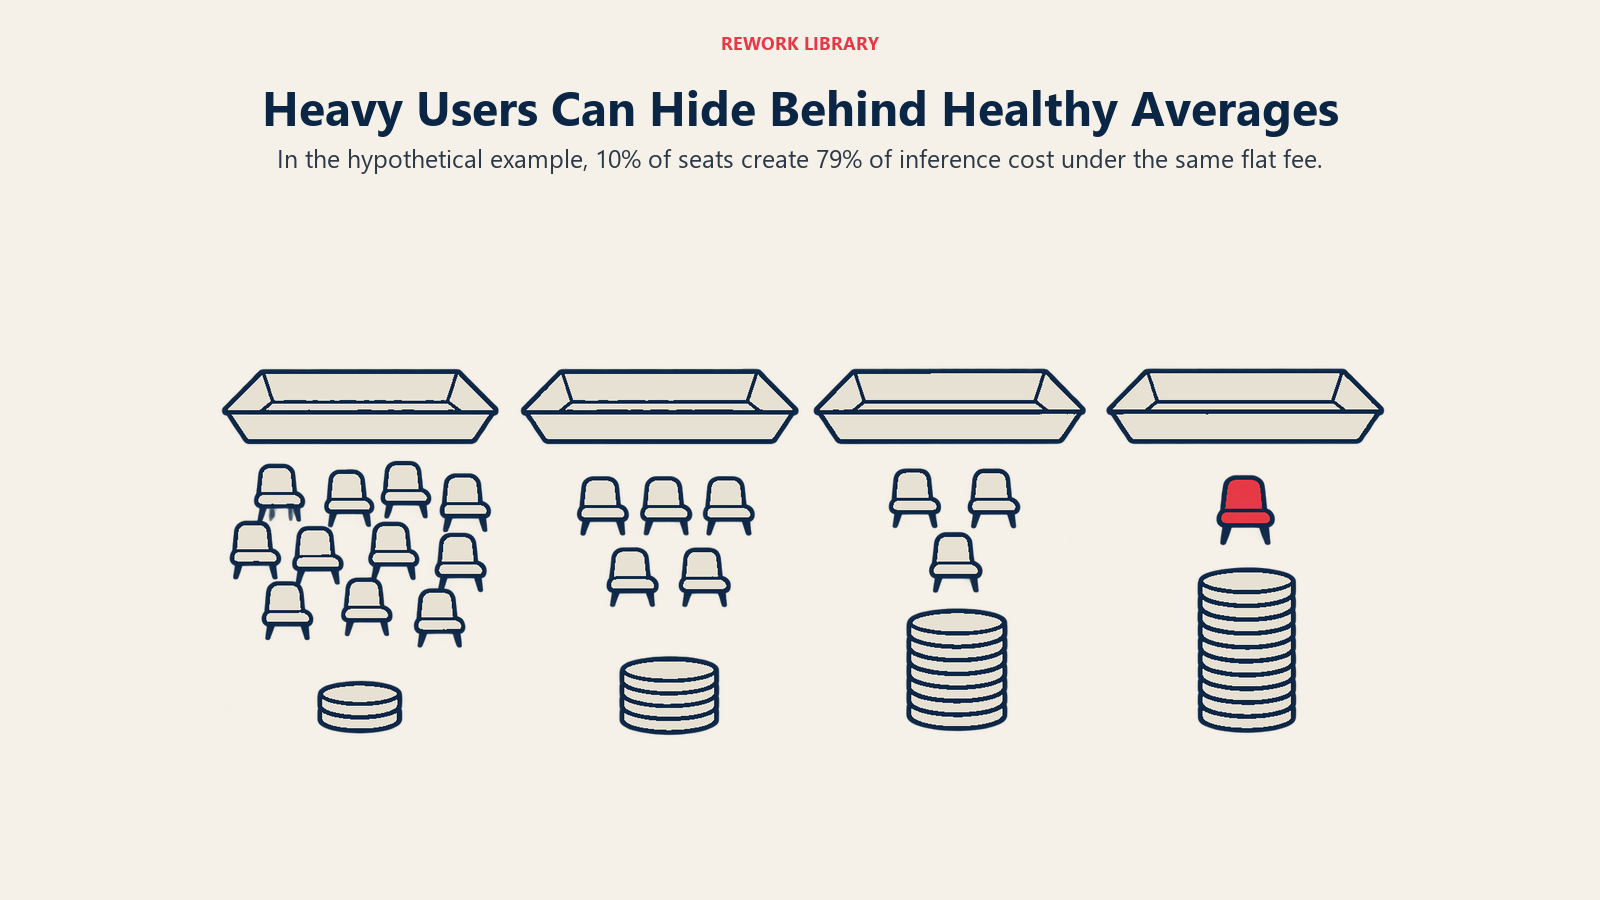
Andaikan anda menjual pembantu AI pada harga tetap $30 setiap kerusi sebulan. Andaikan satu permintaan menelan kos inferens 1 sen. Anda mempunyai 100 kerusi, dan penggunaannya tidak sekata, seperti yang hampir selalu berlaku:
| Kumpulan pelanggan | Kerusi | Permintaan setiap kerusi sebulan | Kos inferens setiap kerusi | Jumlah kos inferens |
|---|---|---|---|---|
| Ringan | 60 | 50 | $0.50 | $30 |
| Sederhana | 30 | 400 | $4.00 | $120 |
| Berat | 9 | 4,000 | $40.00 | $360 |
| Ekstrem | 1 | 20,000 | $200.00 | $200 |
| Jumlah | 100 | $710 |
Hasil ialah 100 kerusi darab $30, iaitu $3,000. Inferens ialah $710. Dengan mengabaikan semua kos lain, margin kasar ialah (3,000 tolak 710) dibahagi 3,000, atau kira-kira 76%.
Kelihatan sihat. Sekarang lihat ke dalamnya.
- Setiap satu daripada 60 kerusi ringan menghasilkan margin kira-kira $29.50.
- Setiap satu daripada 9 kerusi berat rugi $10, kerana inferens $40 melebihi $30 yang dibayar.
- Satu kerusi ekstrem rugi $170.
- 10 kerusi berat dan ekstrem itu (10% pelanggan) menghasilkan $560 daripada kos $710, iaitu kira-kira 79% daripada semua perbelanjaan inferens.
Angka gabungan menyembunyikan subsidi silang. Pengguna ringan membayar untuk pengguna berat. Itu tiada masalah selagi campurannya stabil, tetapi rapuh sebaik sahaja ia berubah.
Apa yang berlaku apabila penggunaan setiap tugasan meningkat
Sekarang andaikan anda melancarkan naik taraf: pembantu itu menjadi ejen yang mengambil beberapa langkah bagi setiap permintaan. Katakan ini menggandakan kos setiap permintaan sebanyak lima kali, jadi satu permintaan menelan kos 5 sen. Pelanggan tidak mengubah bilangan permintaan yang mereka hantar. Kos kini $3,550 berbanding hasil $3,000, jadi margin kasar ialah kira-kira negatif 18%.
Anda menjadikan produk lebih baik, penggunaan tidak berubah, dan anda beralih daripada margin seperti perisian kepada kerugian pada setiap kerusi. Harga tetap tidak dapat menyerap perubahan kos setiap permintaan, kerana harga itu tidak mengambil kira permintaan.
Ekor pengguna berat
Contoh ini menunjukkan corak yang dipanggil ekor pengguna berat. Penggunaan merentasi pelanggan jarang berbentuk lengkung loceng. Ia cenderung pencong, dengan kebanyakan pelanggan menggunakan jumlah sederhana dan sekumpulan kecil menggunakan jauh lebih banyak. Di bawah harga tetap, hasil daripada setiap pelanggan dihadkan, tetapi kosnya tidak.
Tiga perkara menjadikan ekor ini lebih teruk dalam AI berbanding perisian lama.
- Pelanggan terbaik ialah yang paling mahal. Orang yang menyukai produk paling banyak menggunakannya. Mereka memperbaharui, mengembangkan penggunaan, dan memberitahu rakan sekerja. Tetapi bil inferens mereka berkembang seiring dengan semangat mereka.
- Ejen menaikkan siling. Manusia hanya boleh menghantar sejumlah permintaan tertentu dalam sejam. Ejen berjadual boleh menghantar beribu-ribu. Automasi menghapuskan had semula jadi penggunaan setiap kerusi.
- Ekor berkembang apabila produk bertambah baik. Output yang lebih baik bermakna pelanggan mempercayai produk dengan tugasan lebih besar, dokumen lebih panjang dan kerja lebih autonomi. Setiap satunya menaikkan kos setiap tugasan.
Semua ini tidak menjadikan harga tetap salah. Ia bermakna harga tetap meletakkan risiko kos pada anda, dan anda patut tahu itulah tawaran yang anda buat.
Bagaimana pilihan model harga menentukan siapa menanggung risiko
Cara paling jelas untuk memikirkan harga produk AI ialah bertanya satu soalan: apabila kos setiap pelanggan meningkat, siapa yang membayar?
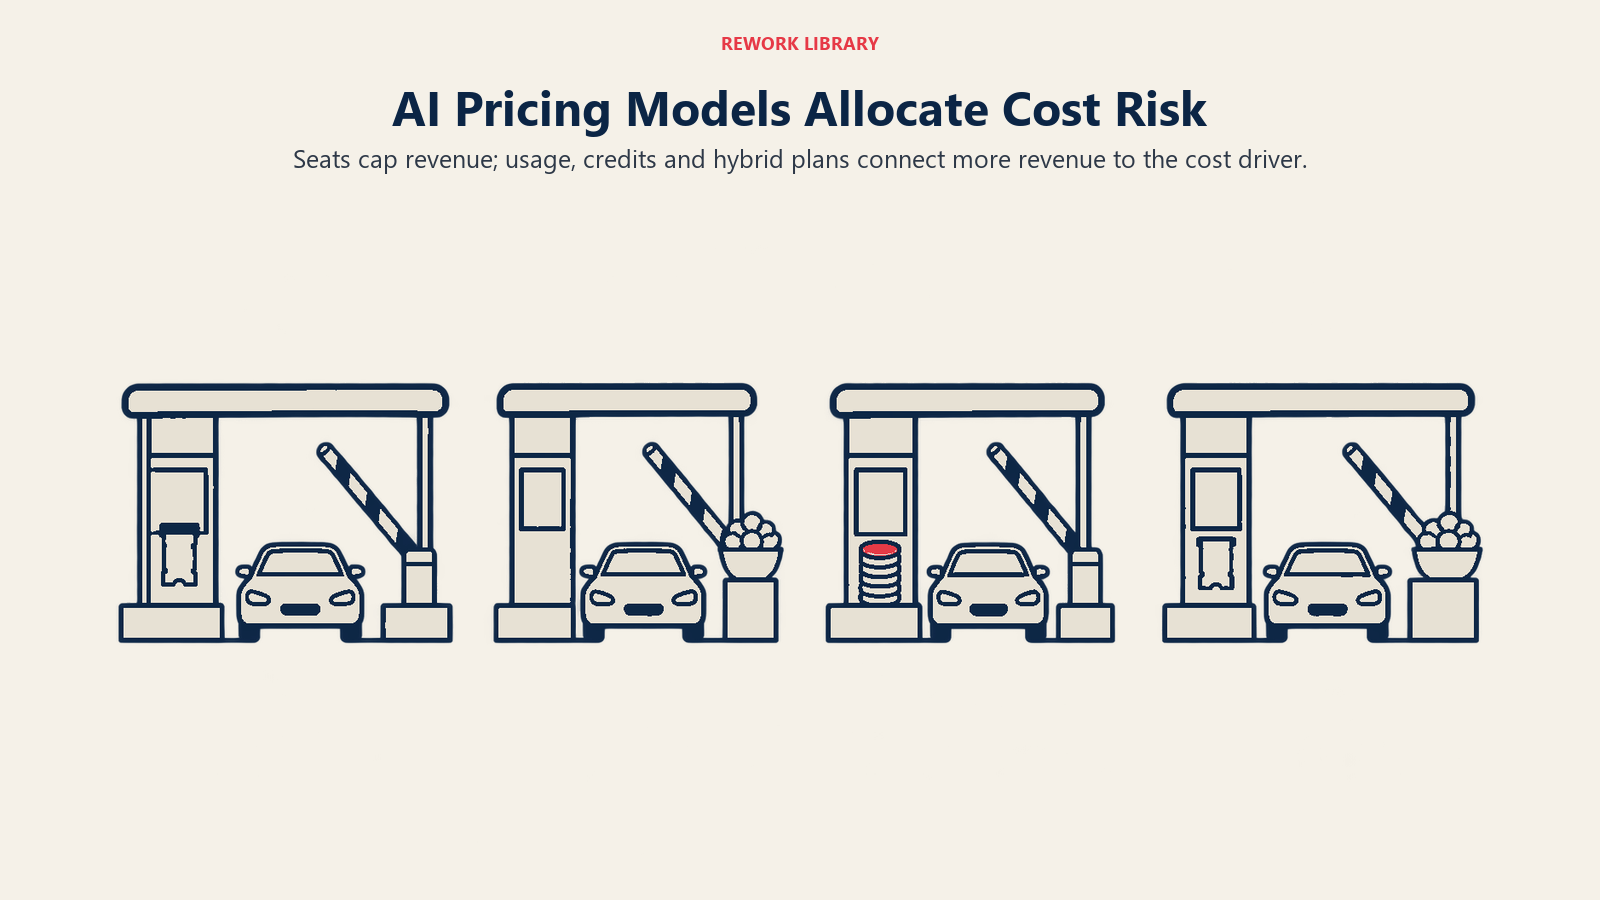
| Model harga | Apa yang dibayar pelanggan | Siapa menanggung risiko kos inferens | Bila margin dilindungi |
|---|---|---|---|
| Tetap setiap kerusi | Akses untuk seorang pengguna | Kebanyakannya anda | Apabila penggunaan setiap kerusi stabil dan ringan |
| Berasaskan penggunaan | Unit yang digunakan (permintaan, tugasan, minit) | Kebanyakannya pelanggan | Apabila harga unit menampung kos dengan ruang lebihan |
| Kredit | Baki prabayar yang dibelanjakan untuk tindakan | Dikongsi, bergantung pada kad kadar | Apabila kredit setiap tindakan menjejaki kos sebenar |
| Hibrid (yuran platform ditambah penggunaan termasuk) | Asas ditambah lebihan | Dikongsi | Apabila peruntukan termasuk ditetapkan jauh di bawah ekor |
Kerusi tetap mudah dijual dan mudah diramalkan oleh pembeli. Ia juga model yang paling terdedah kepada ekor. Artikel kami tentang harga per kerusi dalam era AI menerangkan mengapa unit kerusi menjadi lemah apabila kerja dilakukan oleh perisian dan bukannya manusia.
Harga berasaskan penggunaan mengikat hasil kepada pemacu yang sama yang memacu kos. Jika setiap permintaan menghasilkan 3 sen dan menelan kos 1 sen, anda mengekalkan margin 67% bagi setiap permintaan tidak kira berapa banyak yang tiba. Harga yang anda bayar sebagai balasan ialah ketidakpastian bagi pembeli.
Kredit ialah harga berasaskan penggunaan dengan pembalut. Jika kad kadar dibina daripada kos sebenar, margin dilindungi bagi setiap tindakan. Jika kos setiap tindakan berubah tetapi kad kadar tidak, anda telah mencipta semula masalah harga tetap di dalam sistem kredit. Kami membincangkan pilihan reka bentuk dalam penjelasan harga berasaskan kredit.
Hibrid menggabungkan asas yang boleh diramal dengan peruntukan dan kemudian meter penggunaan melebihinya. Ia memberi pembeli satu angka untuk dibajetkan dan memberi anda had sejauh mana ekor boleh berlari. Lihat harga hibrid untuk produk AI.
Kembali kepada contoh, penyelesaiannya tidak misteri. Jika anda beralih kepada $10 setiap kerusi ditambah 3 sen setiap permintaan selepas 300 yang pertama termasuk, kerusi ekstrem akan membayar kira-kira $600 dan bukannya $30, dan kosnya sebanyak $200 akan ditampung. Kerusi ringan akan membayar asas $10 dan kekal dalam peruntukan. Anda perlu menguji sama ada harga pelekat yang lebih rendah masih menukarkan pembeli, dan itu pertukaran yang sebenar. Tetapi strukturnya memadankan hasil dengan kos di tempat kos itu benar-benar timbul.
Trend jangka panjang: lebih murah setiap unit, lebih banyak unit setiap tugasan
Pengasas sering mendengar bahawa inferens semakin murah, jadi masalah margin akan selesai dengan sendirinya. Ada kebenarannya, dan ada juga kelemahannya.
Kebenarannya didokumentasikan dengan baik. Analisis Andreessen Horowitz tentang trend ini, yang dipanggil LLMflation, menyatakan bahawa bagi LLM dengan prestasi setara, kosnya menurun sebanyak 10x setiap tahun. Epoch AI, yang meneliti model termaju pada enam penanda aras dalam tempoh kira-kira tiga tahun, mendapati bahawa kadar penurunan berbeza secara mendadak bergantung pada pencapaian prestasi, antara 9x hingga 900x setahun. Ia menambah bahawa penurunan paling pantas berlaku dalam tahun terkini, jadi kurang jelas sama ada ia akan berterusan. Kedua-dua kenyataan ini tentang harga untuk mencapai tahap keupayaan yang tetap. Ia tidak menyatakan berapa yang akan anda bayar untuk model terbaik yang tersedia tahun depan.
Kelemahannya ialah separuh kedua persamaan. Kos setiap tugasan bersamaan kos setiap unit keupayaan darab jumlah keupayaan yang digunakan tugasan itu. Sebutan pertama telah menurun dengan cepat. Sebutan kedua cenderung meningkat, atas sebab-sebab yang dibincangkan sebelum ini dalam artikel ini:
- Pelanggan mahukan model paling berkeupayaan, bukan model tahun lepas, jadi mereka terus membeli di barisan hadapan.
- Langkah penaakulan menambah token pada setiap jawapan.
- Gelung ejen mengubah satu permintaan menjadi banyak panggilan.
- Konteks yang lebih panjang dan dokumen yang lebih besar menjadi praktikal, jadi orang menggunakannya.
Angka Anthropic di atas menunjukkan skala sisi penggunaan: peralihan daripada sembang kepada ejen menggandakan token setiap tugasan beberapa kali. Penurunan tahunan 10x dalam harga setiap unit keupayaan boleh ditelan oleh produk yang menggunakan jauh lebih banyak unit bagi setiap tugasan. Kesan bersih pada margin anda bergantung pada daya mana yang menang untuk beban kerja anda, dan itu persoalan empirikal yang perlu anda jawab daripada data anda sendiri.
Pendirian perancangan yang terhasil adalah konservatif. Jangan tetapkan harga produk hari ini dengan andaian kos akan jatuh cukup jauh untuk menyelamatkannya. Tetapkan harga supaya margin setiap pelanggan bertahan pada kos hari ini, dan anggap penurunan kos unit sebagai kelebihan yang boleh anda kongsi dengan pelanggan atau simpan.
Apa yang perlu diukur
Mekanisme hanya membantu jika anda dapat melihatnya dalam angka anda sendiri. Jejaki perkara berikut:
- Kos inferens setiap pelanggan aktif, sebulan. Purata kurang berguna berbanding taburan. Lihat median, persentil ke-90 dan sepuluh akaun teratas.
- Margin kasar mengikut pelanggan, atau mengikut kohort penggunaan. Ketahui berapa ramai pelanggan berada di bawah sasaran anda.
- Kos setiap tugasan yang disiapkan, bukan setiap permintaan. Jika cubaan semula dan langkah ejen tersembunyi dalam "satu tugasan," angka setiap permintaan akan mengurangkan anggaran kos sebenar.
- Bahagian kos daripada 10% pengguna teratas. Dalam contoh tadi ia 79%. Jika bahagian anda tertumpu secara serupa, harga ialah tempat pertama untuk diperiksa.
- Kos setiap permintaan dari semasa ke semasa pada tingkah laku yang tetap. Ini memisahkan penurunan harga unit daripada jejak penggunaan yang meningkat.
Jika anda tidak dapat mengira angka ini hari ini, membina pengelogan untuk melakukannya lebih bernilai berbanding kebanyakan eksperimen harga, kerana setiap keputusan harga bergantung pada pengetahuan tentang dari mana kos datang.
Fakta Utama: Kos Inferens dan Margin Kasar
- Latihan membina model dan sebahagian besarnya tidak bergantung pada volum pelanggan. Inferens menjalankan model bagi setiap tindakan pelanggan dan berskala mengikut penggunaan, sebab itulah ia masuk ke dalam margin kasar.
- Kos setiap permintaan bergantung pada token masuk dan keluar, panjang konteks, saiz model, langkah penaakulan, gelung ejen dan cubaan semula.
- Ejen biasanya menggunakan kira-kira 4x lebih banyak token berbanding interaksi sembang, dan sistem berbilang ejen kira-kira 15x (kejuruteraan Anthropic, tentang sistem penyelidikannya sendiri).
- Bagi LLM dengan prestasi setara, kos menurun sebanyak 10x setiap tahun (a16z).
- Epoch AI mendapati penurunan harga antara 9x hingga 900x setahun bergantung pada pencapaian prestasi, dengan penurunan paling pantas dalam tahun terkini.
- Di bawah harga tetap, hasil setiap pelanggan dihadkan tetapi kos inferens tidak, jadi pengguna berat boleh beroperasi pada margin negatif sementara angka gabungan kelihatan sihat.
- Dalam contoh ilustrasi artikel ini, 10% kerusi menghasilkan kira-kira 79% kos inferens, dan peningkatan 5x dalam kos setiap permintaan mengubah margin 76% menjadi kerugian.
- Harga berasaskan penggunaan, kredit dan hibrid memindahkan lebih banyak risiko kos kepada pelanggan berbanding kerusi tetap.
Rumusannya ringkas. Inferens mengubah kos menyampaikan perisian daripada angka yang boleh diabaikan kepada baris yang bergerak dengan setiap permintaan, dan model harga anda menentukan sama ada pergerakan itu jatuh pada pelanggan atau pada margin anda. Ketahui taburan penggunaan merentasi akaun anda, dan tetapkan harga berdasarkan kos yang anda tanggung sekarang.
Soalan Lazim tentang Kos Inferens dan Margin Kasar
Apakah inferens dalam AI?
Inferens ialah menjalankan model yang telah dilatih untuk menghasilkan output bagi pengguna, seperti menjawab soalan atau menyiapkan tugasan. Ia berlaku setiap kali pelanggan mengambil tindakan, jadi kosnya berkembang mengikut penggunaan. Latihan pula ialah kerja sekali atau berkala untuk membina model.
Mengapa inferens ialah kos berubah?
Setiap permintaan mencetuskan pengkomputerannya sendiri, dan saiz pengkomputeran itu bergantung pada token masuk dan keluar, panjang konteks, saiz model, langkah penaakulan, gelung ejen dan cubaan semula. Lebih banyak permintaan, atau permintaan yang lebih berat, bermakna bil yang lebih besar. Ini berbeza daripada perisian klasik, di mana permintaan tambahan hampir tidak menelan kos.
Bagaimana kos inferens menjejaskan margin kasar?
Inferens biasanya kos langsung terbesar dalam menyampaikan produk AI, jadi ia mengurangkan margin kasar secara langsung. Oleh kerana ia berbeza mengikut pelanggan sedangkan hasil langganan selalunya tidak, margin menjadi angka setiap pelanggan. Margin gabungan yang sihat boleh menyembunyikan pelanggan yang menelan kos lebih daripada yang mereka bayar.
Apakah masalah pengguna berat dalam harga AI?
Di bawah harga tetap, hasil setiap pelanggan dihadkan, tetapi kos inferens tidak. Sekumpulan kecil pengguna berat, selalunya pelanggan anda yang paling aktif, boleh menyumbang sebahagian besar kos dan beroperasi pada margin negatif. Pengguna ringan akhirnya mensubsidi mereka, dan ini hanya berfungsi selagi campuran penggunaan kekal stabil.
Adakah penurunan harga inferens akan menyelesaikan masalah margin dengan sendirinya?
Tidak secara pasti. Harga bagi tahap keupayaan yang tetap telah jatuh dengan pantas, dengan a16z memetik kira-kira 10x setahun dan Epoch AI julat 9x hingga 900x setahun. Tetapi pelanggan juga menggunakan model yang lebih berkeupayaan, konteks lebih panjang, penaakulan dan ejen, yang menaikkan jumlah pengkomputeran setiap tugasan. Daya mana yang menang bergantung pada beban kerja anda.
Model harga manakah yang paling melindungi margin daripada kos inferens?
Model yang mengikat hasil kepada penggunaan, seperti harga berasaskan penggunaan atau kredit dengan kad kadar yang tepat, melindungi margin bagi setiap permintaan. Hibrid dengan peruntukan termasuk mengehadkan ekor sambil mengekalkan asas yang boleh diramal. Kerusi tetap meninggalkan risiko paling banyak pada anda. Pilihan yang betul juga bergantung pada tahap ketidakpastian yang sanggup diterima pembeli anda.
Apa yang patut saya ukur dahulu?
Mulakan dengan kos inferens setiap pelanggan dan taburannya merentasi akaun, terutamanya bahagian kos daripada 10% pengguna teratas anda. Kemudian jejaki kos setiap tugasan yang disiapkan dan bukannya setiap permintaan, serta margin kasar mengikut kohort penggunaan. Ketiga-tiganya menunjukkan sama ada harga anda sepadan dengan tempat kos timbul.
Bacaan Berkaitan

Co-Founder & COO
On this page
- Latihan berbanding inferens
- Mengapa inferens berkelakuan seperti kos berubah
- Bagaimana kos setiap permintaan menjadi margin kasar
- Contoh yang dikira dengan angka ilustrasi
- Apa yang berlaku apabila penggunaan setiap tugasan meningkat
- Ekor pengguna berat
- Bagaimana pilihan model harga menentukan siapa menanggung risiko
- Trend jangka panjang: lebih murah setiap unit, lebih banyak unit setiap tugasan
- Apa yang perlu diukur
- Bacaan Berkaitan