Anwendungsschicht vs. Modellschicht in der KI
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Jedes KI-Startup sitzt irgendwo in einem Stack. Manche bauen Chips und Rechenzentren. Manche trainieren die großen Modelle, die alle anderen mieten. Manche verdrahten diese Modelle zu Werkzeugen, und manche verkaufen ein fertiges Produkt an einen Kunden, der nie von einem Token gehört hat. Welche Schicht Sie wählen, entscheidet darüber, wie viel Kapital Sie brauchen, wie schnell Ihre Kosten fallen und wer Sie kopieren kann.
Die Formel „Anwendungsschicht vs. Modellschicht“ ist die Kurzform der wichtigsten Entscheidung auf dieser Karte. Die Modellschicht ist teuer, von Skaleneffekten getrieben und von Giganten überfüllt. Die Anwendungsschicht ist günstiger zu betreten, näher am Kunden und einem anderen Risiko ausgesetzt: Die Schicht unter Ihnen kann über Nacht verändern, was möglich ist.
Dieser Artikel stellt die vier Schichten dar, was der Wettbewerb in jeder kostet und wie Venture-Investoren und Forscher argumentiert haben, dass sich der Wert auf sie verteilt. Wenn Sie ein B2B-Unternehmen führen und entscheiden, ob Sie mit KI bauen, oder ein Startup in diesem Feld bewerten, ist dies die Karte, die Sie im Kopf behalten sollten.
Der Stack der generativen KI in vier Schichten
Die meisten Analysen des Stacks nutzen drei Schichten: Infrastruktur, Modelle und Anwendungen. Die Firma a16z beschrieb im Januar 2023 genau diese Aufteilung: Anwendungen, die Modelle zu Nutzern bringen, die Modelle selbst (angeboten als proprietäre APIs oder Open-Source-Checkpoints) und die Infrastruktur aus Cloud-Plattformen und Hardwareherstellern, auf der Training und Inferenz laufen.
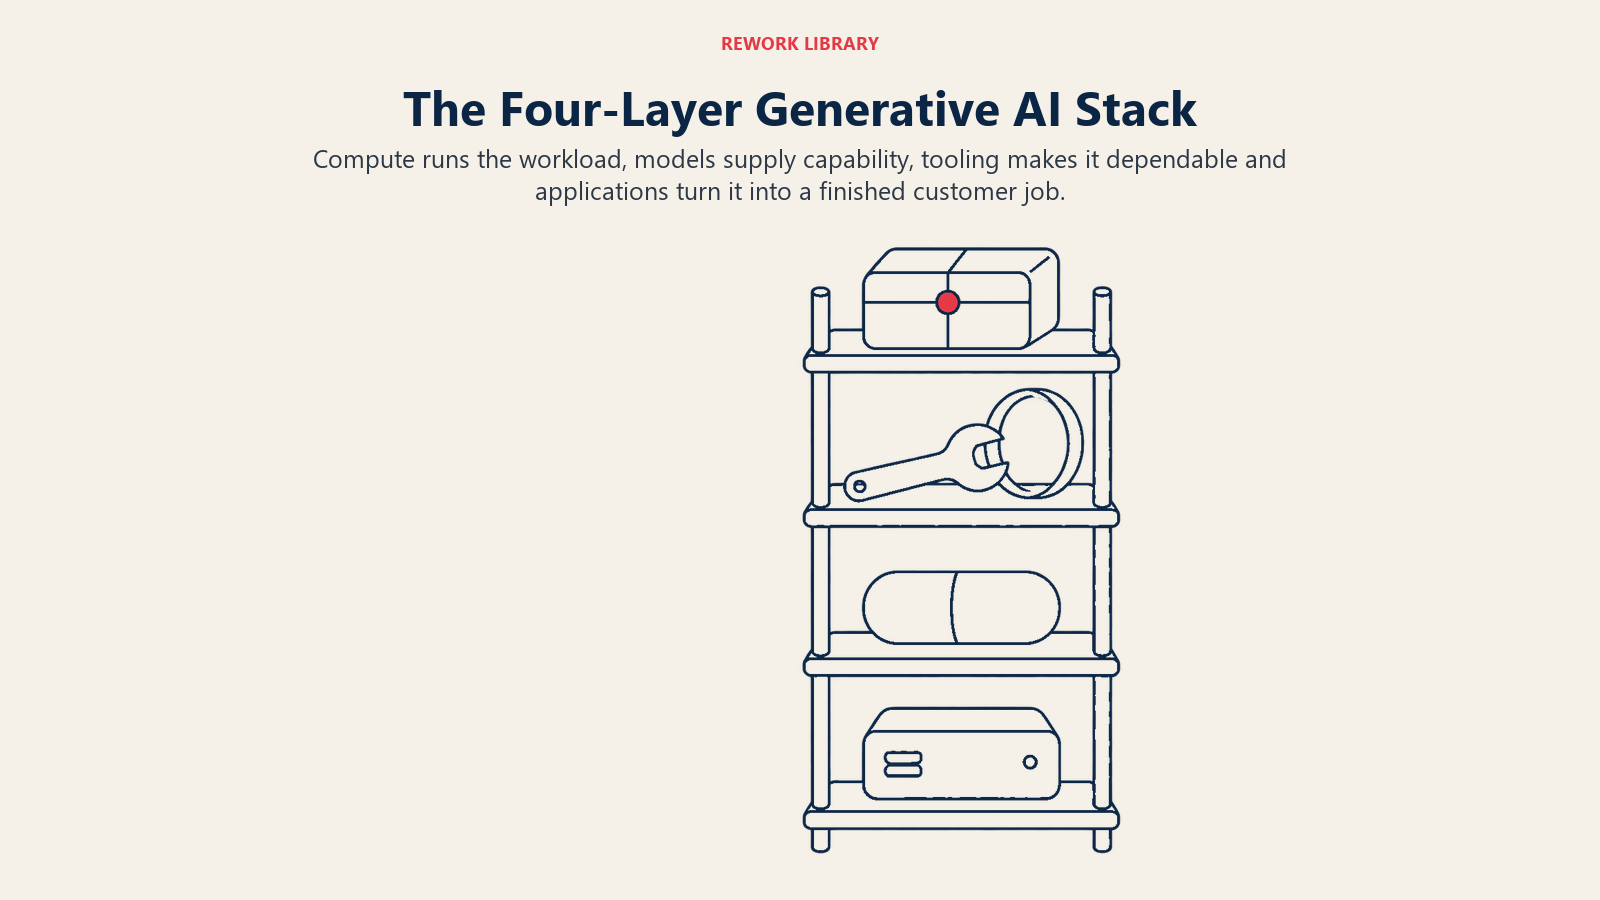
In der Praxis ist in der Mitte eine vierte Schicht entstanden. Es ist das Tooling, das rohe Modelle mit echter Arbeit verbindet: Retrieval, Orchestrierung, Evaluation, Guardrails und die Verrohrung, die einen Modellaufruf in einen verlässlichen Workflow verwandelt. Sie herauszulösen macht das Bild klarer, denn viele Startups leben dort.
| Schicht | Was sie verkauft | Typischer Kunde | Kapitalintensität | Hauptrisiko |
|---|---|---|---|---|
| Rechenleistung und Infrastruktur | Chips, Cloud-Kapazität, Hosting für Training und Inferenz | Modellbauer, Großunternehmen | Sehr hoch | Commodity-Preise, Abschreibung der Hardware |
| Foundation Model | Allzweckmodelle per API oder mit offenen Gewichten | Entwickler, Tooling-Firmen, Unternehmen | Sehr hoch | Schnelle Nachahmung, fallender Preis pro Fähigkeit |
| Tooling und Orchestrierung | Retrieval, Agent-Frameworks, Evaluation, Monitoring | Entwickler und Produktteams | Mäßig | Vom Modell oder der Cloud aufgesogen zu werden |
| Anwendung | Ein fertiges Produkt, das einen bestimmten Job löst | Geschäftsnutzer und Verbraucher | Gering bis mäßig | Retention, Differenzierung, Margendruck |
Zwei Dinge fallen auf. Erstens sinkt die Kapitalintensität, je weiter oben Sie sind. Zweitens sinkt auch Ihre Kontrolle über die Inputs. Ein Anwendungsunternehmen legt die Kosten des genutzten Modells nicht fest und kann nicht verhindern, dass das Modell bei genau der Aufgabe besser wird, die es verkauft.
Was jede Schicht tatsächlich tut
Rechenleistung und Infrastruktur. Diese Schicht liefert die physische und Cloud-Kapazität, die alles andere möglich macht. Es ist ein Skalenspiel: wenige Unternehmen mit enormen Bilanzen, lange Vorlaufzeiten für Hardware und eine Nachfrage, die von den Schichten darüber abhängt. Startups gewinnen hier selten, es sei denn, sie bringen einen wirklich anderen Ansatz bei Hardware oder beim effizienten Betrieb von Modellen mit.
Foundation Models. Das sind die großen Allzweckmodelle, trainiert auf breiten Daten. Sie sind das Nächste, was der Stack an einem Motor hat. Ein Labor trainiert ein Modell und verkauft dann den Zugang dazu für Tausende Anwendungsfälle. Weil dasselbe Modell viele Käufer bedient, belohnt die Ökonomie, wer das meiste Kapital, die meiste Rechenleistung und die meisten Talente hat, zumindest an der Spitze.
Tooling und Orchestrierung. Das ist die Middleware. Ein gutes Beispiel für einen Archetyp ist ein Unternehmen, das Teams hilft zu bewerten, ob die Antworten eines Modells stimmen, oder eines, das die Retrieval-Pipeline verwaltet, die ein Modell mit den Dokumenten eines Kunden füttert. Es bedient Bauende, nicht Endnutzer, sein Schicksal hängt also davon ab, wie viele Bauende es gibt.
Die Anwendungsschicht. Hier ist das Produkt ein erledigter Job, kein Modell. Ein Tool zur Vertragsprüfung auf einem Foundation Model eines Drittanbieters, ein Support-Assistent, trainiert auf dem Help Center eines Unternehmens, ein Coding-Assistent im Editor: Jedes verpackt Modellfähigkeit in einen Workflow, eine Benutzeroberfläche und eine Datenanbindung, die ein Unternehmen tatsächlich kauft. Wie die dünnsten Versionen dieser Schicht kritisiert werden, behandeln wir in AI Wrapper vs. AI-native.
Wo Startups konkurrieren und was es kostet
Die Eintrittskosten unterscheiden sich um Größenordnungen. Epoch AI schätzte im Juni 2024, dass die amortisierten Hardware- und Energiekosten des letzten Trainingslaufs von Frontier-Modellen seit 2016 um das 2,4-fache pro Jahr gewachsen waren, und warnte, dass die größten Trainingsläufe bis 2027 mehr als eine Milliarde Dollar kosten würden. Epochs Aufschlüsselung für große Modelle setzte Hardware bei 47 bis 67 Prozent der Entwicklungskosten an, Personal bei 29 bis 49 Prozent und Energie bei 2 bis 6 Prozent. Das ist eine Projektion von 2024, verstehen Sie sie also als Richtung, nicht als aktuelles Preisschild. Doch die Richtung erklärt, warum die Foundation-Schicht so aussieht, wie sie aussieht: eine Handvoll gut finanzierter Labore plus Open-Weight-Initiativen, die große Unternehmen tragen.
Für einen typischen Gründer mit einem Team von 20 und einer Seed- oder Series-A-Runde schließt diese Rechnung das Rennen um Frontier-Modelle aus. Übrig bleiben die Anwendungs- und Tooling-Schichten sowie die günstigeren Ränder der Modellschicht (kleine spezialisierte Modelle, Fine-Tunes offener Gewichte). Wenn Sie abwägen, ob Sie ein Modell anpassen oder es per Prompts steuern, führt Fine-Tuning vs. Prompting für Agents durch diese Entscheidung.
Warum fühlt sich die Anwendungsschicht erreichbarer an? Weil der Preis der Fähigkeit unter ihr weiter fällt. Der Stanford AI Index berichtete in seiner Ausgabe 2025, dass die Inferenzkosten für ein System, das einem Frontier-Modell von Anfang 2023 entspricht, zwischen November 2022 und Oktober 2024 um mehr als das 280-fache sanken und dass die Hardwarekosten jährlich um 30 Prozent gesunken sind. Ein Produkt, das 2022 unwirtschaftlich war, kann profitabel sein, bis Sie es ausliefern. Die neueste Ausgabe zeigt, dass die Industrie inzwischen über 90 Prozent der bedeutenden Frontier-Modelle hervorbringt, was verrät, wer die Spitze mit Ausgaben vorantreibt und warum der Rest des Marktes sie als gegebenen Input behandelt.
Wichtige Fakten: Schichten des KI-Stacks
- a16zs frühe Analyse fand, dass Infrastrukturanbieter den Großteil der Dollar abschöpften, die durch den Stack flossen, während App-Unternehmen mit Retention, Differenzierung und Bruttomargen kämpften (veröffentlicht im Januar 2023).
- Dieselbe Analyse berichtete, dass App-Unternehmen etwa 20 bis 40 Prozent des Umsatzes für Inferenz und Fine-Tuning pro Kunde ausgaben, mit Bruttomargen von in einigen Fällen bis zu 90 Prozent bis häufiger 50 bis 60 Prozent.
- Die KI-Ausgaben der Unternehmen für generative KI erreichten 2025 $37 Milliarden, nach $11,5 Milliarden 2024, davon $19 Milliarden für die Anwendungsschicht und $18 Milliarden für die Infrastrukturschicht (Menlo Ventures, Dezember 2025).
- Foundation-Model-APIs machten laut demselben Bericht von Menlo Ventures $12,5 Milliarden dieser Unternehmensausgaben 2025 aus.
- Die Trainingskosten an der Spitze sind seit 2016 um etwa das 2,4-fache pro Jahr gewachsen (Epoch AI, Juni 2024).
- Die Inferenzkosten für Frontier-Leistung von Anfang 2023 sanken von November 2022 bis Oktober 2024 um mehr als das 280-fache (Stanford AI Index 2025).
Wie sich der Wert Argumenten zufolge ansammelt
Die ehrliche Antwort ist, dass sich die Argumentation verschoben hat und sich weiter verschiebt. Drei Momentaufnahmen zeigen den Wandel.
Anfang 2023: Infrastruktur gewinnt zuerst. Die oben zitierte Analyse von a16z schloss, dass Infrastrukturanbieter bisher wahrscheinlich die größten Gewinner waren. Anwendungen zeigten starkes Umsatzwachstum, kämpften aber mit Retention, Produktdifferenzierung und Bruttomargen, und Modellanbieter hatten noch keine große kommerzielle Größe erreicht. Zu diesem Zeitpunkt blieb das Geld, das durch den Stack floss, überwiegend unten hängen.
Ende 2023: Die App-Schicht braucht einen eigenen Burggraben. Sequoias Generative AI's Act Two (September 2023) sagte, die Autoren hätten erwartet, dass sich Anwendungs- und Foundation-Model-Unternehmen sauber trennen würden, doch das sei noch nicht geschehen, und die erfolgreichsten nutzerseitigen Anwendungen seien von Anfang an vertikal integriert gewesen. Er argumentierte, dass Workflows und Nutzernetzwerke dauerhaftere Vorteile zu schaffen schienen als Daten, da die nächste Generation von Foundation Models einen Datenburggraben auslöschen könne. Er wies auch auf schwache Retention hin: Die mediane generative KI-App zeigte ein Verhältnis von 14 Prozent täglich zu monatlich aktiven Nutzern, weit unter den besten Consumer-Apps.
Mitte 2024: Die Infrastrukturrechnung muss bezahlt werden. Sequoias AI's $600B Question (Juni 2024) argumentierte, dass das für GPUs ausgegebene Kapital den Umsatz, den KI-Produkte erzeugten, weit überstieg, und beschrieb eine Lücke von etwa $500 Milliarden pro Jahr. Seine Aussage zum Wert lautete, dass fallende Rechenpreise gut für Bauende und langfristige Innovation sind, aber schlecht für Investoren, die darauf gewettet haben, dass die Preise halten.
Ende 2025: Die Ausgaben fließen zu den Apps. Der Unternehmensbericht 2025 von Menlo Ventures fand, dass mehr als die Hälfte der Unternehmensausgaben für generative KI, $19 Milliarden von $37 Milliarden, in die Anwendungsschicht ging. Darin entfielen auf horizontale KI $8,4 Milliarden, auf abteilungsbezogene KI $7,3 Milliarden und auf vertikale KI $3,5 Milliarden. Der Bericht fand außerdem, dass KI-Käufer mit 47 Prozent konvertierten, verglichen mit 25 Prozent bei traditioneller Software.
Legen Sie diese Momentaufnahmen nebeneinander, ergibt sich ein nützliches, wenn auch vorläufiges Muster. Anfangs sammelten sich die Dollar dort, wo die knappen Inputs lagen. Als die Inputs billiger und die Modelle gut genug wurden, wanderten die Unternehmensbudgets zu Produkten, die einen Job zu Ende bringen. Keine dieser Quellen ist eine Prognose der Zukunft, und jede ist die Sicht einer Firma, oft mit eigenem Interesse an der Antwort. Aber die Richtung ist konsistent genug, um darum herum zu planen.
Die Ökonomie jeder Schicht
So funktioniert das Geld auf jeder Ebene tendenziell, auf Grundlage der obigen Quellen und der üblichen Unit-Economics-Logik.
| Schicht | Umsatzform | Kostenform | Was die Marge bestimmt |
|---|---|---|---|
| Rechenleistung und Infrastruktur | Nutzungsbasiert, große Verträge | Riesiges Kapital im Voraus, Abschreibung der Hardware | Auslastung und Preissetzungsmacht |
| Foundation Model | API-Nutzung, Lizenzierung | Trainingsläufe, Personal, Betriebskosten | Skalierung, Effizienz, Differenzierung der Fähigkeit |
| Tooling und Orchestrierung | Abonnements, Nutzungsstufen | Engineering-lastig, mäßige Cloud-Ausgaben | Ob es ein eigenständiges Produkt bleibt |
| Anwendung | Seats, Nutzung, Ergebnisse | Modellnutzung pro Kunde, Support, Vertrieb | Wie viel der Modellkosten Sie weitergeben können |
Für Anwendungsunternehmen ist die wichtigste Zahl die Bruttomarge. Software wurde historisch für Margen in den 70ern und 80ern geschätzt. KI-Produkte tragen bei jeder Nutzung variable Kosten, weil jede Anfrage ein Modell aufruft. Deshalb war a16zs frühe Feststellung wichtig, dass 20 bis 40 Prozent des Umsatzes in Inferenz und Fine-Tuning flossen: Das Margenprofil klassischer Software galt nicht automatisch. Ob das heute noch die richtige Spanne ist, hängt vom Produkt, vom Modellmix und davon ab, wie die Nutzung bepreist wird. Prüfen Sie daher für jedes Unternehmen, das Sie bewerten, die aktuellen Zahlen, statt sie anzunehmen.
Es gibt einen zweiten Effekt. Weil die Modellschicht pro Einheit Fähigkeit billiger wird, können die Kosten einer Anwendung ohne Ihr Zutun fallen. Aber auch die Kosten Ihrer Wettbewerber können fallen, und ebenso der Preis, den Kunden akzeptieren. Fallende Input-Preise helfen jedem Anbieter auf der Anwendungsschicht, sodass die Differenzierung von etwas anderem als dem Modell selbst kommen muss.
Anwendungsschicht versus Modellschicht: So wählen Sie
Stellen Sie sich die Entscheidung als drei Fragen vor.
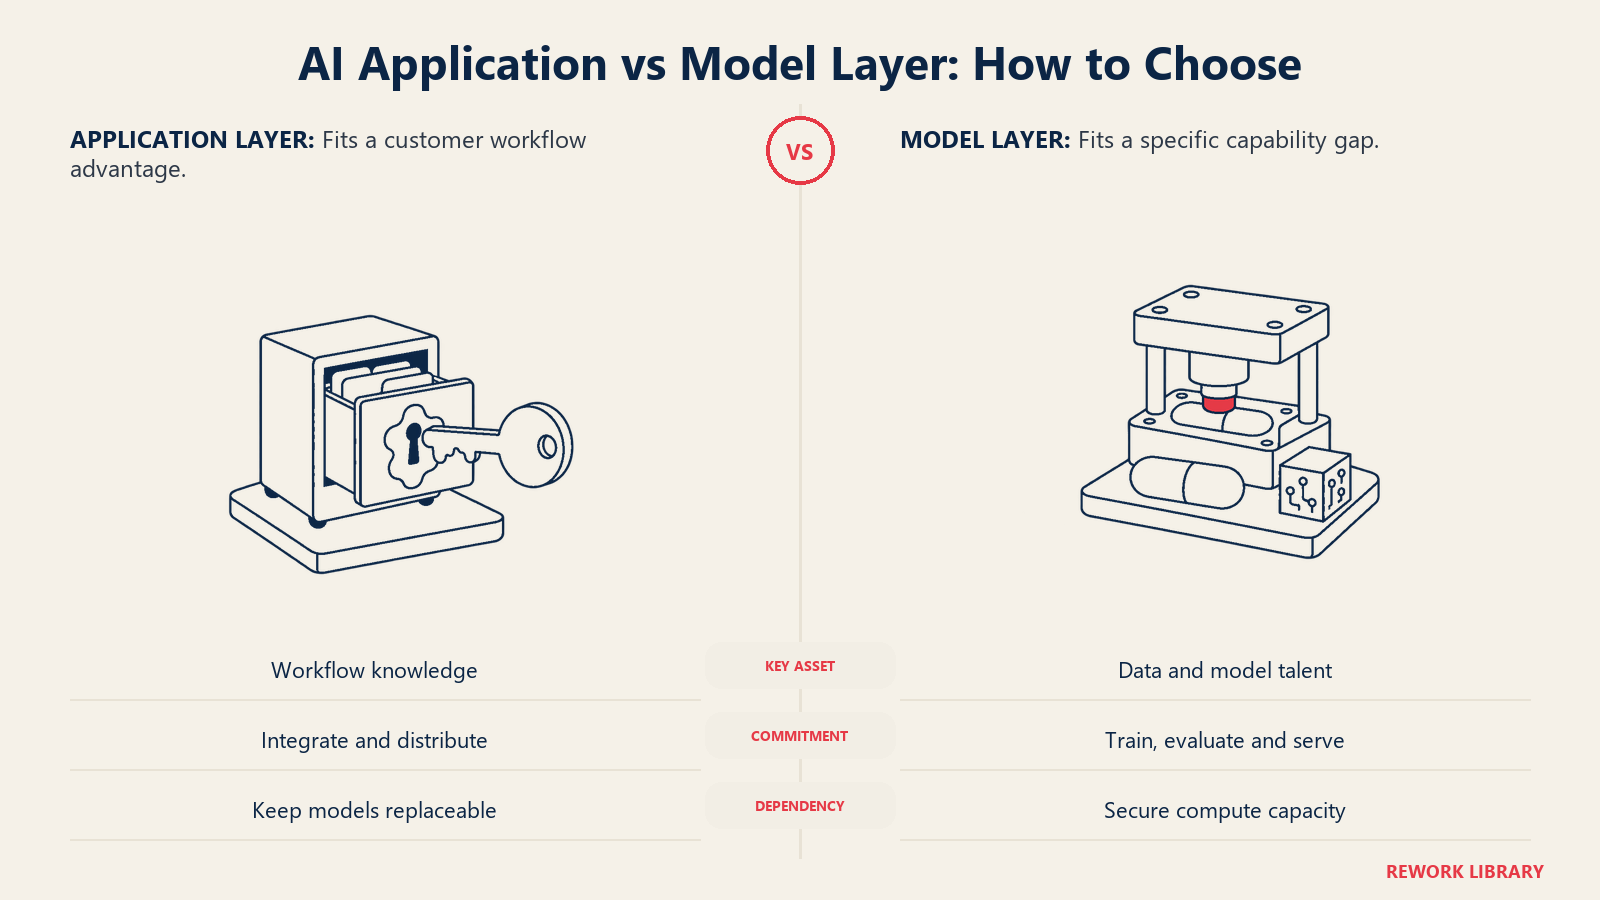
Haben Sie einen Grund, das Modell zu besitzen? Wenn Ihr Vorteil eine Fähigkeit ist, die ein allgemeines Modell nicht liefern kann, etwa eine enge Domäne mit proprietären Daten und dem Bedarf nach enger Kontrolle über Latenz oder Datenschutz, gehört womöglich ein spezialisiertes oder fein abgestimmtes Modell in Ihren Stack. Wenn Ihr Vorteil darin besteht, den Workflow eines Kunden zu verstehen, ist es meist die bessere Wette, das Modell zu mieten. Die Abwägungen behandelt Kaufen vs. Bauen bei KI-Funktionen für SaaS.
Wo liegt Ihr dauerhafter Vorteil? Sequoias Argument zu Workflows und Nutzernetzwerken weist auf die Anwendungsschicht, wo ein Vorteil aus Distribution, Integration in die Systeme eines Kunden und über die Zeit aufgebautem Vertrauen kommen kann. Ein Modellvorteil kann vom nächsten Release eingeholt werden. Ein Workflow, der in den Tagesablauf eines Teams eingebettet ist, ist schwerer zu verdrängen. Zum Rahmen hinter diesem Denken siehe Wettbewerbspositionierung.
Wie abhängig sind Sie von der Schicht unter Ihnen? Jede Anwendung hängt von einem Modelllieferanten ab, und jeder Modellbauer hängt von Rechenleistung ab. Die Wertschöpfungskette Ihres eigenen Produkts zu kartieren zeigt, welche Lieferanten Sie tauschen könnten und welche nicht. Unternehmen, die zwischen Modellen wechseln können, behalten ihre Verhandlungsmacht, und Unternehmen, die das nicht können, sind eine Preisänderung von einem Margenproblem entfernt.
Ein nützlicher Test: Wenn sich das Modell unter Ihrem Produkt im nächsten Quartal verzehnfachte, würde Ihr Geschäft stärker oder verschwände es? Wird es stärker, weil Sie den Workflow, die Kundenbeziehung und die Daten besitzen, bauen Sie eine dauerhafte Anwendung. Verschwindet es, weil Ihr ganzes Produkt ein einziger kluger Prompt war, bauen Sie etwas Fragiles. Diesen zweiten Fall betrachten wir in AI Wrapper vs. AI-native.
Schichten versus Fokus: vertikal und horizontal
Die Schicht, die Sie wählen, ist eine Achse. Die andere ist die Breite. Eine horizontale Anwendung bedient eine Funktion branchenübergreifend, eine vertikale bedient eine einzelne Branche in der Tiefe. Menlos Aufteilung für 2025 zeigt, dass beide echte Budgets haben, mit horizontal bei $8,4 Milliarden und vertikal bei $3,5 Milliarden. Wir vergleichen die beiden in vertikale KI vs. horizontale KI, und wie jede Schicht Geld verdient, steht in Geschäftsmodelle von KI-Startups.
Häufige Fehldeutungen des Stacks
„Die Modellschicht nimmt sich alles.“ Es ist verlockend zu denken, die Labore würden jeden Anwendungsfall aufsaugen. Die Analyse von Sequoia weist in die andere Richtung: Die erfolgreichsten Anwendungen waren vertikal integriert, was nahelegt, dass der Besitz von Workflow und Nutzer so viel zählt wie das Modell. Doch das Risiko ist für dünne Produkte real, denn ein Modell, das bei einer Aufgabe besser wird, kann ein Produkt auslöschen, das auf der Lücke gebaut ist.
„Die Anwendungsschicht ist nur ein Wrapper.“ Manche Anwendungen sind es. Viele nicht. Ein Produkt, das sich in die Systeme eines Unternehmens einbettet, dessen Kontext ansammelt und dessen Prozesse lernt, tut weit mehr, als Text an ein Modell weiterzureichen. Die Kritik trifft auf die dünnsten Fälle zu und ist für den Rest unfair.
„Infrastruktur gewinnt immer.“ Die Analyse von 2023 fand, dass die Infrastruktur die meisten Dollar abschöpfte, und das stimmte für diesen Moment. Doch die Analyse von 2024 argumentierte, dass die Umsatzbasis den Ausgaben noch nicht gefolgt war, und die Daten von 2025 zeigen, dass sich die Unternehmensbudgets zu Anwendungen neigen. Positionen im Stack verschieben sich im Zeitverlauf.
„Wählen Sie eine Schicht und bleiben Sie dort.“ Viele Unternehmen überspannen Schichten. Eine vertikale Anwendung kann ein kleines Modell fein abstimmen, und ein Modellunternehmen kann eine eigene Anwendung ausliefern. Der Stack ist eine Möglichkeit, Abhängigkeiten und Ökonomie zu verstehen, kein Satz von Mauern.
Was das für Gründer bedeutet
Beginnen Sie mit dem Job des Kunden, nicht mit der Schicht. Wählen Sie die Schicht, mit der Sie diesen Job mit dem wenigsten Kapital und dem dauerhaftesten Vorteil lösen, und gestalten Sie dann mit Blick darauf, dass sich die Schichten um Sie herum ändern. Halten Sie Ihren Modelllieferanten austauschbar, messen Sie Ihre Bruttomarge pro Kunde vom ersten Tag an und bauen Sie die Teile des Produkts, die ein besseres Modell nicht kopieren kann: Ihre Integrationen, Ihren Workflow, Ihre Datenposition und Ihre Beziehungen.
Der Stack ist außerdem ein bewegliches Ziel. Der Preis pro Einheit Fähigkeit sinkt, die Zahl kompetenter Modelle wächst, und das Unternehmensbudget wandert zu Produkten, die Arbeit zu Ende bringen. Überprüfen Sie Ihre Schichtwahl mindestens einmal im Jahr.
Weiterführende Lektüre
- AI Wrapper vs. AI-native
- Vertikale KI vs. horizontale KI
- Geschäftsmodelle von KI-Startups
- Was ist ein AI-natives Startup?
- Kaufen vs. Bauen bei KI-Funktionen für SaaS
- Bruttomarge
Häufig gestellte Fragen zu Anwendungsschicht vs. Modellschicht in der KI
Was ist der Unterschied zwischen der Anwendungsschicht und der Modellschicht in der KI?
Die Modellschicht trainiert und betreibt Allzweckmodelle, die viele Produkte nutzen können. Die Anwendungsschicht verpackt Modellfähigkeit in ein fertiges Produkt für einen bestimmten Job, mit Workflow, Oberfläche und Anbindung an Kundendaten. Modellunternehmen verkaufen Fähigkeit, Anwendungsunternehmen verkaufen Ergebnisse.
Wo konkurrieren KI-Startups üblicherweise?
Die meisten Startups konkurrieren auf der Anwendungs- und der Tooling-Schicht, weil das Training von Frontier-Modellen kapitalintensiv ist. Epoch AI schätzte, dass die Trainingskosten an der Spitze seit 2016 um das 2,4-fache pro Jahr gewachsen sind, und prognostizierte Läufe über einer Milliarde Dollar bis 2027. Kleinere Teams mieten meist ein Modell oder stimmen ein offenes fein ab.
Welche Schicht schöpft den meisten Wert ab?
Das hängt vom Zeitraum und von der Quelle ab. a16z schloss Anfang 2023, dass Infrastrukturanbieter die meisten Dollar abschöpften, während Menlo Ventures Ende 2025 fand, dass $19 Milliarden der $37 Milliarden an Unternehmensausgaben für generative KI in Anwendungen gingen. Jede ist die Sicht einer Firma, behandeln Sie sie also als Evidenz, nicht als gesicherte Tatsache.
Sind KI-Anwendungen nur Wrapper um Modelle?
Manche sind es, und sie sind am verwundbarsten, wenn sich Modelle verbessern. Andere betten sich in die Systeme eines Kunden ein, lernen dessen Workflows und halten dessen Daten, was ihnen einen Vorteil gibt, den ein Modell-Upgrade nicht auslöscht. Ob ein Produkt fragil oder dauerhaft ist, hängt davon ab, was es über das Modell hinaus besitzt.
Warum unterscheiden sich die Bruttomargen von KI-Anwendungen von traditioneller Software?
Jede Nutzung ruft ein Modell auf, was variable Kosten erzeugt. a16z berichtete Anfang 2023, dass App-Unternehmen etwa 20 bis 40 Prozent des Umsatzes für Inferenz und Fine-Tuning pro Kunde ausgaben, mit Bruttomargen eher bei 50 bis 60 Prozent als bei 90 Prozent. Aktuelle Zahlen variieren je nach Produkt und Preisgestaltung, prüfen Sie sie daher für jedes Unternehmen.
Sollte ein Startup ein eigenes Modell bauen?
Nur, wenn ein allgemeines Modell die Fähigkeit nicht liefern kann und Sie die Daten, die Talente und das Kapital haben, es zu tragen. Für die meisten B2B-Produkte ist es günstiger und schneller, ein Modell zu mieten und den Workflow darum zu bauen. Sie können ein Modell später immer noch spezialisieren, sobald die Nutzung den Bedarf belegt.

Co-Founder & COO
On this page
- Der Stack der generativen KI in vier Schichten
- Was jede Schicht tatsächlich tut
- Wo Startups konkurrieren und was es kostet
- Wie sich der Wert Argumenten zufolge ansammelt
- Die Ökonomie jeder Schicht
- Anwendungsschicht versus Modellschicht: So wählen Sie
- Schichten versus Fokus: vertikal und horizontal
- Häufige Fehldeutungen des Stacks
- Was das für Gründer bedeutet
- Weiterführende Lektüre