Bahasa Indonesia
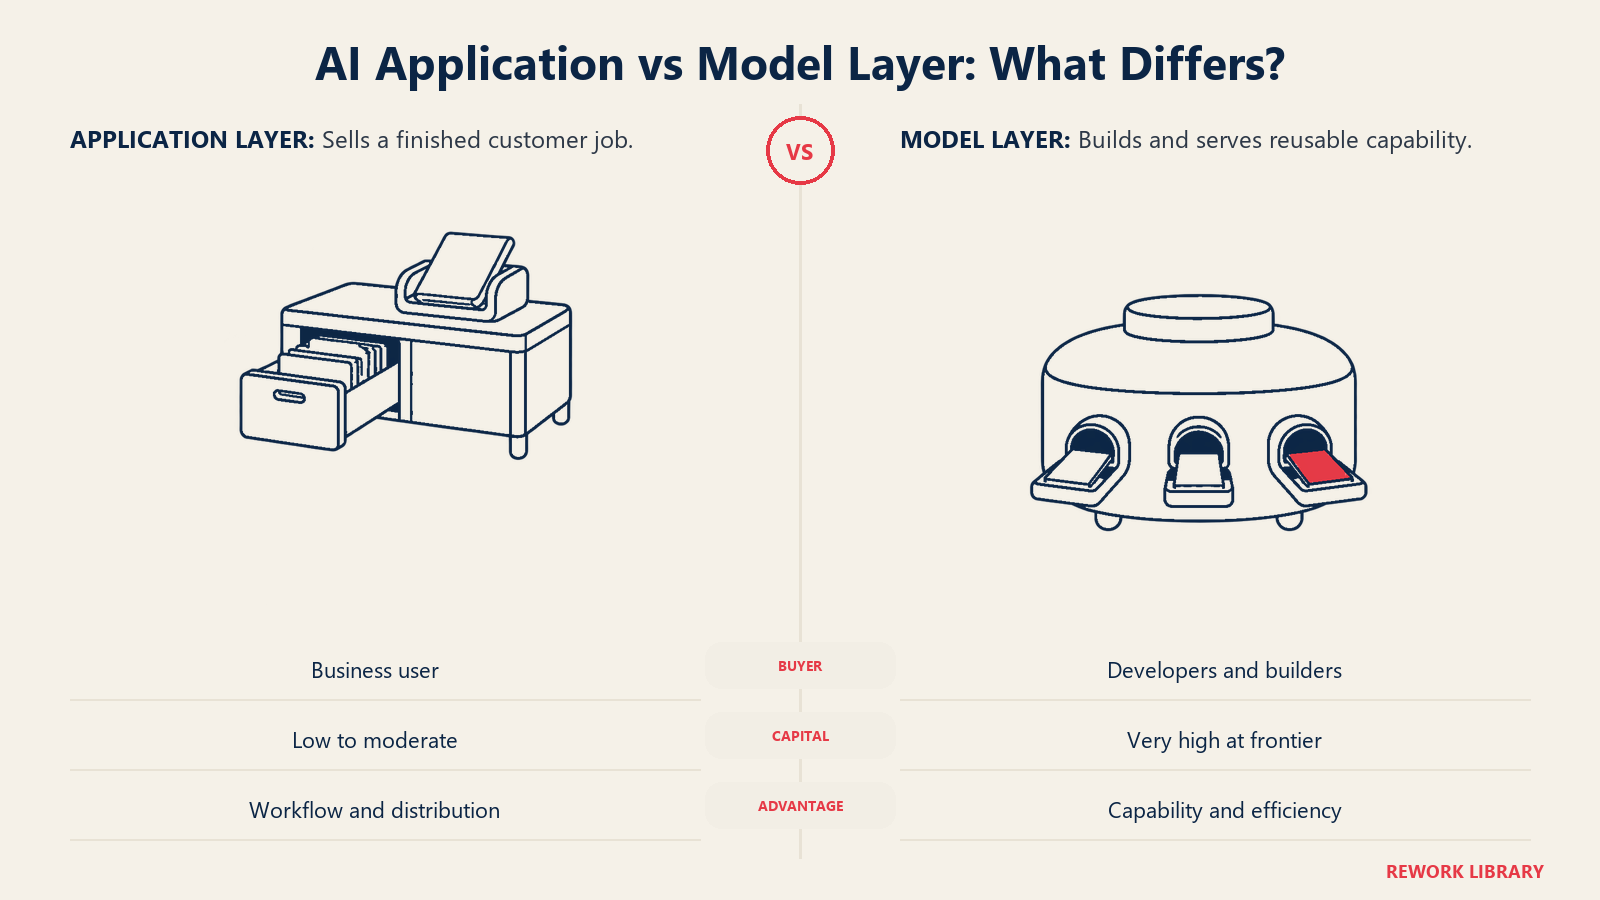
Lapisan Aplikasi vs Lapisan Model dalam AI
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Setiap startup AI berada di suatu titik pada sebuah tumpukan. Ada yang membangun chip dan pusat data. Ada yang melatih model besar yang disewa semua orang. Ada yang menghubungkan model-model itu ke dalam alat, dan ada yang menjual produk jadi kepada pelanggan yang belum pernah mendengar istilah token. Lapisan mana yang Anda pilih menentukan berapa modal yang Anda butuhkan, seberapa cepat biaya Anda turun, dan siapa yang dapat menyalin Anda.
Frasa "lapisan aplikasi vs lapisan model" adalah singkatan untuk pilihan terpenting pada peta itu. Lapisan model mahal, digerakkan oleh skala, dan dipenuhi raksasa. Lapisan aplikasi lebih murah dimasuki, lebih dekat ke pelanggan, dan terpapar risiko yang berbeda: lapisan di bawah Anda dapat mengubah apa yang mungkin dilakukan dalam semalam.
Artikel ini memaparkan keempat lapisan, berapa biaya untuk bersaing di masing-masing, dan bagaimana investor ventura serta para peneliti berargumen tentang penyebaran nilai di antara lapisan-lapisan itu. Jika Anda menjalankan perusahaan B2B dan memutuskan apakah akan membangun dengan AI, atau sedang mengevaluasi startup di bidang ini, inilah peta yang perlu Anda simpan di kepala.
Tumpukan generative AI dalam empat lapisan
Sebagian besar analisis tumpukan memakai tiga lapisan: infrastruktur, model, dan aplikasi. Firma a16z menggambarkan pembagian persis seperti itu pada Januari 2023: aplikasi yang membawa model kepada pengguna, model itu sendiri (ditawarkan sebagai API proprietari atau checkpoint sumber terbuka), dan infrastruktur platform cloud serta pembuat perangkat keras yang menjalankan pelatihan dan inferensi.
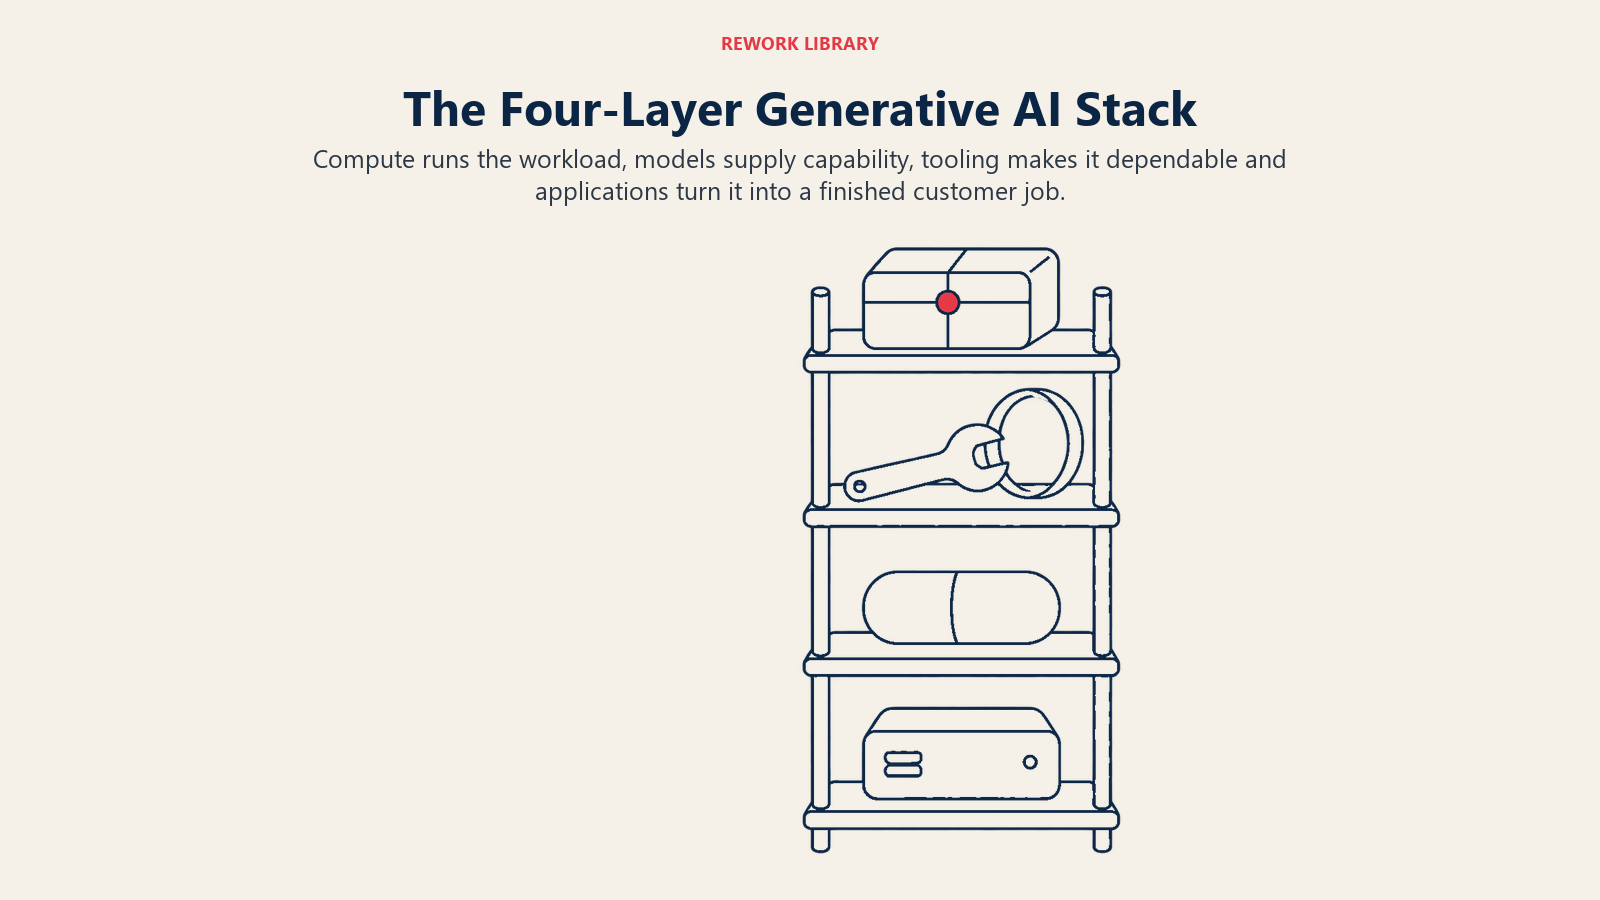
Dalam praktik, lapisan keempat telah tumbuh di tengah. Itu adalah perkakas yang menghubungkan model mentah dengan pekerjaan nyata: retrieval, orkestrasi, evaluasi, guardrail, dan pipa yang mengubah panggilan model menjadi alur kerja yang dapat diandalkan. Memisahkannya membuat gambaran lebih jelas, karena banyak startup berada di sana.
| Lapisan | Yang dijual | Pelanggan tipikal | Intensitas modal | Risiko utama |
|---|---|---|---|---|
| Komputasi dan infrastruktur | Chip, kapasitas cloud, hosting pelatihan dan inferensi | Pembangun model, perusahaan besar | Sangat tinggi | Harga komoditas, depresiasi perangkat keras |
| Foundation model | Model serba guna lewat API atau open weights | Developer, firma perkakas, perusahaan | Sangat tinggi | Peniruan cepat, harga per kapabilitas yang terus turun |
| Perkakas dan orkestrasi | Retrieval, kerangka agen, evaluasi, pemantauan | Developer dan tim produk | Sedang | Terserap ke dalam model atau cloud |
| Aplikasi | Produk jadi yang menyelesaikan pekerjaan tertentu | Pengguna bisnis dan konsumen | Rendah hingga sedang | Retensi, diferensiasi, himpitan margin |
Dua hal yang perlu dicatat. Pertama, intensitas modal menurun saat Anda naik ke atas. Kedua, begitu pula kendali Anda atas input. Perusahaan aplikasi tidak menentukan biaya model yang dipakainya, dan tidak dapat mencegah model menjadi lebih baik pada tugas yang justru dijualnya.
Apa yang sebenarnya dilakukan tiap lapisan
Komputasi dan infrastruktur. Lapisan ini menyediakan kapasitas fisik dan cloud yang memungkinkan segala hal lainnya. Ini permainan skala: segelintir perusahaan dengan neraca raksasa, waktu tunggu perangkat keras yang panjang, dan permintaan yang bergantung pada lapisan di atasnya. Startup jarang menang di sini kecuali membawa pendekatan yang benar-benar berbeda terhadap perangkat keras atau cara melayani model secara efisien.
Foundation model. Ini adalah model serba guna berukuran besar yang dilatih pada data yang luas. Inilah hal yang paling mendekati mesin dalam tumpukan. Sebuah lab melatih satu model lalu menjual aksesnya untuk ribuan kasus penggunaan. Karena model yang sama melayani banyak pembeli, ekonominya menguntungkan pihak yang memiliki modal, komputasi, dan talenta terbanyak, setidaknya di garis depan.
Perkakas dan orkestrasi. Ini adalah middleware. Contoh yang baik dari arketipenya adalah perusahaan yang membantu tim mengevaluasi apakah jawaban model akurat, atau perusahaan yang mengelola pipeline retrieval yang menyuplai model dengan dokumen pelanggan. Lapisan ini melayani para pembangun, bukan pengguna akhir, sehingga nasibnya terkait dengan berapa banyak pembangun yang ada.
Lapisan aplikasi. Di sini produknya adalah pekerjaan yang selesai, bukan model. Alat peninjau kontrak yang dibangun di atas foundation model pihak ketiga, asisten dukungan yang dilatih pada pusat bantuan perusahaan, asisten pemrograman di dalam editor: masing-masing membungkus kapabilitas model dalam alur kerja, antarmuka pengguna, dan koneksi data yang benar-benar dibeli bisnis. Jika Anda penasaran bagaimana versi paling tipis dari lapisan ini dikritik, kami membahasnya di AI wrapper vs AI native.
Di mana startup bersaing dan berapa biayanya
Biaya masuk berbeda berorde-orde besarnya. Epoch AI memperkirakan pada Juni 2024 bahwa biaya perangkat keras dan energi yang diamortisasi untuk putaran pelatihan akhir model frontier telah tumbuh 2,4 kali per tahun sejak 2016, dan memperingatkan bahwa putaran pelatihan terbesar akan menelan lebih dari satu miliar dolar pada 2027. Rincian Epoch untuk model-model besar menempatkan perangkat keras pada 47 hingga 67 persen biaya pengembangan, staf pada 29 hingga 49 persen, dan energi pada 2 hingga 6 persen. Itu proyeksi dari 2024, jadi anggaplah sebagai arah, bukan label harga saat ini. Namun arah itu menjelaskan mengapa lapisan foundation tampak seperti sekarang: segelintir lab yang didanai besar, ditambah upaya open-weight yang didukung perusahaan-perusahaan besar.
Bagi founder tipikal dengan tim 20 orang dan putaran seed atau Series A, perhitungan itu menyingkirkan perlombaan model frontier. Yang tersisa adalah lapisan aplikasi dan perkakas, serta tepian yang lebih murah dari lapisan model (model khusus berukuran kecil, fine-tune dari open weights). Jika Anda menimbang apakah akan menyesuaikan model atau mengarahkannya dengan prompt, fine-tuning vs prompting untuk agen menguraikan keputusan itu.
Mengapa lapisan aplikasi terasa lebih terjangkau? Karena harga kapabilitas terus turun di bawahnya. Stanford AI Index melaporkan dalam edisi 2025 bahwa biaya inferensi untuk sistem yang menyamai model kelas frontier awal 2023 turun lebih dari 280 kali lipat antara November 2022 dan Oktober 2024, dan bahwa biaya perangkat keras menurun 30 persen per tahun. Produk yang tidak ekonomis pada 2022 bisa menguntungkan saat Anda merilisnya. Edisi terbaru menunjukkan industri kini menghasilkan lebih dari 90 persen model frontier yang menonjol, yang memberi tahu Anda siapa yang membelanjakan dana untuk mendorong garis depan, dan mengapa sisa pasar memperlakukannya sebagai input yang sudah tersedia.
Fakta Utama: Lapisan-Lapisan Tumpukan AI
- Analisis awal a16z menemukan bahwa vendor infrastruktur menangkap sebagian besar dolar yang mengalir melalui tumpukan, sementara perusahaan aplikasi kesulitan dengan retensi, diferensiasi, dan margin kotor (terbit Januari 2023).
- Analisis yang sama melaporkan perusahaan aplikasi membelanjakan sekitar 20 hingga 40 persen pendapatan untuk inferensi dan fine-tuning per pelanggan, dengan margin kotor mulai dari setinggi 90 persen dalam beberapa kasus hingga lebih sering 50 sampai 60 persen.
- Belanja generative AI enterprise mencapai $37 miliar pada 2025, naik dari $11,5 miliar pada 2024, dengan $19 miliar mengalir ke lapisan aplikasi dan $18 miliar ke lapisan infrastruktur (Menlo Ventures, Desember 2025).
- API foundation model menyumbang $12,5 miliar dari belanja enterprise 2025 tersebut, menurut laporan Menlo Ventures yang sama.
- Biaya pelatihan frontier telah tumbuh sekitar 2,4 kali per tahun sejak 2016 (Epoch AI, Juni 2024).
- Biaya inferensi untuk performa kelas frontier awal 2023 turun lebih dari 280 kali lipat dari November 2022 hingga Oktober 2024 (Stanford AI Index 2025).
Bagaimana nilai diargumenkan terakumulasi
Jawaban yang jujur adalah bahwa argumennya telah bergeser, dan masih bergeser. Tiga potret menunjukkan pergeserannya.
Awal 2023: infrastruktur menang lebih dulu. Analisis a16z yang dikutip di atas menyimpulkan bahwa vendor infrastruktur kemungkinan pemenang terbesar sejauh ini. Aplikasi menunjukkan pertumbuhan pendapatan yang kuat tetapi kesulitan dengan retensi, diferensiasi produk, dan margin kotor, dan penyedia model belum mencapai skala komersial besar. Pada titik itu, uang yang mengalir melalui tumpukan sebagian besar berhenti di bawah.
Akhir 2023: lapisan aplikasi membutuhkan paritnya sendiri. Generative AI's Act Two dari Sequoia (September 2023) menyatakan bahwa para penulis semula mengharapkan perusahaan aplikasi dan foundation model terpisah dengan rapi, tetapi hal itu belum terjadi, dan bahwa aplikasi berorientasi pengguna yang paling sukses sejak awal justru terintegrasi secara vertikal. Tulisan itu berargumen bahwa alur kerja dan jaringan pengguna tampaknya menciptakan keunggulan yang lebih tahan lama daripada data, karena generasi foundation model berikutnya dapat menghapus parit data. Tulisan itu juga menandai retensi yang lemah: aplikasi generative AI median menunjukkan rasio pengguna aktif harian-ke-bulanan 14 persen, jauh di bawah aplikasi konsumen terbaik.
Pertengahan 2024: tagihan infrastruktur harus dibayar. AI's $600B Question dari Sequoia (Juni 2024) berargumen bahwa modal yang dibelanjakan untuk GPU jauh melampaui pendapatan yang dihasilkan produk AI, dan menggambarkan kesenjangan sekitar $500 miliar per tahun. Poinnya soal nilai: harga komputasi yang turun baik bagi pembangun dan inovasi jangka panjang, tetapi buruk bagi investor yang bertaruh bahwa harga akan bertahan.
Akhir 2025: belanja mengalir ke aplikasi. Laporan enterprise 2025 dari Menlo Ventures menemukan bahwa lebih dari separuh belanja generative AI enterprise, $19 miliar dari $37 miliar, mengalir ke lapisan aplikasi. Di dalamnya, AI horizontal mengambil $8,4 miliar, AI departemental $7,3 miliar, dan AI vertikal $3,5 miliar. Laporan itu juga menemukan bahwa pembeli AI melakukan konversi sebesar 47 persen dibandingkan 25 persen untuk perangkat lunak tradisional.
Letakkan potret-potret itu berdampingan dan Anda mendapat pola yang berguna, walau masih sementara. Pada awalnya, dolar menumpuk di tempat input langka berada. Seiring input menjadi lebih murah dan model cukup baik, anggaran enterprise bergeser ke produk yang menuntaskan pekerjaan. Tidak satu pun sumber ini adalah ramalan masa depan, dan masing-masing adalah pandangan satu firma, sering kali dengan kepentingan pada jawabannya. Namun arahnya cukup konsisten untuk dijadikan dasar perencanaan.
Ekonomi tiap lapisan
Berikut cara uang cenderung bekerja di tiap tingkat, berdasarkan sumber di atas dan logika unit economics standar.
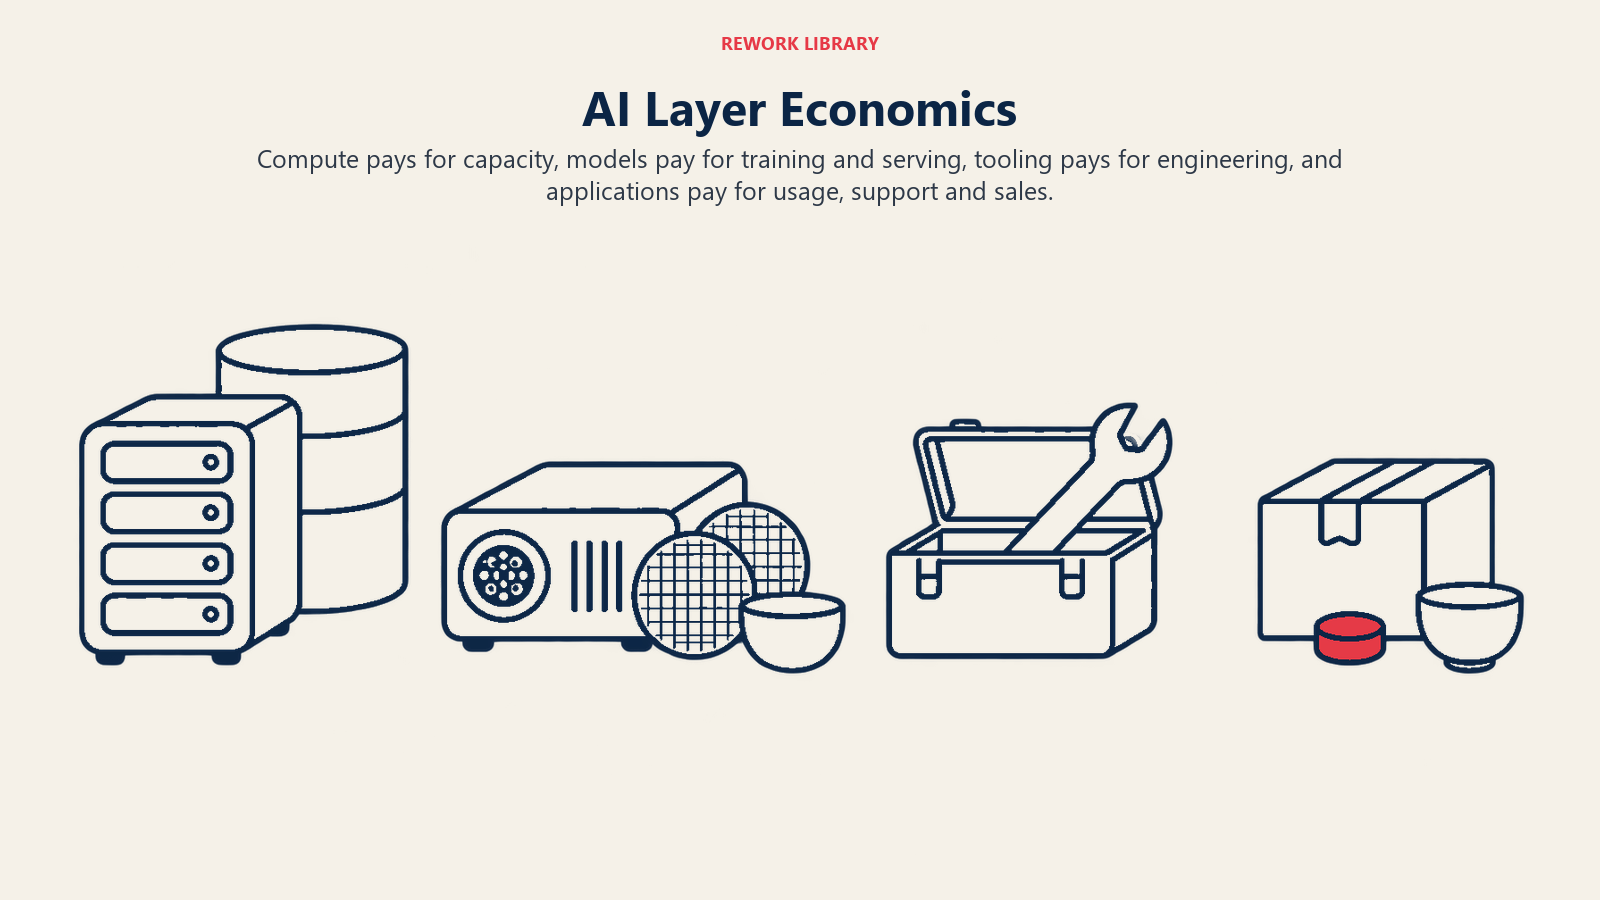
| Lapisan | Bentuk pendapatan | Bentuk biaya | Penentu margin |
|---|---|---|---|
| Komputasi dan infrastruktur | Berbasis penggunaan, kontrak besar | Modal awal besar, depresiasi perangkat keras | Utilisasi dan kekuatan penetapan harga |
| Foundation model | Penggunaan API, lisensi | Putaran pelatihan, staf, biaya penyajian | Skala, efisiensi, diferensiasi kapabilitas |
| Perkakas dan orkestrasi | Langganan, tingkatan penggunaan | Padat rekayasa, belanja cloud sedang | Apakah tetap menjadi produk tersendiri |
| Aplikasi | Seat, penggunaan, hasil | Pemakaian model per pelanggan, dukungan, penjualan | Seberapa banyak biaya model yang dapat diteruskan |
Bagi perusahaan aplikasi, angka terpenting adalah margin kotor. Perangkat lunak secara historis dihargai karena margin di kisaran 70-an dan 80-an. Produk AI membawa biaya variabel pada setiap pemakaian, karena setiap permintaan memanggil model. Itulah mengapa temuan awal a16z tentang 20 hingga 40 persen pendapatan yang mengalir ke inferensi dan fine-tuning penting: artinya profil margin perangkat lunak lama tidak otomatis berlaku. Apakah itu masih kisaran yang tepat hari ini bergantung pada produk, campuran model, dan cara pemakaian dihargai, jadi periksa angka terkini untuk setiap perusahaan yang Anda evaluasi, jangan berasumsi.
Ada efek kedua. Karena lapisan model makin murah per unit kapabilitas, biaya sebuah aplikasi bisa turun tanpa kerja apa pun dari sisi Anda. Namun begitu pula biaya pesaing Anda, dan begitu pula harga yang akan diterima pelanggan. Turunnya harga input membantu setiap pendatang di lapisan aplikasi, yang membuat diferensiasi harus datang dari tempat lain selain model itu sendiri.
Lapisan aplikasi versus lapisan model: cara memilih
Pikirkan keputusan ini sebagai tiga pertanyaan.
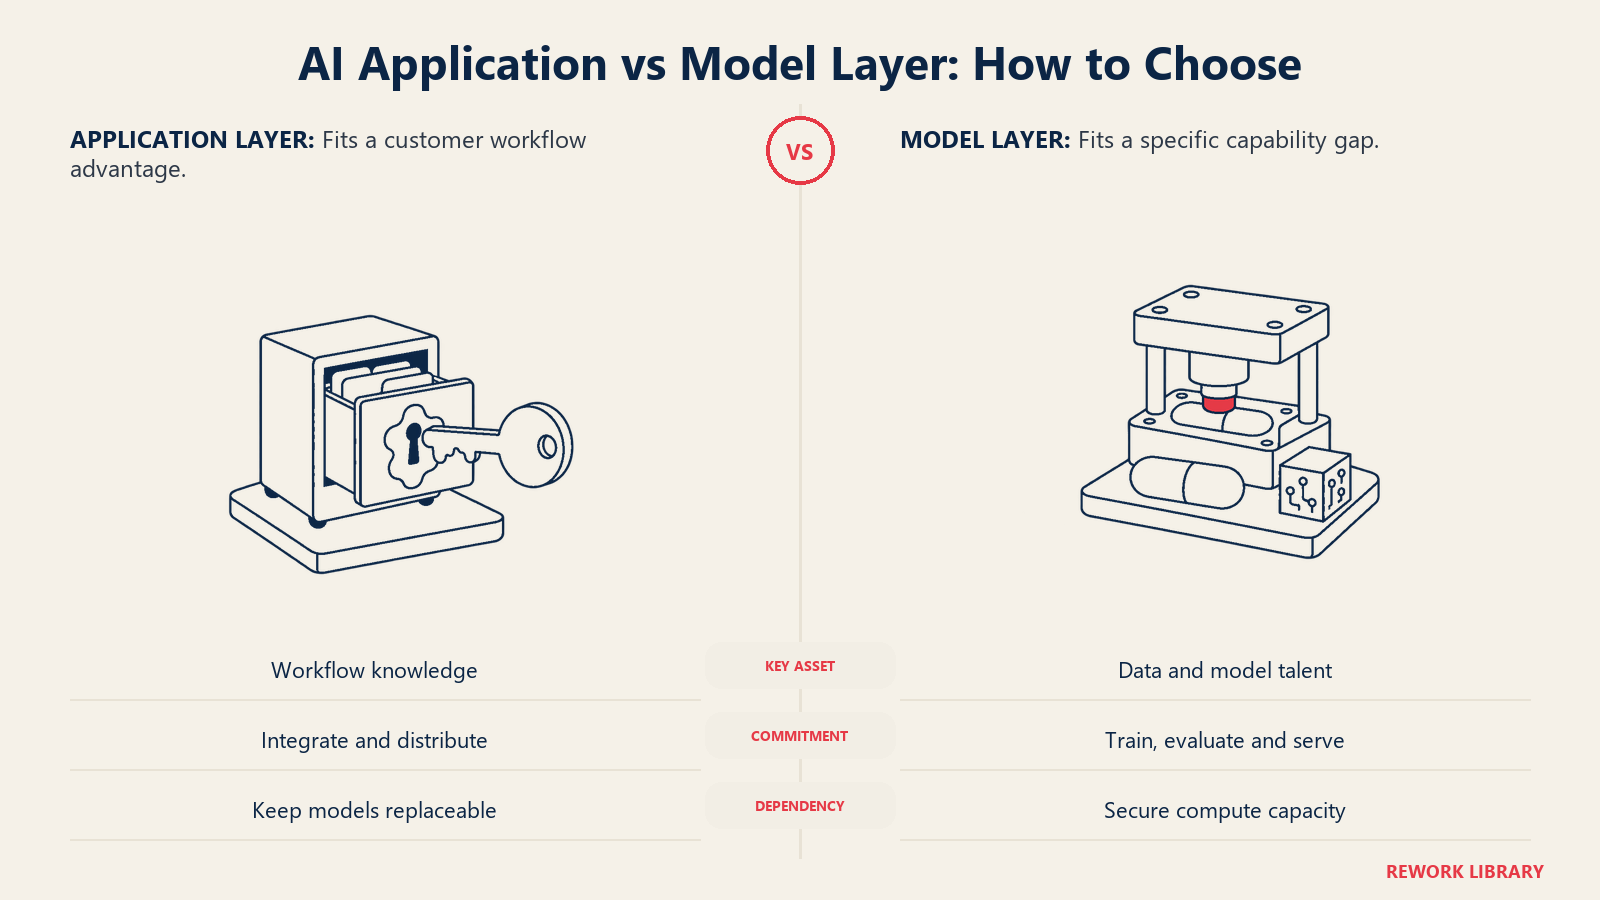
Apakah Anda punya alasan untuk memiliki modelnya? Jika keunggulan Anda adalah kapabilitas yang tidak dapat diberikan model umum, seperti domain sempit dengan data proprietari dan kebutuhan kendali ketat atas latensi atau privasi, model khusus atau hasil fine-tune mungkin layak masuk ke tumpukan Anda. Jika keunggulan Anda adalah memahami alur kerja pelanggan, menyewa model biasanya taruhan yang lebih baik. Pertukarannya dibahas di buy vs build untuk fitur AI SaaS.
Di mana keunggulan tahan lama Anda berada? Argumen Sequoia tentang alur kerja dan jaringan pengguna menunjuk ke lapisan aplikasi, tempat keunggulan dapat datang dari distribusi, integrasi dengan sistem pelanggan, dan kepercayaan yang dibangun seiring waktu. Keunggulan model dapat disamai oleh rilis berikutnya. Alur kerja yang tertanam dalam rutinitas harian tim lebih sulit digeser. Untuk kerangka di balik pemikiran itu, lihat positioning kompetitif.
Seberapa terpapar Anda pada lapisan di bawah? Setiap aplikasi bergantung pada pemasok model, dan setiap pembangun model bergantung pada komputasi. Memetakan rantai nilai produk Anda sendiri menunjukkan pemasok mana yang bisa Anda tukar dan mana yang tidak. Perusahaan yang dapat berpindah antar model mempertahankan daya tawarnya, dan perusahaan yang tidak bisa hanya berjarak satu perubahan harga dari masalah margin.
Uji yang berguna: jika model di bawah produk Anda membaik sepuluh kali lipat kuartal depan, apakah bisnis Anda makin kuat atau lenyap? Jika makin kuat karena Anda memiliki alur kerja, hubungan pelanggan, dan data, Anda sedang membangun aplikasi yang tahan lama. Jika lenyap karena seluruh produk Anda hanya satu prompt yang cerdik, Anda sedang membangun sesuatu yang rapuh. Kasus kedua itu kami bahas di AI wrapper vs AI native.
Lapisan versus fokus: vertikal dan horizontal
Lapisan yang Anda pilih adalah satu sumbu. Sumbu lainnya adalah luas cakupan. Aplikasi horizontal melayani satu fungsi lintas industri, dan aplikasi vertikal melayani satu industri secara mendalam. Pemilahan Menlo 2025 menunjukkan keduanya punya anggaran nyata, dengan horizontal $8,4 miliar dan vertikal $3,5 miliar. Kami membandingkan keduanya di AI vertikal vs AI horizontal, dan cara tiap lapisan menghasilkan uang ada di model bisnis startup AI.
Salah baca yang umum tentang tumpukan ini
"Lapisan model akan mengambil segalanya." Menggoda untuk berpikir bahwa lab akan menyerap setiap kasus penggunaan. Analisis Sequoia menunjuk arah sebaliknya: aplikasi paling sukses terintegrasi secara vertikal, yang menyiratkan bahwa memiliki alur kerja dan pengguna sama pentingnya dengan model. Tetapi risikonya nyata bagi produk tipis, karena model yang makin pandai pada suatu tugas dapat menghapus produk yang dibangun di atas celah itu.
"Lapisan aplikasi hanyalah wrapper." Sebagian aplikasi memang begitu. Banyak yang tidak. Produk yang tertanam dalam sistem perusahaan, mengakumulasi konteksnya, dan mempelajari prosesnya melakukan jauh lebih banyak daripada meneruskan teks ke model. Kritik itu akurat untuk kasus paling tipis dan tidak adil untuk sisanya.
"Infrastruktur selalu menang." Analisis 2023 menemukan infrastruktur menangkap sebagian besar dolar, dan itu benar untuk momen tersebut. Tetapi analisis 2024 berargumen bahwa basis pendapatan belum mengejar belanja, dan data 2025 menunjukkan anggaran enterprise condong ke aplikasi. Posisi dalam tumpukan bergeser seiring waktu.
"Pilih satu lapisan dan bertahan di sana." Banyak perusahaan mengangkangi beberapa lapisan. Aplikasi vertikal dapat men-fine-tune model kecil, dan perusahaan model dapat merilis aplikasinya sendiri. Tumpukan adalah cara memahami ketergantungan dan ekonomi, bukan seperangkat dinding.
Apa artinya bagi founder
Mulailah dari pekerjaan pelanggan, bukan lapisan. Pilih lapisan yang memungkinkan Anda menyelesaikan pekerjaan itu dengan modal paling sedikit dan keunggulan paling tahan lama, lalu rancang untuk perubahan di lapisan sekitar Anda. Jaga agar pemasok model Anda dapat diganti, ukur margin kotor Anda per pelanggan sejak hari pertama, dan bangun bagian produk yang tidak dapat disalin model yang lebih baik: integrasi, alur kerja, posisi data, dan hubungan Anda.
Tumpukan ini juga target yang bergerak. Harga per unit kapabilitas terus turun, jumlah model yang kompeten bertambah, dan anggaran enterprise bergeser ke produk yang menuntaskan pekerjaan. Tinjau ulang pilihan lapisan Anda setidaknya setahun sekali.
Bacaan Terkait
- AI wrapper vs AI native
- AI vertikal vs AI horizontal
- Model bisnis startup AI
- Apa itu startup AI-native
- Buy vs build untuk fitur AI SaaS
- Margin kotor
Pertanyaan yang Sering Diajukan tentang Lapisan Aplikasi vs Lapisan Model AI
Apa perbedaan antara lapisan aplikasi dan lapisan model dalam AI?
Lapisan model melatih dan menyajikan model serba guna yang dapat dipakai banyak produk. Lapisan aplikasi mengemas kapabilitas model menjadi produk jadi untuk pekerjaan tertentu, dengan alur kerja, antarmuka, dan koneksi data pelanggan. Perusahaan model menjual kapabilitas, dan perusahaan aplikasi menjual hasil.
Di mana startup AI biasanya bersaing?
Sebagian besar startup bersaing di lapisan aplikasi dan perkakas, karena pelatihan model frontier padat modal. Epoch AI memperkirakan biaya pelatihan frontier tumbuh 2,4 kali per tahun sejak 2016 dan memproyeksikan putaran di atas satu miliar dolar pada 2027. Tim yang lebih kecil biasanya menyewa model atau men-fine-tune model terbuka.
Lapisan mana yang menangkap nilai terbanyak?
Tergantung pada periode dan sumbernya. a16z menyimpulkan pada awal 2023 bahwa vendor infrastruktur menangkap sebagian besar dolar, sementara Menlo Ventures menemukan pada akhir 2025 bahwa $19 miliar dari $37 miliar belanja generative AI enterprise mengalir ke aplikasi. Masing-masing adalah pandangan satu firma, jadi anggaplah sebagai bukti, bukan fakta yang sudah mapan.
Apakah aplikasi AI hanyalah wrapper di sekitar model?
Sebagian ya, dan itulah yang paling terpapar ketika model membaik. Yang lain tertanam dalam sistem pelanggan, mempelajari alur kerja mereka, dan menyimpan data mereka, yang memberi keunggulan yang tidak dihapus oleh peningkatan model. Apakah produk rapuh atau tahan lama bergantung pada apa yang dimilikinya di luar model.
Mengapa margin kotor aplikasi AI berbeda dari perangkat lunak tradisional?
Setiap pemakaian memanggil model, yang menciptakan biaya variabel. a16z melaporkan pada awal 2023 bahwa perusahaan aplikasi membelanjakan sekitar 20 hingga 40 persen pendapatan untuk inferensi dan fine-tuning per pelanggan, dengan margin kotor lebih sering 50 sampai 60 persen daripada 90 persen. Angka terkini bervariasi menurut produk dan harga, jadi periksa untuk tiap perusahaan.
Haruskah startup membangun modelnya sendiri?
Hanya jika model umum tidak dapat memberikan kapabilitas itu dan Anda memiliki data, talenta, dan modal untuk menopangnya. Untuk sebagian besar produk B2B, menyewa model dan membangun alur kerja di sekitarnya lebih murah dan lebih cepat. Anda selalu bisa mengkhususkan model nanti setelah pemakaian membuktikan kebutuhannya.

Co-Founder & COO
On this page
- Tumpukan generative AI dalam empat lapisan
- Apa yang sebenarnya dilakukan tiap lapisan
- Di mana startup bersaing dan berapa biayanya
- Bagaimana nilai diargumenkan terakumulasi
- Ekonomi tiap lapisan
- Lapisan aplikasi versus lapisan model: cara memilih
- Lapisan versus fokus: vertikal dan horizontal
- Salah baca yang umum tentang tumpukan ini
- Apa artinya bagi founder
- Bacaan Terkait