Camada de aplicação vs. camada de modelo em IA
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Toda startup de IA ocupa um lugar em uma stack. Algumas constroem chips e data centers. Algumas treinam os grandes modelos que todos os outros alugam. Algumas ligam esses modelos a ferramentas, e outras vendem um produto acabado a um cliente que nunca ouviu falar de token. A camada que você escolhe define quanto capital você precisa, com que rapidez seus custos caem e quem pode copiá-lo.
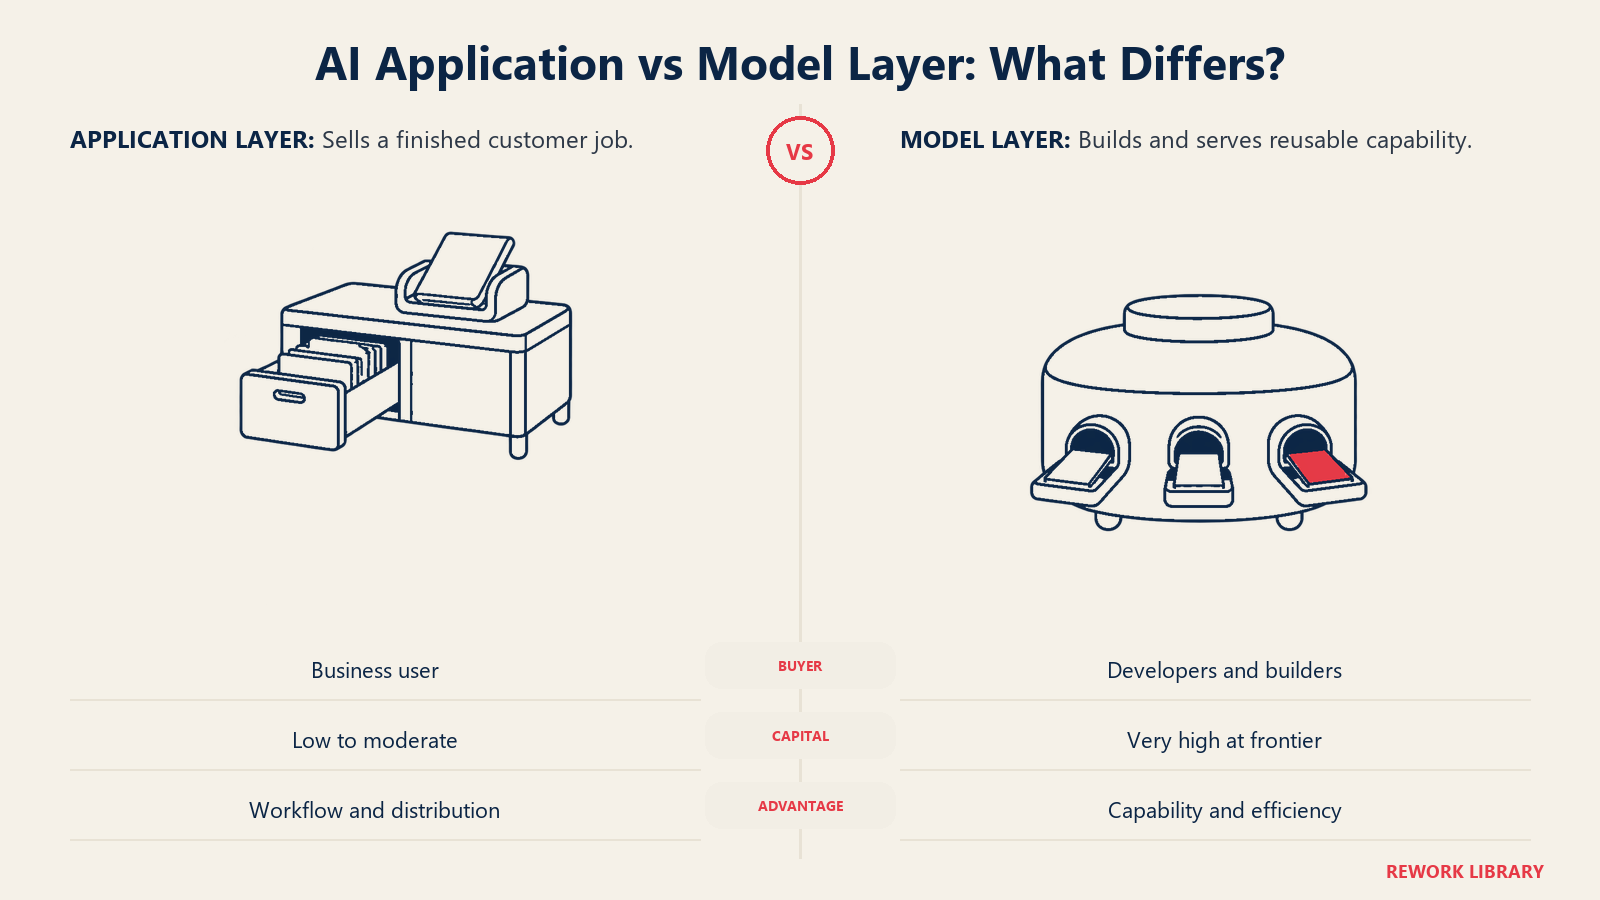
A expressão "camada de aplicação vs. camada de modelo" é um atalho para a escolha mais importante desse mapa. A camada de modelo é cara, movida a escala e lotada de gigantes. A camada de aplicação é mais barata de entrar, mais próxima do cliente e exposta a outro risco: a camada abaixo de você pode mudar o que é possível da noite para o dia.
Este artigo apresenta as quatro camadas, quanto custa competir em cada uma e como investidores de venture capital e pesquisadores argumentaram que o valor se distribui entre elas. Se você dirige uma empresa B2B e está decidindo se constrói com IA, ou avalia uma startup do setor, este é o mapa para ter na cabeça.
A stack de IA generativa em quatro camadas
A maioria das análises da stack usa três camadas: infraestrutura, modelos e aplicações. A empresa a16z descreveu exatamente essa divisão em janeiro de 2023: aplicações que levam modelos aos usuários, os próprios modelos (oferecidos como APIs proprietárias ou checkpoints de código aberto) e a infraestrutura de plataformas de nuvem e fabricantes de hardware que executa o treinamento e a inferência.
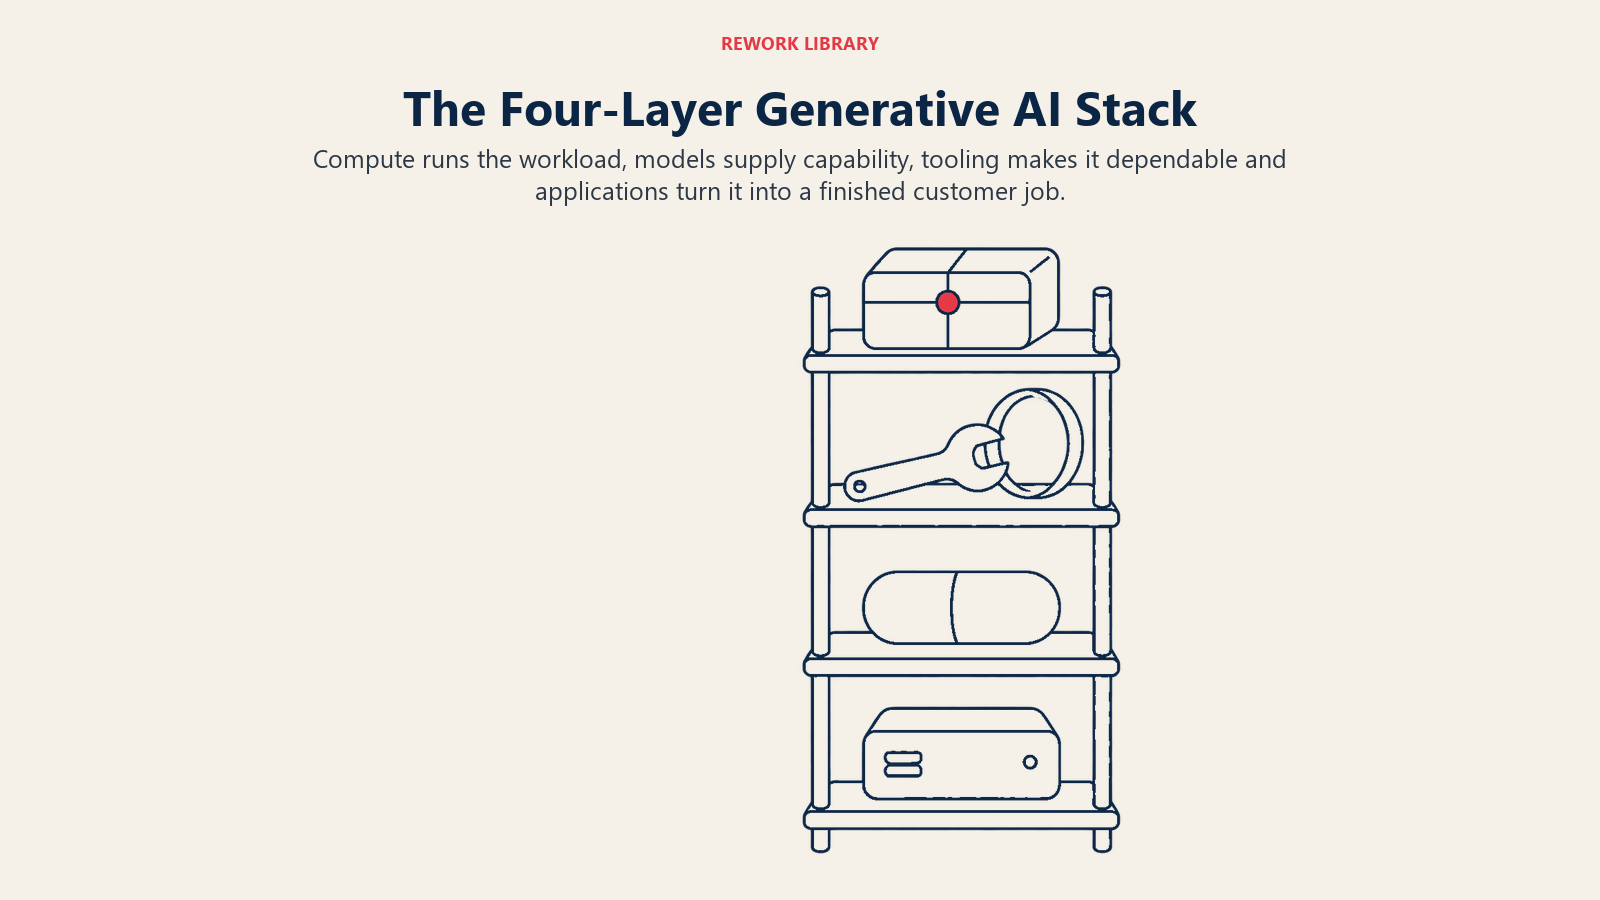
Na prática, uma quarta camada cresceu no meio. É o ferramental que conecta modelos brutos ao trabalho real: recuperação de informação, orquestração, avaliação, guardrails e a infraestrutura que transforma uma chamada de modelo em um fluxo de trabalho confiável. Separá-la deixa o quadro mais claro, porque muitas startups vivem ali.
| Camada | O que vende | Cliente típico | Intensidade de capital | Principal risco |
|---|---|---|---|---|
| Computação e infraestrutura | Chips, capacidade de nuvem, hospedagem de treinamento e inferência | Construtores de modelos, grandes empresas | Muito alta | Preços de commodity, depreciação do hardware |
| Modelo de fundação | Modelos de uso geral via API ou pesos abertos | Desenvolvedores, empresas de ferramental, grandes empresas | Muito alta | Imitação rápida, queda do preço por capacidade |
| Ferramental e orquestração | Recuperação, frameworks de agentes, avaliação, monitoramento | Desenvolvedores e times de produto | Moderada | Ser absorvido pelo modelo ou pela nuvem |
| Aplicação | Um produto acabado que resolve um trabalho específico | Usuários de negócios e consumidores | Baixa a moderada | Retenção, diferenciação, pressão sobre a margem |
Duas coisas a notar. Primeiro, a intensidade de capital cai conforme você sobe. Segundo, o controle sobre os insumos também. Uma empresa de aplicação não define o custo do modelo que usa e não consegue impedir que o modelo fique melhor justamente na tarefa que ela vende.
O que cada camada realmente faz
Computação e infraestrutura. Essa camada fornece a capacidade física e de nuvem que torna todo o resto possível. É um jogo de escala: poucas empresas com balanços enormes, longos prazos de entrega de hardware e uma demanda que depende das camadas acima. Startups raramente vencem aqui, a menos que tragam uma abordagem realmente diferente para o hardware ou para servir modelos com eficiência.
Modelos de fundação. São os modelos grandes e de uso geral treinados em dados amplos. São o que a stack tem de mais parecido com um motor. Um laboratório treina um modelo e depois vende acesso a ele para milhares de casos de uso. Como o mesmo modelo atende muitos compradores, a economia premia quem tem mais capital, computação e talento, pelo menos na fronteira.
Ferramental e orquestração. É o middleware. Um bom exemplo de arquétipo é a empresa que ajuda times a avaliar se as respostas de um modelo são precisas, ou a que gerencia o pipeline de recuperação que alimenta um modelo com os documentos de um cliente. Ela atende construtores, não usuários finais, então seu destino está ligado a quantos construtores existem.
A camada de aplicação. Aqui o produto é um trabalho feito, não um modelo. Uma ferramenta de revisão de contratos construída sobre um modelo de fundação de terceiros, um assistente de suporte treinado na central de ajuda de uma empresa, um assistente de código dentro de um editor: cada um embrulha a capacidade do modelo em um fluxo de trabalho, uma interface e uma conexão de dados que uma empresa de fato compra. Se você tem curiosidade sobre como as versões mais finas dessa camada são criticadas, tratamos disso em AI wrapper vs. AI-native.
Onde as startups competem e quanto custa
O custo de entrada difere em ordens de grandeza. A Epoch AI estimou em junho de 2024 que o custo amortizado de hardware e energia da execução final de treinamento de modelos de fronteira cresceu 2,4 vezes por ano desde 2016, e alertou que os maiores treinamentos custariam mais de um bilhão de dólares até 2027. A decomposição da Epoch para os principais modelos colocou o hardware em 47% a 67% do custo de desenvolvimento, a equipe em 29% a 49% e a energia em 2% a 6%. É uma projeção de 2024, então trate-a como uma direção, não como um preço atual. Mas a direção explica por que a camada de fundação tem a aparência que tem: um punhado de laboratórios bem financiados, além de iniciativas de pesos abertos apoiadas por grandes empresas.
Para um fundador típico, com uma equipe de 20 pessoas e uma rodada seed ou Série A, essa conta exclui a corrida pelo modelo de fronteira. Sobram as camadas de aplicação e de ferramental, e as bordas mais baratas da camada de modelo (modelos pequenos e especializados, fine-tunes de pesos abertos). Se você está pesando entre adaptar um modelo ou orientá-lo com prompts, fine-tuning vs. prompting para agentes percorre essa decisão.
Por que a camada de aplicação parece mais acessível? Porque o preço da capacidade continua caindo por baixo dela. O Stanford AI Index relatou, na edição de 2025, que o custo de inferência de um sistema equivalente a um modelo de classe de fronteira do início de 2023 caiu mais de 280 vezes entre novembro de 2022 e outubro de 2024 e que os custos de hardware vêm caindo 30% ao ano. Um produto que era inviável economicamente em 2022 pode ser lucrativo quando você o lançar. A edição mais recente mostra que a indústria hoje produz mais de 90% dos modelos de fronteira notáveis, o que indica quem está gastando para empurrar a fronteira e por que o resto do mercado a trata como um insumo dado.
Fatos principais: camadas da stack de IA
- A análise inicial da a16z constatou que os fornecedores de infraestrutura capturavam a maior parte dos dólares que fluíam pela stack, enquanto as empresas de aplicação enfrentavam dificuldades com retenção, diferenciação e margens brutas (publicada em janeiro de 2023).
- A mesma análise relatou empresas de aplicação gastando cerca de 20% a 40% da receita com inferência e fine-tuning por cliente, com margens brutas de até 90% em alguns casos, mas mais frequentemente entre 50% e 60%.
- O gasto corporativo com IA generativa chegou a US$ 37 bilhões em 2025, contra US$ 11,5 bilhões em 2024, com US$ 19 bilhões indo para a camada de aplicação e US$ 18 bilhões para a camada de infraestrutura (Menlo Ventures, dezembro de 2025).
- As APIs de modelos de fundação responderam por US$ 12,5 bilhões desse gasto corporativo de 2025, segundo o mesmo relatório da Menlo Ventures.
- O custo de treinamento de fronteira cresceu cerca de 2,4 vezes por ano desde 2016 (Epoch AI, junho de 2024).
- O custo de inferência para um desempenho de classe de fronteira do início de 2023 caiu mais de 280 vezes de novembro de 2022 a outubro de 2024 (Stanford AI Index 2025).
Como se argumentou que o valor se acumula
A resposta honesta é que o argumento mudou e ainda está mudando. Três retratos mostram a virada.
Início de 2023: a infraestrutura vence primeiro. A análise da a16z citada acima concluiu que os fornecedores de infraestrutura eram provavelmente os maiores vencedores até então. As aplicações mostravam forte crescimento de receita, mas tinham dificuldade com retenção, diferenciação de produto e margens brutas, e os provedores de modelos ainda não haviam alcançado grande escala comercial. Naquele momento, o dinheiro que fluía pela stack parava em grande parte na base.
Final de 2023: a camada de aplicação precisa do seu próprio fosso. O Generative AI's Act Two da Sequoia (setembro de 2023) disse que os autores esperavam que as empresas de aplicação e de modelos de fundação se separassem claramente, mas que isso ainda não havia acontecido, e que as aplicações voltadas ao usuário de maior sucesso logo de saída haviam sido verticalmente integradas. Argumentou que fluxos de trabalho e redes de usuários pareciam criar vantagens mais duráveis do que os dados, já que a próxima geração de modelos de fundação poderia apagar um fosso de dados. Também apontou a retenção fraca: o app de IA generativa mediano mostrava uma relação de 14% entre usuários ativos diários e mensais, muito abaixo dos melhores apps de consumo.
Meados de 2024: a conta da infraestrutura precisa ser paga. O [AI's \(600B Question](https://www.sequoiacap.com/article/ais-600b-question/) da Sequoia (junho de 2024) argumentou que o capital gasto em GPUs superava de longe a receita gerada pelos produtos de IA e descreveu uma lacuna de cerca de US\) 500 bilhões por ano. Seu ponto sobre valor era que a queda dos preços de computação é boa para os construtores e para a inovação de longo prazo, mas ruim para investidores que apostaram em preços estáveis.
Final de 2025: o gasto está fluindo para os apps. O relatório corporativo de 2025 da Menlo Ventures constatou que mais da metade do gasto corporativo com IA generativa, US$ 19 bilhões de US$ 37 bilhões, foi para a camada de aplicação. Dentro dela, a IA horizontal ficou com US$ 8,4 bilhões, a IA departamental com US$ 7,3 bilhões e a IA vertical com US$ 3,5 bilhões. O relatório também constatou que os compradores de IA convertiam a 47%, contra 25% do software tradicional.
Colocando esses retratos lado a lado, surge um padrão útil, ainda que provisório. No início, os dólares se concentraram onde estavam os insumos escassos. À medida que os insumos ficaram mais baratos e os modelos ficaram bons o bastante, os orçamentos corporativos migraram para produtos que concluem um trabalho. Nenhuma dessas fontes é uma previsão do futuro, e cada uma é a visão de uma empresa, muitas vezes com interesse na resposta. Mas a direção é consistente o suficiente para planejar em torno dela.
A economia de cada camada
Veja como o dinheiro costuma funcionar em cada nível, com base nas fontes acima e na lógica padrão de unit economics.
| Camada | Formato da receita | Formato do custo | O que define a margem |
|---|---|---|---|
| Computação e infraestrutura | Baseada em uso, grandes contratos | Enorme capital inicial, depreciação do hardware | Utilização e poder de precificação |
| Modelo de fundação | Uso de API, licenciamento | Execuções de treinamento, equipe, custos de servir | Escala, eficiência, diferenciação da capacidade |
| Ferramental e orquestração | Assinaturas, faixas de uso | Muita engenharia, gasto moderado com nuvem | Se continua sendo um produto separado |
| Aplicação | Seats, uso, resultados | Uso do modelo por cliente, suporte, vendas | Quanto do custo do modelo você consegue repassar |
Para empresas de aplicação, o número mais importante é a margem bruta. O software sempre foi valorizado por margens na casa dos 70% e 80%. Produtos de IA carregam um custo variável a cada uso, porque cada requisição chama um modelo. Por isso a constatação inicial da a16z, de 20% a 40% da receita indo para inferência e fine-tuning, importou: significava que o perfil de margem do software antigo não se aplicava automaticamente. Se essa ainda é a faixa certa hoje depende do produto, do mix de modelos e de como o uso é precificado, então confira os números atuais de qualquer empresa que esteja avaliando em vez de presumir.
Há um segundo efeito. Como a camada de modelo está ficando mais barata por unidade de capacidade, os custos de uma aplicação podem cair sem nenhum trabalho do seu lado. Mas os custos dos seus concorrentes também, e o preço que os clientes aceitam também. A queda dos preços dos insumos ajuda todo entrante na camada de aplicação, o que faz a diferenciação vir de outro lugar que não o próprio modelo.
Camada de aplicação ou camada de modelo: como escolher
Pense na decisão como três perguntas.
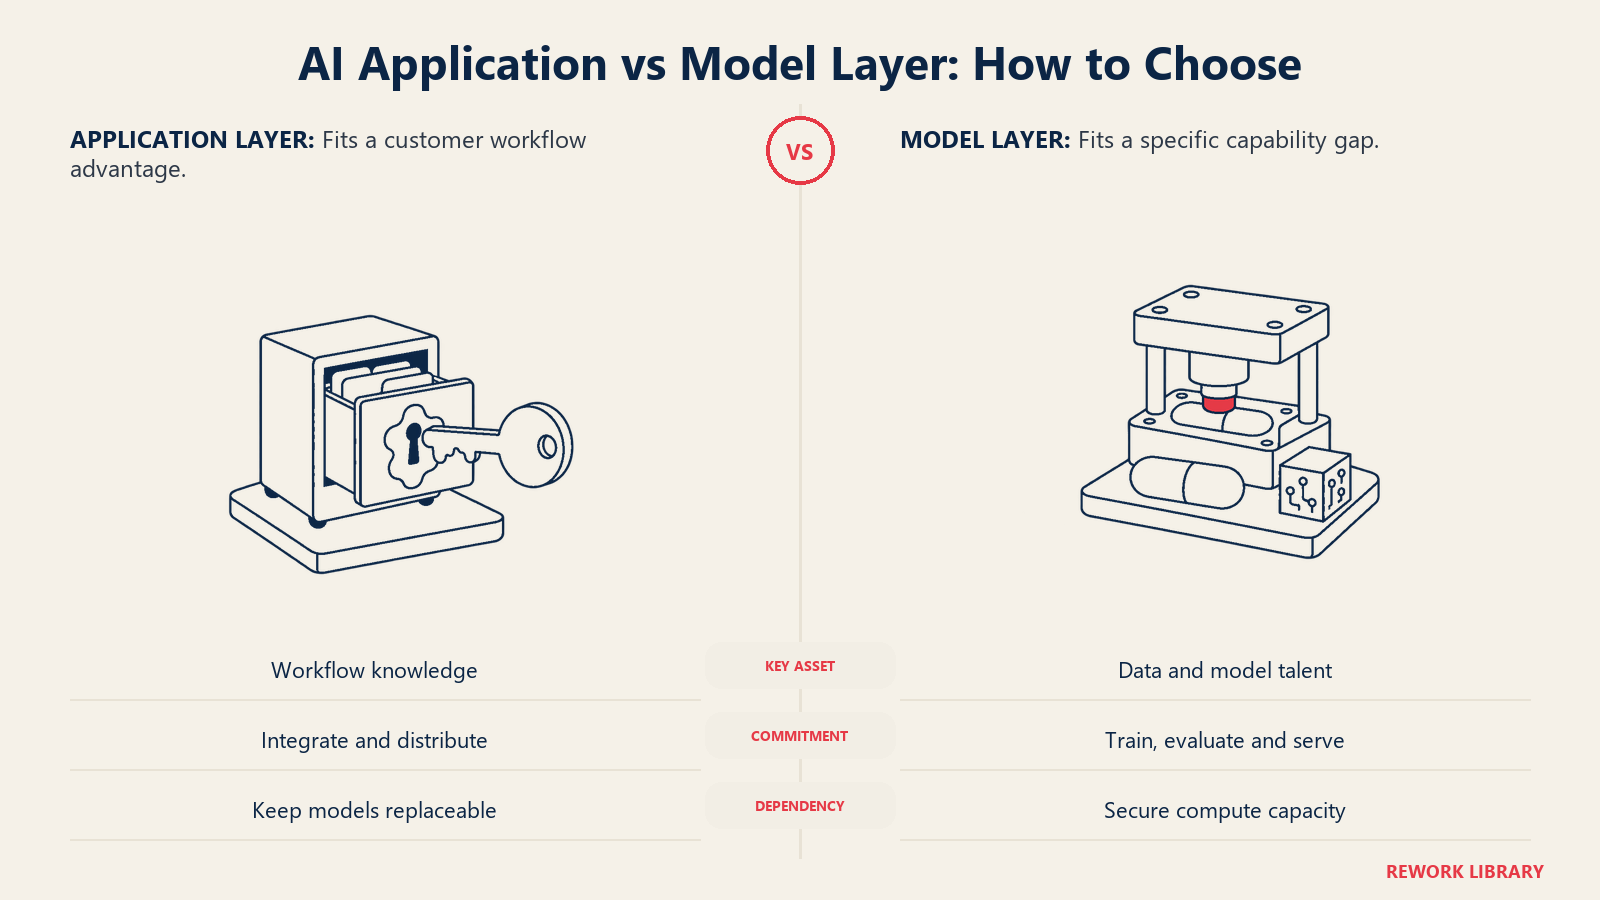
Você tem um motivo para ser dono do modelo? Se a sua vantagem é uma capacidade que um modelo geral não entrega, como um domínio restrito com dados proprietários e a necessidade de controle rigoroso de latência ou privacidade, um modelo especializado ou com fine-tuning pode caber na sua stack. Se a sua vantagem é entender o fluxo de trabalho de um cliente, alugar o modelo costuma ser a melhor aposta. Os trade-offs são tratados em comprar vs. construir funcionalidades de IA em SaaS.
Onde está a sua vantagem durável? O argumento da Sequoia sobre fluxos de trabalho e redes de usuários aponta para a camada de aplicação, onde a vantagem pode vir de distribuição, integração com os sistemas do cliente e confiança construída ao longo do tempo. Uma vantagem de modelo pode ser igualada pelo próximo lançamento. Um fluxo de trabalho embutido na rotina diária de uma equipe é mais difícil de remover. Para o framework por trás desse raciocínio, veja posicionamento competitivo.
Quão exposto você está à camada abaixo? Toda aplicação depende de um fornecedor de modelo, e todo construtor de modelo depende de computação. Mapear a cadeia de valor do seu próprio produto mostra quais fornecedores você poderia trocar e quais não. Empresas que conseguem alternar entre modelos mantêm seu poder de barganha, e as que não conseguem estão a uma mudança de preço de um problema de margem.
Um teste útil: se o modelo por baixo do seu produto melhorasse dez vezes no próximo trimestre, o seu negócio ficaria mais forte ou desapareceria? Se ficaria mais forte porque você é dono do fluxo de trabalho, da relação com o cliente e dos dados, você está construindo uma aplicação durável. Se desapareceria porque o seu produto inteiro era um prompt inteligente, você está construindo algo frágil. Olhamos esse segundo caso em AI wrapper vs. AI-native.
Camadas versus foco: vertical e horizontal
A camada que você escolhe é um eixo. O outro é a amplitude. Uma aplicação horizontal atende uma função em vários setores, e uma vertical atende um único setor em profundidade. A divisão da Menlo de 2025 mostra que ambas têm orçamentos reais, com a horizontal em US$ 8,4 bilhões e a vertical em US$ 3,5 bilhões. Comparamos as duas em IA vertical vs. IA horizontal, e as formas como cada camada ganha dinheiro estão em modelos de negócio de startups de IA.
Leituras equivocadas comuns da stack
"A camada de modelo vai levar tudo." É tentador pensar que os laboratórios vão absorver todo caso de uso. A análise da Sequoia aponta o contrário: as aplicações de maior sucesso foram verticalmente integradas, o que sugere que ser dono do fluxo de trabalho e do usuário importa tanto quanto o modelo. Mas o risco é real para produtos finos, porque um modelo que melhora em uma tarefa pode apagar um produto construído sobre essa lacuna.
"A camada de aplicação é só um wrapper." Algumas aplicações são. Muitas não. Um produto que se embute nos sistemas de uma empresa, acumula seu contexto e aprende seus processos faz muito mais do que repassar texto a um modelo. A crítica é precisa para os casos mais finos e injusta para o resto.
"A infraestrutura sempre vence." A análise de 2023 constatou que a infraestrutura capturava a maior parte dos dólares, e isso era verdade naquele momento. Mas a análise de 2024 argumentou que a base de receita ainda não havia alcançado o gasto, e os dados de 2025 mostram os orçamentos corporativos pendendo para as aplicações. As posições na stack mudam com o tempo.
"Escolha uma camada e fique nela." Muitas empresas atravessam camadas. Uma aplicação vertical pode fazer fine-tuning de um modelo pequeno, e uma empresa de modelos pode lançar a sua própria aplicação. A stack é uma forma de entender dependências e economia, não um conjunto de muros.
O que isso significa para fundadores
Comece pelo trabalho do cliente, não pela camada. Escolha a camada que lhe permite resolver esse trabalho com o menor capital e a vantagem mais durável, depois projete para que as camadas ao seu redor mudem. Mantenha seu fornecedor de modelo substituível, meça sua margem bruta por cliente desde o primeiro dia e construa as partes do produto que um modelo melhor não consegue copiar: suas integrações, seu fluxo de trabalho, sua posição em dados e seus relacionamentos.
A stack também é um alvo em movimento. O preço por unidade de capacidade está caindo, o número de modelos competentes está crescendo e o orçamento corporativo está migrando para produtos que concluem o trabalho. Revise a sua escolha de camada pelo menos uma vez por ano.
Leitura relacionada
- AI wrapper vs. AI-native
- IA vertical vs. IA horizontal
- Modelos de negócio de startups de IA
- O que é uma startup AI-native
- Comprar vs. construir funcionalidades de IA em SaaS
- Margem bruta
Perguntas frequentes sobre a camada de aplicação vs. camada de modelo em IA
Qual é a diferença entre a camada de aplicação e a camada de modelo em IA?
A camada de modelo treina e serve modelos de uso geral que muitos produtos podem usar. A camada de aplicação empacota a capacidade do modelo em um produto acabado para um trabalho específico, com fluxo de trabalho, interface e conexões com os dados do cliente. As empresas de modelo vendem capacidade, e as de aplicação vendem resultados.
Onde as startups de IA costumam competir?
A maioria das startups compete nas camadas de aplicação e de ferramental, porque o treinamento de modelos de fronteira exige muito capital. A Epoch AI estimou que os custos de treinamento de fronteira cresceram 2,4 vezes por ano desde 2016 e projetou execuções acima de um bilhão de dólares até 2027. Equipes menores costumam alugar um modelo ou fazer fine-tuning de um aberto.
Qual camada captura mais valor?
Depende do período e da fonte. A a16z concluiu no início de 2023 que os fornecedores de infraestrutura capturavam a maior parte dos dólares, enquanto a Menlo Ventures constatou no final de 2025 que US$ 19 bilhões de US$ 37 bilhões do gasto corporativo com IA generativa foram para aplicações. Cada uma é a visão de uma empresa, então trate-as como evidência, não como fato consolidado.
Aplicações de IA são apenas wrappers em torno de modelos?
Algumas são, e essas são as mais expostas quando os modelos melhoram. Outras se embutem nos sistemas do cliente, aprendem seus fluxos de trabalho e guardam seus dados, o que lhes dá uma vantagem que uma atualização de modelo não apaga. Se um produto é frágil ou durável depende do que ele possui além do modelo.
Por que as margens brutas de aplicações de IA diferem das do software tradicional?
Cada uso chama um modelo, o que cria um custo variável. A a16z relatou no início de 2023 que as empresas de aplicação gastavam cerca de 20% a 40% da receita com inferência e fine-tuning por cliente, com margens brutas mais frequentemente entre 50% e 60% do que de 90%. Os números atuais variam conforme o produto e a precificação, então confira-os para cada empresa.
Uma startup deve construir seu próprio modelo?
Só se um modelo geral não entregar a capacidade e você tiver os dados, o talento e o capital para sustentá-lo. Para a maioria dos produtos B2B, alugar um modelo e construir o fluxo de trabalho em torno dele é mais barato e mais rápido. Você sempre pode especializar um modelo depois, quando o uso provar a necessidade.

Co-Founder & COO
On this page
- A stack de IA generativa em quatro camadas
- O que cada camada realmente faz
- Onde as startups competem e quanto custa
- Como se argumentou que o valor se acumula
- A economia de cada camada
- Camada de aplicação ou camada de modelo: como escolher
- Camadas versus foco: vertical e horizontal
- Leituras equivocadas comuns da stack
- O que isso significa para fundadores
- Leitura relacionada