Apakah Roda Tenaga Data?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Roda tenaga data ialah gelung di mana penggunaan sesuatu produk menghasilkan data, data itu menjadikan produk lebih baik, dan produk yang lebih baik menarik lebih banyak penggunaan, yang seterusnya menghasilkan lebih banyak data. Dalam syarikat permulaan AI, inilah jawapan paling popular kepada soalan "apa yang menghalang syarikat yang lebih besar daripada meniru kita?" Ia juga antara jawapan yang paling dilebih-lebihkan. Sesetengah produk benar-benar mempunyai roda tenaga. Banyak yang lain hanya mempunyai saluran data dengan rajah yang dilukis di sekelilingnya.
Halaman ini menerangkan asal usul idea ini, cara gelung itu sebenarnya berfungsi, cara khusus ia boleh gagal, dan satu set ujian untuk menentukan sama ada sesuatu produk benar-benar memilikinya. Ia sebahagian daripada set soalan parit pertahanan yang lebih luas, yang dibincangkan dalam peta kebolehpertahanan syarikat permulaan AI secara keseluruhan, dan sengaja dikekalkan sempit: data sebagai sumber kelebihan, bukan aliran kerja, pengedaran atau jenama.
Dari Mana Idea Ini Datang
Perkataan "roda tenaga" ialah metafora perniagaan sebelum ia menjadi metafora data. Jim Collins mempopularkannya dalam Good to Great, dan penerangan beliau sendiri tentang konsep roda tenaga menggunakan imej menolak roda yang sangat berat. Kemajuan awal hampir tidak dapat dilihat, setiap tolakan dibina atas tolakan sebelumnya, dan pada satu ketika momentum mula bekerja untuk anda. Collins menolak idea satu langkah ajaib: hasil datang daripada tolakan terkumpul ke arah yang konsisten. Halaman umum kami tentang kesan roda tenaga membincangkan versi strategi perniagaan.
Versi data menambah satu mekanisme khusus. Dalam gambaran Collins, roda berputar kerana usaha yang berterusan. Dalam gambaran data, roda sepatutnya berputar sebahagiannya dengan sendiri, kerana setiap interaksi pelanggan menghasilkan maklumat yang menambah baik produk untuk pelanggan seterusnya. Dakwaan inilah yang menjadikannya menarik kepada pelabur: ia menjanjikan pulangan berganda yang tidak boleh dibeli oleh pesaing untuk memintas anda.
Ia juga dakwaan yang paling patut diteliti, kerana ia sebenarnya dua dakwaan yang digabungkan. Pertama, lebih banyak data menjadikan produk lebih baik. Kedua, peningkatan ini cukup besar, cukup pantas dan cukup eksklusif untuk menghalang pesaing. Dakwaan pertama sering benar. Dakwaan kedua ialah tempat kebanyakan roda tenaga gagal.
Cara Gelung Ini Sebenarnya Berfungsi
Roda tenaga data yang berfungsi mempunyai empat pautan, dan setiap pautan boleh menjadi yang paling lemah.
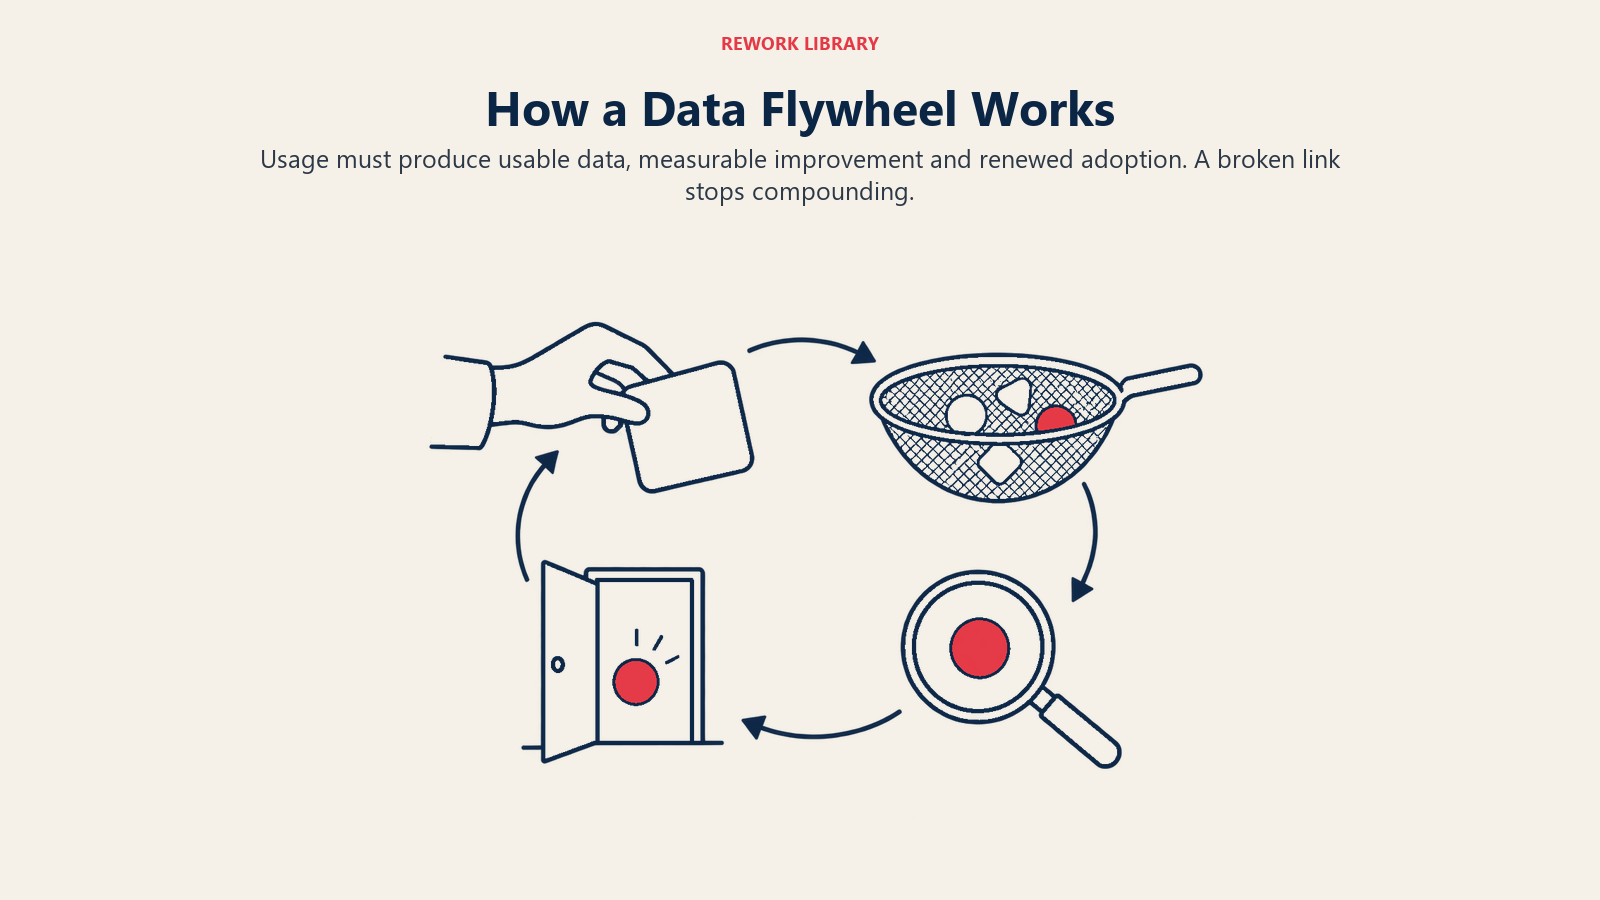
- Penggunaan menghasilkan data. Pelanggan melakukan sesuatu dalam produk yang meninggalkan jejak berguna: pembetulan, kelulusan, cadangan yang ditolak, tugasan yang disiapkan.
- Data ditangkap dan dibersihkan. Syarikat mempunyai kebenaran untuk menggunakannya, menyimpannya dalam bentuk yang boleh digunakan, dan boleh memisahkan isyarat daripada hingar.
- Data menambah baik produk. Ia menyuap latihan model, fine-tuning, pengambilan semula, prompt, set penilaian atau peraturan, dan peningkatannya boleh diukur.
- Peningkatan mendorong lebih banyak penggunaan. Output yang lebih baik meraih lebih banyak kepercayaan, lebih banyak aliran kerja, lebih banyak pelanggan atau pengekalan yang lebih tinggi, dan kitaran itu berulang.
Gelung ini hanya berganda jika keempat-empat pautan bertahan. Banyak produk mempunyai pautan pertama (semuanya meninggalkan log) tetapi tiada yang lain. Mengumpul data bukanlah roda tenaga. Roda tenaga ialah data yang digunakan, yang mengubah produk, dan yang mengubah tingkah laku pelanggan.
Jenis data yang diambil kira
Tidak semua data sama, dan jenisnya menentukan tahap kebolehpertahanan gelung itu.
| Jenis data | Contoh isyarat | Kekuatan tipikal sebagai parit pertahanan |
|---|---|---|
| Data awam atau boleh dibeli | Teks web, set data berlesen | Lemah: pesaing boleh mendapat input yang sama |
| Log penggunaan mentah | Klik, pertanyaan, tempoh sesi | Lemah hingga sederhana: murah dikumpul, bising untuk dipelajari |
| Maklum balas eksplisit | Ibu jari ke atas atau ke bawah, penarafan, kedudukan | Sederhana: berguna, tetapi jarang dan mudah dimanipulasi |
| Pembetulan dan suntingan | Pengguna menulis semula draf AI, seorang ejen membatalkan keputusan | Kuat: dilabel oleh pakar yang melakukan kerja sebenar |
| Data hasil | Adakah urus niaga ditutup, tuntutan dibayar, pesakit pulih | Paling kuat: mengaitkan output dengan hasil sebenar, sukar ditiru |
Coraknya mudah: semakin dekat data dengan keputusan sebenar yang dibuat oleh pakar sebenar, dan semakin jauh ia daripada apa-apa yang boleh dikikis atau dibeli oleh pesaing, semakin tinggi nilainya.
Mengapa Data Menjadi Parit AI Lalai
Sebahagian daya tarikannya datang daripada penyelidikan. Kajian tentang penskalaan dalam pembelajaran mendalam oleh Hestness dan rakan-rakan mendapati ralat generalisasi mengikut hukum kuasa apabila data latihan bertambah, merentasi terjemahan mesin, pemodelan bahasa, pemprosesan imej dan pengecaman pertuturan. Kajian kemudian tentang hukum penskalaan untuk model bahasa melaporkan bahawa kerugian berskala sebagai hukum kuasa dengan saiz model, saiz set data dan pengkomputeran, dengan sesetengah trend menjangkau lebih tujuh susunan magnitud. Tafsiran popularnya ialah "lebih banyak data, model lebih baik, secara konsisten." Tafsiran itulah benih kepada cerita roda tenaga.
Sebab kedua ialah pembelajaran daripada manusia memang berkesan. Kertas InstructGPT oleh OpenAI melaporkan bahawa output daripada model 1.3 bilion parameter yang dilatih dengan demonstrasi pelabel dan output berperingkat lebih disukai berbanding output daripada GPT-3 dengan 175 bilion parameter, walaupun model itu mempunyai 100 kali ganda lebih sedikit parameter. Dalam erti kata lain, data maklum balas boleh lebih penting daripada skala mentah dalam menentukan tingkah laku produk.
Kedua-dua dapatan ini benar. Tiada satu pun membuktikan sesebuah syarikat permulaan mempunyai parit pertahanan. Hukum kuasa juga merupakan lengkung pulangan berkurangan, dan syarikat yang membayar pelabel sedang menerangkan proses yang boleh ditiru oleh mana-mana pesaing yang mempunyai dana besar.
Bila Roda Tenaga Data Itu Sebenar
Roda tenaga cenderung tulen apabila kebanyakan perkara berikut benar.
Data itu proprietari dan dihasilkan oleh produk itu sendiri. Jika data terbaik datang daripada kerja pelanggan anda sendiri, pesaing tidak boleh melesenkan atau merangkaknya. Mereka perlu memenangi pelanggan terlebih dahulu, dan itu masalah yang lebih sukar.
Data sukar diperoleh tanpa aliran kerja. Data yang merupakan hasil sampingan tugasan yang memang perlu dilakukan (menyemak dokumen, menyelesaikan tiket, meluluskan invois) terkumpul tanpa usaha tambahan daripada pengguna. Data yang memerlukan pengguna berhenti dan memberi penarafan hanya mengalir sedikit demi sedikit. Untuk cara kedudukan aliran kerja mencipta kelebihannya sendiri, lihat kebergantungan aliran kerja AI.
Peningkatan itu kelihatan kepada pelanggan. Jika model yang lebih baik tidak pernah mengubah apa yang dilihat pelanggan, gelung itu tidak mendorong penggunaan. Ujiannya ialah sama ada pelanggan boleh menyedari, tanpa diberitahu, bahawa produk itu sudah bertambah baik.
Domain itu mempunyai ekor panjang yang boleh diliputi data. Apabila input pelbagai dan bercelaru, kes pinggir yang terkumpul itulah produknya. Inilah teras hujah untuk AI menegak: domain sempit memberi data tempat untuk tertumpu.
Gelung itu merangkumi hasil, bukan sekadar aktiviti. Mengetahui apa yang dilakukan pelanggan memang berguna. Mengetahui apa yang berlaku selepas itulah yang membolehkan produk mempelajari maksud "bagus".
Saudara terdekat gelung data dalam strategi klasik ialah kesan rangkaian dan kos pertukaran. Data boleh menyuap kedua-duanya, tetapi ia tidak secara automatik menjadi salah satu daripadanya. Kesan rangkaian bermaksud setiap pengguna baharu menjadikan produk lebih bernilai kepada setiap pengguna lain. Gelung data biasanya bermaksud setiap pengguna baharu menjadikan produk sedikit lebih baik untuk semua orang, dan itu sesuatu yang lebih lemah.
Bila Ia Dilebih-lebihkan
Inilah bahagian yang cenderung dilangkau oleh pengasas dan pelabur. Esei Martin Casado dan Peter Lauten, "The Empty Promise of Data Moats", yang diterbitkan pada 2019, mengemukakan hujah skeptikal secara langsung. Hujah utama mereka ialah secara amnya tiada kesan rangkaian yang wujud semata-mata kerana mempunyai lebih banyak data, dan apa yang kelihatan seperti kesan rangkaian biasanya ialah kesan skala, dengan satu perbezaan penting daripada ekonomi skala klasik: kos menambah data unik ke dalam korpus anda mungkin meningkat manakala nilai data tambahan menurun.
Penaakulan mereka memberikan senarai semak berguna tentang cara kegagalan.
Pulangan berkurangan
Contoh chatbot dalam esei itu ialah ilustrasi paling jelas. Mengumpul bahagian pertama pertanyaan meliputi soalan biasa dan memberikan keuntungan besar. Apabila sesebuah syarikat telah melihat 40 peratus pertanyaan dalam contoh itu, tiada lagi kelebihan untuk mengumpul lebih banyak. Lengkung menjadi rata, dan pesaing yang sampai ke bahagian rata lengkung itu berada pada kedudukan yang sama. Hukum kuasa dalam kertas penyelidikan dan lengkung rata dalam rancangan perniagaan ialah bentuk yang sama dilihat dari jarak berbeza.
Permulaan sejuk itu terhad
Esei yang sama berhujah bahawa membina korpus berdaya maju minimum boleh dicapai, dan oleh itu tidak boleh menjadi parit pertahanan yang tahan lama dengan sendirinya. Jika peserta baharu boleh mencapai tahap "cukup baik" dengan data yang dibeli, data sintetik, beberapa rakan kongsi reka bentuk atau model asas yang kukuh, permulaan awal penyandang menyusut menjadi permulaan awal pada ekor panjang sahaja.
Ekor panjang itu mahal
Dalam tulisan kemudian, Taming the Tail, Casado dan Matt Bornstein berhujah bahawa taburan berekor panjang adalah lazim dalam masalah ML dan ini boleh bermakna disekonomi skala: bahagian kerja yang semakin besar jatuh pada tempat yang nilai setiap kejadiannya paling rendah. Mereka juga melaporkan bahawa kos pembangunan aplikasi AI boleh mencecah tiga hingga lima kali ganda lebih tinggi berbanding perisian biasa. Roda tenaga yang perlu bergantung pada kes jarang ialah roda tenaga dengan geseran yang meningkat, bukan menurun.
Data awam menghakis kelebihan dari arah lain
Model asas dilatih sebahagian besarnya dengan data awam, dan stok itu terhad. Penyelidikan Epoch tentang had penskalaan LLM berdasarkan data yang dijana manusia mengunjurkan bahawa model akan dilatih dengan set data yang kira-kira menyamai saiz stok teks manusia awam yang tersedia antara 2026 dan 2032. Pengajaran yang relevan untuk syarikat permulaan bukan tentang berakhirnya data. Ia ialah apabila model umum semakin mahir dalam apa yang boleh diajar oleh data awam, bahagian produk yang bergantung pada data awam tidak lagi menjadi pembeza. Yang tinggal ialah apa sahaja yang tidak dapat dilihat oleh orang awam.
Model asas yang lebih baik boleh menyerap kelebihan anda
Jika kelebihan data sesebuah syarikat permulaan ialah "kami melakukan fine-tuning pada contoh yang menambah baik tugasan biasa," model asas yang lebih kukuh yang dilancarkan suku tahun depan mungkin menutup jurang itu tanpa sebarang data baharu. Inilah risiko praktikal di sebalik persoalan dalam AI wrapper berbanding AI-native: kelebihan yang berada dalam lapisan model yang tidak anda kawal adalah disewa, bukan dimiliki.
Kualiti maklum balas, bukan kuantiti
Volum mudah diukur dan mudah dibanggakan. Kualiti lebih sukar. Butang ibu jari ke atas diklik oleh orang yang tergesa-gesa, label berubah apabila penyemak berbeza tidak bersetuju, dan log merekod apa yang dilakukan pengguna, bukan sama ada ia betul. Roda tenaga yang disuap maklum balas bising boleh berputar tanpa menambah baik apa-apa. Isyarat paling bersih biasanya ialah pembetulan pakar atau hasil yang disahkan, dan ini datang daripada amalan penilaian dan kepercayaan yang dibina lewat oleh kebanyakan pasukan.
Ujian Praktikal: Adakah Anda Memilikinya?
Soalan yang memisahkan roda tenaga yang berfungsi daripada slogan:
| Soalan | Rupa jawapan yang kukuh |
|---|---|
| Bolehkah pesaing membeli atau mengikis data yang setara? | Tidak, kerana ia hanya wujud dalam aliran kerja pelanggan kami |
| Adakah kami mempunyai kebenaran untuk menggunakan data pelanggan bagi penambahbaikan? | Ya, dalam kontrak, dengan skop yang jelas |
| Bolehkah kami tunjukkan produk bertambah baik kerana data? | Ya, perbandingan sebelum dan selepas pada set penilaian tetap |
| Adakah peningkatan itu kelihatan dalam pengekalan, penggunaan atau kadar kemenangan? | Ya, diukur, bukan diandaikan |
| Di manakah kedudukan pada lengkung? | Kami tahu sama ada kami di peringkat awal, pertengahan atau sudah rata |
| Apa berlaku jika model asas yang lebih kukuh dilancarkan? | Kelebihan kami bertahan kerana ia berada di atas model, bukan di dalamnya |
| Seberapa pantas pelanggan baharu mencapai tahap "bagus"? | Lebih pantas berbanding pesaing yang bermula dari sifar |
Soalan tentang lengkung paling penting. Syarikat permulaan yang boleh memplot kualiti berbanding volum data proprietari tahu situasi mana antara tiga yang sedang dihadapinya: masih mendaki, di mana lebih banyak data sangat bernilai; semakin rata, di mana data tambahan kurang bernilai; atau sudah rata, di mana parit pertahanan perlu datang dari sumber lain. Kebanyakan pengasas belum melukis plot ini.
Satu tabiat kedua membantu: simpan set penilaian tetap yang tidak pernah dimasukkan ke dalam latihan. Tanpanya, sebarang dakwaan peningkatan hanyalah anekdot. Idea pengukuran berkaitan terdapat dalam metrik penerimaan produk AI, dan sisi infrastruktur untuk menangkap penggunaan dibincangkan dalam gelung telemetri untuk AI dalam produk dan kelebihan telemetri produk.
Bagaimana Roda Tenaga Sesuai dalam Parit Pertahanan yang Lebih Besar
Malah roda tenaga data yang kukuh jarang berdiri sendiri. Dalam bahasa strategi klasik, parit ekonomi ialah kelebihan yang tahan lama, dan tahan lama biasanya bermaksud beberapa sumber yang saling mengukuhkan. Data cenderung berpasangan dengan:
- Kedudukan aliran kerja. Berada di tempat kerja itu berlaku ialah cara data dihasilkan sejak awal.
- Pengedaran. Lebih ramai pelanggan bermakna lebih banyak data, dan persoalan cara anda memenangi pelanggan pertama itu adalah berasingan, lihat parit pengedaran AI.
- Kos pertukaran. Konfigurasi khusus pelanggan yang terkumpul menjadikan peralihan menyakitkan, dan ini memastikan data terus mengalir.
Anggap roda tenaga sebagai penguat kepada kelebihan lain, bukan penggantinya. Amaran Casado dan Lauten ialah menganggap data sebagai parit ajaib boleh menyesatkan pengasas daripada apa yang sebenarnya mereka perlukan untuk menang. Versi idea yang berguna lebih sempit dan lebih mudah diuji: bagi produk ini, dalam domain ini, adakah data penggunaan proprietari menambah baik hasil secara boleh diukur dengan cara yang tidak dapat ditandingi pesaing dengan cepat?
Kesilapan Biasa
- Menganggap log sebagai kelebihan data. Volum tanpa label atau hasil mengajar sedikit sahaja.
- Mengandaikan lengkung tidak akan rata. Pulangan berkurangan terpakai pada data anda sama seperti data orang lain.
- Mengabaikan hak data. Jika kontrak pelanggan tidak membenarkan pembelajaran daripada data mereka, gelung itu disekat dari segi undang-undang.
- Membina gelung di sekeliling model yang disewa. Jika peningkatan boleh ditiru dengan menaik taraf model asas, ia bukan milik anda.
- Mengukur volum latihan dan bukannya kualiti yang kelihatan kepada pelanggan. Gelung itu tertutup apabila pelanggan menyedarinya.
- Melangkau kumpulan kawalan. Tanpa set penilaian yang diasingkan, anda tidak dapat membezakan peningkatan daripada hanyutan.
Fakta Utama
- Asal metafora: Jim Collins menerangkan roda tenaga sebagai tolakan terkumpul ke arah yang konsisten, tanpa satu inovasi ajaib.
- Penyelidikan penskalaan: Hestness et al. mendapati penskalaan ralat generalisasi mengikut hukum kuasa merentasi empat domain ML, dan Kaplan et al. melaporkan kerugian berskala sebagai hukum kuasa dengan saiz model, saiz set data dan pengkomputeran.
- Maklum balas mengatasi saiz dalam satu kes: Output InstructGPT daripada model 1.3B lebih disukai berbanding output GPT-3 175B, walaupun mempunyai 100x lebih sedikit parameter.
- Hujah skeptikal: Casado dan Lauten (2019) berhujah bahawa mempunyai lebih banyak data tidak dengan sendirinya mencipta kesan rangkaian, dan kos data unik mungkin meningkat manakala nilai tambahannya menurun.
- Ekonomi ekor panjang: Casado dan Bornstein (2020) menyatakan kos pembangunan aplikasi AI boleh mencecah 3-5x lebih tinggi berbanding perisian biasa.
- Had data awam: Penyelidik Epoch mengunjurkan set data latihan akan kira-kira menyamai stok teks manusia awam antara 2026 dan 2032.

Co-Founder & COO
On this page
- Dari Mana Idea Ini Datang
- Cara Gelung Ini Sebenarnya Berfungsi
- Jenis data yang diambil kira
- Mengapa Data Menjadi Parit AI Lalai
- Bila Roda Tenaga Data Itu Sebenar
- Bila Ia Dilebih-lebihkan
- Pulangan berkurangan
- Permulaan sejuk itu terhad
- Ekor panjang itu mahal
- Data awam menghakis kelebihan dari arah lain
- Model asas yang lebih baik boleh menyerap kelebihan anda
- Kualiti maklum balas, bukan kuantiti
- Ujian Praktikal: Adakah Anda Memilikinya?
- Bagaimana Roda Tenaga Sesuai dalam Parit Pertahanan yang Lebih Besar
- Kesilapan Biasa
- Fakta Utama