¿Qué es un flywheel de datos?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Un flywheel de datos es un ciclo en el que usar un producto genera datos, esos datos mejoran el producto y el producto mejorado atrae más uso, que a su vez genera más datos. En las startups de IA es la respuesta más popular a la pregunta «¿qué impide que una empresa más grande nos copie?». También es una de las respuestas más exageradas. Algunos productos tienen un flywheel genuino. Muchos tienen un conducto de datos con un diagrama dibujado alrededor.
Esta página explica de dónde viene la idea, cómo funciona realmente el ciclo, las formas concretas en que se rompe y un conjunto de pruebas para decidir si un producto determinado tiene uno. Forma parte de un conjunto más amplio de preguntas sobre fosos competitivos, que se abordan en el mapa general de defendibilidad de startups de IA, y se mantiene deliberadamente acotada: los datos como fuente de ventaja, no el flujo de trabajo, la distribución ni la marca.
De dónde viene la idea
La palabra «flywheel» es una metáfora de negocios antes que una metáfora de datos. Jim Collins la popularizó en Good to Great, y su propia descripción del concepto de flywheel usa la imagen de empujar una rueda muy pesada. El progreso inicial es casi imperceptible, cada empujón se suma al anterior y, en algún momento, el impulso empieza a jugar a su favor. Collins rechaza la idea de una única jugada decisiva: los resultados provienen de empujones acumulados en una dirección constante. Nuestra página general sobre el efecto flywheel cubre la versión de estrategia de negocios.
La versión de datos añade un mecanismo concreto. En la imagen de Collins, la rueda gira gracias a un esfuerzo sostenido. En la imagen de datos, se supone que la rueda gira en parte por sí sola, porque cada interacción con un cliente produce información que mejora el producto para el siguiente cliente. Esa afirmación es lo que la hace atractiva para los inversionistas: promete rendimientos compuestos que un competidor no puede superar a fuerza de dinero.
También es la afirmación que merece más escrutinio, porque en realidad son dos afirmaciones empaquetadas en una. La primera es que más datos hacen mejor el producto. La segunda es que esa mejora es lo bastante grande, rápida y exclusiva como para mantener alejados a los rivales. La primera suele ser cierta. La segunda es donde fallan la mayoría de los flywheels.
Cómo funciona realmente el ciclo
Un flywheel de datos que funciona tiene cuatro eslabones, y cualquiera de ellos puede ser el débil.
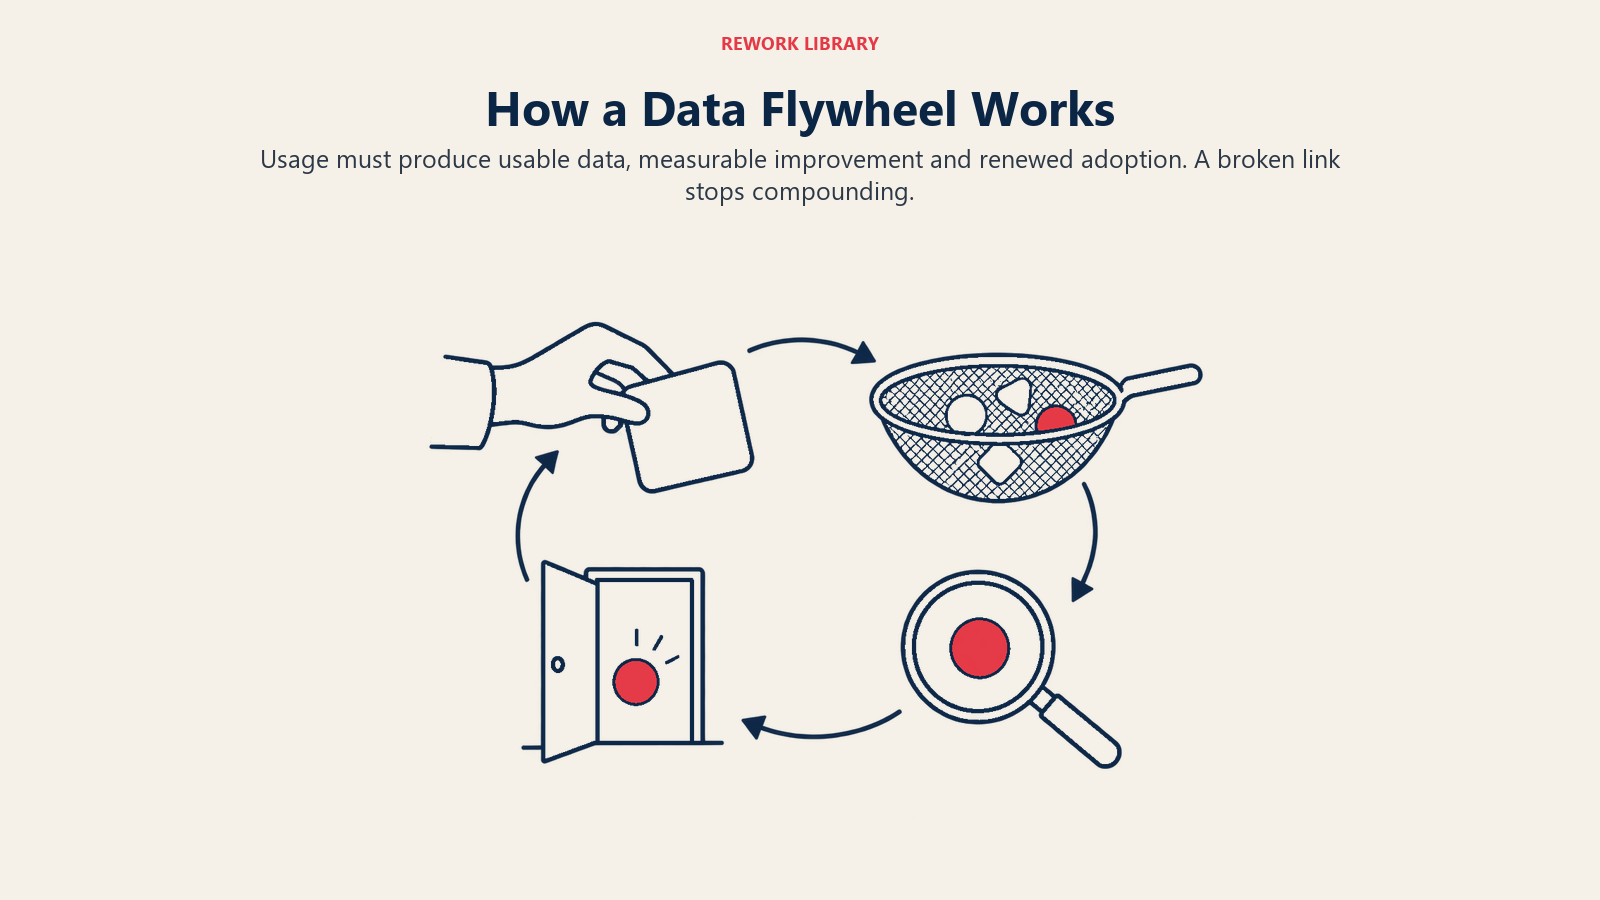
- El uso genera datos. Los clientes hacen algo en el producto que deja un rastro útil: una corrección, una aprobación, una sugerencia rechazada, una tarea completada.
- Los datos se capturan y se limpian. La empresa tiene permiso para usarlos, los almacena en un formato utilizable y puede separar la señal del ruido.
- Los datos mejoran el producto. Alimentan el entrenamiento de modelos, el fine-tuning, la recuperación de información, los prompts, los conjuntos de evaluación o las reglas, y la mejora es medible.
- La mejora impulsa más uso. Un mejor resultado genera más confianza, más flujos de trabajo, más clientes o más retención, y el ciclo se repite.
El ciclo solo se vuelve compuesto si los cuatro eslabones se sostienen. Muchos productos tienen el primer eslabón (todo deja registros) y ninguno de los demás. Recopilar datos no es un flywheel. Un flywheel son datos que se usan, que cambian el producto y que cambian el comportamiento del cliente.
Qué tipos de datos cuentan
No todos los datos valen lo mismo, y el tipo determina qué tan defendible es el ciclo.
| Tipo de datos | Señal de ejemplo | Fortaleza típica como foso |
|---|---|---|
| Datos públicos o que se pueden comprar | Texto web, conjuntos de datos con licencia | Débil: los rivales pueden obtener los mismos insumos |
| Registros de uso sin procesar | Clics, consultas, duración de sesiones | Débil a moderada: baratos de recopilar, ruidosos para aprender |
| Retroalimentación explícita | Pulgar arriba o abajo, calificaciones, clasificaciones | Moderada: útil, pero escasa y fácil de manipular |
| Correcciones y ediciones | Un usuario reescribe un borrador de IA, un agente anula una decisión | Fuerte: etiquetada por un experto que hace trabajo real |
| Datos de resultados | ¿Se cerró el trato, se pagó el reclamo, se recuperó el paciente? | La más fuerte: vincula el resultado con un hecho real, difícil de replicar |
El patrón es sencillo: cuanto más cerca estén los datos de una decisión real tomada por un experto real, y cuanto más lejos estén de cualquier cosa que un competidor pueda extraer de la web o comprar, más valen.
Por qué los datos se volvieron el foso predeterminado de la IA
Parte del atractivo proviene de la investigación. El trabajo sobre escalamiento en deep learning de Hestness y sus colegas encontró que el error de generalización sigue una ley de potencia a medida que crecen los datos de entrenamiento, en traducción automática, modelado de lenguaje, procesamiento de imágenes y reconocimiento de voz. Un trabajo posterior sobre leyes de escalamiento para modelos de lenguaje informó que la pérdida escala como una ley de potencia con el tamaño del modelo, el tamaño del conjunto de datos y el cómputo, con algunas tendencias que abarcan más de siete órdenes de magnitud. La lectura popular es «más datos, mejor modelo, de forma confiable». Esa lectura es la semilla del relato del flywheel.
Una segunda razón es que aprender de las personas funciona. El artículo de InstructGPT de OpenAI informó que los resultados de un modelo de 1300 millones de parámetros entrenado con demostraciones de etiquetadores y resultados clasificados fueron preferidos a los del GPT-3 de 175 000 millones de parámetros, pese a que el modelo tenía 100 veces menos parámetros. En otras palabras, los datos de retroalimentación pueden importar más que la escala bruta para el comportamiento de un producto.
Ambos hallazgos son reales. Ninguno demuestra que una startup tenga un foso. Una ley de potencia también es una curva de rendimientos decrecientes, y una empresa que paga a etiquetadores está describiendo un proceso que cualquier rival bien financiado puede copiar.
Cuándo un flywheel de datos es real
Un flywheel tiende a ser genuino cuando se cumple la mayoría de lo siguiente.
Los datos son propios y los genera el propio producto. Si los mejores datos provienen del trabajo de sus propios clientes, un rival no puede licenciarlos ni rastrearlos. Primero tiene que ganar clientes, que es el problema más difícil.
Los datos son difíciles de obtener sin el flujo de trabajo. Los datos que son un subproducto de una tarea que las personas tienen que hacer de todos modos (revisar un documento, resolver un ticket, aprobar una factura) se acumulan sin esfuerzo adicional de los usuarios. Los datos que exigen que los usuarios se detengan a calificar algo llegan a cuentagotas. Para ver cómo la posición en el flujo de trabajo crea su propia ventaja, consulte lock-in del flujo de trabajo de IA.
La mejora es visible para los clientes. Si un mejor modelo nunca cambia lo que ve un cliente, el ciclo no impulsa el uso. La prueba es si un cliente podría notar, sin que se lo digan, que el producto mejoró.
El dominio tiene una cola larga que los datos pueden cubrir. Donde los insumos son variados y desordenados, los casos extremos acumulados son el producto. Este es el núcleo del argumento a favor de la IA vertical: los dominios acotados dan a los datos un lugar donde concentrarse.
El ciclo incluye resultados, no solo actividad. Saber lo que hicieron los clientes es útil. Saber lo que ocurrió después es lo que permite al producto aprender qué significa «bueno».
Los parientes más cercanos del ciclo de datos en la estrategia clásica son los efectos de red y los costos de cambio. Los datos pueden alimentar a ambos, pero no son automáticamente ninguno de los dos. Un efecto de red significa que cada nuevo usuario hace que el producto sea más valioso para todos los demás usuarios. Un ciclo de datos suele significar que cada nuevo usuario hace que el producto sea un poco mejor para todos, lo cual es algo más débil.
Cuándo está sobrevalorado
Esta es la parte que los fundadores y los inversionistas suelen saltarse. El ensayo de Martin Casado y Peter Lauten «The Empty Promise of Data Moats», publicado en 2019, plantea directamente el argumento escéptico. Su argumento central es que, en general, no existe un efecto de red inherente por el simple hecho de tener más datos, y que lo que parece serlo suele ser un efecto de escala, con una diferencia crucial respecto a las economías de escala clásicas: el costo de añadir datos únicos a su corpus puede subir mientras el valor de los datos incrementales baja.
Su razonamiento ofrece una lista útil de modos de falla.
Rendimientos decrecientes
El ejemplo del chatbot del ensayo es la ilustración más clara. Recopilar la primera porción de consultas cubre las preguntas comunes y produce grandes avances. Cuando una empresa ha visto el 40 % de las consultas del ejemplo, ya no queda ventaja en recopilar más. La curva se aplana, y un rival que llega a la parte plana de la curva está en igualdad de condiciones. Una ley de potencia en un artículo de investigación y una curva plana en un plan de negocios son la misma forma vista desde distancias distintas.
El arranque en frío tiene límites
El mismo ensayo sostiene que construir un corpus mínimo viable es alcanzable y, por lo tanto, no puede ser por sí solo un foso duradero. Si un nuevo competidor puede llegar a «suficientemente bueno» con datos comprados, datos sintéticos, unos pocos socios de diseño o un modelo base sólido, la ventaja inicial del incumbente se reduce a una ventaja solo en la cola larga.
La cola larga es cara
En un texto posterior, Taming the Tail, Casado y Matt Bornstein sostienen que las distribuciones de cola larga son endémicas en los problemas de ML y que esto puede implicar deseconomías de escala: una proporción creciente del trabajo cae donde el valor por instancia es más bajo. También informan que los costos de desarrollo de aplicaciones de IA pueden ser de tres a cinco veces más altos que en el software típico. Un flywheel que tiene que alimentarse de casos raros es un flywheel con fricción creciente, no decreciente.
Los datos públicos erosionan las ventajas desde el otro lado
Los modelos fundacionales se entrenan en gran medida con datos públicos, y esa reserva es finita. La investigación de Epoch sobre los límites del escalamiento de LLM basados en datos generados por humanos proyecta que los modelos se entrenarán con conjuntos de datos de aproximadamente el tamaño de la reserva disponible de texto humano público entre 2026 y 2032. La lección relevante para las startups no tiene que ver con el fin de los datos. Es que, a medida que los modelos generales mejoran en lo que los datos públicos pueden enseñar, la parte de un producto que depende de datos públicos deja de ser un diferenciador. Lo que queda es todo aquello que el público no puede ver.
Mejores modelos base pueden absorber su ventaja
Si la ventaja de datos de una startup es «hicimos fine-tuning con ejemplos que mejoran una tarea común», un modelo fundacional más potente lanzado el próximo trimestre puede cerrar esa brecha sin ningún dato nuevo. Este es el riesgo práctico detrás de la pregunta de AI wrapper frente a AI-native: una ventaja que vive en la capa de modelo que usted no controla es alquilada, no propia.
Calidad de la retroalimentación, no cantidad
El volumen es fácil de medir y fácil de presumir. La calidad es más difícil. Los botones de pulgar arriba los pulsan personas con prisa, las etiquetas se desvían cuando distintos revisores no están de acuerdo y los registros recogen lo que hicieron los usuarios, no si era correcto. Un flywheel alimentado con retroalimentación ruidosa puede girar sin mejorar nada. La señal más limpia suele ser la corrección de un experto o un resultado verificado, y estas provienen de prácticas de evaluación y confianza que la mayoría de los equipos construyen tarde.
Una prueba práctica: ¿tiene usted uno?
Preguntas que separan un flywheel que funciona de un eslogan:
| Pregunta | Cómo se ve una respuesta sólida |
|---|---|
| ¿Puede un competidor comprar o extraer datos equivalentes? | No, porque solo existen dentro de los flujos de trabajo de nuestros clientes |
| ¿Tenemos permiso para usar los datos de los clientes para mejorar? | Sí, en los contratos, con un alcance claro |
| ¿Podemos demostrar que el producto mejoró gracias a los datos? | Sí, con un antes y después sobre un conjunto de evaluación fijo |
| ¿La ganancia se refleja en retención, uso o tasa de cierre? | Sí, medida, no supuesta |
| ¿En qué punto de la curva estamos? | Sabemos si estamos al principio, a la mitad o en la parte plana |
| ¿Qué pasa si se lanza un modelo base más potente? | Nuestra ventaja sobrevive porque se ubica por encima del modelo, no dentro de él |
| ¿Qué tan rápido llega un cliente nuevo a «bueno»? | Más rápido de lo que llegaría con un rival que parte de cero |
La pregunta sobre la curva es la más importante. Una startup que puede graficar la calidad frente al volumen de datos propios sabe en cuál de tres situaciones se encuentra: todavía en ascenso, donde más datos valen mucho; aplanándose, donde los datos adicionales valen poco; o ya en la parte plana, donde el foso tiene que venir de otro lado. La mayoría de los fundadores no ha trazado esta gráfica.
Un segundo hábito ayuda: mantenga un conjunto de evaluación fijo que nunca entre en el entrenamiento. Sin él, cualquier afirmación de mejora es una anécdota. Ideas de medición relacionadas aparecen en las métricas de adopción de productos de IA, y el lado de infraestructura de la captura de uso se cubre en ciclos de telemetría para la IA dentro del producto y en la ventaja de la telemetría de producto.
Cómo encaja un flywheel en un foso más amplio
Incluso un flywheel de datos sólido rara vez se sostiene solo. En el lenguaje de la estrategia clásica, un foso económico es una ventaja duradera, y duradera suele significar varias fuentes que se refuerzan entre sí. Los datos tienden a combinarse con:
- Posición en el flujo de trabajo. Estar donde ocurre el trabajo es la forma en que los datos se generan en primer lugar.
- Distribución. Más clientes significa más datos, y la cuestión de cómo se ganan esos primeros clientes es aparte, consulte foso de distribución de IA.
- Costos de cambio. La configuración acumulada específica de cada cliente hace que irse sea doloroso, lo que mantiene el flujo de datos.
Trate el flywheel como un amplificador de otras ventajas, no como un sustituto de ellas. La advertencia de Casado y Lauten es que tratar los datos como un foso mágico puede desviar a los fundadores de lo que realmente necesitan para ganar. La versión útil de la idea es más acotada y más comprobable: para este producto, en este dominio, ¿los datos de uso propios mejoran los resultados de forma medible y de una manera que un rival no puede igualar rápidamente?
Errores comunes
- Contar los registros como ventaja de datos. El volumen sin etiquetas ni resultados enseña poco.
- Suponer que la curva nunca se aplana. Los rendimientos decrecientes se aplican a sus datos tanto como a los de cualquier otro.
- Ignorar los derechos sobre los datos. Si los contratos con los clientes no permiten aprender de sus datos, el ciclo está bloqueado legalmente.
- Construir el ciclo alrededor de un modelo alquilado. Si la mejora se puede replicar actualizando un modelo base, no es suya.
- Medir el volumen de entrenamiento en lugar de la calidad visible para el cliente. El ciclo se cierra cuando los clientes lo notan.
- Omitir el grupo de control. Sin un conjunto de evaluación reservado, no puede distinguir la mejora de la deriva.
Datos clave
- Origen de la metáfora: Jim Collins describe el flywheel como empujones acumulados en una dirección constante, sin una única innovación decisiva.
- Investigación sobre escalamiento: Hestness et al. encontraron que el error de generalización escala según una ley de potencia en cuatro dominios de ML, y Kaplan et al. informaron que la pérdida escala como una ley de potencia con el tamaño del modelo, el tamaño del conjunto de datos y el cómputo.
- La retroalimentación supera al tamaño en un caso: los resultados de InstructGPT de un modelo de 1300 millones de parámetros fueron preferidos a los del GPT-3 de 175 000 millones, pese a tener 100 veces menos parámetros.
- El argumento escéptico: Casado y Lauten (2019) sostienen que tener más datos no crea por sí solo un efecto de red, y que el costo de los datos únicos puede subir mientras su valor incremental baja.
- Economía de la cola larga: Casado y Bornstein (2020) afirman que los costos de desarrollo de aplicaciones de IA pueden ser de 3 a 5 veces más altos que en el software típico.
- Límite de los datos públicos: investigadores de Epoch proyectan que los conjuntos de datos de entrenamiento igualarán aproximadamente la reserva de texto humano público entre 2026 y 2032.

Co-Founder & COO
On this page
- De dónde viene la idea
- Cómo funciona realmente el ciclo
- Qué tipos de datos cuentan
- Por qué los datos se volvieron el foso predeterminado de la IA
- Cuándo un flywheel de datos es real
- Cuándo está sobrevalorado
- Rendimientos decrecientes
- El arranque en frío tiene límites
- La cola larga es cara
- Los datos públicos erosionan las ventajas desde el otro lado
- Mejores modelos base pueden absorber su ventaja
- Calidad de la retroalimentación, no cantidad
- Una prueba práctica: ¿tiene usted uno?
- Cómo encaja un flywheel en un foso más amplio
- Errores comunes
- Datos clave