Was ist ein Daten-Flywheel?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Ein Daten-Flywheel ist ein Kreislauf, in dem die Nutzung eines Produkts Daten erzeugt, diese Daten das Produkt verbessern und das bessere Produkt mehr Nutzung anzieht, die wiederum mehr Daten erzeugt. Bei KI-Startups ist es die beliebteste Antwort auf die Frage: „Was hält ein größeres Unternehmen davon ab, uns zu kopieren?“ Es ist aber auch eine der am stärksten übertriebenen Antworten. Manche Produkte haben ein echtes Flywheel. Viele haben eine Datenleitung, um die jemand ein Diagramm gezeichnet hat.
Diese Seite erklärt, woher die Idee stammt, wie der Kreislauf tatsächlich funktioniert, an welchen Stellen er konkret bricht, und bietet eine Reihe von Tests, mit denen Sie entscheiden können, ob ein bestimmtes Produkt eines hat. Sie gehört zu einem größeren Satz von Fragen rund um den Burggraben, die in der übergreifenden Karte zur Verteidigungsfähigkeit von KI-Startups behandelt werden, und bleibt bewusst eng: Daten als Quelle des Vorteils, nicht Workflow, Vertrieb oder Marke.
Woher die Idee stammt
Das Wort „Flywheel“ ist eine Geschäftsmetapher, bevor es eine Datenmetapher ist. Jim Collins hat es in Good to Great populär gemacht, und seine eigene Beschreibung des Flywheel-Konzepts nutzt das Bild eines sehr schweren Rades, das man anschiebt. Der frühe Fortschritt ist kaum wahrnehmbar, jeder Stoß baut auf dem vorherigen auf, und irgendwann beginnt der Schwung für Sie zu arbeiten. Collins lehnt die Idee eines einzelnen genialen Schachzugs ab: Ergebnisse entstehen aus vielen Stößen in eine gleichbleibende Richtung. Unsere allgemeine Seite zum Flywheel-Effekt behandelt die Version aus der Unternehmensstrategie.
Die Datenversion fügt einen bestimmten Mechanismus hinzu. Im Bild von Collins dreht sich das Rad durch anhaltende Anstrengung. Im Datenbild soll sich das Rad teilweise von selbst drehen, weil jede Kundeninteraktion Informationen erzeugt, die das Produkt für den nächsten Kunden verbessern. Genau dieses Versprechen macht es für Investoren attraktiv: Es verspricht sich verstärkende Erträge, an denen ein Wettbewerber sich nicht vorbeikaufen kann.
Es ist aber auch die Behauptung, die die genaueste Prüfung verdient, denn eigentlich sind es zwei Behauptungen in einer. Die erste lautet, dass mehr Daten das Produkt besser machen. Die zweite lautet, dass diese Verbesserung groß genug, schnell genug und exklusiv genug ist, um Konkurrenten fernzuhalten. Die erste stimmt oft. An der zweiten scheitern die meisten Flywheels.
Wie der Kreislauf tatsächlich funktioniert
Ein funktionierendes Daten-Flywheel hat vier Glieder, und jedes davon kann das schwache sein.
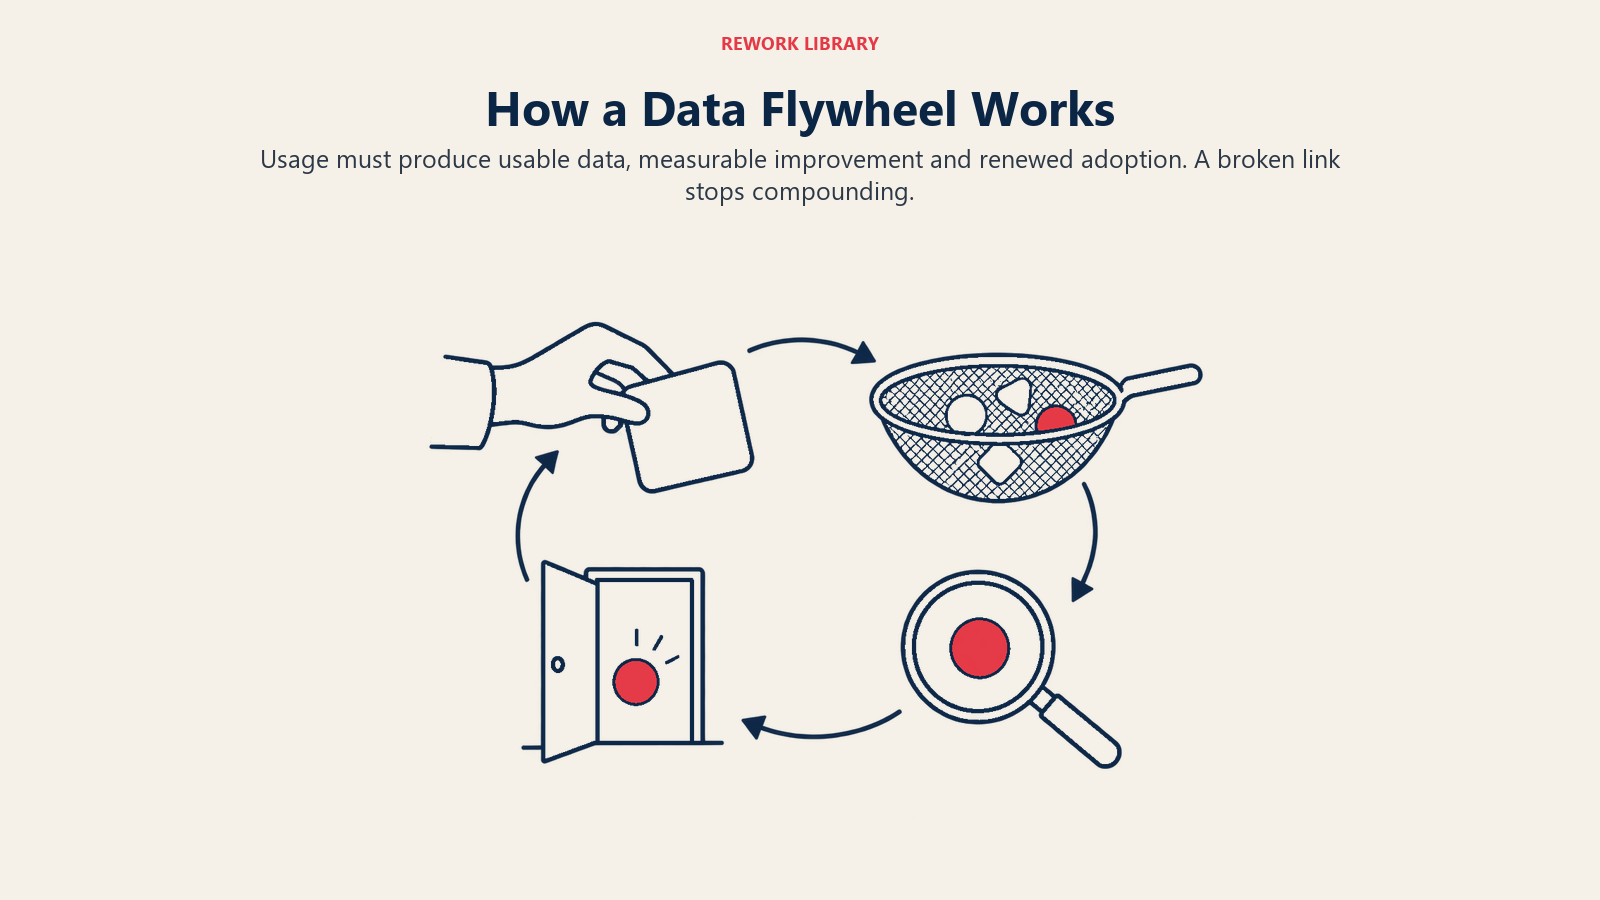
- Nutzung erzeugt Daten. Kunden tun im Produkt etwas, das eine nützliche Spur hinterlässt: eine Korrektur, eine Freigabe, einen abgelehnten Vorschlag, eine erledigte Aufgabe.
- Die Daten werden erfasst und bereinigt. Das Unternehmen darf sie nutzen, speichert sie in einer brauchbaren Form und kann Signal von Rauschen trennen.
- Die Daten verbessern das Produkt. Sie fließen in Modelltraining, Fine-tuning, Retrieval, Prompts, Evaluationssets oder Regeln ein, und die Verbesserung ist messbar.
- Die Verbesserung treibt mehr Nutzung. Bessere Ergebnisse schaffen mehr Vertrauen, mehr Workflows, mehr Kunden oder mehr Bindung, und der Zyklus wiederholt sich.
Der Kreislauf verstärkt sich nur, wenn alle vier Glieder halten. Viele Produkte haben Glied eins (alles hinterlässt Logs) und keines der anderen. Daten zu sammeln ist kein Flywheel. Ein Flywheel sind Daten, die genutzt werden, die das Produkt verändern und die das Kundenverhalten verändern.
Welche Arten von Daten zählen
Nicht alle Daten sind gleich, und die Art bestimmt, wie verteidigungsfähig der Kreislauf ist.
| Datenart | Beispielsignal | Typische Stärke als Burggraben |
|---|---|---|
| Öffentliche oder käufliche Daten | Webtexte, lizenzierte Datensätze | Schwach: Konkurrenten bekommen dieselben Eingaben |
| Rohe Nutzungslogs | Klicks, Suchanfragen, Sitzungsdauer | Schwach bis mittel: günstig zu sammeln, verrauscht zum Lernen |
| Explizites Feedback | Daumen hoch oder runter, Bewertungen, Rangfolgen | Mittel: nützlich, aber spärlich und leicht zu manipulieren |
| Korrekturen und Bearbeitungen | Ein Nutzer schreibt einen KI-Entwurf um, ein Bearbeiter überstimmt eine Entscheidung | Stark: gelabelt von einer Fachkraft bei echter Arbeit |
| Ergebnisdaten | Wurde der Deal abgeschlossen, der Schaden bezahlt, ist der Patient genesen | Am stärksten: verknüpft das Ergebnis mit einem realen Resultat, schwer zu replizieren |
Das Muster ist einfach: Je näher die Daten an einer echten Entscheidung einer echten Fachkraft liegen und je weiter sie von allem entfernt sind, was ein Wettbewerber abgreifen oder kaufen könnte, desto mehr sind sie wert.
Warum Daten zum Standard-Burggraben für KI wurden
Ein Teil der Anziehungskraft stammt aus der Forschung. Arbeiten zur Skalierung im Deep Learning von Hestness und Kollegen ergaben, dass der Generalisierungsfehler mit wachsenden Trainingsdaten einem Potenzgesetz folgt, und zwar in maschineller Übersetzung, Sprachmodellierung, Bildverarbeitung und Spracherkennung. Spätere Arbeiten zu Skalierungsgesetzen für Sprachmodelle berichteten, dass der Loss als Potenzgesetz mit Modellgröße, Datensatzgröße und Rechenleistung skaliert, wobei manche Trends mehr als sieben Größenordnungen umfassen. Die populäre Lesart lautet: „Mehr Daten, besseres Modell, zuverlässig.“ Diese Lesart ist der Keim der Flywheel-Geschichte.
Ein zweiter Grund ist, dass das Lernen von Menschen funktioniert. Das InstructGPT-Paper von OpenAI berichtete, dass Ausgaben eines Modells mit 1,3 Milliarden Parametern, das mit Demonstrationen und Rangfolgen von Labelern trainiert wurde, den Ausgaben des GPT-3 mit 175 Milliarden Parametern vorgezogen wurden, obwohl das Modell 100-mal weniger Parameter hatte. Feedbackdaten können also für das Verhalten eines Produkts wichtiger sein als reine Größe.
Beide Befunde sind echt. Keiner beweist, dass ein Startup einen Burggraben hat. Ein Potenzgesetz ist auch eine Kurve abnehmender Erträge, und ein Unternehmen, das Labeler bezahlt, beschreibt einen Prozess, den jeder gut finanzierte Konkurrent kopieren kann.
Wann ein Daten-Flywheel echt ist
Ein Flywheel ist in der Regel echt, wenn die meisten der folgenden Punkte zutreffen.
Die Daten sind proprietär und werden vom Produkt selbst erzeugt. Wenn die besten Daten aus der Arbeit Ihrer eigenen Kunden stammen, kann ein Konkurrent sie weder lizenzieren noch crawlen. Er muss zuerst Kunden gewinnen, und das ist das schwierigere Problem.
Die Daten sind ohne den Workflow schwer zu bekommen. Daten, die als Nebenprodukt einer Aufgabe entstehen, die Menschen ohnehin erledigen müssen (ein Dokument prüfen, ein Ticket lösen, eine Rechnung freigeben), sammeln sich ohne zusätzlichen Aufwand der Nutzer an. Daten, für die Nutzer innehalten und etwas bewerten müssen, tröpfeln nur. Wie die Position im Workflow einen eigenen Vorteil schafft, lesen Sie unter Workflow-Lock-in bei KI.
Die Verbesserung ist für Kunden sichtbar. Wenn ein besseres Modell nie verändert, was ein Kunde sieht, treibt der Kreislauf keine Nutzung. Der Test lautet, ob ein Kunde ohne Hinweis erkennen könnte, dass das Produkt besser geworden ist.
Die Domäne hat einen Long Tail, den die Daten abdecken können. Wo Eingaben vielfältig und unordentlich sind, sind gesammelte Sonderfälle das Produkt. Das ist der Kern des Arguments für vertikale KI: Enge Domänen geben Daten einen Ort, an dem sie sich konzentrieren.
Der Kreislauf umfasst Ergebnisse, nicht nur Aktivität. Zu wissen, was Kunden getan haben, ist nützlich. Zu wissen, was danach geschah, lässt das Produkt lernen, was „gut“ bedeutet.
Die nächsten Verwandten des Datenkreislaufs in der klassischen Strategie sind Netzwerkeffekte und Wechselkosten. Daten können beide speisen, sind aber nicht automatisch eines davon. Ein Netzwerkeffekt bedeutet, dass jeder neue Nutzer das Produkt für jeden anderen Nutzer wertvoller macht. Ein Datenkreislauf bedeutet meist, dass jeder neue Nutzer das Produkt für alle ein wenig besser macht, und das ist schwächer.
Wann es überschätzt wird
Diesen Teil überspringen Gründer und Investoren gern. Martin Casados und Peter Lautens Essay „The Empty Promise of Data Moats“, 2019 veröffentlicht, vertritt die skeptische Position direkt. Ihr zentrales Argument lautet, dass es in der Regel keinen inhärenten Netzwerkeffekt allein dadurch gibt, dass man mehr Daten hat, und dass das, was danach aussieht, meist ein Skaleneffekt ist, mit einem entscheidenden Unterschied zu klassischen Skaleneffekten: Die Kosten, einzigartige Daten zum eigenen Korpus hinzuzufügen, können steigen, während der Wert zusätzlicher Daten sinkt.
Ihre Argumentation liefert eine nützliche Checkliste von Fehlerquellen.
Abnehmende Erträge
Das Chatbot-Beispiel des Essays ist die klarste Veranschaulichung. Das Sammeln des ersten Teils der Anfragen deckt die häufigen Fragen ab und bringt große Fortschritte. Sobald ein Unternehmen im Beispiel 40 Prozent der Anfragen gesehen hat, bringt weiteres Sammeln keinen Vorteil mehr. Die Kurve flacht ab, und ein Konkurrent, der den flachen Teil der Kurve erreicht, steht auf Augenhöhe. Ein Potenzgesetz in einem Forschungspaper und eine flache Kurve in einem Businessplan sind dieselbe Form aus unterschiedlicher Entfernung betrachtet.
Der Kaltstart ist begrenzt
Derselbe Essay argumentiert, dass der Aufbau eines minimal brauchbaren Korpus machbar ist und daher für sich allein kein dauerhafter Burggraben sein kann. Wenn ein Neueinsteiger mit gekauften Daten, synthetischen Daten, einigen Designpartnern oder einem starken Basismodell „gut genug“ erreicht, schrumpft der Vorsprung des etablierten Anbieters auf einen Vorsprung nur noch im Long Tail.
Der Long Tail ist teuer
In einem späteren Beitrag, Taming the Tail, argumentieren Casado und Matt Bornstein, dass Long-Tail-Verteilungen bei ML-Problemen allgegenwärtig sind und dass dies Größennachteile bedeuten kann: Ein wachsender Anteil der Arbeit fällt dort an, wo der Wert pro Fall am geringsten ist. Sie berichten außerdem, dass die Entwicklungskosten für KI-Anwendungen drei- bis fünfmal höher liegen können als bei typischer Software. Ein Flywheel, das sich von seltenen Fällen ernähren muss, ist ein Flywheel mit steigender Reibung, nicht mit sinkender.
Öffentliche Daten untergraben Vorteile von der anderen Seite
Foundation Models werden größtenteils mit öffentlichen Daten trainiert, und dieser Bestand ist endlich. Die Forschung von Epoch zu den Grenzen der LLM-Skalierung auf Basis menschlich erzeugter Daten prognostiziert, dass Modelle zwischen 2026 und 2032 mit Datensätzen trainiert werden, die ungefähr dem verfügbaren Bestand an öffentlichem menschlichem Text entsprechen. Die relevante Lehre für Startups betrifft nicht das Ende der Daten. Sie lautet: Je besser allgemeine Modelle in dem werden, was öffentliche Daten lehren können, desto weniger differenziert der Teil eines Produkts, der von öffentlichen Daten abhängt. Übrig bleibt, was die Öffentlichkeit nicht sehen kann.
Bessere Basismodelle können Ihren Vorsprung aufsaugen
Wenn der Datenvorteil eines Startups lautet „Wir haben auf Beispielen feinabgestimmt, die eine gängige Aufgabe verbessern“, kann ein stärkeres Foundation Model, das im nächsten Quartal erscheint, diese Lücke ganz ohne neue Daten schließen. Das ist das praktische Risiko hinter der Frage in AI wrapper vs. AI-native: Ein Vorteil, der in einer Modellschicht liegt, die Sie nicht kontrollieren, ist gemietet, nicht besessen.
Feedbackqualität statt Feedbackmenge
Volumen ist leicht zu messen und leicht vorzuzeigen. Qualität ist schwieriger. Daumen-hoch-Buttons werden von Menschen in Eile geklickt, Labels driften, wenn verschiedene Prüfer uneinig sind, und Logs halten fest, was Nutzer getan haben, nicht ob es richtig war. Ein Flywheel, das mit verrauschtem Feedback gespeist wird, kann sich drehen, ohne irgendetwas zu verbessern. Das sauberste Signal ist meist die Korrektur einer Fachkraft oder ein verifiziertes Ergebnis, und diese stammen aus Praktiken für Evaluation und Vertrauen, die die meisten Teams erst spät aufbauen.
Ein praktischer Test: Haben Sie eines?
Fragen, die ein funktionierendes Flywheel von einem Slogan unterscheiden:
| Frage | Wie eine starke Antwort aussieht |
|---|---|
| Kann ein Wettbewerber gleichwertige Daten kaufen oder abgreifen? | Nein, weil sie nur in den Workflows unserer Kunden existieren |
| Dürfen wir Kundendaten zur Verbesserung nutzen? | Ja, vertraglich geregelt, mit klarem Umfang |
| Können wir zeigen, dass das Produkt dank der Daten besser wurde? | Ja, ein Vorher-nachher-Vergleich auf einem festen Evaluationsset |
| Zeigt sich der Gewinn bei Bindung, Nutzung oder Win Rate? | Ja, gemessen, nicht angenommen |
| Wo auf der Kurve stehen wir? | Wir wissen, ob wir früh, in der Mitte oder im flachen Teil sind |
| Was passiert, wenn ein stärkeres Basismodell erscheint? | Unser Vorteil bleibt, weil er auf dem Modell sitzt, nicht in ihm |
| Wie schnell erreicht ein neuer Kunde „gut“? | Schneller, als es bei einem Konkurrenten ohne Vorsprung der Fall wäre |
Die Frage nach der Kurve ist die wichtigste. Ein Startup, das Qualität gegen das Volumen proprietärer Daten auftragen kann, weiß, in welcher von drei Situationen es sich befindet: noch im Anstieg, wo mehr Daten viel wert sind; im Abflachen, wo zusätzliche Daten wenig wert sind; oder schon flach, wo der Burggraben von woanders kommen muss. Die meisten Gründer haben diese Grafik nie gezeichnet.
Eine zweite Gewohnheit hilft: Halten Sie ein festes Evaluationsset vor, das nie ins Training einfließt. Ohne eines ist jede Behauptung einer Verbesserung eine Anekdote. Verwandte Messansätze finden sich bei Kennzahlen zur Adoption von KI-Produkten, und die Infrastrukturseite der Nutzungserfassung wird unter Telemetrie-Loops für KI im Produkt und beim Vorteil durch Produkttelemetrie behandelt.
Wie ein Flywheel in einen größeren Burggraben passt
Selbst ein starkes Daten-Flywheel steht selten allein. In der Sprache der klassischen Strategie ist ein ökonomischer Burggraben ein dauerhafter Vorteil, und dauerhaft bedeutet meist mehrere sich gegenseitig verstärkende Quellen. Daten kombinieren sich typischerweise mit:
- Position im Workflow. Dort zu sein, wo die Arbeit stattfindet, ist überhaupt erst der Weg, auf dem die Daten entstehen.
- Vertrieb. Mehr Kunden bedeuten mehr Daten, und die Frage, wie Sie diese ersten Kunden gewinnen, ist eine eigene, siehe KI-Burggraben durch Vertrieb.
- Wechselkosten. Angesammelte kundenspezifische Konfiguration macht den Abschied schmerzhaft, und das hält die Daten am Fließen.
Behandeln Sie das Flywheel als Verstärker anderer Vorteile, nicht als deren Ersatz. Casado und Lauten warnen, dass die Behandlung von Daten als magischer Burggraben Gründer von dem ablenken kann, was sie tatsächlich zum Gewinnen brauchen. Die nützliche Version der Idee ist enger und besser prüfbar: Verbessern proprietäre Nutzungsdaten für dieses Produkt, in dieser Domäne, die Ergebnisse messbar auf eine Weise, die ein Konkurrent nicht schnell nachahmen kann?
Häufige Fehler
- Logs als Datenvorteil zählen. Volumen ohne Labels oder Ergebnisse lehrt wenig.
- Annehmen, dass die Kurve nie abflacht. Abnehmende Erträge gelten für Ihre Daten genauso wie für alle anderen.
- Datenrechte ignorieren. Wenn Kundenverträge das Lernen aus ihren Daten nicht erlauben, ist der Kreislauf rechtlich blockiert.
- Den Kreislauf um ein gemietetes Modell bauen. Wenn sich die Verbesserung durch ein Upgrade des Basismodells nachbilden lässt, gehört sie nicht Ihnen.
- Trainingsvolumen statt für Kunden sichtbarer Qualität messen. Der Kreislauf schließt sich, wenn Kunden es bemerken.
- Die Kontrollgruppe weglassen. Ohne zurückgehaltenes Evaluationsset können Sie Verbesserung nicht von Drift unterscheiden.
Wichtige Fakten
- Ursprung der Metapher: Jim Collins beschreibt das Flywheel als viele Stöße in eine gleichbleibende Richtung, ohne eine einzelne bahnbrechende Innovation.
- Skalierungsforschung: Hestness et al. fanden eine Skalierung des Generalisierungsfehlers nach Potenzgesetz in vier ML-Domänen, und Kaplan et al. berichteten, dass der Loss als Potenzgesetz mit Modellgröße, Datensatzgröße und Rechenleistung skaliert.
- Feedback schlägt Größe in einem Fall: Ausgaben von InstructGPT aus einem 1,3-Mrd.-Modell wurden denen des GPT-3 mit 175 Mrd. Parametern vorgezogen, trotz 100-mal weniger Parametern.
- Die skeptische Position: Casado und Lauten (2019) argumentieren, dass mehr Daten für sich allein keinen Netzwerkeffekt erzeugen und dass die Kosten einzigartiger Daten steigen können, während ihr zusätzlicher Wert sinkt.
- Ökonomie des Long Tail: Casado und Bornstein (2020) sagen, dass die Entwicklungskosten für KI-Anwendungen drei- bis fünfmal höher liegen können als bei typischer Software.
- Grenze öffentlicher Daten: Forscher von Epoch prognostizieren, dass Trainingsdatensätze zwischen 2026 und 2032 ungefähr dem Bestand an öffentlichem menschlichem Text entsprechen werden.

Co-Founder & COO
On this page
- Woher die Idee stammt
- Wie der Kreislauf tatsächlich funktioniert
- Welche Arten von Daten zählen
- Warum Daten zum Standard-Burggraben für KI wurden
- Wann ein Daten-Flywheel echt ist
- Wann es überschätzt wird
- Abnehmende Erträge
- Der Kaltstart ist begrenzt
- Der Long Tail ist teuer
- Öffentliche Daten untergraben Vorteile von der anderen Seite
- Bessere Basismodelle können Ihren Vorsprung aufsaugen
- Feedbackqualität statt Feedbackmenge
- Ein praktischer Test: Haben Sie eines?
- Wie ein Flywheel in einen größeren Burggraben passt
- Häufige Fehler
- Wichtige Fakten