Bahasa Indonesia
Apa Itu Flywheel Data?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Flywheel data adalah siklus di mana penggunaan sebuah produk menghasilkan data, data itu membuat produk lebih baik, dan produk yang lebih baik menarik lebih banyak penggunaan, yang kemudian menghasilkan lebih banyak data. Di startup AI, ini adalah jawaban paling populer untuk pertanyaan "apa yang mencegah perusahaan yang lebih besar meniru kami?" Ini juga salah satu jawaban yang paling sering dilebih-lebihkan. Sebagian produk memiliki flywheel yang sungguhan. Banyak lainnya hanya memiliki saluran data yang diberi diagram di sekelilingnya.
Halaman ini menjelaskan asal gagasan tersebut, cara kerja siklusnya yang sebenarnya, titik-titik spesifik di mana siklus itu rusak, serta serangkaian uji untuk menentukan apakah sebuah produk benar-benar memilikinya. Pembahasan ini merupakan bagian dari kumpulan pertanyaan parit pertahanan yang lebih luas, yang dibahas dalam peta daya pertahanan startup AI secara keseluruhan, dan sengaja dibuat sempit: data sebagai sumber keunggulan, bukan alur kerja, distribusi, atau merek.
Asal Gagasan Ini
Kata "flywheel" adalah metafora bisnis sebelum menjadi metafora data. Jim Collins mempopulerkannya dalam Good to Great, dan deskripsinya sendiri tentang konsep flywheel menggunakan gambaran mendorong roda yang sangat berat. Kemajuan awal nyaris tidak terasa, setiap dorongan dibangun di atas dorongan sebelumnya, dan pada titik tertentu momentum mulai bekerja untuk Anda. Collins menolak gagasan tentang satu langkah pamungkas: hasil datang dari akumulasi dorongan ke arah yang konsisten. Halaman umum kami tentang efek flywheel membahas versi strategi bisnisnya.
Versi data menambahkan mekanisme yang spesifik. Dalam gambaran Collins, roda berputar karena upaya yang berkelanjutan. Dalam gambaran data, roda seharusnya berputar sebagian dengan sendirinya, karena setiap interaksi pelanggan menghasilkan informasi yang menyempurnakan produk untuk pelanggan berikutnya. Klaim inilah yang membuatnya menarik bagi investor: ia menjanjikan imbal hasil yang terus bertambah, yang tidak dapat dilampaui pesaing hanya dengan uang.
Klaim ini juga yang paling layak diperiksa dengan cermat, karena sebenarnya ia adalah dua klaim yang dibungkus menjadi satu. Yang pertama, lebih banyak data membuat produk lebih baik. Yang kedua, peningkatan ini cukup besar, cukup cepat, dan cukup eksklusif untuk menahan para pesaing. Klaim pertama sering kali benar. Klaim kedua adalah tempat sebagian besar flywheel gagal.
Cara Kerja Siklus yang Sebenarnya
Flywheel data yang berfungsi memiliki empat mata rantai, dan masing-masing bisa menjadi titik terlemah.
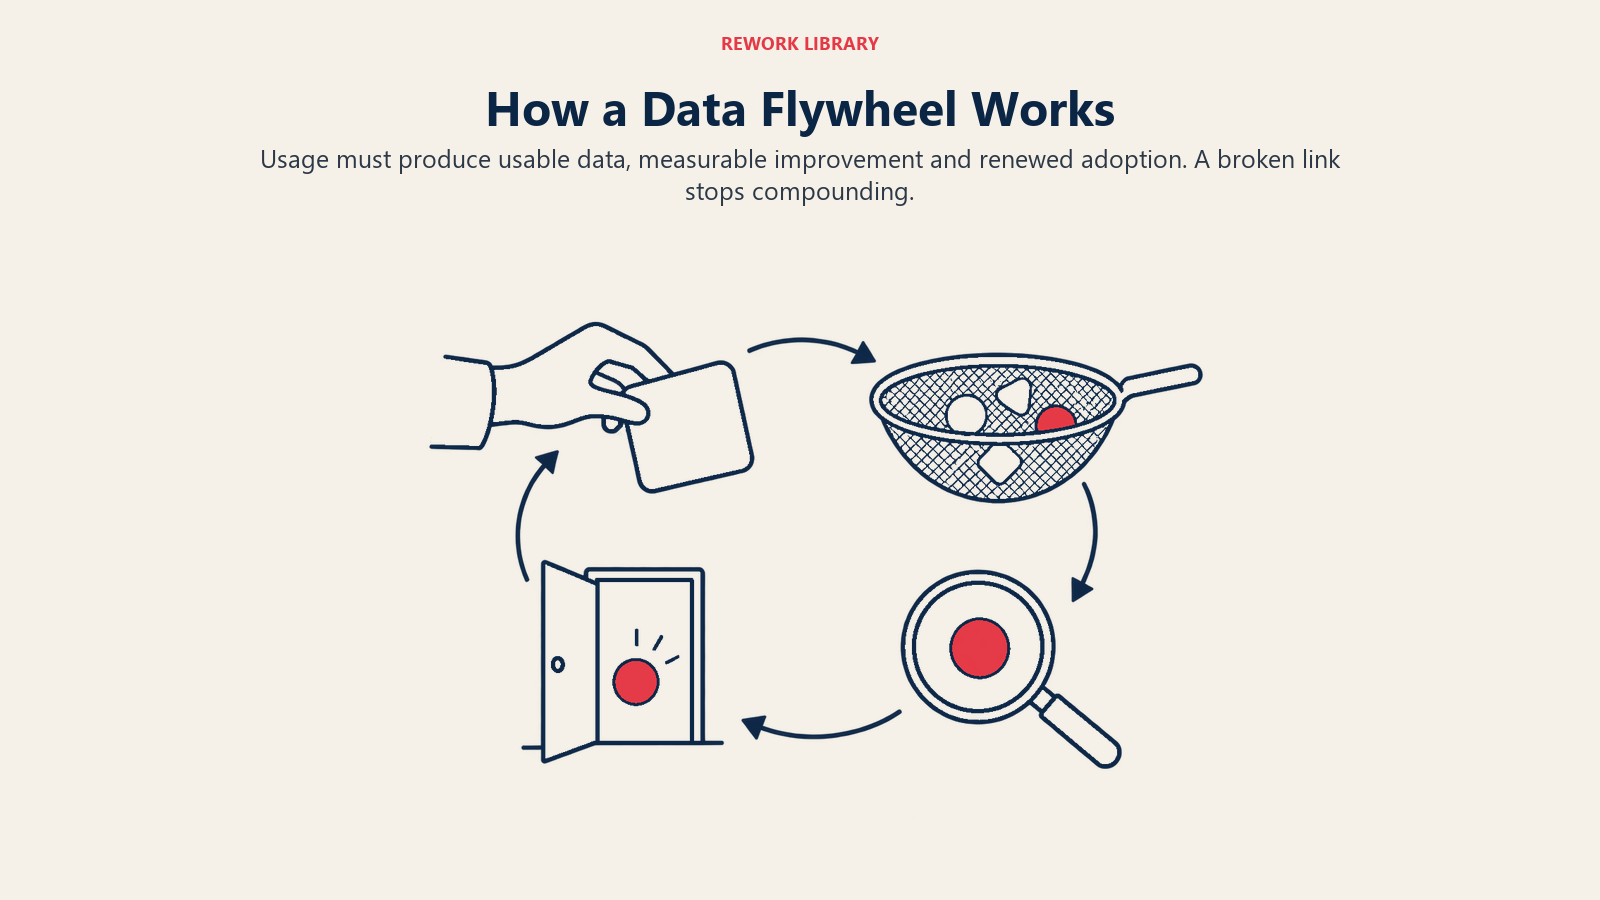
- Penggunaan menghasilkan data. Pelanggan melakukan sesuatu di dalam produk yang meninggalkan jejak berguna: koreksi, persetujuan, saran yang ditolak, tugas yang diselesaikan.
- Data ditangkap dan dibersihkan. Perusahaan memiliki izin untuk menggunakannya, menyimpannya dalam bentuk yang dapat dipakai, dan mampu memisahkan sinyal dari gangguan.
- Data menyempurnakan produk. Data itu memasok pelatihan model, fine-tuning, retrieval, prompt, set evaluasi, atau aturan, dan peningkatannya dapat diukur.
- Peningkatan mendorong lebih banyak penggunaan. Hasil yang lebih baik menumbuhkan lebih banyak kepercayaan, lebih banyak alur kerja, lebih banyak pelanggan, atau retensi yang lebih tinggi, dan siklusnya berulang.
Siklus ini hanya berlipat ganda jika keempat mata rantai bertahan. Banyak produk memiliki mata rantai pertama (semuanya meninggalkan log) tetapi tidak memiliki yang lain. Mengumpulkan data bukanlah flywheel. Flywheel adalah data yang digunakan, yang mengubah produk, dan yang mengubah perilaku pelanggan.
Jenis data apa yang diperhitungkan
Tidak semua data setara, dan jenisnya menentukan seberapa kuat daya pertahanan siklus tersebut.
| Jenis data | Contoh sinyal | Kekuatan umum sebagai parit pertahanan |
|---|---|---|
| Data publik atau yang dapat dibeli | Teks web, dataset berlisensi | Lemah: pesaing bisa mendapatkan masukan yang sama |
| Log penggunaan mentah | Klik, kueri, durasi sesi | Lemah hingga sedang: murah dikumpulkan, penuh gangguan untuk dipelajari |
| Umpan balik eksplisit | Jempol ke atas atau ke bawah, penilaian, peringkat | Sedang: berguna, tetapi jarang dan mudah dimanipulasi |
| Koreksi dan suntingan | Pengguna menulis ulang draf AI, agen ditimpa keputusannya | Kuat: diberi label oleh pakar yang mengerjakan pekerjaan nyata |
| Data hasil | Apakah deal tertutup, klaim terbayar, pasien pulih | Terkuat: mengaitkan keluaran dengan hasil nyata, sulit ditiru |
Polanya sederhana: semakin dekat data dengan keputusan nyata yang dibuat oleh pakar sungguhan, dan semakin jauh dari apa pun yang dapat di-scrape atau dibeli pesaing, semakin tinggi nilainya.
Mengapa Data Menjadi Parit Pertahanan AI Bawaan
Sebagian daya tariknya berasal dari riset. Penelitian tentang scaling dalam deep learning oleh Hestness dan rekan-rekannya menemukan bahwa galat generalisasi mengikuti hukum pangkat seiring bertambahnya data pelatihan, di bidang terjemahan mesin, pemodelan bahasa, pemrosesan citra, dan pengenalan suara. Penelitian berikutnya tentang hukum scaling untuk model bahasa melaporkan bahwa loss berskala mengikuti hukum pangkat terhadap ukuran model, ukuran dataset, dan komputasi, dengan sebagian tren mencakup lebih dari tujuh orde besaran. Tafsiran populernya adalah "lebih banyak data, model lebih baik, secara andal." Tafsiran itulah benih dari cerita flywheel.
Alasan kedua adalah bahwa belajar dari manusia memang berhasil. Makalah InstructGPT dari OpenAI melaporkan bahwa keluaran dari model 1,3 miliar parameter yang dilatih dengan demonstrasi pelabel dan keluaran berperingkat lebih disukai daripada keluaran GPT-3 dengan 175 miliar parameter, meskipun modelnya memiliki parameter 100 kali lebih sedikit. Dengan kata lain, data umpan balik bisa lebih menentukan perilaku produk daripada skala mentah.
Kedua temuan itu nyata. Tidak satu pun membuktikan bahwa sebuah startup memiliki parit pertahanan. Hukum pangkat juga merupakan kurva hasil yang semakin menurun, dan perusahaan yang membayar pelabel sedang menggambarkan proses yang bisa ditiru oleh pesaing mana pun yang memiliki pendanaan kuat.
Kapan Flywheel Data Itu Nyata
Flywheel cenderung sungguhan bila sebagian besar hal berikut terpenuhi.
Data bersifat eksklusif dan dihasilkan oleh produk itu sendiri. Jika data terbaik berasal dari pekerjaan pelanggan Anda sendiri, pesaing tidak dapat melisensikan atau meng-crawl-nya. Mereka harus memenangkan pelanggan terlebih dahulu, dan itu masalah yang lebih sulit.
Data sulit diperoleh tanpa alur kerja tersebut. Data yang merupakan produk sampingan dari tugas yang memang harus dikerjakan orang (meninjau dokumen, menyelesaikan tiket, menyetujui faktur) terkumpul tanpa upaya tambahan dari pengguna. Data yang mengharuskan pengguna berhenti dan memberi penilaian hanya mengalir sedikit demi sedikit. Untuk bagaimana posisi dalam alur kerja menciptakan keunggulannya sendiri, lihat lock-in alur kerja AI.
Peningkatan terlihat oleh pelanggan. Jika model yang lebih baik tidak pernah mengubah apa yang dilihat pelanggan, siklus itu tidak mendorong penggunaan. Ujinya adalah apakah pelanggan dapat merasakan, tanpa diberi tahu, bahwa produknya menjadi lebih baik.
Domainnya memiliki ekor panjang yang dapat dicakup oleh data. Ketika masukan beragam dan berantakan, kasus-kasus tepi yang terkumpul justru menjadi produknya. Inilah inti argumen untuk AI vertikal: domain yang sempit memberi data tempat untuk terkonsentrasi.
Siklus mencakup hasil, bukan sekadar aktivitas. Mengetahui apa yang dilakukan pelanggan memang berguna. Mengetahui apa yang terjadi sesudahnya itulah yang memungkinkan produk mempelajari arti "baik".
Kerabat terdekat siklus data dalam strategi klasik adalah efek jaringan dan biaya peralihan. Data dapat memperkuat keduanya, tetapi tidak otomatis menjadi salah satunya. Efek jaringan berarti setiap pengguna baru membuat produk lebih bernilai bagi setiap pengguna lainnya. Siklus data biasanya berarti setiap pengguna baru membuat produk sedikit lebih baik untuk semua orang, dan itu sesuatu yang lebih lemah.
Kapan Ini Dinilai Terlalu Tinggi
Bagian inilah yang cenderung dilewati para founder dan investor. Esai Martin Casado dan Peter Lauten, "The Empty Promise of Data Moats", yang diterbitkan pada 2019, menyampaikan argumen skeptisnya secara langsung. Argumen utama mereka adalah bahwa umumnya tidak ada efek jaringan yang melekat hanya karena memiliki lebih banyak data, dan bahwa apa yang tampak seperti efek jaringan biasanya adalah efek skala, dengan satu perbedaan penting dari skala ekonomi klasik: biaya menambahkan data unik ke korpus Anda bisa naik, sementara nilai data tambahan justru turun.
Penalaran mereka memberikan daftar periksa yang berguna tentang titik-titik kegagalan.
Hasil yang semakin menurun
Contoh chatbot dalam esai tersebut adalah ilustrasi paling jelas. Mengumpulkan potongan kueri pertama mencakup pertanyaan-pertanyaan umum dan memberikan peningkatan besar. Ketika sebuah perusahaan telah melihat 40 persen kueri dalam contoh itu, tidak ada lagi keuntungan dari mengumpulkan lebih banyak. Kurvanya mendatar, dan pesaing yang mencapai bagian datar kurva berada pada posisi setara. Hukum pangkat dalam makalah riset dan kurva datar dalam rencana bisnis adalah bentuk yang sama, hanya dilihat dari jarak yang berbeda.
Cold start itu terbatas
Esai yang sama berpendapat bahwa membangun korpus minimum yang layak adalah hal yang dapat dicapai, sehingga tidak dapat menjadi parit pertahanan yang tahan lama dengan sendirinya. Jika pendatang baru dapat mencapai tingkat "cukup baik" dengan data yang dibeli, data sintetis, beberapa mitra desain, atau model dasar yang kuat, keunggulan awal pemain lama menyusut menjadi keunggulan awal pada ekor panjang saja.
Ekor panjang itu mahal
Dalam tulisan berikutnya, Taming the Tail, Casado dan Matt Bornstein berpendapat bahwa distribusi berekor panjang adalah hal yang lazim dalam masalah ML, dan ini dapat berarti disekonomi skala: porsi pekerjaan yang terus bertambah jatuh pada area di mana nilai per kasus paling rendah. Mereka juga melaporkan bahwa biaya pengembangan aplikasi AI dapat mencapai tiga hingga lima kali lebih tinggi daripada perangkat lunak pada umumnya. Flywheel yang harus memakan kasus-kasus langka adalah flywheel dengan gesekan yang meningkat, bukan yang menurun.
Data publik menggerus keunggulan dari sisi lain
Foundation model sebagian besar dilatih dengan data publik, dan persediaannya terbatas. Riset Epoch tentang batas scaling LLM berdasarkan data buatan manusia memproyeksikan bahwa model akan dilatih dengan dataset yang kira-kira seukuran persediaan teks manusia publik yang tersedia antara 2026 dan 2032. Pelajaran yang relevan bagi startup bukanlah tentang habisnya data. Pelajarannya adalah bahwa ketika model umum semakin baik dalam hal-hal yang dapat diajarkan oleh data publik, bagian produk yang bergantung pada data publik berhenti menjadi pembeda. Yang tersisa adalah apa pun yang tidak dapat dilihat publik.
Model dasar yang lebih baik dapat menyerap keunggulan Anda
Jika keunggulan data sebuah startup adalah "kami melakukan fine-tuning dengan contoh-contoh yang menyempurnakan tugas umum," foundation model yang lebih kuat yang dirilis kuartal depan mungkin menutup celah itu tanpa data baru sama sekali. Inilah risiko praktis di balik pertanyaan dalam AI wrapper vs AI-native: keunggulan yang berada di lapisan model yang tidak Anda kendalikan adalah keunggulan sewaan, bukan milik sendiri.
Kualitas umpan balik, bukan kuantitasnya
Volume mudah diukur dan mudah dibanggakan. Kualitas lebih sulit. Tombol jempol ke atas diklik oleh orang yang terburu-buru, label bergeser ketika peninjau yang berbeda tidak sepakat, dan log mencatat apa yang dilakukan pengguna, bukan apakah itu benar. Flywheel yang diberi makan umpan balik yang penuh gangguan bisa terus berputar tanpa menyempurnakan apa pun. Sinyal terbersih biasanya adalah koreksi dari pakar atau hasil yang terverifikasi, dan keduanya berasal dari praktik evaluasi dan kepercayaan yang baru dibangun belakangan oleh sebagian besar tim.
Uji Praktis: Apakah Anda Memilikinya?
Pertanyaan-pertanyaan yang memisahkan flywheel yang berfungsi dari sekadar slogan:
| Pertanyaan | Seperti apa jawaban yang kuat |
|---|---|
| Dapatkah pesaing membeli atau melakukan scraping data yang setara? | Tidak, karena data itu hanya ada di dalam alur kerja pelanggan kami |
| Apakah kami memiliki izin untuk menggunakan data pelanggan demi penyempurnaan? | Ya, tercantum dalam kontrak, dengan cakupan yang jelas |
| Dapatkah kami menunjukkan bahwa produk menjadi lebih baik karena data? | Ya, perbandingan sebelum dan sesudah pada set evaluasi yang tetap |
| Apakah peningkatannya terlihat pada retensi, penggunaan, atau tingkat kemenangan? | Ya, diukur, bukan diasumsikan |
| Di mana posisi kami pada kurva? | Kami tahu apakah kami berada di awal, tengah, atau bagian datar kurva |
| Apa yang terjadi jika model dasar yang lebih kuat dirilis? | Keunggulan kami bertahan karena berada di atas model, bukan di dalamnya |
| Seberapa cepat pelanggan baru mencapai tingkat "baik"? | Lebih cepat daripada pesaing yang memulai dari nol |
Pertanyaan tentang kurva adalah yang paling penting. Startup yang dapat memetakan kualitas terhadap volume data eksklusif mengetahui di antara tiga situasi mana ia berada: masih menanjak, di mana lebih banyak data sangat berharga; mulai mendatar, di mana data tambahan bernilai kecil; atau sudah datar, di mana parit pertahanan harus datang dari tempat lain. Sebagian besar founder belum pernah membuat grafik ini.
Kebiasaan kedua juga membantu: pertahankan set evaluasi tetap yang tidak pernah masuk ke pelatihan. Tanpanya, setiap klaim peningkatan hanyalah anekdot. Gagasan pengukuran terkait muncul dalam metrik adopsi produk AI, dan sisi infrastruktur untuk menangkap penggunaan dibahas dalam siklus telemetri untuk AI di dalam produk serta keunggulan telemetri produk.
Bagaimana Flywheel Masuk ke Dalam Parit Pertahanan yang Lebih Besar
Bahkan flywheel data yang kuat jarang berdiri sendiri. Dalam bahasa strategi klasik, parit pertahanan ekonomi adalah keunggulan yang tahan lama, dan tahan lama biasanya berarti beberapa sumber yang saling memperkuat. Data cenderung berpasangan dengan:
- Posisi dalam alur kerja. Berada di tempat pekerjaan berlangsung adalah satu-satunya cara data itu dihasilkan.
- Distribusi. Lebih banyak pelanggan berarti lebih banyak data, dan pertanyaan tentang bagaimana Anda memenangkan pelanggan pertama itu adalah hal terpisah, lihat parit pertahanan distribusi AI.
- Biaya peralihan. Konfigurasi khusus pelanggan yang terkumpul membuat kepergian terasa menyakitkan, sehingga data terus mengalir.
Perlakukan flywheel sebagai penguat bagi keunggulan lain, bukan penggantinya. Peringatan Casado dan Lauten adalah bahwa memperlakukan data sebagai parit pertahanan ajaib dapat mengalihkan founder dari hal yang sebenarnya mereka butuhkan untuk menang. Versi gagasan yang berguna lebih sempit dan lebih mudah diuji: untuk produk ini, dalam domain ini, apakah data penggunaan eksklusif secara terukur menyempurnakan hasil dengan cara yang tidak dapat segera disamai pesaing?
Kesalahan Umum
- Menganggap log sebagai keunggulan data. Volume tanpa label atau hasil hanya mengajarkan sedikit.
- Mengasumsikan kurva tidak pernah mendatar. Hasil yang semakin menurun berlaku untuk data Anda sama seperti untuk data siapa pun.
- Mengabaikan hak atas data. Jika kontrak pelanggan tidak mengizinkan pembelajaran dari data mereka, siklus itu terhalang secara hukum.
- Membangun siklus di atas model sewaan. Jika peningkatannya dapat direplikasi dengan meng-upgrade model dasar, itu bukan milik Anda.
- Mengukur volume pelatihan alih-alih kualitas yang terlihat oleh pelanggan. Siklus tertutup ketika pelanggan menyadarinya.
- Melewatkan kelompok kontrol. Tanpa set evaluasi yang disisihkan, Anda tidak dapat membedakan peningkatan dari pergeseran.
Fakta Utama
- Asal metafora: Jim Collins menggambarkan flywheel sebagai akumulasi dorongan ke arah yang konsisten, tanpa satu inovasi pamungkas.
- Riset scaling: Hestness dkk. menemukan scaling galat generalisasi mengikuti hukum pangkat di empat domain ML, dan Kaplan dkk. melaporkan scaling loss mengikuti hukum pangkat terhadap ukuran model, ukuran dataset, dan komputasi.
- Umpan balik mengalahkan ukuran dalam satu kasus: Keluaran InstructGPT dari model 1,3B lebih disukai daripada keluaran GPT-3 175B, meskipun parameternya 100x lebih sedikit.
- Argumen skeptis: Casado dan Lauten (2019) berpendapat bahwa memiliki lebih banyak data tidak dengan sendirinya menciptakan efek jaringan, dan bahwa biaya data unik bisa naik sementara nilai tambahannya turun.
- Ekonomi ekor panjang: Casado dan Bornstein (2020) menyatakan biaya pengembangan aplikasi AI dapat mencapai 3-5x lebih tinggi daripada perangkat lunak pada umumnya.
- Batas data publik: Para peneliti Epoch memproyeksikan dataset pelatihan akan kira-kira menyamai persediaan teks manusia publik antara 2026 dan 2032.

Co-Founder & COO
On this page
- Asal Gagasan Ini
- Cara Kerja Siklus yang Sebenarnya
- Jenis data apa yang diperhitungkan
- Mengapa Data Menjadi Parit Pertahanan AI Bawaan
- Kapan Flywheel Data Itu Nyata
- Kapan Ini Dinilai Terlalu Tinggi
- Hasil yang semakin menurun
- Cold start itu terbatas
- Ekor panjang itu mahal
- Data publik menggerus keunggulan dari sisi lain
- Model dasar yang lebih baik dapat menyerap keunggulan Anda
- Kualitas umpan balik, bukan kuantitasnya
- Uji Praktis: Apakah Anda Memilikinya?
- Bagaimana Flywheel Masuk ke Dalam Parit Pertahanan yang Lebih Besar
- Kesalahan Umum
- Fakta Utama