O que é um flywheel de dados?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Um flywheel de dados é um ciclo em que o uso de um produto gera dados, esses dados tornam o produto melhor, e o produto melhor atrai mais uso, que gera mais dados. Em startups de IA, é a resposta mais popular para a pergunta "o que impede uma empresa maior de nos copiar?". Também é uma das respostas mais exageradas. Alguns produtos têm um flywheel genuíno. Muitos têm um duto de dados com um diagrama desenhado em volta.
Esta página explica de onde vem a ideia, como o ciclo realmente funciona, as formas específicas como ele quebra e um conjunto de testes para decidir se um produto tem um. Ela faz parte de um conjunto mais amplo de perguntas sobre fosso competitivo, tratado no mapa de defensabilidade de startups de IA, e permanece propositalmente restrita: dados como fonte de vantagem, não workflow, distribuição ou marca.
De onde vem a ideia
A palavra "flywheel" é uma metáfora de negócios antes de ser uma metáfora de dados. Jim Collins a popularizou em Good to Great, e a sua própria descrição do conceito de flywheel usa a imagem de empurrar uma roda muito pesada. O progresso inicial é quase imperceptível, cada empurrão se apoia no anterior e, em algum momento, o impulso começa a trabalhar a seu favor. Collins rejeita a ideia de um único movimento decisivo: os resultados vêm de empurrões acumulados em uma direção consistente. Nossa página geral sobre o efeito flywheel aborda a versão de estratégia de negócios.
A versão de dados acrescenta um mecanismo específico. Na imagem de Collins, a roda gira por causa de esforço contínuo. Na imagem de dados, a roda deveria girar em parte sozinha, porque cada interação com o cliente produz informações que melhoram o produto para o próximo cliente. É essa afirmação que a torna atraente para investidores: ela promete retornos compostos que um concorrente não consegue superar apenas com dinheiro.
Também é a afirmação que mais merece escrutínio, porque na verdade são duas afirmações juntas. A primeira é que mais dados tornam o produto melhor. A segunda é que essa melhoria é grande o suficiente, rápida o suficiente e exclusiva o suficiente para manter os rivais de fora. A primeira costuma ser verdadeira. A segunda é onde a maioria dos flywheels falha.
Como o ciclo realmente funciona
Um flywheel de dados que funciona tem quatro elos, e qualquer um deles pode ser o mais fraco.
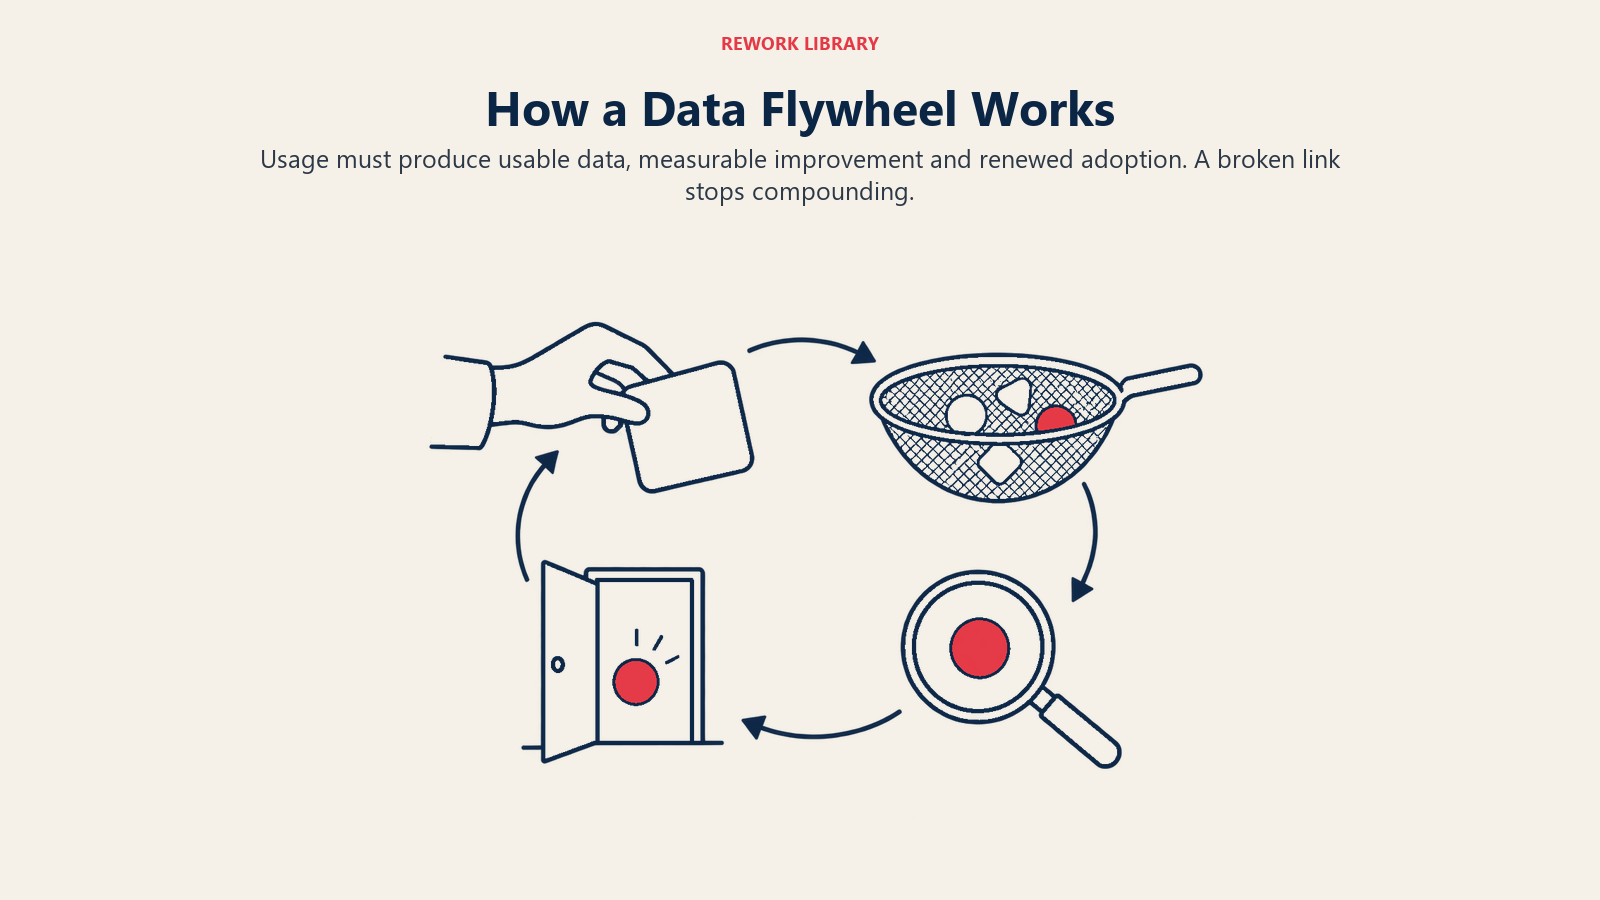
- O uso gera dados. Os clientes fazem algo no produto que deixa um rastro útil: uma correção, uma aprovação, uma sugestão rejeitada, uma tarefa concluída.
- Os dados são capturados e limpos. A empresa tem permissão para usá-los, armazena-os em formato utilizável e consegue separar sinal de ruído.
- Os dados melhoram o produto. Eles alimentam treinamento de modelos, fine-tuning, recuperação, prompts, conjuntos de avaliação ou regras, e a melhoria é mensurável.
- A melhoria gera mais uso. Resultados melhores conquistam mais confiança, mais workflows, mais clientes ou mais retenção, e o ciclo se repete.
O ciclo só se acumula se os quatro elos se sustentarem. Muitos produtos têm o primeiro elo (tudo gera logs) e nenhum dos outros. Coletar dados não é um flywheel. Um flywheel são dados que são usados, que mudam o produto e que mudam o comportamento do cliente.
Que tipos de dados contam
Nem todos os dados são iguais, e o tipo decide o quão defensável é o ciclo.
| Tipo de dado | Exemplo de sinal | Força típica como fosso |
|---|---|---|
| Dados públicos ou compráveis | Texto da web, datasets licenciados | Fraca: os rivais conseguem os mesmos insumos |
| Logs brutos de uso | Cliques, consultas, duração da sessão | Fraca a moderada: baratos de coletar, ruidosos para aprender |
| Feedback explícito | Joinha para cima ou para baixo, notas, rankings | Moderada: útil, mas escasso e fácil de manipular |
| Correções e edições | Um usuário reescreve um rascunho da IA, um agente tem uma decisão revertida | Forte: rotulado por um especialista fazendo trabalho real |
| Dados de resultado | O negócio fechou, o sinistro foi pago, o paciente se recuperou | A mais forte: liga o resultado da IA a um desfecho real, difícil de replicar |
O padrão é simples: quanto mais perto o dado está de uma decisão real tomada por um especialista real, e quanto mais longe está de qualquer coisa que um concorrente possa raspar ou comprar, mais ele vale.
Por que os dados viraram o fosso padrão da IA
Parte do apelo vem da pesquisa. O trabalho sobre escalabilidade em deep learning de Hestness e colegas descobriu que o erro de generalização segue uma lei de potência à medida que os dados de treinamento crescem, em tradução automática, modelagem de linguagem, processamento de imagens e reconhecimento de fala. Um trabalho posterior sobre leis de escala para modelos de linguagem relatou que a perda escala como uma lei de potência com o tamanho do modelo, o tamanho do dataset e a computação, com algumas tendências cobrindo mais de sete ordens de grandeza. A leitura popular é "mais dados, modelo melhor, de forma confiável". Essa leitura é a semente da história do flywheel.
Uma segunda razão é que aprender com pessoas funciona. O artigo do InstructGPT da OpenAI relatou que os resultados de um modelo de 1,3 bilhão de parâmetros treinado com demonstrações de rotuladores e resultados ranqueados foram preferidos aos do GPT-3 de 175 bilhões de parâmetros, apesar de o modelo ter 100 vezes menos parâmetros. Em outras palavras, dados de feedback podem importar mais do que a escala bruta para o comportamento de um produto.
As duas descobertas são reais. Nenhuma prova que uma startup tem um fosso. Uma lei de potência também é uma curva de retornos decrescentes, e uma empresa que paga rotuladores está descrevendo um processo que qualquer rival bem financiado consegue copiar.
Quando um flywheel de dados é real
Um flywheel tende a ser genuíno quando a maioria das condições abaixo é verdadeira.
Os dados são proprietários e gerados pelo próprio produto. Se os melhores dados vêm do trabalho dos seus próprios clientes, um rival não consegue licenciá-los nem rastreá-los. Ele precisa primeiro conquistar clientes, que é o problema mais difícil.
Os dados são difíceis de obter sem o workflow. Dados que são subproduto de uma tarefa que as pessoas precisam fazer de qualquer forma (revisar um documento, resolver um chamado, aprovar uma fatura) se acumulam sem esforço extra dos usuários. Dados que exigem que os usuários parem para avaliar coisas chegam a conta-gotas. Para entender como a posição no workflow cria a sua própria vantagem, veja lock-in de fluxo de trabalho em IA.
A melhoria é visível para os clientes. Se um modelo melhor nunca muda o que o cliente vê, o ciclo não gera uso. O teste é se um cliente conseguiria perceber, sem ser avisado, que o produto melhorou.
O domínio tem uma cauda longa que os dados podem cobrir. Onde as entradas são variadas e bagunçadas, os casos extremos acumulados são o produto. Esse é o núcleo do argumento a favor da IA vertical: domínios restritos dão aos dados um lugar para se concentrar.
O ciclo inclui resultados, não apenas atividade. Saber o que os clientes fizeram é útil. Saber o que aconteceu depois é o que permite ao produto aprender o que significa "bom".
Os parentes mais próximos do ciclo de dados na estratégia clássica são os efeitos de rede e os custos de troca. Os dados podem alimentar os dois, mas não são automaticamente nenhum deles. Um efeito de rede significa que cada novo usuário torna o produto mais valioso para todos os outros usuários. Um ciclo de dados geralmente significa que cada novo usuário torna o produto um pouco melhor para todos, o que é algo mais fraco.
Quando ele é superestimado
Esta é a parte que fundadores e investidores costumam pular. O ensaio de Martin Casado e Peter Lauten "The Empty Promise of Data Moats", publicado em 2019, apresenta o argumento cético de forma direta. O argumento central é que, em geral, não existe um efeito de rede inerente ao simples fato de ter mais dados, e que aquilo que parece um efeito de rede costuma ser um efeito de escala, com uma diferença crucial em relação às economias de escala clássicas: o custo de adicionar dados únicos ao seu acervo pode subir enquanto o valor dos dados incrementais cai.
O raciocínio deles oferece uma lista útil de modos de falha.
Retornos decrescentes
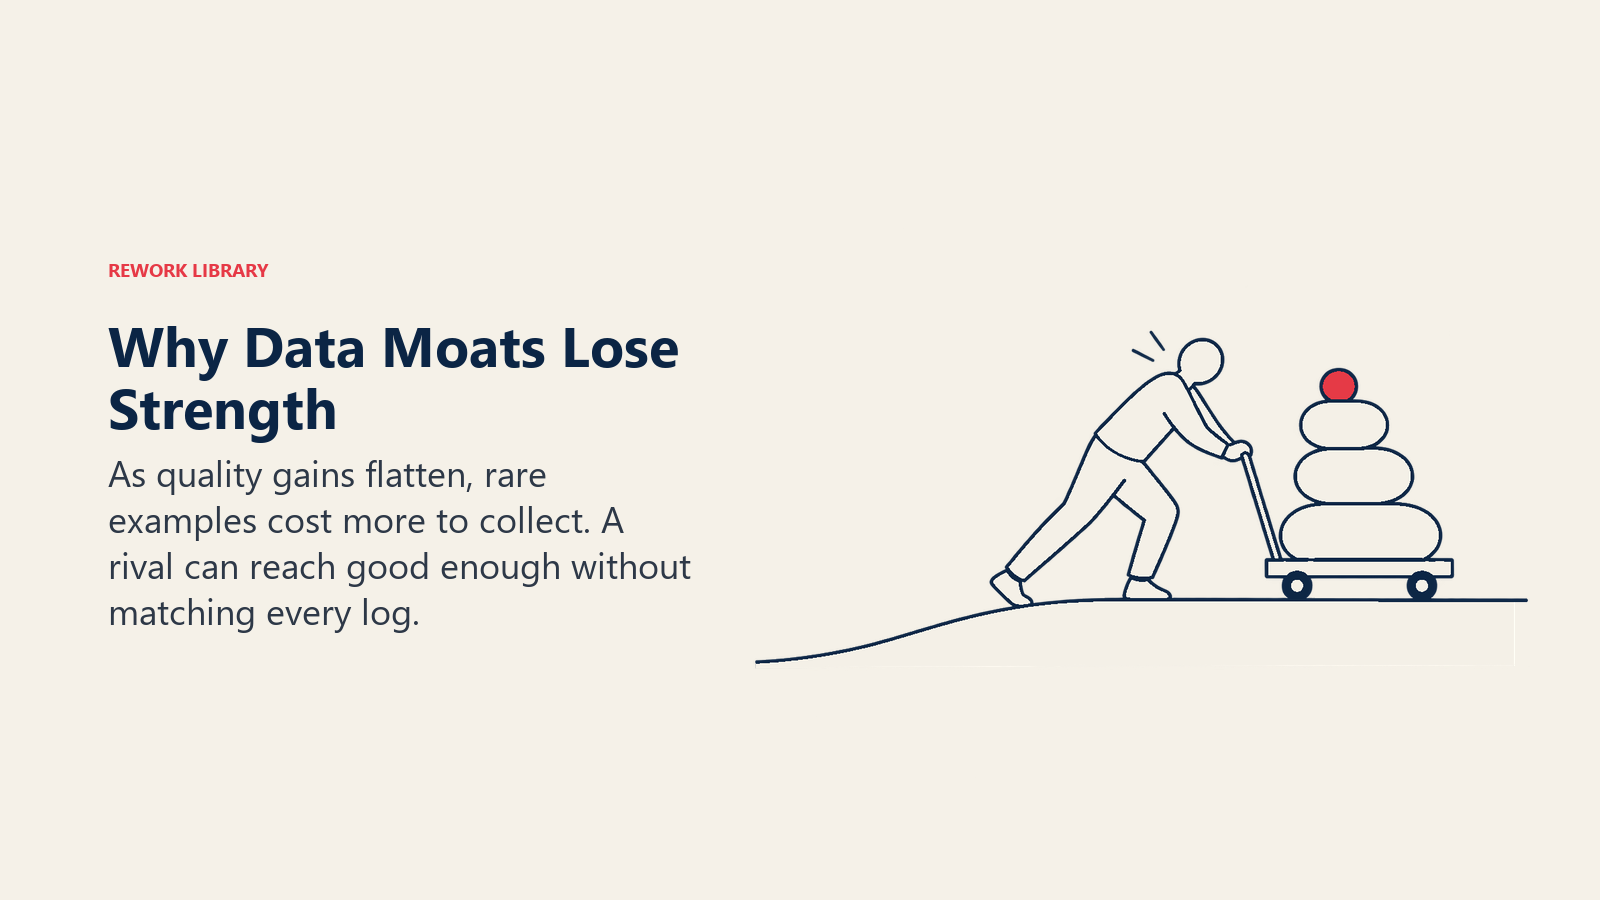
O exemplo do chatbot no ensaio é a ilustração mais clara. Coletar a primeira fatia de consultas cobre as perguntas comuns e traz grandes ganhos. Quando a empresa já viu 40% das consultas no exemplo, não resta vantagem em coletar mais. A curva se achata, e um rival que chega à parte plana da curva está em pé de igualdade. Uma lei de potência em um artigo científico e uma curva plana em um plano de negócios são a mesma forma vista de distâncias diferentes.
O cold start é limitado
O mesmo ensaio argumenta que montar um acervo mínimo viável é algo alcançável e, por isso, não pode ser um fosso duradouro por si só. Se um novo entrante consegue chegar ao "bom o suficiente" com dados comprados, dados sintéticos, alguns parceiros de design ou um modelo-base forte, a vantagem inicial do incumbente encolhe para uma vantagem apenas na cauda longa.
A cauda longa é cara
Em um texto posterior, Taming the Tail, Casado e Matt Bornstein argumentam que distribuições de cauda longa são endêmicas em problemas de ML e que isso pode significar deseconomias de escala: uma parcela crescente do trabalho cai onde o valor por instância é menor. Eles também relatam que os custos de desenvolvimento de aplicações de IA podem ser de três a cinco vezes maiores do que no software típico. Um flywheel que precisa se alimentar de casos raros é um flywheel com atrito crescente, não decrescente.
Dados públicos corroem vantagens pelo outro lado
Os modelos de fundação são treinados em grande parte com dados públicos, e esse estoque é finito. A pesquisa da Epoch sobre os limites da escala de LLM com base em dados gerados por humanos projeta que os modelos serão treinados com datasets aproximadamente do tamanho do estoque disponível de texto humano público entre 2026 e 2032. A lição relevante para startups não é sobre o fim dos dados. É que, à medida que os modelos gerais melhoram naquilo que os dados públicos podem ensinar, a parte de um produto que depende de dados públicos deixa de ser um diferencial. O que sobra é tudo aquilo que o público não consegue ver.
Modelos-base melhores podem absorver a sua vantagem
Se a vantagem de dados de uma startup é "fizemos fine-tuning com exemplos que melhoram uma tarefa comum", um modelo de fundação mais forte lançado no próximo trimestre pode fechar essa lacuna sem nenhum dado novo. Esse é o risco prático por trás da pergunta em AI wrapper vs AI-native: uma vantagem que vive na camada de modelo que você não controla é alugada, não própria.
Qualidade do feedback, não quantidade
Volume é fácil de medir e fácil de exibir. Qualidade é mais difícil. Botões de joinha são clicados por pessoas com pressa, os rótulos mudam quando revisores diferentes discordam, e os logs registram o que os usuários fizeram, não se estava certo. Um flywheel alimentado por feedback ruidoso pode girar sem melhorar nada. O sinal mais limpo geralmente é a correção de um especialista ou um resultado verificado, e eles vêm de práticas de avaliação e confiança que a maioria das equipes constrói tarde.
Um teste prático: você tem um?
Perguntas que separam um flywheel que funciona de um slogan:
| Pergunta | Como é uma resposta forte |
|---|---|
| Um concorrente consegue comprar ou raspar dados equivalentes? | Não, porque eles só existem dentro dos workflows dos nossos clientes |
| Temos permissão para usar dados dos clientes para melhorias? | Sim, em contrato, com escopo claro |
| Conseguimos mostrar que o produto melhorou por causa dos dados? | Sim, um antes e depois em um conjunto de avaliação fixo |
| O ganho aparece na retenção, no uso ou na taxa de conversão? | Sim, medido, não presumido |
| Onde estamos na curva? | Sabemos se estamos no início, no meio ou na parte plana |
| O que acontece se um modelo-base mais forte for lançado? | Nossa vantagem sobrevive porque fica acima do modelo, não dentro dele |
| Com que rapidez um novo cliente chega ao "bom"? | Mais rápido do que chegaria com um rival começando do zero |
A pergunta da curva é a mais importante. Uma startup que consegue traçar a qualidade em relação ao volume de dados proprietários sabe em qual de três situações está: ainda subindo, quando mais dados valem muito; achatando, quando dados adicionais valem pouco; ou já plana, quando o fosso precisa vir de outro lugar. A maioria dos fundadores nunca desenhou esse gráfico.
Um segundo hábito ajuda: manter um conjunto de avaliação fixo que nunca entra no treinamento. Sem ele, qualquer afirmação de melhoria é anedota. Ideias de medição relacionadas aparecem em métricas de adoção de produtos de IA, e o lado da infraestrutura para capturar o uso é tratado em ciclos de telemetria para IA dentro do produto e na vantagem da telemetria de produto.
Como um flywheel se encaixa em um fosso maior
Mesmo um flywheel de dados forte raramente se sustenta sozinho. Na linguagem clássica de estratégia, um fosso econômico é uma vantagem duradoura, e duradoura geralmente significa várias fontes que se reforçam. Os dados costumam se combinar com:
- Posição no workflow. Estar onde o trabalho acontece é o que faz os dados serem gerados.
- Distribuição. Mais clientes significam mais dados, e a questão de como conquistar esses primeiros clientes é separada, veja fosso de distribuição em IA.
- Custos de troca. Configurações acumuladas e específicas de cada cliente tornam a saída dolorosa, o que mantém os dados chegando.
Trate o flywheel como um amplificador de outras vantagens, não como substituto delas. O alerta de Casado e Lauten é que tratar os dados como um fosso mágico pode desviar os fundadores do que eles realmente precisam para vencer. A versão útil da ideia é mais restrita e mais testável: para este produto, neste domínio, os dados proprietários de uso melhoram os resultados de forma mensurável, de um jeito que um rival não consegue igualar rapidamente?
Erros comuns
- Contar logs como vantagem de dados. Volume sem rótulos ou resultados ensina pouco.
- Presumir que a curva nunca se achata. Retornos decrescentes valem para os seus dados tanto quanto para os de qualquer outro.
- Ignorar os direitos sobre os dados. Se os contratos com clientes não permitem aprender com os dados deles, o ciclo está bloqueado juridicamente.
- Construir o ciclo em torno de um modelo alugado. Se a melhoria pode ser replicada com a atualização de um modelo-base, ela não é sua.
- Medir volume de treinamento em vez de qualidade visível ao cliente. O ciclo se fecha quando os clientes percebem.
- Pular o grupo de controle. Sem um conjunto de avaliação reservado, você não consegue distinguir melhoria de desvio.
Fatos principais
- Origem da metáfora: Jim Collins descreve o flywheel como empurrões acumulados em uma direção consistente, sem uma única inovação decisiva.
- Pesquisa sobre escala: Hestness et al. encontraram escala do erro de generalização segundo uma lei de potência em quatro domínios de ML, e Kaplan et al. relataram que a perda escala como uma lei de potência com o tamanho do modelo, o tamanho do dataset e a computação.
- Feedback supera tamanho em um caso: os resultados do InstructGPT com um modelo de 1,3B foram preferidos aos do GPT-3 de 175B, apesar de ter 100x menos parâmetros.
- O argumento cético: Casado e Lauten (2019) argumentam que ter mais dados não cria, por si só, um efeito de rede, e que o custo de dados únicos pode subir enquanto o seu valor incremental cai.
- Economia da cauda longa: Casado e Bornstein (2020) dizem que os custos de desenvolvimento de aplicações de IA podem ser de 3 a 5x maiores do que no software típico.
- Limite dos dados públicos: pesquisadores da Epoch projetam que os datasets de treinamento vão se igualar aproximadamente ao estoque de texto humano público entre 2026 e 2032.

Co-Founder & COO
On this page
- De onde vem a ideia
- Como o ciclo realmente funciona
- Que tipos de dados contam
- Por que os dados viraram o fosso padrão da IA
- Quando um flywheel de dados é real
- Quando ele é superestimado
- Retornos decrescentes
- O cold start é limitado
- A cauda longa é cara
- Dados públicos corroem vantagens pelo outro lado
- Modelos-base melhores podem absorver a sua vantagem
- Qualidade do feedback, não quantidade
- Um teste prático: você tem um?
- Como um flywheel se encaixa em um fosso maior
- Erros comuns
- Fatos principais