Genauigkeitskontrollen für KI im Finanzwesen: falsche Zahlen verhindern
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Genauigkeitskontrollen für KI im Finanzwesen sind die Prüfungen zwischen dem Ergebnis eines KI-Tools und Ihren Büchern, Berichten oder Entscheidungen: Tie-outs zu Quelldokumenten, Toleranzschwellen, unabhängige Nachberechnung, Abstimmung und eine klar definierte menschliche Prüfung. Es geht nicht darum, dem Tool zu misstrauen. Eine flüssig formulierte, selbstsicher falsche Zahl sieht genau so aus wie eine richtige, und nur eine im Voraus entworfene Kontrolle unterscheidet die beiden.
Dieser Leitfaden richtet sich an Controller, FP&A-Leiter, Finanzmanager und alle, die Zahlen freigeben, an denen ein KI-Tool mitgewirkt hat. Wenn Sie noch entscheiden, wo Sie KI einsetzen, beginnen Sie mit KI-Anwendungsfällen im Finanzwesen. Wenn Sie sich um Prüfung und SOX-Umfang sorgen, lesen Sie parallel dazu KI und interne Kontrollen. Dieser Artikel bildet die praktische Ebene darunter: welche Kontrollen welche Fehler abfangen.
Wichtige Fakten
- FinanceBench, ein veröffentlichter Benchmark mit 10.231 Fragen zu börsennotierten Unternehmen, ergab: GPT-4-Turbo mit einem Retrieval-System beantwortete in der 150 Fälle umfassenden Stichprobe der Autoren 81 % der Fragen falsch oder verweigerte die Antwort (arXiv).
- Selbst die beste von den FinanceBench-Autoren getestete Konfiguration, GPT-4-Turbo mit langem Kontextfenster, war nur in 79 % der Fälle korrekt. Die Autoren warnen, dass falsche Einheiten, veraltete Zahlen und fehlerhafte Logik „ohne genaue Prüfung möglicherweise nicht erkennbar sind“ (FinanceBench paper).
- Von den 8.908 FinanceBench-Fragen, die die Autoren klassifiziert haben, betreffen 66 % (5.897) numerisches Schlussfolgern, also die Art von Berechnung, die Finanzteams täglich durchführen (FinanceBench paper).
- Die Leitlinien der US-Bankenaufsicht zum Modellrisiko (SR 26-2, im April 2026 als Ersatz für SR 11-7 veröffentlicht) betrachten die „wirksame Hinterfragung“ (Effective Challenge) durch objektive Experten als Teil eines soliden Modellrisikomanagements und beschreiben die Ergebnisanalyse, einschließlich Backtesting, als Weg, Modellergebnisse mit realen Resultaten zu vergleichen (Federal Reserve SR 26-2).
- Im Jahr 2025 erstattete Deloitte über A$97.000 für einen australischen Regierungsbericht zurück, der ursprünglich mit rund A$440.000 bewertet war, nachdem sich herausgestellt hatte, dass er ein erfundenes Zitat und Verweise auf nicht existierende Forschung enthielt (CFO Dive).
Warum KI sich bei Zahlen irrt
Generative KI sagt plausiblen Text voraus. Sie rechnet nicht wie eine Tabellenkalkulation, und sie „kennt“ Ihr Hauptbuch nicht, solange Sie ihr die Daten nicht geben. Daraus ergeben sich einige Fehlermuster, die Finanzteams immer wieder sehen. Zum Begriff selbst siehe KI-Halluzination.
- Erfundene Inhalte. Eine Zahl, ein Zitat oder ein Konto, das nicht existiert, mit voller Überzeugung vorgetragen.
- Richtige Zahl, falscher Kontext. Ein korrekter Wert aus der falschen Periode, der falschen Einheit, Währung oder Größenordnung (Tausender statt Millionen).
- Fehlerhafte Arithmetik oder Logik. Schritte, die schlüssig wirken, aber nicht aufgehen.
- Stilles Auslassen. Eine Zeile fehlt in einer Zusammenfassung oder Abstimmung, und nichts weist auf die Lücke hin.
- Drift. Verhalten, das sich nach einem Anbieter-Update, einer Prompt-Änderung oder einer neuen Datenquelle verändert.
Die FinanceBench-Autoren beschreiben das Muster treffend. Die Modelle lieferten oft „oberflächlich kohärente und scheinbar gut begründete Antworten, teils mit umfangreichen Berechnungen und Argumentationsschritten, die dennoch falsch waren“ (FinanceBench paper). Das ist die gefährliche Art von Fehler: Er besteht den flüchtigen Blick. Retrieval kann helfen, denn die Verankerung des Modells in Ihren Dokumenten ist die Idee hinter Retrieval-Augmented Generation. Das Benchmark-Ergebnis zeigt jedoch, dass Retrieval allein das Ergebnis nicht buchungssicher macht.
Dokumentierte Fälle: Was ungeprüfte Ergebnisse kosten
Keiner dieser Fälle stammt aus dem Abschlussprozess eines Finanzteams, aber jeder ist ein öffentlicher Beleg dafür, was passiert, wenn KI-Ergebnisse ohne echte Prüfung nach außen gehen.
Ein Beratungsbericht mit erfundenen Quellen. Ein Bericht über A$440.000 für das australische Department of Employment and Workplace Relations enthielt ein erfundenes Zitat aus einem Bundesgerichtsurteil und Verweise auf nicht existierende wissenschaftliche Arbeiten. Deloitte erstattete über A$97.000 zurück, weniger als ein Viertel des Honorars, und das Ministerium erklärte, der Kern der Untersuchung sei erhalten geblieben (CFO Dive). Die Lehre für das Finanzwesen: Ein professionelles Arbeitsergebnis kann KI-Erfindungen in die Hände eines Kunden tragen, und die Kosten sind eine Rückerstattung plus der Reputationsschaden.
Erfundene Zitate in einem Gerichtsschriftsatz. In Mata v. Avianca verhängte ein Bundesgericht in New York Sanktionen gegen Anwälte, die einen Schriftsatz mit von ChatGPT erzeugten, nicht existierenden Urteilen eingereicht hatten. Der Beschluss vom 22. Juni 2023 verhängte gesamtschuldnerisch eine Strafe von 5.000 $ gegen die Kanzlei und die Anwälte und stellte Bösgläubigkeit fest, begründet mit bewusstem Wegsehen und irreführenden Aussagen. Das Gericht erklärte außerdem, der Einsatz eines zuverlässigen KI-Tools sei nicht per se unzulässig, Anwälte müssten aber als Torwächter für die Richtigkeit fungieren (Reed Smith). Dieselbe Logik gilt für jeden, der einen Schriftsatz, eine Abstimmung oder einen Managementbericht unterzeichnet.
Ein Chatbot, der Richtlinien falsch wiedergab. In Moffatt v. Air Canada (2024 BCCRT 149) machte ein Tribunal in British Columbia die Fluggesellschaft für falsche Auskünfte zu Trauerfall-Tarifen verantwortlich, die ihr eigener Chatbot erteilt hatte und die einer anderen Seite ihrer Website widersprachen. Das Tribunal schrieb, es „sollte Air Canada offensichtlich sein, dass sie für alle Informationen auf ihrer Website verantwortlich ist“ (McCarthy Tetrault). Wenn ein Chatbot der Finanzabteilung einem Mitarbeiter die falsche Erstattungsgrenze oder einem Lieferanten den falschen Zahlungstermin nennt, müssen Sie damit rechnen, für die Auskunft geradezustehen.
Ein Benchmark zur eigentlichen Arbeit. FinanceBench liegt dem Finanzwesen am nächsten: Fragen aus den Einreichungen börsennotierter Unternehmen, wobei die Autoren 2.400 Modellantworten manuell prüften (arXiv). Er testet Fragenbeantwortung, nicht ein bestimmtes Produkt, das Sie kaufen könnten, und die Modelle haben sich seither weiterentwickelt. Er zeigt aber, dass die Fehlerquoten bei realistischen Finanzfragen nicht klein waren.
Die fünf Ebenen der Genauigkeitskontrolle
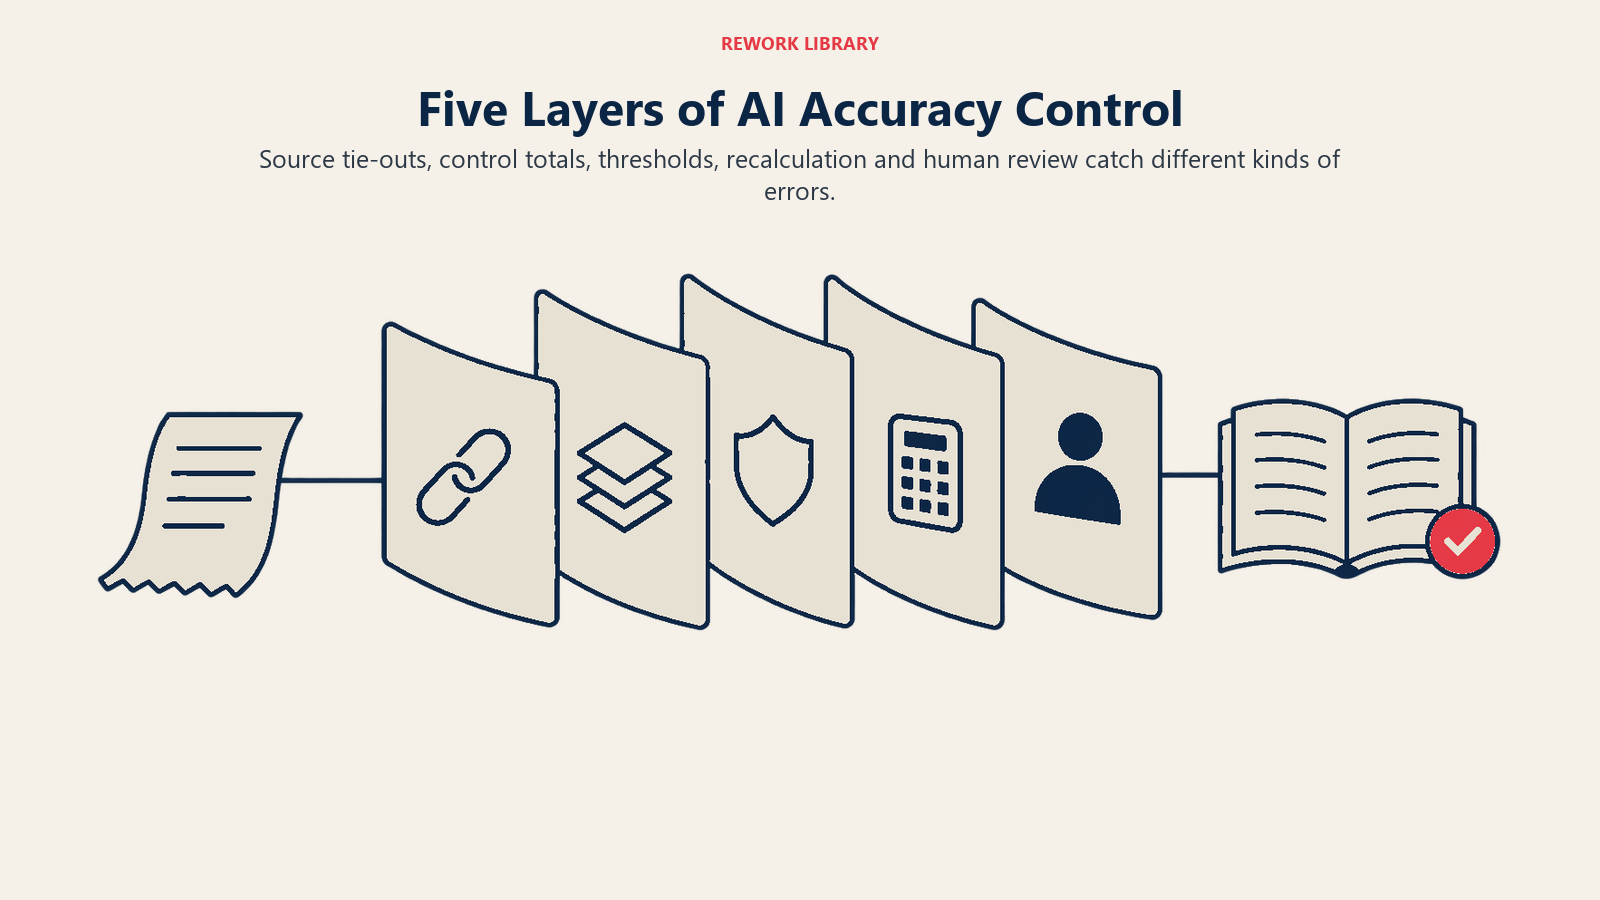
Gute Kontrollen sind gestaffelt. Keine einzelne Prüfung fängt jeden Fehlertyp ab, also legen Sie mehrere Ebenen zwischen Modell und Hauptbuch.
1. Tie-out zur Quelle
Jede Zahl, die die KI liefert, wird auf ein Quelldokument oder einen Systemeintrag zurückgeführt: die Rechnung, den Kontoauszug, den Vertrag, den Hauptbuchsaldo. Bei Extraktionstools bedeutet das, eine Stichprobe gegen das Originaldokument erneut durchzuführen. Bei Zusammenfassungen und Kommentaren klickt der Prüfer von jeder genannten Zahl zum zugrunde liegenden Bericht durch. Kann das Tool für eine Zahl seine Quelle nicht nennen, wird die Zahl nicht übernommen.
2. Abstimmung und Kontrollsummen
Summen fangen ab, was zeilenweise Prüfungen übersehen, besonders stilles Auslassen. Vergleichen Sie Anzahl und Summe der eingehenden Datensätze mit den ausgehenden. Prüfen Sie, ob die extrahierten Rechnungszeilen die Rechnungssumme ergeben, ob abgeglichene Bankposten plus offene Posten den Kontoauszugssaldo ergeben und ob die Nebenbücher mit dem Hauptbuch übereinstimmen. Eine Kontrollsumme ist günstig aufzubauen und fängt ganze Fehlerkategorien ab. In KI-gestützte Bankabstimmung lesen Sie, wie Abgleichstools offenlegen, was sie nicht zuordnen konnten.
3. Schwellenwerte und Toleranzen
Legen Sie explizite Regeln fest, wann ein Ergebnis automatisch akzeptiert, geprüft oder abgelehnt wird. Typische Auslöser sind:
- Betrag über einem festgelegten Wert
- Konfidenzwert unter einer festgelegten Stufe
- Neuer Lieferant, neues Konto oder erstmaliges Muster
- Abweichung gegenüber Vorperiode oder Budget über einem festgelegten Prozentsatz
- Abweichende Währung, Gesellschaft oder Periode gegenüber dem Datensatz
Wählen Sie die Schwellenwerte anhand Ihrer eigenen Fehlerdaten, nicht anhand der Voreinstellung des Anbieters, und überprüfen Sie sie vierteljährlich. Zu locker, und Fehler passieren; zu streng, und die Prüfer ertrinken und klicken nur noch auf „Freigeben“.
4. Unabhängige Nachberechnung
Berechnen Sie alles Numerische außerhalb des Modells neu. Nutzen Sie eine Tabellenkalkulation, eine Datenbankabfrage oder eine Regel-Engine, um den von der KI genannten Wert zu berechnen, und vergleichen Sie. Das ist die richtige Antwort auf den Fehler der fehlerhaften Arithmetik: Das Sprachmodell entwirft und erklärt, deterministische Software rechnet. Abweichungserklärungen sind ein gutes Beispiel. Der Text kann von der KI entworfen werden, aber jede darin genannte Zahl sollte per Abfrage gezogen werden, wie in KI-gestützte Abweichungsanalyse beschrieben.
5. Menschliche Prüfung mit definiertem Umfang
„Eine Person prüft es“ ist erst dann eine Kontrolle, wenn Sie festlegen, was sie ansieht, was eine Eskalation auslöst und wo sie das Ergebnis dokumentiert. Die Bankenaufsicht formuliert es in SR 26-2 so: Wirksame Hinterfragung ist kritische Analyse durch objektive Experten, durchgeführt von Personen mit der passenden Expertise, genügend Unabhängigkeit, um objektiv zu bleiben, und dem Standing und Einfluss, um Änderungen durchzusetzen (Federal Reserve SR 26-2). Diese Leitlinie wurde für die Modelle von Banken geschrieben, doch der Maßstab lässt sich übertragen: Ihr Prüfer braucht die Fachkenntnis, eine falsche Zahl zu erkennen, die Unabhängigkeit, es auszusprechen, und die Befugnis, die Buchung zu stoppen.
Welche Kontrolle welchen Fehler abfängt
| Fehlertyp | Beispiel | Passende Kontrolle |
|---|---|---|
| Erfundene Inhalte | Ein genanntes Konto, ein Lieferant oder ein Standard, den es nicht gibt | Tie-out zur Quelle; Abgleich mit den Stammdaten |
| Falsche Größenordnung oder Währung | Tausender als Millionen gelesen; EUR wie USD behandelt | Toleranzprüfung gegen Vorperiode; Validierung von Einheit und Währung |
| Rechenfehler | Zwischensummen, die nicht aufgehen | Unabhängige Nachberechnung; Kontrollsummen |
| Falsche Periode oder Gesellschaft | Q2-Wert in einer Q3-Zusammenfassung | Abgleich von Periode und Gesellschaft mit dem Datensatz |
| Stilles Auslassen | Eine Zeile fehlt in einer Abstimmung | Datensatzanzahl und Kontrollsummen, Eingang gegen Ausgang |
| Plausibler, aber unbelegter Kommentar | Eine Abweichungserklärung ohne Grundlage | Prüfer verfolgt jede Aussage bis ins Hauptbuch |
| Drift im Zeitverlauf | Nachlassende Genauigkeit nach einem Anbieter-Update | Ergebnisanalyse; Überwachung der Override-Quote; Änderungskontrolle |
Kontrollintensität am Risiko ausrichten
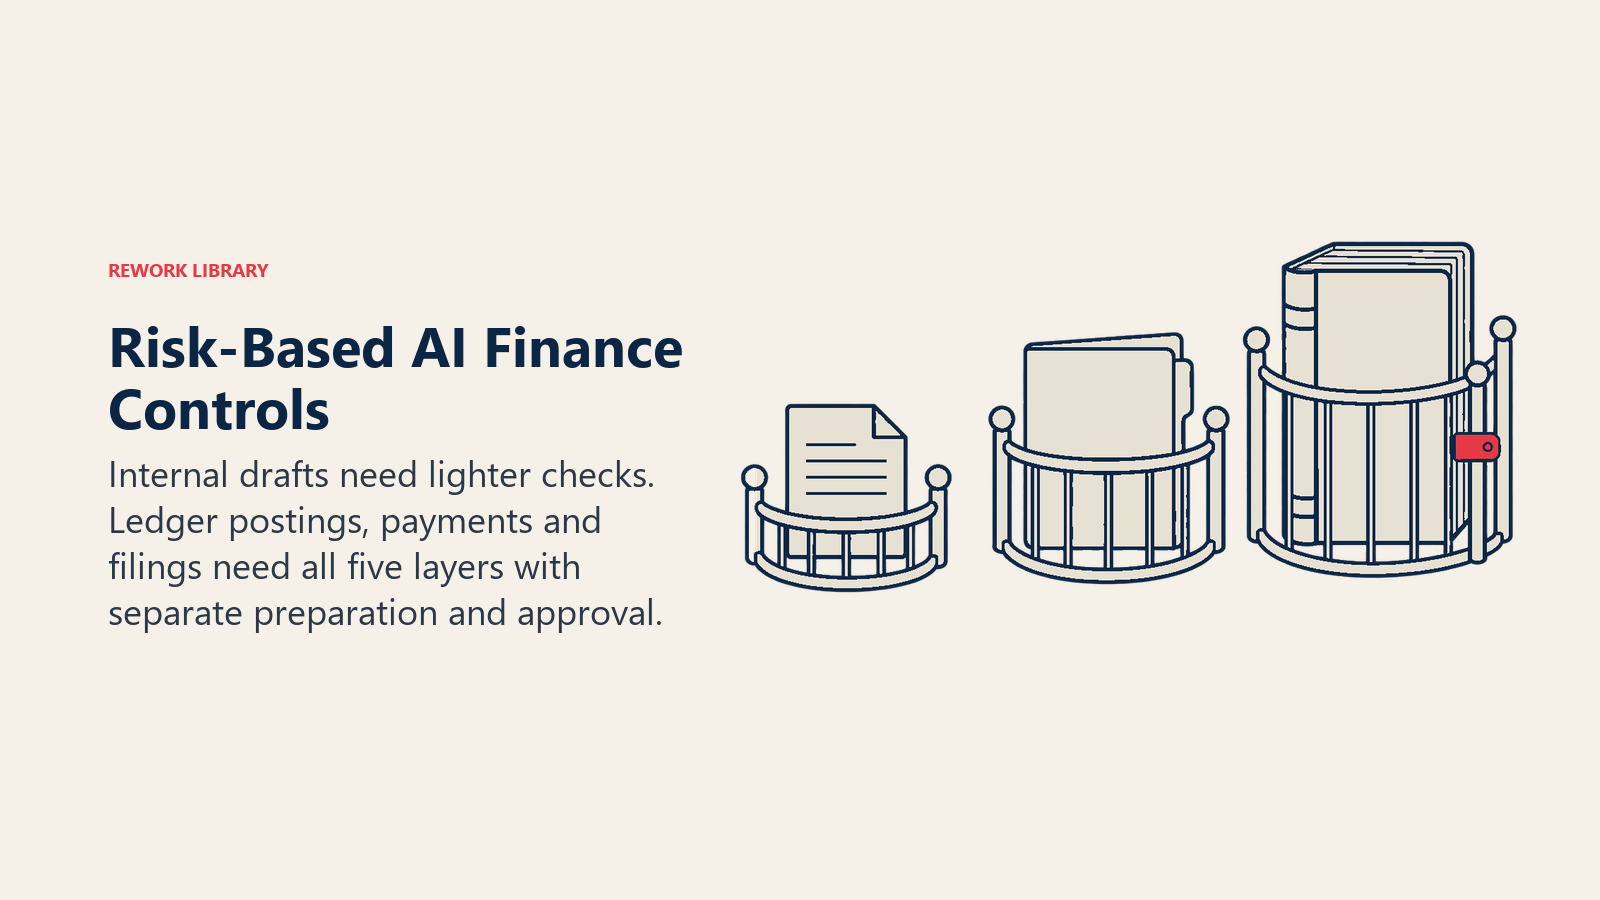
Nicht jeder KI-Einsatz verdient denselben Aufwand. Ein Tool, das eine interne Besprechungszusammenfassung entwirft, braucht weniger Kontrolle als eines, das Abgrenzungen oder Steuerpositionen vorschlägt. Stufen Sie danach ab, worauf das Ergebnis Einfluss hat.
| Stufe | Wohin das Ergebnis fließt | Mindestkontrollen |
|---|---|---|
| Niedrig | Interne Entwürfe, Brainstorming, Recherchenotizen | Stichprobe; keine direkte Buchung |
| Mittel | Management-Reporting, Prognosen, Kommentare | Tie-out zur Quelle, unabhängige Nachberechnung, benannter Prüfer |
| Hoch | Hauptbuchbuchungen, Zahlungen, Meldungen, Schätzungen | Alle fünf Ebenen, Trennung von Ersteller und Freigeber, protokollierte Nachweise, Ergebnistests |
Bei der hohen Stufe halten Sie die KI vollständig aus den Freigaberechten heraus. Ein Tool, das einen Buchungssatz vorbereitet, sollte ihn nicht auch freigeben. Zahlungen und andere betrugsanfällige Abläufe verdienen die zusätzliche Sorgfalt, die in KI in der Kreditorenbuchhaltung beschrieben ist.
So führen Sie Genauigkeitskontrollen Schritt für Schritt ein
- Erfassen Sie, wo KI Zahlen berührt. Beziehen Sie Tools ein, die einzelne Teammitglieder selbst eingeführt haben, und KI-Funktionen in Systemen, die Sie bereits besitzen. SR 26-2 beschreibt ein umfassendes Modellinventar als gängige Praxis bei Banken, und die Gewohnheit ist übernehmenswert (Federal Reserve SR 26-2).
- Stufen Sie jeden Einsatz ein, danach, wohin er fließt, anhand der Tabelle oben.
- Definieren Sie für jeden Einsatz den „bekannt guten“ Wert. Welche Quelle ist die Wahrheit? Bei der Rechnungserfassung ist es das Dokument, bei der Abstimmung der Kontoauszug, bei einer Prognose die Ist-Werte, sobald sie vorliegen.
- Bauen Sie vor dem Go-live einen Testdatensatz auf. Sammeln Sie einige hundert reale, anonymisierte Fälle, auch unschöne: gescannte Seiten, ungewöhnliche Währungen, Teilzahlungen. Bewerten Sie das Tool anhand bekannter Antworten.
- Fahren Sie parallel. Lassen Sie den alten Prozess einige Zyklen weiterlaufen, vergleichen Sie Zeile für Zeile und halten Sie die Unterschiede und ihre Ursachen fest.
- Fügen Sie die Ebenen hinzu. Binden Sie Tie-outs, Kontrollsummen, Schwellenwerte und Nachberechnung nach Möglichkeit als automatisierte Prüfungen ein und schreiben Sie den Schritt der menschlichen Prüfung samt Prüfumfang auf.
- Protokollieren Sie alles, was ein Prüfer brauchen würde. Eingaben, Ergebnisse, Tool- oder Prompt-Version, Prüfer, was geprüft und was überstimmt wurde.
- Überwachen Sie die Ergebnisse. SR 26-2 beschreibt die Ergebnisanalyse als Vergleich von Modellergebnissen mit realen Resultaten, wodurch wesentliche Fehler oder anhaltende Abweichungen sichtbar werden können (Federal Reserve SR 26-2). Verfolgen Sie Fehlerquote und Override-Quote je Tool und Monat; eine steigende Override-Quote ist ein frühes Zeichen, dass das Tool gedriftet ist.
- Kontrollieren Sie Änderungen. Behandeln Sie Modell-Upgrades, Prompt-Änderungen und neue Datenquellen als Änderungen, die einen erneuten Test auslösen.
- Legen Sie eine Stoppregel fest. Bestimmen Sie im Voraus, ab welcher Fehlerquote das Tool pausiert wird und wer die Befugnis dazu hat.
Das Generative AI Profile des NIST (NIST AI 600-1), veröffentlicht am 26. Juli 2024, ist eine freiwillige Ergänzung zum AI Risk Management Framework und eine brauchbare Checklistenquelle, wenn Ihr Risikoteam eine anerkannte Referenz wünscht (NIST).
Beispiele nach Finanzfunktion
- Kreditorenbuchhaltung. Die Rechnungserfassung liest eine Summe als 1.250,00, obwohl auf der Rechnung 12.500,00 steht. Eine Tie-out-Stichprobe und eine Prüfung der Zeilensumme fangen das ab; ein Zahlungsschwellenwert löst eine Prüfung aus, bevor das Geld fließt.
- Monatsabschluss. Eine entworfene Abgrenzung nennt den Satz des letzten Quartals. Ein Vorperiodenvergleich zeigt einen Sprung an, und der Prüfer erkennt die veraltete Eingabe.
- FP&A. Ein generierter Kommentar sagt, der Umsatz sei um 12 % gestiegen, das Hauptbuch zeigt 9 %. Eine Regel, dass jede genannte Zahl aus einer Abfrage stammt und nicht aus dem Text des Modells, schließt das aus.
- Treasury und Cashflow-Prognose. Eine Prognose driftet, weil sich das Zahlungsverhalten ändert. Ein wöchentliches Backtesting gegen den tatsächlichen Cash deckt es auf.
- Steuern und Umsatz. Ein Modell fasst einen Standard zusammen und lässt eine Bedingung aus. Die fachliche Prüfung durch eine qualifizierte Person anhand des Standardtexts ist die Kontrolle; Geschwindigkeit ist hier nicht das Ziel.
Häufige Fallstricke
- Die Zusammenfassung prüfen statt der Quelle. Ein Prüfer, der nur das Ergebnis der KI liest, kann eine erfundene Zahl nicht erkennen.
- Konfidenzwerten vertrauen. Ein hoher Wert heißt, das Modell ist sich sicher, nicht, dass es recht hat. Kalibrieren Sie anhand Ihrer eigenen Ergebnisse.
- Automation Bias. Nach einigen fehlerfreien Wochen beginnen Prüfer zu überfliegen. Wechseln Sie die Stichproben und messen Sie, wie oft Prüfer tatsächlich überstimmen.
- Einmaliges Testen. Ein Pilotprojekt, das im März bestand, sagt wenig über das Verhalten nach einem Modell-Update im September aus.
- KI prüft KI. Ein zweites Modell kann bei der Vorsortierung helfen, aber eine Person oder eine deterministische Regel muss das Ergebnis verantworten.
- Schwellenwerte, die niemand angepasst hat. Voreinstellungen passen selten zu Ihren Volumina und Ihrem Risiko. Legen Sie sie anhand Ihrer eigenen Fehlerhistorie fest.
- Keine Stoppregel. Wenn niemand ein fehlerhaftes Tool pausieren darf, bucht das Tool weiter.
- Schwache Daten darunter. Unsaubere Stammdaten und uneinheitliche Kontenrahmen erschweren jede Kontrolle. Datenbereitschaft im Finanzwesen behandelt die Grundlagen.
Was Sie messen sollten
- Fehlerquote gegenüber Quelle oder Ist-Werten, je Tool und Anwendungsfall
- Erkennungsquote: Anteil der Fehler, die Kontrollen finden, gegenüber denen, die erst nach der Buchung auffallen
- Override-Quote und die Gründe, die Prüfer nennen
- Prüfzeit pro Vorgang, um Drüberwinken oder Überlastung zu erkennen
- Durchrutscher: Fehler, die das Hauptbuch oder einen Bericht erreicht haben, und wie sie durchgekommen sind
- Testabdeckung: Anteil der KI-Einsätze mit aktuellem Testdatensatz und benanntem Verantwortlichen
Wie es weitergeht
Wählen Sie den einen KI-Einsatz in Ihrem Team, der die wichtigste Zahl speist, und legen Sie in diesem Monat drei Prüfungen darum: eine Tie-out-Stichprobe, eine Kontrollsumme und einen schriftlich festgelegten Prüfschritt. Ergänzen Sie dann die Ergebnisverfolgung, damit Sie die tatsächliche Fehlerquote erfahren statt die des Anbieters. Für das größere Governance-Bild überlegen Sie, wer jede Kontrolle verantwortet, wenn sich die Arbeit zwischen Menschen und Tools verschiebt.
Häufig gestellte Fragen zu Genauigkeitskontrollen für KI im Finanzwesen
Was ist die wichtigste Genauigkeitskontrolle für KI im Finanzwesen?
Das Tie-out zur Quelle, denn es prüft, worauf es ankommt: Stimmt die Zahl mit dem Dokument oder Hauptbucheintrag überein, aus dem sie angeblich stammt? Kombinieren Sie es mit Kontrollsummen, die Auslassungen abfangen, die zeilenweise Prüfungen übersehen.
Kann Retrieval aus unseren eigenen Dokumenten verhindern, dass KI Fehler macht?
Es verringert sie, beseitigt sie aber nicht. In der FinanceBench-Studie beantwortete GPT-4-Turbo mit einem Retrieval-System 81 % der Fragen in der Stichprobe der Autoren falsch oder verweigerte die Antwort, daher braucht auch verankerte Ausgabe Kontrollen.
Wie oft sollten Menschen KI-Ergebnisse im Finanzwesen prüfen?
Das hängt von der Stufe ab. Ergebnisse, die ins Hauptbuch gebucht werden, Geld bewegen oder in eine Meldung einfließen, sollten jedes Mal von einer benannten Person geprüft werden. Entwürfe mit geringerem Risiko können stichprobenartig geprüft werden, wobei die Stichprobenquote steigt, sobald Fehlerdaten oder ein Modellwechsel dies nahelegen.
Reicht es, wenn ein zweites KI-Modell das erste prüft?
Nicht allein. Ein zweites Modell kann Vorgänge für die Prüfung vorsortieren, aber beide können auf ähnliche Weise falsch liegen. Eine deterministische Nachberechnung oder eine Person mit der Befugnis, das Ergebnis zu hinterfragen, sollte das Ergebnis verantworten.
Gibt es reale Beispiele dafür, dass KI-Fehler Folgen hatten?
Ja. Ein Bundesgericht sanktionierte Anwälte wegen von ChatGPT erzeugter falscher Urteilszitate, ein Tribunal machte Air Canada für die falsche Tarifauskunft seines Chatbots verantwortlich, und Deloitte erstattete einen Teil eines Regierungshonorars zurück, nachdem ein Bericht erfundene Quellenverweise enthielt.
Gelten diese Kontrollen auch für kleine Finanzteams?
Ja, in schlankerer Form. Ein kleines Team kann monatlich eine Tie-out-Stichprobe ziehen, Kontrollsummen in einer Tabelle führen und verlangen, dass eine zweite Person alles freigibt, was gebucht wird. Das Prinzip bleibt gleich: Lassen Sie nie eine ungeprüfte KI-Zahl in die Bücher gelangen.
Head of Finance Strategy
On this page
- Wichtige Fakten
- Warum KI sich bei Zahlen irrt
- Dokumentierte Fälle: Was ungeprüfte Ergebnisse kosten
- Die fünf Ebenen der Genauigkeitskontrolle
- 1. Tie-out zur Quelle
- 2. Abstimmung und Kontrollsummen
- 3. Schwellenwerte und Toleranzen
- 4. Unabhängige Nachberechnung
- 5. Menschliche Prüfung mit definiertem Umfang
- Welche Kontrolle welchen Fehler abfängt
- Kontrollintensität am Risiko ausrichten
- So führen Sie Genauigkeitskontrollen Schritt für Schritt ein
- Beispiele nach Finanzfunktion
- Häufige Fallstricke
- Was Sie messen sollten
- Wie es weitergeht