Bahasa Indonesia
Kepercayaan dan Evaluasi sebagai Aset Penjualan untuk Produk AI
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Bukti kepercayaan dan evaluasi adalah kumpulan dokumen dan hasil yang memungkinkan pembeli memeriksa klaim sebuah produk AI tanpa harus begitu saja percaya pada vendor. Isinya mencakup metodologi evaluasi yang dipublikasikan, tingkat kesalahan pada tugas yang representatif, model card atau system card, trust center, audit dan sertifikasi pihak ketiga, hasil red-team, serta kebijakan yang jelas untuk mengungkap insiden. Bagi produk AI, ini bukan berkas administrasi di balik layar. Ini adalah aset penjualan, karena semuanya menjawab pertanyaan tersulit pembeli sebelum ada yang menjadwalkan panggilan.
Alasannya bersifat struktural. Pembeli tidak bisa menilai kualitas produk AI hanya dari antarmukanya, dan setiap vendor di kategori ini mengaku "akurat" dan "aman". Bukti adalah satu-satunya hal yang membedakan klaim dari fakta. Halaman ini membahas jenis-jenis bukti kepercayaan, siapa di sisi pembeli yang membaca bukti yang mana, dan cara menyajikan evaluasi secara jujur. Pembahasan ini melanjutkan menjual AI kepada pembeli yang skeptis, yang menguraikan keraguan pembeli menjadi keberatan-keberatan spesifik, dan mengapa demo lebih penting untuk produk AI, yang membahas cara membuktikan kualitas secara langsung. Di sini fokusnya adalah bukti yang ada sebelum dan sesudah demo.
Mengapa Bukti Mempersingkat Kesepakatan AI
Sebagian besar kesepakatan AI tidak tersendat di produknya. Kesepakatan tersendat pada pertanyaan yang tidak bisa dijawab penjual dengan cepat: seberapa sering produk ini salah, siapa yang sudah mengauditnya, apa yang terjadi pada data kami, apa yang Anda lakukan ketika produk gagal. Setiap pertanyaan yang tak terjawab menjadi putaran bolak-balik antara champion, vendor, dan tim keamanan atau hukum di pihak pembeli. Putaran inilah yang membuat kesepakatan berjalan lambat.
Bukti bekerja dengan tiga cara.
Bukti menjawab pertanyaan secara asinkron. Analis keamanan di pihak pembeli bisa membaca halaman kepercayaan pukul 23.00 dan tiba di panggilan pertama dengan hal-hal dasar yang sudah beres. Panggilan itu lalu dipakai untuk membahas kecocokan, bukan untuk membuktikan bahwa vendor adalah perusahaan sungguhan.
Bukti memberi champion Anda sesuatu untuk diteruskan. Champion yang percaya pada produk tetap harus meyakinkan rekan kerja yang tidak hadir di demo. Ringkasan evaluasi atau laporan audit yang jelas bisa beredar tanpa perlu disertai tenaga penjual. Lihat komite pembelian AI untuk mengetahui siapa saja rekan kerja tersebut.
Tidak satu pun dari ini menjamin kesepakatan yang lebih cepat, dan halaman ini tidak mengutip angka tentang seberapa besar bukti mempersingkat siklus penjualan, jadi anggaplah manfaat kecepatan sebagai mekanisme untuk diuji di pipeline Anda sendiri, bukan angka untuk dikutip.
Jenis-Jenis Bukti Kepercayaan
Bukti kepercayaan terbagi menjadi enam kelompok. Keenamnya berbeda dalam hal apa yang dibuktikan, seberapa sulit dibuat, dan seberapa besar pembeli yang skeptis akan mendiskon nilainya.
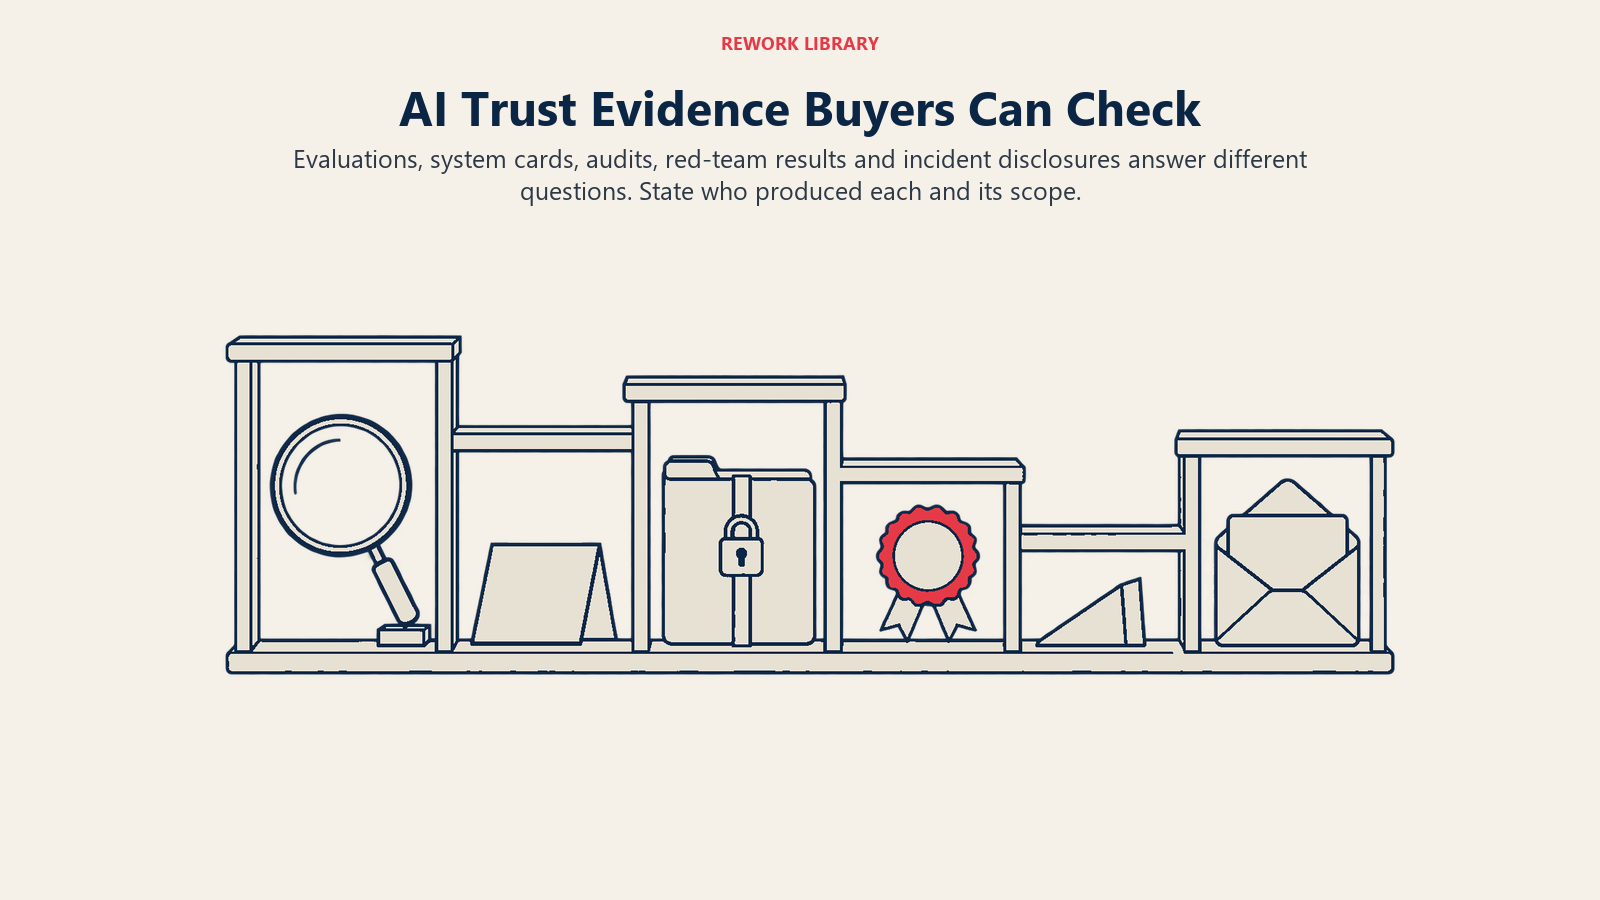
| Jenis bukti | Yang ditunjukkan | Siapa yang membuatnya | Seberapa besar pembeli mendiskonnya |
|---|---|---|---|
| Hasil dan metodologi evaluasi | Seberapa baik produk bekerja pada tugas yang dinyatakan dan bagaimana hal itu diukur | Vendor, kadang bersama evaluator luar | Lebih rendah bila set uji dan metodenya ditunjukkan, lebih tinggi bila hanya angka utama yang muncul |
| Model card atau system card | Untuk apa model atau produk ini, bagaimana pengujiannya, batasan yang diketahui | Vendor | Sedang, karena dilaporkan sendiri, tetapi menandakan kematangan |
| Trust center | Dokumen keamanan, privasi, sub-pemroses, dan kebijakan di satu tempat | Vendor | Rendah untuk dokumennya sendiri, meski halaman tanpa substansi mudah dikenali |
| Audit atau sertifikasi pihak ketiga | Pihak independen memeriksa cakupan yang terdefinisi | Auditor eksternal atau badan sertifikasi | Terendah, selama cakupannya dinyatakan |
| Hasil red-team atau uji adversarial | Bagaimana sistem berperilaku saat diserang atau disalahgunakan | Penguji internal atau eksternal | Bergantung pada independensi penguji dan apa yang diungkapkan |
| Pengungkapan insiden | Cara vendor berkomunikasi ketika terjadi masalah | Vendor | Sulit dipalsukan, karena memperlihatkan perilaku di bawah tekanan |
Pola yang perlu diperhatikan: independensi meningkatkan kredibilitas. Angka yang sama pada set uji yang disediakan pembeli, atau yang diperiksa pihak ketiga, mengalahkan angka yang dihitung vendor pada set miliknya sendiri.
Metodologi Evaluasi dan Pelaporan Tingkat Kesalahan
Inti dari bukti kepercayaan AI adalah tingkat kesalahan terukur pada tugas yang representatif. NIST AI Risk Management Framework spesifik tentang apa yang membuat angka seperti itu bermakna. Dalam uraiannya tentang karakteristik "valid dan andal", NIST AI RMF 1.0 menyatakan bahwa pengukuran akurasi harus selalu dipasangkan dengan set uji yang didefinisikan dengan jelas dan realistis, yang mewakili kondisi penggunaan yang diharapkan, beserta rincian metodologi pengujian, dan bahwa semua itu harus disertakan dalam dokumentasi terkait. Kerangka ini juga menyebutkan bahwa ukuran akurasi harus mempertimbangkan tingkat false positive dan false negative, dan dapat mencakup pemisahan hasil untuk segmen data yang berbeda.
Hal itu dapat diringkas menjadi daftar periksa singkat untuk setiap klaim akurasi yang Anda publikasikan atau kirim kepada pembeli:
- Tugas apa? "Mengekstrak total faktur dari PDF hasil pindai" dapat diperiksa. "Memahami dokumen" tidak.
- Set uji apa? Berapa banyak contoh, dari mana asalnya, dan apakah jenis input milik pembeli termasuk di dalamnya.
- Bagaimana "benar" didefinisikan? Siapa yang menilai, berdasarkan kriteria tertulis apa, dan seberapa sering penilai berbeda pendapat.
- Jenis kesalahan apa? Jawaban salah, jawaban yang tidak ada, dan penolakan membawa biaya yang berbeda. Laporkan secara terpisah bila itu penting.
- Kapan dijalankan? Model dan prompt berubah, sehingga evaluasi tanpa tanggal memiliki masa berlaku yang tidak diketahui.
Kerangka ini juga mencatat bahwa validitas dan keandalan sistem yang sudah diterapkan sering dinilai melalui pengujian atau pemantauan berkelanjutan, bukan satu kali uji sebelum peluncuran. Pembeli yang pernah dirugikan sebelumnya cenderung bertanya apakah angkanya masih terkini. Evaluasi bertanggal yang dijalankan ulang secara terjadwal menjawab pertanyaan itu.
Model Card dan System Card
Model card adalah dokumen singkat yang menyertai sebuah model dan menyatakan untuk apa model itu dibuat, bagaimana model dievaluasi, dan di mana model sebaiknya tidak dipakai. Formatnya berasal dari Mitchell dkk., "Model Cards for Model Reporting", yang mengusulkan agar model dirilis bersama dokumentasi yang mencakup konteks penggunaan yang dimaksud, prosedur evaluasi, dan kinerja yang diukur pada berbagai kondisi seperti kelompok demografis atau budaya, termasuk pemisahan interseksional. Tujuan yang dinyatakan adalah membantu praktisi menilai apakah suatu model cocok untuk suatu penggunaan dan mencegah penerapan dalam konteks yang tidak sesuai.
Startup yang membangun di atas model pihak ketiga biasanya tidak melatih model yang mereka jual, sehingga model card dalam arti harfiah mungkin tidak berlaku. Gagasannya tetap relevan. "System card" atau kartu tingkat produk menjelaskan seluruh produk: model atau model-model di baliknya, lapisan retrieval dan guardrail, tugas yang dituju, kinerja yang dievaluasi, keterbatasan yang diketahui, dan langkah peninjauan oleh manusia. Itu lebih dekat dengan apa yang sebenarnya dibeli pembeli, dan merupakan satu halaman yang wajar untuk ditautkan dari trust center Anda.
Benchmark Publik dan Batasannya
Benchmark publik memberi pembeli acuan bersama, dan benchmark telah membentuk pemahaman tentang seperti apa "evaluasi yang baik". Holistic Evaluation of Language Models (HELM) dari Stanford adalah contoh yang berguna dari pendekatan ini. HELM mengevaluasi 30 model bahasa pada 42 skenario dengan tujuh metrik: akurasi, kalibrasi, ketahanan, keadilan, bias, toksisitas, dan efisiensi. Poinnya adalah bahwa melihat akurasi saja menyembunyikan pertukaran (trade-off), dan bahwa model sebelumnya hanya diuji pada sebagian kecil skenario yang sama, sehingga perbandingan sulit dilakukan.
Dua pelajaran terbawa ke dunia penjualan.
Pertama, laporkan lebih dari satu angka. Pembeli yang mengevaluasi agen dukungan peduli pada akurasi, tetapi juga pada apakah agen tahu kapan ia tidak yakin, bagaimana perilakunya pada input yang tidak biasa, serta seberapa cepat dan mahal ia berjalan. Ringkasan multi-metrik lebih kredibel daripada satu skor utama.
Kedua, benchmark publik mengukur model umum, bukan produk Anda pada faktur atau tiket milik pembeli Anda, jadi padukan dengan hasil tingkat tugas.
Audit dan Sertifikasi Pihak Ketiga
Verifikasi independen memiliki bobot terbesar bagi pembeli, karena vendor tidak menilai pekerjaannya sendiri. Untuk AI, standar yang paling menarik perhatian adalah ISO/IEC 42001. Menurut daftar di IEC webstore, standar ini terbit pada 18 Desember 2023, dan menetapkan persyaratan serta memberikan panduan untuk membangun, menerapkan, memelihara, dan terus meningkatkan sistem manajemen AI, bagi organisasi mana pun yang menyediakan atau menggunakan produk atau layanan berbasis AI.
Bersikaplah tepat tentang apa arti sertifikasi semacam itu dan apa yang bukan artinya. Standar sistem manajemen berkaitan dengan cara organisasi mengatur pekerjaan AI-nya: proses, peran, penanganan risiko, dan siklus perbaikan. Ini bukan uji apakah suatu model akurat atau adil. Mengatakan "tersertifikasi ISO 42001" memberi tahu pembeli bahwa proses tata kelola Anda dinilai secara independen. Itu tidak memberi tahu mereka tingkat kesalahan produk Anda. Sebutkan apa yang dicakup sertifikat, nama badan sertifikasinya, dan cakupannya, lalu padukan dengan hasil evaluasi tingkat produk.
Riwayat penegakan hukum yang dibahas dalam menjual AI kepada pembeli yang skeptis mengingatkan bahwa klaim yang dilebih-lebihkan membawa risiko hukum, bukan hanya risiko komersial.
Hasil Red-Team dan Pengungkapan Insiden
Red teaming berarti menyerang atau menyalahgunakan sistem dengan sengaja untuk menemukan kegagalan sebelum pengguna sungguhan menemukannya. Mempublikasikan ringkasan tentang apa yang diuji, apa yang ditemukan, dan apa yang diperbaiki menunjukkan kepada pembeli bahwa mode kegagalan memang dicari. Untuk produk agen yang mengambil tindakan, hal ini lebih penting, dan red teaming AI agent membahas cara pengujiannya sendiri bekerja.
Pengungkapan insiden adalah artefak yang paling tidak glamor dan paling mengungkap. Fungsi MANAGE dalam kerangka NIST mencakup satu subkategori (MANAGE 4.3) yang menyatakan bahwa insiden dan kesalahan dikomunikasikan kepada para pelaku AI yang relevan, termasuk komunitas terdampak, dan bahwa proses untuk melacak, menanggapi, dan memulihkannya dijalankan serta didokumentasikan. Pembeli yang membaca kebijakan Anda sedang menanyakan satu hal: ketika ini rusak pada kami, apakah kami akan mendengarnya dari Anda lebih dulu, dan seberapa cepat?
Kebijakan insiden yang layak pakai menyatakan apa yang dihitung sebagai insiden, bagaimana pelanggan diberi tahu dan dalam jangka waktu berapa, apa isi laporan pasca-insiden, dan siapa pemiliknya. Mempublikasikan insiden masa lalu disertai laporan yang jujur sering kali membangun lebih banyak kepercayaan daripada rekam jejak bersih yang tidak bisa diverifikasi siapa pun.
Siapa di Sisi Pembeli yang Membaca Apa
Anggota komite pembelian yang berbeda mengonsumsi artefak yang berbeda, sehingga satu "halaman kepercayaan" hanya berhasil jika disusun untuk beberapa jenis pembaca.
| Peran pembeli | Yang mereka cari | Artefak yang mereka baca |
|---|---|---|
| Economic buyer atau sponsor bisnis | Apakah risikonya dapat diterima dan dapat dipertanggungjawabkan bila dipertanyakan? | Ringkasan evaluasi, referensi pelanggan, sertifikasi yang disebutkan dalam bahasa sederhana |
| Champion atau manajer pengguna akhir | Apakah ini akan bekerja pada tugas kami dan tidak mempermalukan saya? | Hasil tingkat tugas, contoh kegagalan, desain peninjauan oleh manusia |
| Keamanan dan IT | Ke mana data pergi, siapa yang dapat mengaksesnya, apa permukaan seranganya? | Trust center, dokumentasi keamanan, cakupan audit, ringkasan red-team |
| Hukum dan privasi | Paparan kontrak, penggunaan data, kesesuaian regulasi | Ketentuan penanganan data, daftar sub-pemroses, kebijakan insiden, cakupan sertifikasi |
| Risiko atau kepatuhan | Apakah ini sesuai dengan kerangka tata kelola AI kami? | System card, pemetaan ke kerangka seperti NIST AI RMF, laporan audit |
| Evaluator teknis | Apakah metodenya sahih dan dapat direproduksi? | Metodologi evaluasi, deskripsi set uji, hasil bertanggal |
Uji yang berguna: pilih satu peran pembeli dan tanyakan apakah mereka bisa menemukan jawabannya dalam waktu kurang dari sepuluh menit tanpa menghubungi Anda. Bila jawabannya tidak, kesepakatan akan melambat. Ujung proses di sisi kontrak dibahas di dari pilot AI ke kontrak.
Menyajikan Evaluasi dengan Jujur
Risiko dari bukti kepercayaan adalah berubah menjadi pemasaran. Pembeli yang merasakan kemasan lebih banyak daripada isi akan mendiskon semuanya. Beberapa praktik menjaga kredibilitasnya.
Dahulukan cakupan, baru hasil. Nyatakan apa yang diuji sebelum menyebut skornya. Angka tanpa cakupan hanyalah klaim.
Tunjukkan titik lemahnya. Letakkan keterbatasan di samping hasil, bukan terkubur di catatan kaki. "Akurasi turun pada formulir tulisan tangan, dan formulir itu diarahkan ke peninjau" adalah keterbatasan yang disertai kontrol. Pembeli yang membacanya tahu bahwa Anda memahami produk Anda.
Pisahkan yang terukur dari yang diklaim. Jaga perbedaan yang jelas antara "kami sudah menguji ini" dan "kami memperkirakan ini". Pembeli memaklumi sikap hati-hati. Mereka tidak memaklumi prakiraan yang disajikan sebagai hasil.
Logika transparansi yang sama muncul di tingkat industri. Edisi 2025 Foundation Model Transparency Index dari Stanford melaporkan bahwa rata-rata skor transparansi di antara pengembang foundation model turun dari 58 pada 2024 menjadi 40 pada 2025, dengan perusahaan paling tertutup soal data pelatihan, komputasi pelatihan, serta penggunaan dan dampak pascapenerapan. Satu pengembang mendapat skor 95 dan yang terendah 14. Skor itu menggambarkan pengembang model, bukan vendor aplikasi, tetapi memperlihatkan celah di pasar: ketika banyak pemasok mengungkap sedikit, vendor yang mengungkap banyak akan menonjol.
Kebiasaan Pemeliharaan, Bukan Proyek Sekali Jadi
Aset kepercayaan menurun nilainya. Laporan tahun lalu menggambarkan produk tahun lalu. Cara praktis menjaganya tetap berguna adalah memperlakukannya seperti produk yang punya pemilik.
- Tetapkan pemilik. Seseorang, sering kali pimpinan keamanan atau produk, bertanggung jawab menjaga trust center tetap mutakhir.
- Kaitkan pembaruan dengan rilis. Perubahan material pada model, prompt, atau alur data memicu evaluasi ulang dan pembaruan kartu.
- Pensiunkan yang tak bisa dipelihara. Halaman usang lebih buruk daripada halaman pendek yang mutakhir, dan setiap pertanyaan pembeli yang tak terjawab adalah celah yang perlu diisi.
Bukti juga membantu argumen komersial. Pembeli yang menyusun justifikasi internal membutuhkan angka yang dapat dipertanggungjawabkan, yang menjadi topik business case ROI produk AI, dan kinerja terukur adalah persis yang menjadi tumpuan harga berbasis hasil, seperti dibahas di harga berbasis penggunaan vs berbasis hasil untuk AI. Untuk pembahasan lebih dalam tentang pengukuran sistem otonom secara khusus, lihat cara mengevaluasi AI agent.
Fakta Utama
- Akurasi membutuhkan set uji: NIST AI RMF 1.0 menyatakan pengukuran akurasi harus dipasangkan dengan set uji yang didefinisikan jelas dan realistis, yang mewakili penggunaan yang diharapkan, ditambah metodologi pengujian yang terdokumentasi.
- Insiden harus dikomunikasikan: MANAGE 4.3 dalam kerangka yang sama menyerukan agar insiden dan kesalahan dikomunikasikan kepada para pelaku AI yang relevan dan agar proses penanganannya didokumentasikan.
- Model card memiliki bentuk yang terdefinisi: Mitchell dkk. mengusulkan dokumentasi yang mencakup penggunaan yang dimaksud, prosedur evaluasi, dan kinerja pada berbagai kondisi serta kelompok.
- Satu metrik menyembunyikan pertukaran: HELM mengevaluasi 30 model pada 42 skenario dengan tujuh metrik, dari akurasi hingga efisiensi.
- ISO/IEC 42001 menyangkut tata kelola: terbit 18 Desember 2023, standar ini menetapkan persyaratan untuk sistem manajemen AI, menurut IEC webstore. Ini bukan uji akurasi sebuah model.
- Transparansi industri rendah: Foundation Model Transparency Index 2025 menemukan skor rata-rata turun dari 58 menjadi 40, sehingga pengungkapan dapat menjadi pembeda vendor.
Bacaan Terkait
- Pertanyaan privasi data yang diajukan pembeli AI
- Penjelasan tinjauan keamanan AI
- Apa itu kebijakan AI yang bertanggung jawab?
- Menjual AI kepada pembeli yang skeptis
- Mengapa demo lebih penting untuk produk AI
- Komite pembelian AI
- Dari pilot AI ke kontrak
- Cara mengevaluasi AI agent
- Red teaming AI agent

Co-Founder & COO
On this page
- Mengapa Bukti Mempersingkat Kesepakatan AI
- Jenis-Jenis Bukti Kepercayaan
- Metodologi Evaluasi dan Pelaporan Tingkat Kesalahan
- Model Card dan System Card
- Benchmark Publik dan Batasannya
- Audit dan Sertifikasi Pihak Ketiga
- Hasil Red-Team dan Pengungkapan Insiden
- Siapa di Sisi Pembeli yang Membaca Apa
- Menyajikan Evaluasi dengan Jujur
- Kebiasaan Pemeliharaan, Bukan Proyek Sekali Jadi
- Fakta Utama
- Bacaan Terkait