Confiança e avaliação como ativo de vendas para produtos de IA
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Evidências de confiança e avaliação são o conjunto de documentos e resultados que permitem ao comprador verificar as afirmações de um produto de IA sem aceitar a palavra do fornecedor. Isso inclui metodologia de avaliação publicada, taxas de erro em tarefas representativas, model cards ou system cards, um trust center, auditorias e certificações de terceiros, resultados de red team e uma política clara de divulgação de incidentes. Em um produto de IA, isso não é papelada de bastidores. É um ativo de vendas, porque responde às perguntas mais difíceis do comprador antes que alguém agende uma conversa.
O motivo é estrutural. O comprador não consegue ver a qualidade de um produto de IA olhando para a interface, e todo fornecedor da categoria diz "preciso" e "seguro". A evidência é a única coisa que separa uma declaração de um fato. Esta página aborda os tipos de evidência de confiança, quem do lado do comprador lê o quê e como apresentar a avaliação com honestidade. Ela complementa vender IA para compradores céticos, que divide a dúvida do comprador em objeções específicas, e por que as demos importam mais para produtos de IA, que trata de provar a qualidade ao vivo. Aqui o foco é a evidência que existe antes e depois da demo.
Por que a evidência encurta os negócios de IA
A maioria dos negócios de IA não trava no produto. Trava em perguntas que o vendedor não consegue responder rápido: com que frequência ele erra, quem o auditou, o que acontece com os nossos dados, o que vocês fazem quando ele falha. Cada pergunta sem resposta vira um vaivém entre o champion, o fornecedor e a equipe de segurança ou jurídica do comprador. São esses vaivéns que tornam os negócios lentos.
A evidência funciona de três maneiras.
Ela responde às perguntas de forma assíncrona. O analista de segurança do comprador pode ler uma página de confiança às 23h e chegar à primeira conversa com o básico resolvido. A conversa passa então a tratar de adequação, não de provar que o fornecedor é uma empresa de verdade.
Ela dá ao seu champion algo para encaminhar. Um champion que acredita no produto ainda precisa convencer colegas que não estiveram na demo. Um resumo de avaliação ou um relatório de auditoria claro circula sem precisar do vendedor junto. Veja o comitê de compra de IA para saber quem são esses colegas.
Nada disso garante um negócio mais rápido, e esta página não cita um número para o quanto a evidência encurta um ciclo de vendas. Portanto, trate o ganho de velocidade como um mecanismo a ser testado no seu próprio pipeline, não como um número para citar.
Os tipos de evidência de confiança
A evidência de confiança se divide em seis grupos. Eles diferem no que provam, na dificuldade de produzi-los e no desconto que um comprador cético aplica a cada um.
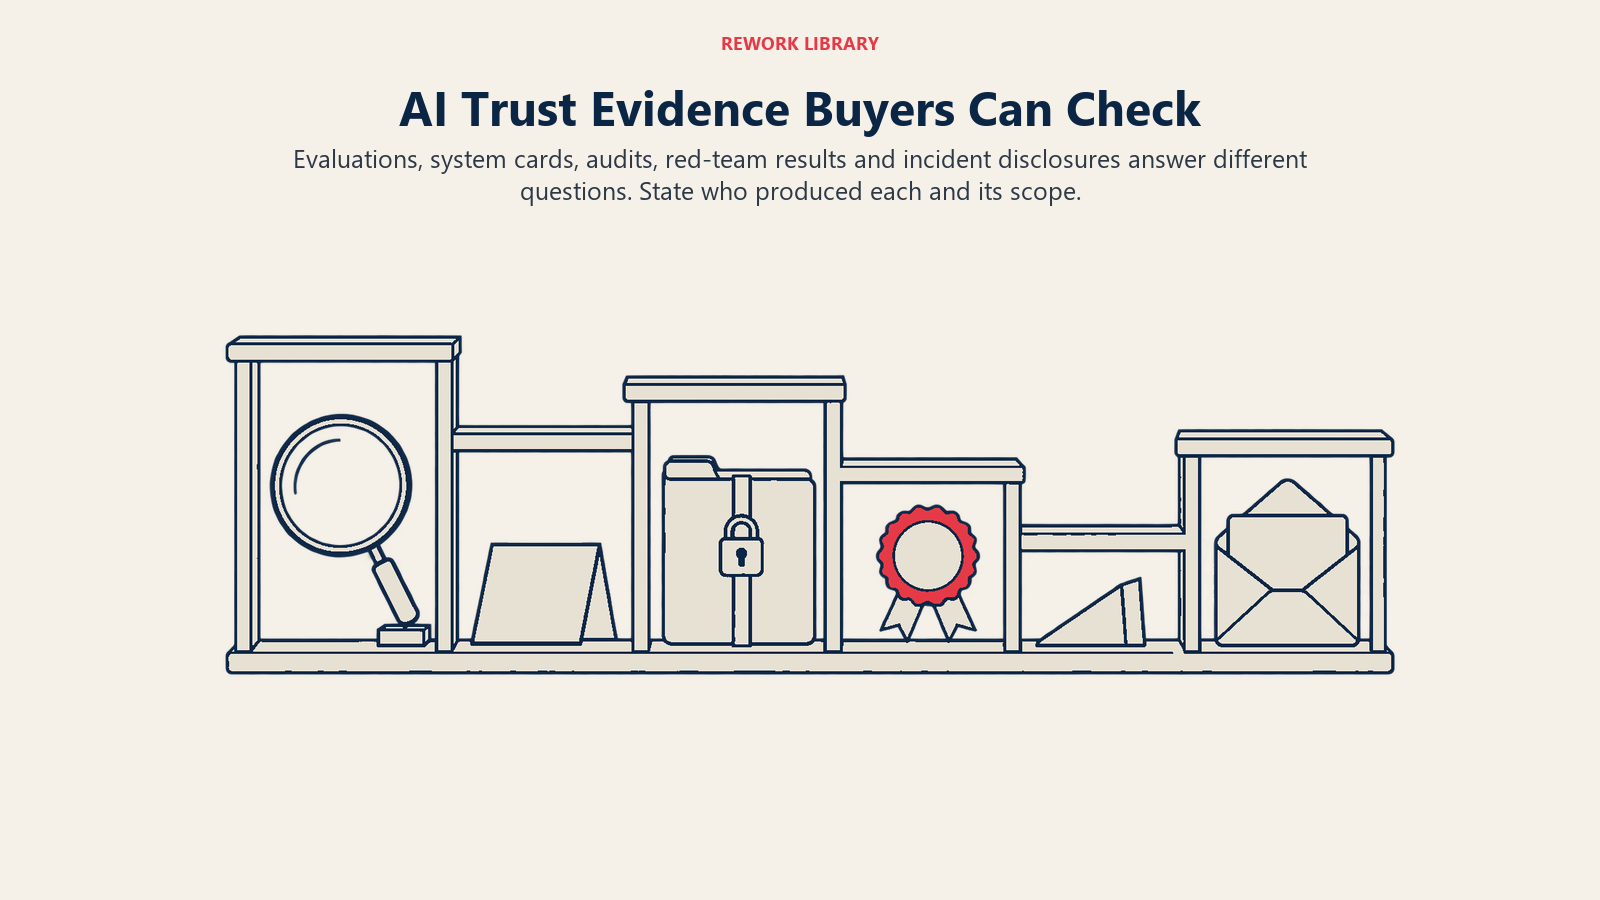
| Tipo de evidência | O que mostra | Quem produz | Quanto os compradores descontam |
|---|---|---|---|
| Resultados e metodologia de avaliação | Qual o desempenho do produto em tarefas declaradas e como isso foi medido | O fornecedor, às vezes com um avaliador externo | Menos quando o conjunto de teste e o método são mostrados, mais quando só aparece um número de destaque |
| Model card ou system card | Para que serve o modelo ou produto, como foi testado, limites conhecidos | O fornecedor | Moderado, por ser autodeclarado, mas sinaliza maturidade |
| Trust center | Documentos de segurança, privacidade, suboperadores e políticas em um só lugar | O fornecedor | Baixo para os documentos em si, embora uma página sem substância por trás seja fácil de perceber |
| Auditoria ou certificação de terceiros | Uma parte independente verificou um escopo definido | Um auditor externo ou organismo certificador | O mais baixo, desde que o escopo seja declarado |
| Resultados de red team ou testes adversariais | Como o sistema se comportou sob ataque ou uso indevido | Testadores internos ou externos | Depende da independência dos testadores e do que é divulgado |
| Divulgação de incidentes | Como o fornecedor se comunica quando algo dá errado | O fornecedor | Difícil de forjar, porque mostra o comportamento sob pressão |
O padrão a observar: independência aumenta a credibilidade. O mesmo número, em um conjunto de teste fornecido pelo comprador ou conferido por um terceiro, vale mais do que o calculado pelo fornecedor no seu próprio conjunto.
Metodologia de avaliação e relatório de taxa de erro
O núcleo da evidência de confiança em IA é uma taxa de erro medida em uma tarefa representativa. O NIST AI Risk Management Framework é específico sobre o que torna um número assim significativo. Na descrição da característica "válido e confiável", o NIST AI RMF 1.0 afirma que as medições de acurácia devem sempre vir acompanhadas de conjuntos de teste claramente definidos e realistas, representativos das condições de uso esperadas, junto com detalhes da metodologia de teste, e que isso deve constar da documentação associada. Também diz que as medidas de acurácia devem considerar as taxas de falsos positivos e falsos negativos e podem incluir a desagregação dos resultados por diferentes segmentos de dados.
Isso se traduz em uma lista de verificação curta para qualquer afirmação de acurácia que você publique ou envie a um comprador:
- Que tarefa? "Extrai totais de faturas de PDFs digitalizados" é verificável. "Entende documentos" não é.
- Que conjunto de teste? Quantos exemplos, de onde vieram e se o tipo de entrada do comprador está incluído.
- Como "correto" foi definido? Quem avaliou, com base em quais critérios escritos e com que frequência os avaliadores discordaram.
- Que tipos de erro? Uma resposta errada, uma resposta ausente e uma recusa têm custos diferentes. Relate-os separadamente quando isso importar.
- Quando foi executado? Modelos e prompts mudam, então uma avaliação sem data tem validade desconhecida.
O framework também observa que a validade e a confiabilidade de sistemas em produção costumam ser avaliadas por testes ou monitoramento contínuos, não por um único teste anterior ao lançamento. Compradores que já se queimaram tendem a perguntar se o número é atual. Uma avaliação datada e reexecutada periodicamente responde a isso.
Model cards e system cards
Um model card é um documento curto que acompanha um modelo e informa para que ele serve, como foi avaliado e onde não deve ser usado. O formato vem de Mitchell et al., "Model Cards for Model Reporting", que propôs que os modelos sejam entregues com documentação cobrindo o contexto de uso pretendido, os procedimentos de avaliação e o desempenho medido em diferentes condições, como grupos demográficos ou culturais, incluindo recortes interseccionais. O objetivo declarado era ajudar profissionais a julgar se um modelo é adequado a um uso e desencorajar sua implantação em contextos inadequados.
Startups que constroem sobre modelos de terceiros normalmente não treinam o modelo que vendem, então um model card literal pode não se aplicar. A ideia continua valendo. Um "system card", ou card no nível do produto, descreve o produto inteiro: o modelo ou os modelos por trás dele, as camadas de recuperação e de guardrails, as tarefas pretendidas, o desempenho avaliado, as limitações conhecidas e a etapa de revisão humana. Isso se aproxima mais do que o comprador de fato está adquirindo, e é uma página natural para linkar a partir do seu trust center.
Benchmarks públicos e seus limites
Os benchmarks públicos dão aos compradores uma referência comum e moldaram o que se entende por "boa avaliação". O Holistic Evaluation of Language Models (HELM), de Stanford, é um bom exemplo dessa abordagem. Ele avaliou 30 modelos de linguagem em 42 cenários usando sete métricas: acurácia, calibração, robustez, equidade, viés, toxicidade e eficiência. Seu argumento era que olhar apenas para a acurácia esconde trade-offs, e que os modelos haviam sido testados antes em uma pequena fração dos mesmos cenários, o que dificultava a comparação.
Duas lições se aplicam às vendas.
Primeiro, relate mais de um número. O comprador que avalia um agente de suporte se importa com a acurácia, mas também com saber se ele percebe quando está em dúvida, como se comporta diante de entradas incomuns e qual é sua velocidade e seu custo. Um resumo com várias métricas é mais crível do que uma única nota de destaque.
Segundo, um benchmark público mede um modelo geral, não o seu produto sobre as faturas ou os tickets do seu comprador, então combine-o com resultados no nível da tarefa.
Auditorias e certificações de terceiros
A verificação independente é a que mais pesa para os compradores, porque o fornecedor não está avaliando o próprio trabalho. Para IA, o padrão que mais atraiu atenção é a ISO/IEC 42001. Segundo a página da loja da IEC, ela foi publicada em 18 de dezembro de 2023 e especifica requisitos e fornece orientações para estabelecer, implementar, manter e melhorar continuamente um sistema de gestão de IA, para qualquer organização que forneça ou use produtos ou serviços baseados em IA.
Seja preciso sobre o que esse tipo de certificação significa e o que não significa. Uma norma de sistema de gestão trata de como uma organização governa seu trabalho com IA: seus processos, papéis, tratamento de riscos e ciclo de melhoria. Não é um teste de se um determinado modelo é preciso ou justo. Dizer "certificado na ISO 42001" informa ao comprador que o seu processo de governança foi avaliado de forma independente. Não informa a taxa de erro do seu produto. Diga o que o certificado cobre, nomeie o organismo certificador e o escopo, e combine-o com resultados de avaliação no nível do produto.
O histórico de fiscalização abordado em vender IA para compradores céticos é um lembrete de que afirmações exageradas trazem risco jurídico além do risco comercial.
Resultados de red team e divulgação de incidentes
Red teaming significa atacar ou usar um sistema de forma indevida de propósito para encontrar falhas antes dos usuários reais. Publicar um resumo do que foi testado, do que foi encontrado e do que foi corrigido mostra ao comprador que os modos de falha foram procurados. Para produtos de agentes que executam ações, isso importa ainda mais, e red teaming de agentes de IA explica como o teste em si funciona.
A divulgação de incidentes é o artefato menos glamouroso e mais revelador. A função MANAGE do framework do NIST inclui uma subcategoria (MANAGE 4.3) que afirma que incidentes e erros são comunicados aos atores de IA relevantes, incluindo as comunidades afetadas, e que os processos para rastreá-los, respondê-los e se recuperar deles são seguidos e documentados. O comprador que lê a sua política está fazendo uma só pergunta: quando isso quebrar para nós, vamos saber por você primeiro, e com que rapidez?
Uma política de incidentes viável define o que conta como incidente, como os clientes são notificados e em que prazo, o que o relatório pós-incidente contém e quem é o responsável. Publicar um incidente passado com um relato honesto costuma gerar mais confiança do que um histórico limpo que ninguém consegue verificar.
Quem do lado do comprador lê o quê
Diferentes membros do comitê de compra consomem artefatos diferentes, então uma única "página de confiança" só funciona se for organizada para vários leitores.
| Papel do comprador | O que procura | Artefatos que lê |
|---|---|---|
| Economic buyer ou patrocinador do negócio | O risco é aceitável e defensável se for questionado? | Resumo de avaliação, referências de clientes, certificações descritas em linguagem simples |
| Champion ou gerente do usuário final | Vai funcionar nas nossas tarefas sem me deixar em situação constrangedora? | Resultados no nível da tarefa, exemplos de falha, o desenho da revisão humana |
| Segurança e TI | Para onde vão os dados, quem pode acessá-los, qual é a superfície de ataque? | Trust center, documentação de segurança, escopo da auditoria, resumo de red team |
| Jurídico e privacidade | Exposição contratual, uso de dados, adequação regulatória | Termos de tratamento de dados, lista de suboperadores, política de incidentes, escopo da certificação |
| Risco ou compliance | Isso se encaixa no nosso framework de governança de IA? | System card, mapeamento para um framework como o NIST AI RMF, relatórios de auditoria |
| Avaliadores técnicos | O método é sólido e reproduzível? | Metodologia de avaliação, descrição do conjunto de teste, resultados datados |
Um teste útil: escolha um papel de comprador e pergunte se ele conseguiria encontrar suas respostas em menos de dez minutos sem falar com você. Onde a resposta for não, o negócio vai desacelerar. O fim do processo, no contrato, está em dos pilotos de IA aos contratos.
Como apresentar a avaliação com honestidade
O risco da evidência de confiança é virar marketing. O comprador que percebe mais verniz do que substância desconta tudo. Algumas práticas mantêm a credibilidade.
Comece pelo escopo, depois os resultados. Diga o que foi testado antes de dizer a nota. Um número sem escopo é uma declaração.
Mostre os pontos fracos. Coloque as limitações ao lado dos resultados, não enterradas em uma nota de rodapé. "A acurácia cai em formulários manuscritos, e esses vão para um revisor" é um limite com um controle. O comprador que lê isso aprende que você conhece o seu produto.
Separe o que é medido do que é declarado. Mantenha uma distinção clara entre "testamos isto" e "esperamos isto". Os compradores perdoam a cautela. Não perdoam uma previsão apresentada como resultado.
A mesma lógica de transparência aparece no nível do setor. A edição de 2025 do Foundation Model Transparency Index, de Stanford, relatou que as pontuações médias de transparência entre os desenvolvedores de modelos de fundação caíram de 58 em 2024 para 40 em 2025, com as empresas mais opacas em dados de treinamento, capacidade de computação de treinamento e uso e impacto após a implantação. Um desenvolvedor teve 95 e o mais baixo, 14. Essas pontuações descrevem desenvolvedores de modelos, não fornecedores de aplicações, mas mostram uma lacuna no mercado: quando muitos fornecedores divulgam pouco, o que divulga muito se destaca.
Um hábito de manutenção, não um projeto pontual
Os ativos de confiança envelhecem. Um relatório do ano passado descreve o produto do ano passado. A forma prática de mantê-los úteis é tratá-los como um produto com dono.
- Atribua um responsável. Alguém, em geral um líder de segurança ou de produto, é responsável por manter o trust center atualizado.
- Vincule as atualizações aos lançamentos. Uma mudança relevante de modelo, prompt ou fluxo de dados dispara uma nova execução da avaliação e a atualização do card.
- Aposente o que você não consegue manter. Uma página desatualizada é pior do que uma curta e atual, e cada pergunta de comprador sem resposta é uma lacuna a preencher.
A evidência também ajuda no argumento comercial. Compradores que montam uma justificativa interna precisam de números defensáveis, tema do business case de ROI de produtos de IA, e o desempenho medido é exatamente aquilo de que depende a precificação vinculada a resultados, como visto em precificação baseada em uso vs. baseada em resultados para IA. Para um tratamento mais aprofundado sobre medir sistemas autônomos especificamente, veja como avaliar agentes de IA.
Fatos principais
- A acurácia precisa de um conjunto de teste: o NIST AI RMF 1.0 afirma que as medições de acurácia devem vir acompanhadas de conjuntos de teste claramente definidos e realistas, representativos do uso esperado, além de metodologia de teste documentada.
- Incidentes devem ser comunicados: a subcategoria MANAGE 4.3 do mesmo framework prevê que incidentes e erros sejam comunicados aos atores de IA relevantes e que os processos de resposta sejam documentados.
- Model cards têm um formato definido: Mitchell et al. propuseram documentação cobrindo uso pretendido, procedimentos de avaliação e desempenho em diferentes condições e grupos.
- Uma só métrica esconde trade-offs: o HELM avaliou 30 modelos em 42 cenários com sete métricas, da acurácia à eficiência.
- A ISO/IEC 42001 trata de governança: publicada em 18 de dezembro de 2023, especifica requisitos para um sistema de gestão de IA, segundo a loja da IEC. Não é um teste da acurácia de um modelo.
- A transparência do setor é baixa: o Foundation Model Transparency Index de 2025 constatou que a pontuação média caiu de 58 para 40, então a divulgação pode diferenciar um fornecedor.
Leitura relacionada
- Perguntas de privacidade de dados que os compradores de IA fazem
- Revisões de segurança de IA explicadas
- O que é uma política de IA responsável?
- Vender IA para compradores céticos
- Por que as demos importam mais para produtos de IA
- O comitê de compra de IA
- Dos pilotos de IA aos contratos
- Como avaliar agentes de IA
- Red teaming de agentes de IA

Co-Founder & COO
On this page
- Por que a evidência encurta os negócios de IA
- Os tipos de evidência de confiança
- Metodologia de avaliação e relatório de taxa de erro
- Model cards e system cards
- Benchmarks públicos e seus limites
- Auditorias e certificações de terceiros
- Resultados de red team e divulgação de incidentes
- Quem do lado do comprador lê o quê
- Como apresentar a avaliação com honestidade
- Um hábito de manutenção, não um projeto pontual
- Fatos principais
- Leitura relacionada