データエンジニア職務記述書テンプレート - 2026年版ガイド
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
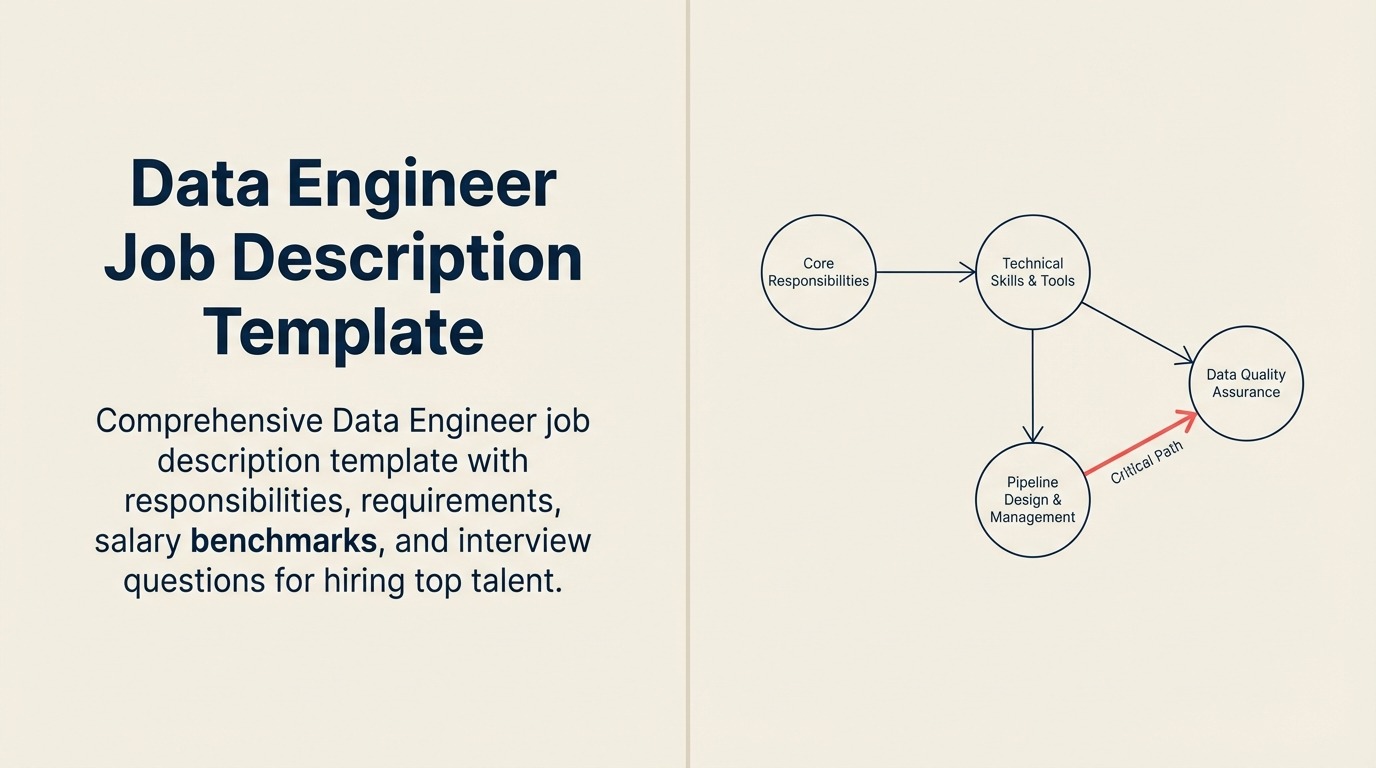
AIデータエンジニアの職務記述書は、機械学習やAIシステムを大規模に支えるデータパイプライン、フィーチャーストア、インフラを構築・維持する職務を定義するものです。SQL、Python、Spark、クラウドプラットフォーム、ETL/ELTといったデータエンジニアリングの中核スキルに加えて、モデルの本番運用、フィーチャーパイプラインの管理、学習・推論のためのデータ品質確保といったAI特有の職責も組み合わせています。以下のテンプレートを使えば、データ基盤とそれが今支えているAIワークロードの両方に対応する人材を採用できます。
このガイドで得られること
- すぐに使える完全な職務記述書テンプレート
- データパイプラインアーキテクチャとETL開発をカバーする主な職責
- 必須の資格要件と技術スキル要件
- 経験と勤務地別の給与レンジを含む報酬ガイド
- 大企業、スタートアップ、リモート環境それぞれのバリエーション
- 業界別の考慮事項とコンプライアンス要件
- 技術面と行動面を評価するための15以上の的を絞った面接質問
- ソーシング戦略や避けるべき警戒すべき兆候を含む採用のヒント
データエンジニアは、組織が大規模にデータを収集、保存、処理、分析できるようにするインフラを構築・維持します。堅牢なデータパイプラインを設計し、ETLプロセスを実装し、分析チームやビジネスステークホルダーのためにデータの品質とアクセス性を確保します。
主なハイライト
- 平均給与レンジ:米国内で年間$95,000〜$170,000
- 主な焦点:データパイプラインアーキテクチャ、ETL開発、インフラ管理
- 成長軌道:2032年までに35%の雇用成長が見込まれる高需要職種
- 技術スタック:SQL、Python、Spark、Kafka、AWS/Azure/GCPクラウドプラットフォーム
- 影響領域:組織全体でのデータドリブンな意思決定を可能にする
- リモート勤務の柔軟性:ポジションの70%がリモートまたはハイブリッド勤務に対応
この職務が重要な理由
データエンジニアは、現代のデータドリブンな組織の背骨として機能し、アナリストやデータサイエンティスト、経営層が生データから意味のある知見を引き出せるようにする基盤を作ります。企業が競争優位のためにデータへの依存を強めるなか、データエンジニアは品質、セキュリティ、パフォーマンスの基準を維持しながら、さまざまなソースからエンドユーザーへ情報が効率的に流れるようにします。
この職務はソフトウェアエンジニアリングの原則とデータシステムへの深い理解を組み合わせるものであり、分析能力を拡大し高度なAI/ML施策を実行しようとする組織にとって不可欠な存在です。
基本の職務記述書テンプレート
職務概要
当社では、拡大するデータチームに加わり、データインフラの開発を推進していただけるスキルの高いデータエンジニアを募集しています。データサイエンティスト、アナリスト、プロダクトチームと密接に連携しながら、当社の分析エコシステムを支えるスケーラブルなデータパイプラインを設計・構築・維持し、高品質なデータへの信頼できるアクセスを確保していただきます。
この職務では、多様なデータソースを扱うソリューションを設計し、堅牢なETLプロセスを実装し、パフォーマンスとコスト効率のためにデータワークフローを最適化していただきます。セキュリティとガバナンスの基準への準拠を確保しながら、当社のデータプラットフォーム戦略に貢献していただきます。
このポジションはシニアデータエンジニアリングマネージャーの直属となり、分析、プロダクト、エンジニアリングを含む部門横断チームと幅広く連携しながら、ビジネスに影響を与えるデータソリューションを提供します。
主な職責
- 最新のETL/ELTフレームワークとクラウド技術を用いて、スケーラブルなデータパイプラインを設計・実装する
- データウェアハウスのスキーマ、データレイク、リアルタイムストリーミングアーキテクチャを開発・維持する
- 自動化されたデータ品質モニタリングシステムを構築し、データ検証フレームワークを実装する
- クラウドプラットフォーム全体でデータベースのパフォーマンス、クエリ効率、ストレージコストを最適化する
- データサイエンティストやMLOpsエンジニアと連携し、機械学習モデルとフィーチャーストアを本番運用化する
- データガバナンスポリシー、セキュリティ管理、コンプライアンスモニタリングシステムを実装する
- データシステムとプロセスに関する包括的なドキュメントを作成・維持する
- データパイプラインの障害を監視・トラブルシューティングし、ダウンタイムとデータ損失を最小限に抑える
- チームの生産性を高めるため、新しいデータ技術やツールを評価・導入する
- ジュニアエンジニアを指導し、技術アーキテクチャの意思決定に貢献する
要件
必須資格:
- コンピュータサイエンス、データエンジニアリング、または関連する技術分野の学士号
- データエンジニアリング、ソフトウェア開発、または関連職種での3年以上の実務経験
- SQLへの高い習熟度と、少なくとも1つのプログラミング言語(Python、Scala、Javaのいずれか)
- クラウドプラットフォーム(AWS、Azure、GCPのいずれか)とそのデータサービスに関する経験
- データパイプラインのオーケストレーションツール(Airflow、Luigiなど)を用いた実務経験
- データウェアハウジングの概念、ディメンショナルモデリング、データレイクアーキテクチャに関する知識
- 分散コンピューティングフレームワーク(Spark、Hadoopなど)に関する経験
- バージョン管理システム、CI/CDの実践、ソフトウェア開発ライフサイクルに関する理解
歓迎する資格:
- データエンジニアリング、コンピュータサイエンス、または定量分野の修士号
- リアルタイムストリーミング技術(Kafka、Kinesis、Pub/Sub)に関する経験
- コンテナ化およびオーケストレーション技術(Docker、Kubernetes)に関する知識
- Infrastructure as Codeツール(Terraform、CloudFormation)に関する知見
- データ可視化ツールおよびビジネスインテリジェンスプラットフォームに関する経験
AIおよびMLに特化したスキル(AIデータエンジニア職の場合):
データエンジニアリングの業務がAIシステムを支える場面が増えるにつれ、採用担当者はデータパイプラインと機械学習をつなぐスキルをますます重視するようになっています。このテーブルを使って、掲載するAI関連要件の水準を調整してください。
| スキル領域 | 確認すべきポイント | AIワークロードにとって重要な理由 |
|---|---|---|
| フィーチャーエンジニアリングとフィーチャーストア | フィーチャーパイプライン(Feast、Tecton、または内製)の経験 | モデルには学習・推論のために一貫性のある低レイテンシーなフィーチャーが必要 |
| モデルの本番運用化 | MLOpsエンジニアと連携してモデルをデプロイ・モニタリングした経験 | データサイエンスのノートブックと信頼性の高い本番システムの橋渡しをする |
| ベクトルデータとエンベディングデータ | ベクトルデータベース(Pinecone、Weaviate、pgvector)に関する知見 | 生成AIやセマンティック検索のユースケースにおける検索を支える |
| ML向けのデータ品質 | 検証フレームワーク、ドリフト検知、リネージ追跡 | 質の悪い学習データは時間とともに気づかぬうちにモデルの精度を低下させる |
| リアルタイムAI向けのストリーミング | オンライン推論にデータを供給するKafka、Kinesis、またはPub/Sub | リアルタイムのパーソナライゼーションや不正検知は最新のイベントデータに依存する |
モデルのデプロイに重点を置く職務については、このテンプレートをMLOpsエンジニアの職務記述書と組み合わせてください。また、分析業務寄りの採用については、データアナリストやデータサイエンティストのプロフィールと比較してください。
提供内容
- 競争力のある報酬:基本給$110,000〜$150,000に加え、株式報酬への参加
- 充実した福利厚生:会社負担の医療・歯科・視力保険
- 専門能力開発:年間$3,000の学習予算とカンファレンス参加支援
- 柔軟な職場環境:リモートファーストの文化とオフィス利用の選択肢
- テクノロジー手当:ホームオフィスの整備や機器のための年間$2,000の手当
- 成長の機会:明確なキャリアパスと技術リーダーシップの機会
状況別バリエーション
大企業環境
大企業の環境では、データエンジニアはガバナンス、コンプライアンス、レガシーシステムとの統合に重点を置きます。セキュリティプロトコル、データリネージの追跡、標準化されたデータモデルとレポーティングフレームワークを必要とする複数の事業部門との連携が重視されます。
スタートアップ環境
スタートアップのデータエンジニアは複数の役割を兼務することが多く、インフラと分析の両方の責任を担うことがよくあります。迅速なプロトタイピング、コスト最適化、スケール可能なMVPデータソリューションの構築に重点が置かれます。詳細なドキュメント作成よりもスピードと柔軟性を重視し、創業者やプロダクトチームと直接連携します。
リモート・ハイブリッド環境
リモートで働くデータエンジニアには、非同期のコミュニケーション能力と自律的に働く力が不可欠です。パイプラインの状況や問題について、優れたドキュメンテーション力と積極的なコミュニケーションが求められます。チームメンバーとの定期的なビデオでの確認や、重大なデータ障害に対する明確なエスカレーション手順も重要です。
業界別の考慮事項
| 業界 | 主な要件 | コンプライアンス要件 |
|---|---|---|
| 金融サービス | リアルタイムの不正検知、高頻度取引データ、規制報告 | SOX、PCI-DSS、バーゼルIII |
| ヘルスケア | HIPAA準拠のアーキテクチャ、臨床データの統合、研究データセット | HIPAA、FDA 21 CFR Part 11 |
| Eコマース | 顧客行動のトラッキング、在庫管理、レコメンデーションエンジン | GDPR、CCPA、PCI-DSS |
| テクノロジー | プロダクト利用状況の分析、A/Bテスト基盤、ユーザーエンゲージメント指標 | GDPR、SOC 2、ISO 27001 |
| 製造業 | IoTセンサーデータ、サプライチェーン最適化、予知保全 | ISO 9001、FDA(規制対象製品の場合) |
| メディア・エンターテインメント | コンテンツパフォーマンス分析、ユーザーエンゲージメント、広告配信の最適化 | COPPA、GDPR、放送規制 |
報酬ガイド
給与情報
全国平均レンジ:年間$95,000〜$170,000
経験レベル別の内訳:
- エントリーレベル(0〜2年):$85,000〜$115,000
- ミッドレベル(3〜5年):$110,000〜$145,000
- シニアレベル(6年以上):$140,000〜$190,000
- スタッフ/プリンシパルレベル:$180,000〜$250,000以上
地域別給与の違い
| 大都市圏 | 給与レンジ | 生活費に関する要因 |
|---|---|---|
| サンフランシスコ・ベイエリア | $130,000〜$220,000 | 需要が高く、テック企業が集中 |
| ニューヨーク市 | $120,000〜$200,000 | 金融業界によるプレミアム |
| シアトル | $115,000〜$185,000 | テックハブ、クラウドプロバイダーの拠点 |
| オースティン | $105,000〜$165,000 | 成長するテックシーン、生活費は比較的低め |
| シカゴ | $100,000〜$160,000 | 金融・ヘルスケア業界 |
| デンバー | $95,000〜$155,000 | 新興のテック市場 |
| リモート | $90,000〜$170,000 | 企業の所在地や方針によって異なる |
報酬に影響する要因:
- クラウドプラットフォームの認定資格(AWS、Azure、GCP)は10〜15%のプレミアムにつながることがある
- 上級学位や専門スキル(MLエンジニアリング、リアルタイムシステムなど)はレンジを引き上げる
- 業界(金融、ヘルスケアなど)によってはより高い報酬が提示される場合がある
給与データはGlassdoor、PayScale、および業界調査をもとに2026年1月時点でまとめたものです
面接質問
技術・実務に関する質問
パイプラインアーキテクチャ:「1日あたり10TBのログデータを処理するデータパイプラインを設計してください。アーキテクチャの意思決定、技術選定、拡張性への配慮について説明してください」
データモデリング:「スタースキーマとスノーフレークスキーマの違いを説明してください。データウェアハウスにおいて、それぞれのアプローチをどのような場合に選びますか」
パフォーマンス最適化:「重要なデータパイプラインの動作が遅く、SLAの期限を守れていません。パフォーマンスのボトルネックをどのように診断し、解決しますか」
データ品質:「ストリーミングデータパイプラインにデータ品質チェックを実装する際のアプローチを説明してください。スキーマの変化にはどう対応しますか」
クラウド技術:「データレイクとデータウェアハウスのアーキテクチャを比較し、それぞれの違いを説明してください。どのような場合にそれぞれのアプローチを勧めますか」
リアルタイム処理:「ラムダアーキテクチャパターンについて説明してください。カッパアーキテクチャと比較した場合の利点と欠点は何ですか」
分散システム:「Apache Sparkにおけるデータのパーティショニングはどのように機能しますか。異なるパーティショニング戦略を使い分ける場面について説明してください」
モニタリングとアラート:「重要なETLパイプラインについて、どのような指標を追跡しますか。データの鮮度や品質の問題に対するアラートはどのように設定しますか」
行動面接質問
問題解決:「本番環境でデータパイプラインが障害を起こした経験について教えてください。そのインシデントにどう対応し、再発防止のために何をしましたか」
コラボレーション:「データ要件が食い違うステークホルダーと協働しなければならなかった状況について教えてください。その状況をどのように解決しましたか」
技術的リーダーシップ:「データエンジニアリングチームに新しい技術やアプローチを導入した事例を教えてください。どのようにして周囲の賛同を得ましたか」
優先順位づけ:「複数の緊急なデータ要望のバランスを取らなければならなかった経験について教えてください。どのように優先順位をつけ、ステークホルダーとコミュニケーションを取りましたか」
継続的な学習:「進化し続けるデータ技術についてどのように最新情報を得ていますか。最近学んで実際に活用した新しいツールの例を挙げてください」
カルチャーフィットに関する質問
データドリブンなマインドセット:「データシステムを構築する際、技術的な意思決定にどのように取り組みますか。どのような要因を考慮しますか」
品質基準:「あなたにとって『良い』データエンジニアリングとはどのようなものですか。自分の仕事の品質をどのように確保していますか」
チームでの協働:「データサイエンティストやアナリストとはどのように連携するのが好ましいですか。理想的な協働プロセスを説明してください」
イノベーションとのバランス:「実績のある技術の活用と、本番システムでの新しいツールの実験とのバランスをどのように取りますか」
評価のヒント:技術的な深さと実務経験の両方を示す候補者を探してください。優れた候補者はトレードオフについて語り、具体的な技術に言及し、ビジネスへの影響を理解していることを示します。問題解決への取り組み方や、複雑な技術概念を明確に伝える能力にも注目してください。
採用のヒント
クイックソーシングガイド
主要なソーシングプラットフォーム:
- LinkedIn:肩書きに「Data Engineer」「ETL Developer」「Big Data」を含む人材に注目する
- GitHub:データパイプラインのコード、特にApache AirflowのDAGを含むリポジトリを検索する
- Stack Overflow:データエンジニアリング関連のタグ(apache-spark、pandas、sqlなど)で活動しているユーザーを対象にする
- AngelList:曖昧さに強く、スタートアップ志向のデータエンジニアを見つけるのに有効
プロフェッショナルコミュニティ:
- データエンジニアリング関連のSlackコミュニティや地域のミートアップ
- SparkやKafkaのユーザーグループ
- クラウドプロバイダーのユーザーグループ(AWS、Azure、GCPのデータサービス)
求人情報最適化のヒント:
- 使用している技術スタック(Spark、Kafka、Airflowなど)を具体的に強調する
- データの規模(1日あたりのTB数、数百万件のレコードなど)を記載し、経験豊富な候補者を惹きつける
- リモートワークの選択肢をタイトルや説明文に目立つ形で記載する
- 使用するクラウドプラットフォームを明記し、関連する経験を持つ人材を惹きつける
警戒すべき兆候
- SQLの経験しかない:Python/Scala/Javaのプログラミングスキルがない候補者は、現代のデータエンジニアリング業務に苦労する可能性がある
- クラウドの経験がない:クラウドデータサービスへの理解が限定的な場合、スキルセットが古い可能性を示す
- サイロ化した仕事の進め方:データサイエンティストやアナリストとの連携に消極的な場合、カルチャーフィットが悪い可能性を示唆する
- 本番運用の経験がない:システムのモニタリング、デバッグ、インシデント対応の経験が不足している
- バズワードが多い:実際の応用を示さずに専門用語を多用する
- バージョン管理の経験がない:Gitや共同開発の実践に不慣れである
採用担当者向けのよくある質問
データエンジニアとデータサイエンティストの違いは何ですか?
データエンジニアは、データへのアクセスを可能にするデータインフラ、パイプライン、システムの構築と維持に重点を置きます。データサイエンティストはそのインフラを使ってデータを分析し、予測モデルを構築します。データエンジニアは、ソフトウェアエンジニアリングとシステムアーキテクチャにより重点を置いています。
ジュニアのデータエンジニアを採用すべきか、それとも転向を前提にシニア開発者を採用すべきでしょうか?
ジュニアのデータエンジニアは、関連する教育や基礎的なスキルを持っていることが多いものの、指導が必要です。シニア開発者はソフトウェアエンジニアリングのベストプラクティスをもたらしますが、データ特有の技術を習得するのに時間がかかる場合があります。チームの指導体制と、目下の技術的なニーズの両方を考慮してください。
データエンジニアにとってドメイン知識はどれくらい重要ですか?
技術スキルが第一に重要ですが、ドメイン知識があるとデータエンジニアがデータの文脈やビジネス要件を理解しやすくなります。ドメイン知識は価値がありますが、業務の中で身につけることができるのに対し、確かな技術的基礎はすぐには育ちにくいものです。
データエンジニアの一般的なキャリアパスはどのようなものですか?
一般的なパスとしては、シニアデータエンジニア、リードデータエンジニア、データエンジニアリングマネージャーへの昇進や、MLエンジニアリング、データアーキテクチャ、プラットフォームエンジニアリングといった分野への専門化があります。データサイエンスやアナリティクスエンジニアリングの職種へ転向する人もいます。
データエンジニアを目指す方向けのよくある質問
データエンジニアとして、どのプログラミング言語に重点を置くべきですか?
Pythonが最も汎用性の高い選択肢であり、ETL開発、データ処理、MLワークフローとの統合に広く使われています。SQLはデータ操作に不可欠です。Sparkを多用する環境では、ScalaやJavaも役立ちます。
データエンジニアにとって、クラウド認定資格はどれくらい重要ですか?
クラウド認定資格は、データサービスに関する実践的な知識を証明するものであり、候補者としての評価を大きく高めることができます。AWS Data Analytics、Azure Data Engineer、GCP Data Engineerの各資格は、雇用主から高く評価されています。
データエンジニアにとって最も重要なスキルは何ですか?
データモデリングの原則への理解と組み合わさった高いSQLスキルです。こうした基礎はあらゆる技術やプラットフォームに共通して当てはまります。問題解決能力とシステム思考も同様に重要です。
現在の職場でビッグデータ技術に触れる機会がない場合、どうすれば経験を積めますか?
クラウドの無料枠を活用して、AWS Glue、Azure Data Factory、GCP Dataflowといったマネージドサービスを試してみましょう。オープンソースプロジェクトに貢献したり、公開データセットを使って個人プロジェクトを作成したり、オンラインのラボやチュートリアルを活用したりするのも有効です。
ETLとELTのアプローチの違いは何ですか?
ETL(Extract, Transform, Load)は、データを変換してから移行先に読み込む方式で、構造化データや従来型のウェアハウスに適しています。ELT(Extract, Load, Transform)は、まず生データを読み込んでから変換する方式で、クラウドのデータレイクや大規模な非構造化データの扱いに優れています。