Prevendo o CSAT com IA: avaliando cada conversa sem pesquisas
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
O CSAT previsto é uma estimativa de quão satisfeito o cliente ficou com uma conversa de suporte, produzida por um modelo que lê a conversa e seus metadados em vez de esperar que o cliente responda a uma pesquisa. O resultado costuma ser uma nota (muitas vezes de 1 a 5, para coincidir com a escala da pesquisa) ou uma probabilidade de o cliente ter avaliado a interação como boa. Como nenhum cliente precisa responder, ele pode cobrir quase todas as conversas.
Essa cobertura é todo o argumento de venda, e também a armadilha. Uma pesquisa diz o que um cliente falou. Uma previsão diz o que um modelo supõe que um cliente teria falado, com base em padrões de conversas passadas. São coisas diferentes, e é na distância entre elas que as equipes se complicam. Este guia cobre como funcionam o CSAT previsto e a pontuação de sentimento, como se comparam ao CSAT de pesquisa e como conferir uma nota prevista com resultados reais de pesquisa antes de deixá-la orientar decisões. Ele faz parte da coleção AI for Customer Service, então a visão geral de IA no atendimento ao cliente dá o panorama mais amplo.
Primeiro, um limite. Avaliar o quão bem um agente conduziu uma conversa, com base em uma rubrica, é outro trabalho, tratado em garantia de qualidade com IA para o suporte. Este artigo trata do resultado do cliente: ele ficou satisfeito, e como saber isso sem perguntar?
Fatos Principais
- O CX Score da Intercom, uma alternativa gerada por IA ao CSAT de pesquisa, avalia conversas encerradas de 1 a 5, analisando um conjunto de motivos nomeados separadamente e combinando em seguida os que não são neutros. Conversas por telefone não são avaliadas (Intercom).
- A Intercom descreve o CSAT de pesquisa como a captura de feedback de um grupo pequeno e autosselecionado, que muitas vezes representa em excesso as opiniões extremas (visão do fornecedor) (Intercom).
- Trabalhos acadêmicos sobre modelagem de satisfação do cliente descrevem as taxas de resposta de pesquisas como muito baixas e observam que os não respondentes costumam ser a maior parte da base de clientes, então ignorá-los pode enviesar as estimativas (Toronto Metropolitan University).
- Quando a Zendesk lançou o Satisfaction Prediction em 2016, disse que o modelo lia centenas de sinais, incluindo a descrição em texto, o número de respostas e o tempo total de espera, e estava disponível para contas Enterprise que recebiam pelo menos 500 avaliações de satisfação por mês (Zendesk).
- Pesquisas sobre LLMs como juízes constataram que modelos fortes podem chegar a mais de 80% de concordância com as preferências humanas, o mesmo nível em que os humanos concordam entre si, ao mesmo tempo em que apresentam vieses de posição, de verbosidade e de autovalorização (Zheng et al., 2023).
- Um modelo bem calibrado é aquele em que, entre os casos pontuados perto de 0,8, cerca de 80% realmente se mostram positivos (documentação do scikit-learn).
Por que o CSAT de pesquisa sozinho não basta
O CSAT de pesquisa é simples: depois que uma conversa é encerrada, envia-se um pedido de avaliação de uma pergunta e reporta-se a parcela de avaliações boas. É barato e os clientes o entendem. Mas tem três fraquezas estruturais que nenhum desenho de pesquisa corrige por completo.
Cobertura. Só os clientes que respondem são contados. As taxas de resposta variam por canal, público e desenho da pesquisa, e a pesquisa resumida acima as chama de muito baixas. Se você cuida de um suporte com milhares de conversas por semana, pode estar tomando decisões de dimensionamento de equipe e de produto com base em uma fatia delas.
Viés de autosseleção. As pessoas que respondem não são uma amostra aleatória. Os clientes muito felizes e os muito insatisfeitos respondem; o grande meio-termo dá de ombros e vai embora. A maioria silenciosa, incluindo o cliente que ficou levemente irritado e cancelou em silêncio um mês depois, fica quase invisível. Os pesquisadores citados acima fazem o mesmo ponto: os não respondentes tendem a ser o grupo maior, então deixá-los de fora pode distorcer os resultados.
Lacunas de momento e de canal. Uma pesquisa depois de uma conversa por e-mail encerrada não diz nada sobre o chat abandonado nem sobre o ticket que ficou sem resposta. As pesquisas também chegam atrasadas: você fica sabendo de uma semana ruim na semana seguinte.
O CSAT previsto ataca diretamente o primeiro e o terceiro problemas. Ele pode avaliar uma conversa no momento em que ela é encerrada (ou enquanto ainda está aberta) e não depende de resposta. Ele não corrige o viés automaticamente. Um modelo treinado com respostas de pesquisa herda a distorção da pesquisa, e isso é o principal a ter em mente no restante deste artigo.
Como funciona o CSAT previsto
Há duas abordagens amplas, e muitos produtos misturam as duas.
Abordagem 1: um modelo supervisionado treinado com o seu histórico de pesquisas
Você pega conversas passadas que receberam resposta de pesquisa, trata a nota como o rótulo e treina um modelo para prevê-la a partir de características da conversa. O lançamento da Zendesk em 2016 é um exemplo claro desse desenho: o modelo usava sinais como o texto do ticket, o número de respostas e o tempo total de espera, e o produto exigia um volume mínimo de avaliações por mês para haver histórico rotulado suficiente de onde aprender (Zendesk). Essa exigência de volume é um lembrete útil: a previsão supervisionada precisa de muitas respostas reais de pesquisa para aprender, o que significa que ela depende em silêncio dos mesmos dados que pretende substituir.
Características típicas:
- Sinais de texto: as palavras do cliente, mudanças de sentimento ao longo das mensagens, frases como "ainda não funciona" ou "é a terceira vez que peço".
- Sinais de esforço: número de respostas, reatribuições, transferências entre agentes, número de vezes que o cliente teve de se repetir.
- Sinais de tempo: tempo de primeira resposta, tempo total de espera, intervalos entre respostas.
- Contexto: canal, assunto, nível do cliente, se é um contato repetido.
Abordagem 2: um modelo de linguagem lendo a conversa contra fatores definidos
Produtos mais novos usam um modelo de linguagem para ler a transcrição inteira e julgá-la contra fatores nomeados, somando-os depois em uma nota. O CX Score da Intercom funciona assim. Ele avalia motivos específicos (qualidade da resposta, esforço do cliente, emoção forte, feedback sobre produto ou serviço e feedback sobre políticas), trata um motivo como neutro se não há sinal forte e deriva uma avaliação de 1 a 5 da combinação dos motivos não neutros, sem ponderação oculta de um motivo sobre outro (Intercom). Ele avalia apenas conversas encerradas por messenger ou e-mail, o que ensina algo prático: todo produto de CSAT previsto tem limites de escopo, e você precisa conhecer os seus.
Os motivos importam mais do que o número. "3,2, impulsionado por alto esforço do cliente e uma reclamação sobre política" diz o que corrigir.
Onde a pontuação de sentimento se encaixa
A análise de sentimento é o bloco básico por baixo de quase tudo isso. Ela rotula o tom emocional do texto, mensagem por mensagem. O CSAT previsto vai um passo além: combina tom com esforço, resultado e contexto para estimar o veredicto geral sobre a interação. Uma conversa pode ter uma abertura irritada e um final feliz (o cliente estava chateado, o agente resolveu, o cliente agradeceu). O sentimento por mensagem enxerga as duas metades. Uma boa previsão de CSAT dá mais peso ao final.
CSAT de pesquisa x CSAT previsto
| Dimensão | CSAT de pesquisa | CSAT previsto |
|---|---|---|
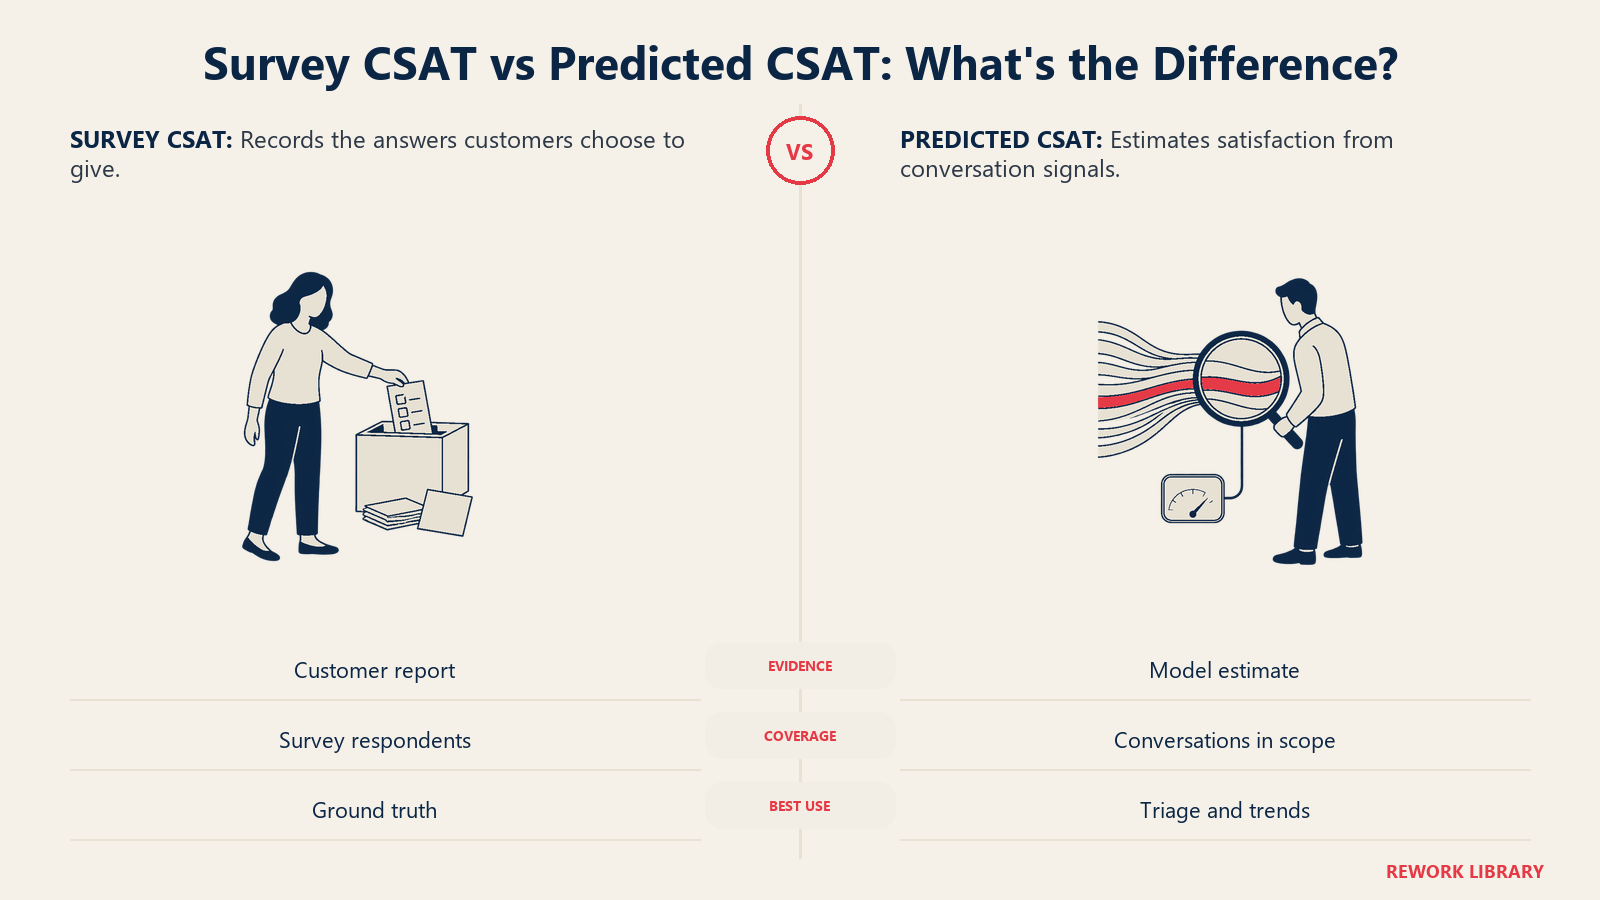
| O que mede | O que o cliente disse que sentiu | A estimativa de um modelo sobre o que ele diria |
| Cobertura | Só os clientes que respondem | Quase todas as conversas no escopo |
| Principal viés | Autosseleção, extremos em excesso | Herdado dos dados de treinamento, mais pontos cegos do modelo |
| Velocidade | Depois que a pesquisa é respondida | No encerramento da conversa ou perto dele |
| Explica o "porquê" | Só se houver um comentário em texto livre | Pode anexar motivos e citações |
| Bom para | Verdade de referência, relatórios, benchmarking | Triagem, identificar tendências, encontrar problemas silenciosos |
| Fraco em | Maioria silenciosa, conversas abandonadas | Sarcasmo, contexto que o modelo não vê, assuntos novos |
A conclusão não é "substituir as pesquisas". É que as duas têm erros complementares. As pesquisas são estreitas, mas reais; as previsões são amplas, mas modeladas. Usadas juntas, a pesquisa vira a verdade de referência que mantém a previsão honesta, e a previsão estende essa verdade às conversas que ninguém avaliou.
Exemplos reais por função
Liderança de suporte. Um diretor de suporte vê o CSAT de pesquisa estável no mesmo nível por um trimestre. A nota prevista, rodando sobre todas as conversas, cai bruscamente em um assunto (digamos, uma mudança de cobrança). A pesquisa não percebeu porque poucos desses clientes responderam. O diretor encaminha uma amostra dessas conversas a um revisor humano e encontra a causa raiz.
Produto e engenharia. Notas separadas por assunto e por motivo viram uma lista ordenada do que frustra os clientes. Combine isso com o resumo de tickets com IA e a equipe de produto recebe uma explicação curta e citada para cada grupo de nota baixa, em vez de uma planilha.
Customer success. Um CSAT previsto baixo nos tickets recentes de uma conta-chave é um alerta antecipado que nenhuma pesquisa teria revelado. É um insumo entre vários para os health scores e para os sinais de suporte que preveem o churn, e nunca deve ser o único.
Operações de suporte e QA. O CSAT previsto decide quais conversas uma pessoa deve ler. É um sinal de triagem. As conversas de nota baixa vão para revisão, e os resultados da revisão realimentam as verificações do modelo. Ele não deve ser usado para avaliar agentes individualmente (para isso, veja o artigo de QA indicado acima).
Suporte proativo. Se uma conversa está tendendo ao negativo enquanto ainda está aberta, um supervisor pode intervir antes que ela seja encerrada.
Como validar as notas previstas com os resultados da pesquisa
Este é o passo que a maioria das equipes pula, e é ele que decide se o número vale a pena. O princípio: as respostas de pesquisa que você tem são exemplos rotulados. Separe algumas, nunca treine com elas e teste o modelo contra elas.
Passo 1: monte um conjunto de reserva
Pegue conversas com pesquisa de um período recente e separe-as. Se o fornecedor treinou com o seu histórico, pergunte qual período foi usado no treinamento e garanta que o seu conjunto de teste venha de depois dele. Um modelo testado em conversas com as quais foi treinado vai parecer melhor do que é.
Passo 2: compare no nível da conversa
Para cada conversa do conjunto de reserva, coloque a nota prevista ao lado da avaliação real da pesquisa. Comece por estas verificações:
| Verificação | O que informa | O que procurar |
|---|---|---|
| Concordância de ordem | O modelo ordena as conversas como os clientes ordenaram? | Notas previstas mais altas devem coincidir com avaliações de pesquisa mais altas |
| Classificação de boa contra ruim | Ele consegue separar clientes satisfeitos de insatisfeitos? | Use ROC AUC, que resume em um número o quanto as notas separam os dois grupos (scikit-learn) |
| Calibração | As probabilidades significam o que dizem? | Entre conversas com nota perto de 0,8, cerca de 80% devem ser avaliadas como boas (scikit-learn) |
| Erro por segmento | Ele é igualmente preciso em todo lugar? | Separe os resultados por canal, idioma, assunto e nível do cliente |
A calibração merece um olhar mais atento. Trace a probabilidade prevista contra a parcela real de avaliações boas em cada faixa (um diagrama de confiabilidade). Se a linha ficar perto da diagonal, as notas se comportam como probabilidades reais. Se não, você ainda pode usar o modelo para ordenar, mas não deve ler um "0,8" como 80% de chance de um cliente feliz.
Passo 3: compare no nível agregado
Ninguém age com base na nota de uma única conversa. Os líderes leem médias por equipe, assunto e semana. Então verifique também se a média do CSAT previsto de um grupo acompanha a média do CSAT de pesquisa desse mesmo grupo ao longo do tempo. Um modelo pode ser ruidoso por conversa e ainda dizer a verdade no agregado, ou o contrário. Teste o nível que você vai usar.
Passo 4: verifique o que as pesquisas não enxergam
A pergunta difícil é se o modelo acerta nas conversas que nunca receberam pesquisa. Você não consegue testar isso diretamente, mas pode sondar. Pegue uma amostra aleatória de conversas sem pesquisa, peça a dois revisores que as leiam sem ver a nota prevista e compare. Se os seus revisores discordam muito entre si, esse é o teto de qualquer modelo. Pesquisas sobre LLMs como juízes constataram que modelos fortes podem igualar a taxa em que os humanos concordam entre si, o que é uma meta sensata, e não uma perfeita (Zheng et al., 2023). Faça também, em alguns casos de nota baixa sem pesquisa, um breve contato de acompanhamento para saber como o cliente realmente se sentiu.
Passo 5: fique de olho na deriva
A concordância se deteriora quando o produto, a política ou a mistura de idiomas mudam. Repita a comparação com o conjunto de reserva todo mês e depois de qualquer grande mudança.
Vieses e pontos cegos conhecidos
Distorção nos dados de treinamento. Um modelo supervisionado aprende com os respondentes. Se clientes extremos dominam o seu histórico de pesquisas, o modelo aprende como soam os clientes extremos e pode lidar mal com o meio-termo silencioso. Pesquisadores que trabalham nesse problema defendem que os dados de não respondentes sejam trazidos para a modelagem em vez de ignorados (Toronto Metropolitan University).
Estilo acima de substância. Os modelos de linguagem usados como juízes podem favorecer respostas mais longas e polidas, um viés de verbosidade documentado (Zheng et al., 2023). No suporte, uma troca prolixa e cheia de desculpas pode parecer mais satisfatória do que uma curta que resolveu o problema. Verifique se o CSAT previsto acompanha a extensão da mensagem depois de considerar o resultado.
Cegueira para o resultado. A satisfação depende muito de o problema ter sido realmente resolvido. Um modelo que vê só a conversa pode não saber que o reembolso nunca chegou. Alimente-o com dados de resolução quando puder e trate a taxa de resolução como uma verificação separada.
Idioma e cultura. Normas de cortesia, sarcasmo e hábitos de avaliação variam por região. Um modelo validado em tickets em inglês diz pouco sobre os em português. Valide por idioma.
A lacuna do atendimento por IA. Conversas atendidas por bots e por pessoas podem se comportar de modo diferente: os clientes podem avaliá-las por padrões distintos, e a precisão do modelo pode variar entre elas. Valide os dois grupos separadamente em vez de presumir que um resultado cobre ambos.
Implementando o CSAT previsto, passo a passo
- Nomeie a decisão que ele vai apoiar. Triagem, relatório de tendências, alertas de contas e coaching de agentes exigem precisões diferentes. Comece pela triagem, o uso mais tolerante.
- Corrija primeiro os seus dados. Texto de tickets limpo, tags consistentes de canal e assunto e resultados de resolução melhoram as previsões. Veja como preparar os dados de suporte para a IA.
- Mantenha a pesquisa funcionando. Ela é a sua verdade de referência. Cortá-la para "economizar com pesquisas" elimina a única forma de validar o modelo.
- Rode em modo sombra. Avalie as conversas por algumas semanas sem mostrar a líderes nem agentes e compare com os resultados de pesquisa que chegam.
- Valide com os cinco passos acima e anote a precisão que encontrou, por segmento.
- Publique o que o número é. Rotule-o como "previsto" em todo dashboard, ao lado do CSAT de pesquisa, nunca misturado a ele em silêncio.
- Adicione motivos, não só notas. Exija que o sistema mostre quais fatores levaram a uma nota baixa, com o trecho citado.
- Roteie com base nele. Envie as conversas de previsão baixa para uma fila humana e amostre as altas para detectar falsa tranquilidade.
- Revise a cada trimestre. Repita o teste com o conjunto de reserva, verifique as diferenças entre segmentos e aposente os usos que o modelo não consegue sustentar.
Erros comuns
Tratar a previsão como uma medição. É uma estimativa. Um dashboard que mostra o CSAT previsto e o de pesquisa como a mesma métrica vai enganar as pessoas na primeira vez que divergirem.
Abandonar a pesquisa. Sem respostas de pesquisa recentes você não consegue validar, e o modelo se afasta aos poucos do que os clientes realmente sentem.
Usá-lo para avaliar pessoas. O CSAT previsto reflete tanto a situação do cliente quanto a habilidade do agente: uma disputa de cobrança tem nota mais baixa do que uma redefinição de senha. Comparar agentes pelas notas previstas brutas pune quem pega a fila difícil.
Ignorar os segmentos. Um número geral pode parecer bom enquanto um canal ou idioma está errado em silêncio. Sempre separe por segmento.

Customer Success Operations Manager
On this page
- Fatos Principais
- Por que o CSAT de pesquisa sozinho não basta
- Como funciona o CSAT previsto
- Abordagem 1: um modelo supervisionado treinado com o seu histórico de pesquisas
- Abordagem 2: um modelo de linguagem lendo a conversa contra fatores definidos
- Onde a pontuação de sentimento se encaixa
- CSAT de pesquisa x CSAT previsto
- Exemplos reais por função
- Como validar as notas previstas com os resultados da pesquisa
- Passo 1: monte um conjunto de reserva
- Passo 2: compare no nível da conversa
- Passo 3: compare no nível agregado
- Passo 4: verifique o que as pesquisas não enxergam
- Passo 5: fique de olho na deriva
- Vieses e pontos cegos conhecidos
- Implementando o CSAT previsto, passo a passo
- Erros comuns