Métricas de atendimento com IA: contenção, resolução, CSAT e custo por contato
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
As métricas de atendimento com IA são o pequeno conjunto de números que mostra se a sua IA está resolvendo os problemas dos clientes, com que qualidade e a que custo. Nenhum número isolado faz isso. A contenção diz que um humano ficou de fora. A resolução diz que o problema desapareceu. O CSAT diz como o cliente se sentiu. O custo por contato diz o que foi preciso. Cada uma pode parecer saudável enquanto outra falha em silêncio, então a unidade útil é um scorecard em que cada métrica tem uma parceira que cobre o seu ponto cego.
Este guia traz esse scorecard: onze métricas, uma fórmula para cada, um exemplo prático com números hipotéticos, as armadilhas e uma tabela-modelo que você pode colar nos seus relatórios. Se você precisa da versão longa sobre como contenção, deflexão e resolução se diferenciam, leia taxa de resolução da IA. Aqui usamos essas definições e seguimos em frente. Para a visão mais ampla de onde a IA se encaixa no suporte, comece pela visão geral de IA no atendimento ao cliente.
Fatos Principais
- Um scorecard de IA saudável tem onze métricas em quatro grupos: resultado (contenção, resolução, taxa de reabertura), experiência (CSAT, esforço, qualidade da transferência), eficiência (custo, tempo de atendimento) e cobertura (escalonamento, lacunas de conhecimento).
- Toda métrica precisa de uma parceira. A contenção anda com a resolução, o CSAT anda com uma linha de base humana, e o custo por contato anda com o custo por problema resolvido.
- O custo por contato muda quando você altera a forma de contar um "contato", mesmo que nada de real tenha mudado. Defina-o como um problema do cliente e mantenha a definição fixa (Gladly).
- Em um grande estudo com agentes de suporte ao cliente, a assistência de IA elevou os problemas resolvidos por hora em 14% em média, com ganho de 34% entre profissionais novatos e de baixa qualificação (NBER).
- A própria orientação da Zendesk sobre tempo médio de atendimento alerta que um número baixo não significa bom desempenho e recomenda lê-lo ao lado do CSAT, da resolução no primeiro contato e do esforço do cliente (Zendesk).
- Reporte cada métrica com o denominador escrito ao lado. Mudar o denominador é a forma mais fácil de fabricar progresso.
O scorecard num relance
Antes do detalhe, aqui está o conjunto inteiro. Trate a coluna "Anda com" como a regra que mantém a métrica honesta.
| Grupo | Métrica | Fórmula | Anda com |
|---|---|---|---|
| Resultado | Taxa de contenção | Conversas sem envolvimento humano ÷ conversas da IA | Taxa de resolução |
| Resultado | Taxa de resolução verificada | Conversas resolvidas e não repetidas ÷ conversas da IA | Taxa de reabertura, revisão por amostragem |
| Resultado | Taxa de reabertura / recontato | Conversas resolvidas seguidas de recontato sobre o mesmo problema ÷ conversas resolvidas | Taxa de resolução |
| Experiência | CSAT, IA versus humano | Respostas satisfeitas ÷ total de respostas, separadas por quem atendeu | Taxa de resposta |
| Experiência | Esforço do cliente | Soma das notas de esforço ÷ respostas da pesquisa | CSAT |
| Experiência | Qualidade da transferência | Transferências em que o agente não perguntou de novo ÷ transferências | Taxa de escalonamento |
| Eficiência | Custo por contato | Custo total de suporte ÷ contatos | Custo por problema resolvido |
| Eficiência | Custo por problema resolvido | Custo total de suporte ÷ problemas resolvidos | Custo por contato |
| Eficiência | Impacto no tempo de atendimento do agente | Tempo médio de atendimento com assistência de IA versus sem | CSAT, taxa de reabertura |
| Cobertura | Taxa de escalonamento | Conversas passadas a um humano ÷ conversas da IA | Contenção |
| Cobertura | Taxa de lacunas de conhecimento | Perguntas que a IA não soube responder com base em suas fontes ÷ perguntas feitas | Resolução por assunto |
A lista é longa, mas a maioria das equipes revisa cinco ou seis dessas métricas toda semana e as demais todo mês. As seções a seguir vão grupo por grupo.
Métricas de resultado: o problema desapareceu?
A taxa de contenção é a parcela das conversas da IA que nunca chegaram a um humano.
Contenção = conversas sem envolvimento humano ÷ total de conversas da IA
É a métrica mais fácil de calcular e a mais fácil de interpretar errado. O cliente que desiste está contido. O cliente que recebe uma resposta errada e fecha a janela está contido. O relatório do Consumer Financial Protection Bureau sobre chatbots de bancos descreve clientes presos em "doom loops" de respostas repetitivas e inúteis, sem uma saída para um humano, e cita uma pesquisa em que 78% dos consumidores precisaram falar com uma pessoa depois que um chatbot não atendeu às suas necessidades (CFPB). Alguns desses clientes entram no número de contenção de alguém como um sucesso.
A taxa de resolução verificada é a contenção com as falhas removidas.
Resolução verificada = (conversas contidas − conversas seguidas de recontato sobre o mesmo problema − conversas que um revisor avaliou como erradas) ÷ total de conversas da IA
O critério para julgar o que é "resolvido" é uma escolha de projeto. A Intercom, por exemplo, define sua taxa de resolução como a porcentagem de conversas que seu agente de IA resolve sem envolvimento humano e conta uma resolução quando o cliente confirma a resposta ou sai sem pedir mais ajuda (Intercom). É uma regra operacional razoável, mas ela conta o silêncio como sucesso, então faça a sua própria checagem de recontato por cima de qualquer número do fornecedor.
A taxa de reabertura ou de recontato pega as falhas silenciosas.
Taxa de reabertura = conversas resolvidas seguidas de recontato sobre o mesmo problema dentro da sua janela ÷ conversas resolvidas
Numa ferramenta de tickets, a reabertura é um evento nativo. A Zendesk define tickets reabertos como aqueles reabertos depois de resolvidos (Zendesk). Com a IA, o cliente muitas vezes não reabre nada. Ele abre um novo chat, manda um e-mail ou liga para você. Por isso, cruze por cliente e assunto entre os canais, não pelo ID do ticket, e escolha uma janela adequada ao problema: alguns dias para uma redefinição de senha, algumas semanas para uma disputa de cobrança.
Um exemplo prático (hipotético)
Digamos que 10.000 conversas comecem com a sua IA em um mês.
- 6.000 são contidas e 4.000 são passadas a um humano (contenção de 60%, escalonamento de 40%).
- Das 6.000 contidas, 900 clientes voltam por outro canal em até sete dias sobre o mesmo problema.
- A resolução verificada é (6.000 − 900) ÷ 10.000 = 51%.
A manchete diz 60%. O número defensável é 51%. Os dois são verdadeiros, mas só um pertence a um business case de orçamento. Acrescente uma revisão humana semanal de uma amostra aleatória e talvez o valor caia ainda mais, o que é uma informação útil sobre o quanto a contagem da própria ferramenta é otimista.
Métricas de experiência: como foi?
CSAT, separado entre IA e humano. O cálculo padrão é respostas satisfeitas divididas pelo total de respostas, multiplicado por 100. A maioria das equipes conta as duas notas mais altas numa escala de cinco pontos, ou os votos "bom" numa escala binária. O erro é publicar um único CSAT misturado. Reporte a nota das conversas atendidas pela IA e das atendidas por humanos separadamente e mostre a taxa de resposta ao lado de cada uma, porque clientes que acabaram de receber uma resposta ruim de um bot têm menos probabilidade de preencher uma pesquisa do que clientes que falaram com uma pessoa. Um CSAT alto da IA com 4% de taxa de resposta diz algo sobre os 4%.
Se você quer ver a satisfação antes de a pesquisa chegar, prever o CSAT com IA trata de modelá-lo a partir de sinais da conversa. Trate uma nota prevista como um convite para olhar, não como um substituto de perguntar.
Esforço do cliente. O Customer Effort Score mede o esforço de que o cliente precisa para obter o que quer. Numa escala padrão, a Zendesk escreve a fórmula como a soma das notas de CES dividida pelo número de respostas da pesquisa e observa que uma nota alta indica baixo esforço (Zendesk). As escalas correm nos dois sentidos entre os fornecedores, então anote qual extremo é o "fácil" antes de comparar dois relatórios. O esforço é a métrica que expõe o bot longo e educado que tecnicamente responde e leva nove mensagens para isso.
Qualidade da transferência. Quando a IA transfere, o humano precisou recomeçar?
Qualidade da transferência = transferências em que o agente tinha o resumo da conversa, identificou o cliente e não refez a pergunta ÷ total de transferências
Você mede isso por amostragem das transferências, não por um dashboard. Leia vinte por semana e marque cada uma como sim ou não. O padrão que você procura é o cliente que explica o problema a um bot e depois o explica de novo a uma pessoa. Essa repetição corrói a confiança mais rápido do que uma resposta errada. O agent assist (assistência ao agente) é a capacidade que torna possível uma transferência limpa, ao resumir a conversa para o agente.
Métricas de eficiência: quanto custou e o que liberou?
O custo por contato é o número de eficiência mais simples.
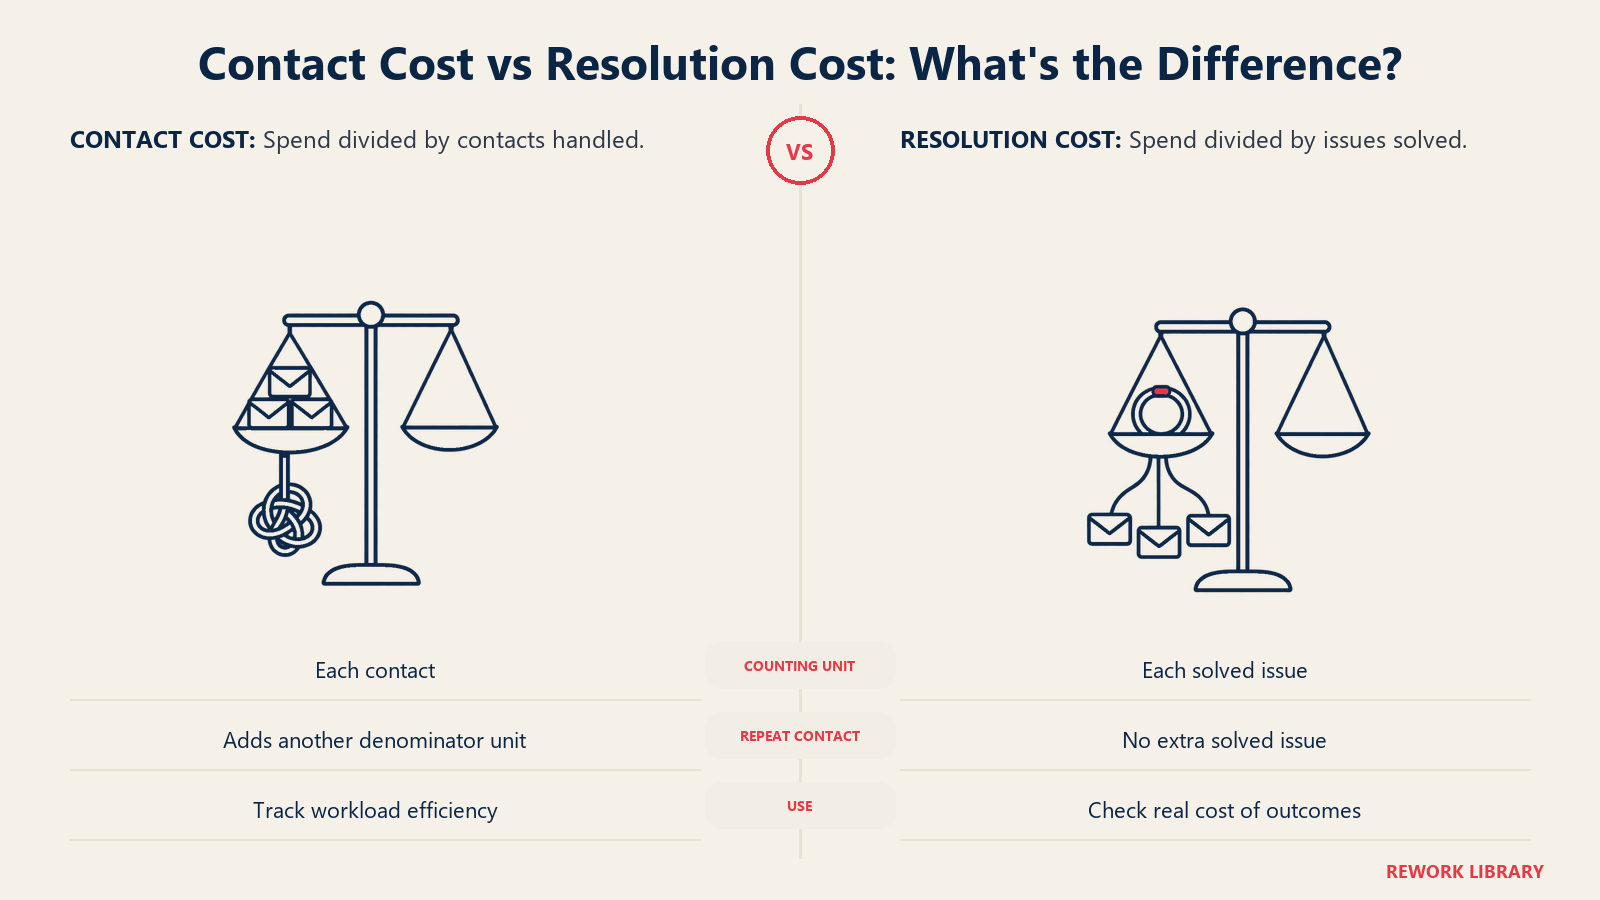
Custo por contato = custo operacional total de suporte do período ÷ total de contatos atendidos no período
O exemplo prático da Gladly é uma equipe que gasta $100.000 em um mês e atende 10.000 contatos, o que dá $10,00 por contato. A mesma página destaca o ponto que importa: sistemas baseados em tickets contam cada novo ticket, enquanto sistemas baseados em conversas contam a conversa inteira como uma só, e contar cada toque reduz o custo reportado sem mudar a experiência do cliente. Sua recomendação é definir um contato como um problema do cliente e manter essa definição fixa (Gladly).
O custo por problema resolvido é a versão mais difícil e mais honesta, porque fragmentar o trabalho não consegue reduzi-lo.
Custo por problema resolvido = custo operacional total de suporte ÷ problemas efetivamente resolvidos (pela IA ou por um humano)
Continue o exemplo hipotético anterior, com um custo total de suporte presumido de $120.000 no mês. Os 900 recontatos são contatos reais, então o total é de 10.900, o que dá um custo por contato de cerca de $11,01. Os humanos resolvem 3.600 dos 4.000 problemas escalonados e todos os 900 problemas de recontato, de modo que os problemas resolvidos somam 5.100 + 3.600 + 900 = 9.600. O custo por problema resolvido é $120.000 ÷ 9.600 = $12,50. O segundo número é maior porque não deixa um recontato parecer uma pechincha. Acompanhe os dois. Quando divergem, a sua IA está criando contatos extras.
Para os insumos do custo em si, como o que entra no numerador e onde as taxas da plataforma de IA se encaixam, veja o custo do atendimento ao cliente com IA.
Impacto no tempo de atendimento do agente. O tempo médio de atendimento costuma ser escrito como tempo de conversa mais tempo de espera mais trabalho posterior, dividido pelo número de contatos atendidos (Zendesk). Com a IA no meio, duas coisas mudam. Primeiro, a IA absorve os contatos simples, então a fila restante dos humanos é mais difícil e o tempo médio de atendimento deles pode subir mesmo com o sistema funcionando. Segundo, as ferramentas de assistência devem encurtar o tempo de cada contato. Meça os dois: o tempo de atendimento por motivo de contato antes e depois, e os problemas resolvidos por hora de agente.
Existe evidência externa para o efeito da assistência. Um estudo com agentes de suporte ao cliente que usaram um assistente de IA generativa encontrou um aumento médio de 14% nos problemas resolvidos por hora, uma melhora de 34% entre profissionais novatos e de baixa qualificação e impacto mínimo sobre os experientes (NBER). Esses são os resultados desse estudo, não uma meta para a sua equipe, mas mostram por que você deve ler o tempo de atendimento por nível de experiência: o ganho não se distribui de modo uniforme. A orientação da Zendesk sobre a métrica também alerta que um tempo de atendimento baixo não significa bom desempenho, porque pressionar os agentes a encurtar os contatos pode prejudicar a qualidade, então leia-o ao lado do CSAT e do esforço (Zendesk).
Métricas de cobertura: onde a IA para?
Taxa de escalonamento.
Taxa de escalonamento = conversas passadas a um humano ÷ conversas da IA
Não existe um número ideal. Uma taxa próxima de zero pode significar que a IA é excelente ou que ela esconde a saída. Divida os escalonamentos em dois tipos. As transferências planejadas acontecem porque você configurou uma regra, como todo reembolso acima de um valor definido ir para uma pessoa. Os escalonamentos por falha acontecem porque o cliente pediu um humano, demonstrou frustração ou esbarrou em algo que a IA não conseguiu tratar. A documentação da Intercom traça uma linha parecida entre uma transferência acionada por um procedimento configurado e um escalonamento que ocorre pelo comportamento padrão ou por regras do workspace, como o cliente pedir uma pessoa (Intercom). Seu objetivo não é minimizar o escalonamento. É tornar os escalonamentos por falha mais raros e as transferências planejadas mais suaves. Essa é a decisão no centro de automatizar ou assistir.
Taxa de lacunas de conhecimento.
Taxa de lacunas de conhecimento = perguntas que a IA não soube responder com confiança com base em suas fontes ÷ perguntas feitas
A documentação da HelpCrunch, por exemplo, define uma pergunta não resolvida como qualquer consulta que o agente de IA não conseguiu responder com confiança com base nas fontes de dados conectadas, e usa o relatório para encontrar pontos cegos (HelpCrunch). Qualquer que seja a ferramenta, a prática é a mesma: ordene as lacunas por volume e escreva ou corrija a cada semana o artigo por trás da maior delas. A taxa de resolução costuma ser um problema de conteúdo disfarçado. Uma fonte organizada e atual vale mais do que um modelo melhor, e é por isso que preparar os dados de suporte para a IA vem antes da maior parte dos ajustes.
Exemplos reais por função
O mesmo scorecard é lido de forma diferente conforme a fila.
Suporte ao cliente, nível 1. Redefinições de senha e consultas de pedido devem mostrar alta resolução verificada e baixo esforço. Se não mostram, o problema é de integração, não de inteligência.
Cobrança e operações financeiras. A contenção pode parecer ótima enquanto a taxa de reabertura sobe, porque a IA explica a fatura, mas não enxerga a conta. Acompanhe aqui a taxa de reabertura e o custo por problema resolvido, não a contenção.
Help desk de TI. Os funcionários repetem perguntas quando as etapas mudam. Acompanhe os recontatos por pessoa e a taxa de lacunas de conhecimento, já que artigos desatualizados são a causa habitual.
E-commerce. "Onde está o meu pedido?" é uma consulta e se resolve de forma limpa. O risco é a encomenda atrasada: a IA informa "em trânsito" e o cliente liga no dia seguinte. A taxa de reabertura por motivo de contato mostra isso.
Onboarding e sucesso do cliente. O silêncio é perigoso aqui. Um novo cliente que pergunta como importar contatos e nunca responde não foi ajudado. Combine a resolução com um sinal de ativação vindo do produto.
Como montar o scorecard, passo a passo
- Defina por escrito um contato e uma resolução. Uma frase para cada. Contato = um problema do cliente, não um evento do sistema. Resolução = resposta correta ou tarefa concluída, sem resposta humana e sem recontato dentro da janela.
- Escolha os denominadores. Decida se você divide por todas as conversas da IA, pelas conversas tentadas ou pelas conversas dentro do escopo. Coloque a escolha em uma nota de rodapé em todo relatório.
- Etiquete cada conversa com um motivo de contato. Sem etiquetas de assunto, você não consegue segmentar, e uma média geral esconde os assuntos em que a IA falha.
- Monte a checagem de recontato. Cruze ID do cliente e assunto entre chat, e-mail e telefone. É a adição de maior valor.
- Configure a revisão por amostragem. Um revisor lê toda semana um conjunto aleatório de conversas "resolvidas" e as classifica como certas, parcialmente certas ou erradas. Envie as erradas ao seu processo de garantia de qualidade.
- Separe CSAT e esforço por quem atendeu. Só IA, só humano e IA e depois humano são três populações diferentes.
- Calcule o custo dos dois jeitos. Custo por contato e custo por problema resolvido, lado a lado, todo mês.
- Defina limites por assunto, não globais. Uma meta única empurra a IA para assuntos em que ela não deveria tocar, como reembolsos, questões jurídicas e de segurança.
- Revise as definições a cada trimestre. Novos canais, novas ações da ferramenta e mudanças nas regras do fornecedor alteram o que conta.
Para a sequência de implantação, incluindo quais métricas medir como linha de base antes do lançamento, veja implantar a IA no atendimento ao cliente.
Um modelo de scorecard que você pode copiar
Preencha as colunas de meta e responsável com os seus próprios números. A coluna "Sinal de alerta" é o padrão que indica que a métrica está sendo manipulada ou mal interpretada.
| Métrica | Periodicidade | Responsável | Meta (a sua) | Sinal de alerta |
|---|---|---|---|---|
| Taxa de contenção | Semanal | Operações de suporte | Definida por assunto | Sobe enquanto o CSAT cai |
| Taxa de resolução verificada | Semanal | Operações de suporte | Definida por assunto | Distância para a contenção aumentando |
| Taxa de reabertura / recontato | Semanal | Operações de suporte | Abaixo da sua linha de base | Mesmo cliente, novo canal |
| CSAT (IA) versus CSAT (humano) | Semanal | Líder de suporte | IA dentro da faixa do humano | Baixa taxa de resposta na IA |
| Esforço do cliente | Mensal | Líder de suporte | Por assunto | Muitas mensagens por resolução |
| Qualidade da transferência | Amostra semanal | QA | A maioria das transferências limpas | Clientes se repetindo |
| Custo por contato | Mensal | Finanças + suporte | Tendência, não promessa | Cai sem mudança na resolução |
| Custo por problema resolvido | Mensal | Finanças + suporte | Tendência, não promessa | Diverge para cima do custo por contato |
| Tempo de atendimento por motivo | Mensal | Líder de suporte | Por motivo | Cai enquanto a taxa de reabertura sobe |
| Taxa de escalonamento (planejado versus por falha) | Semanal | Operações de suporte | Parcela de falhas em queda | Perto de zero sem saída visível |
| Taxa de lacunas de conhecimento | Semanal | Responsável pelo conhecimento | Em queda | Maior lacuna inalterada por um mês |
Armadilhas a evitar
Comemorar apenas a contenção. É a métrica com maior chance de parecer boa enquanto os clientes sofrem. Nunca a mostre sem a resolução verificada ao lado.
Misturar o CSAT da IA e o do humano. A mistura esconde o lado que está com dificuldade. Separe-os.
Deixar o denominador derivar. Passar de "todas as conversas" para "conversas dentro do escopo" num trimestre posterior eleva todas as taxas sem nenhuma melhora real.
Otimizar o tempo de atendimento por si só. Quando a IA fica com o trabalho fácil, os contatos humanos restantes são mais longos. Julgue a equipe pela resolução e pela satisfação por motivo de contato.
Contar contatos, não problemas. O custo por contato premia dividir um problema em vários toques. Use o custo por problema resolvido como verificação.
Confiar no dashboard do fornecedor como a verdade inteira. As plataformas definem resolução de modo diferente, então compare a sua própria tendência sob uma única definição fixa. Mantenha uma amostra manual, já que um modelo avaliando outro modelo pode compartilhar seus pontos cegos.
Ignorar o risco. As métricas descrevem qualidade, não dano. Uma promessa de reembolso errada pode passar por todos os dashboards. Leia os riscos do atendimento ao cliente com IA junto com o scorecard e acrescente uma contagem de incidentes sinalizados.
Perguntas frequentes sobre métricas de atendimento com IA
Quais são as métricas de atendimento com IA mais importantes?
Comece por cinco: contenção, resolução verificada, taxa de reabertura ou de recontato, CSAT separado entre IA e humano e custo por problema resolvido. Juntas, elas mostram se a IA evitou um humano, resolveu o problema, se sustentou depois, satisfez o cliente e custou menos do que a alternativa.
Como calculo a taxa de contenção?
Divida o número de conversas da IA que nunca envolveram um humano pelo total de conversas da IA. Depois, subtraia as conversas seguidas de recontato sobre o mesmo problema para obter a taxa de resolução verificada. A contenção sozinha não diz se o cliente foi ajudado.
Qual é a diferença entre custo por contato e custo por resolução?
O custo por contato divide o custo total de suporte pelos contatos atendidos, então dividir um problema em vários toques o reduz. O custo por problema resolvido divide pelos problemas efetivamente solucionados, então não pode ser reduzido assim. Acompanhe os dois e investigue quando se afastarem.
O CSAT da IA e o do humano devem ser reportados separadamente?
Sim. São populações diferentes, com padrões de resposta diferentes, e uma nota misturada esconde o lado mais fraco. Mostre a taxa de resposta ao lado de cada nota, porque uma nota alta com pouquíssimas respostas diz pouco sobre os clientes que ficaram em silêncio.
Com que frequência devo revisar essas métricas?
Revise as métricas de resultado e de cobertura toda semana, já que são as que mudam mais rápido e orientam as correções de conteúdo. Revise custo, esforço e tempo de atendimento todo mês. Revisite as definições a cada trimestre ou sempre que acrescentar um canal, der novas ações à IA ou mudar configurações do fornecedor.
O que é a taxa de lacunas de conhecimento?
É a parcela das perguntas dos clientes que a IA não soube responder com confiança com base nas fontes conectadas. Ordene as perguntas sem resposta por volume e corrija a maior lacuna a cada semana, escrevendo ou atualizando o artigo correspondente. Uma taxa de lacunas em queda é o primeiro sinal de que a resolução nesse assunto está prestes a melhorar.

Customer Success Operations Manager
On this page
- Fatos Principais
- O scorecard num relance
- Métricas de resultado: o problema desapareceu?
- Um exemplo prático (hipotético)
- Métricas de experiência: como foi?
- Métricas de eficiência: quanto custou e o que liberou?
- Métricas de cobertura: onde a IA para?
- Exemplos reais por função
- Como montar o scorecard, passo a passo
- Um modelo de scorecard que você pode copiar
- Armadilhas a evitar