AIによるCSAT予測:アンケートなしですべての会話をスコアリング
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
予測CSATとは、顧客がアンケートに回答するのを待つ代わりに、会話とそのメタデータを読み取るモデルが、サポートの会話に対する顧客の満足度を推定したものです。 出力は通常、スコア(アンケートの尺度に合わせて1〜5が多い)か、顧客がそのやり取りを良いと評価した確率です。顧客が回答する必要がないため、ほぼすべての会話をカバーできます。
このカバー範囲こそが最大の売りであり、同時に落とし穴でもあります。アンケートは、顧客が何と言ったかを教えてくれます。予測は、過去の会話のパターンに基づいて、顧客が何と言っただろうとモデルが推測した内容を教えてくれます。この2つは別物であり、両者の間のギャップでチームは苦労することになります。このガイドでは、予測CSATとセンチメントスコアリングの仕組み、アンケートCSATとの比較、そして予測スコアが意思決定を左右する前に、実際のアンケート結果と照らして確認する方法を解説します。AI for Customer Serviceコレクションの一部ですので、全体像はカスタマーサービスにおけるAIの概要をご覧ください。
最初に1つ、線引きをしておきます。担当者が会話をどれだけうまく扱ったかを評価基準に照らして採点するのは別の仕事で、AIによるサポートの品質保証で扱っています。この記事が扱うのは顧客の結果です。顧客は満足したのか、そして尋ねずにそれをどう知るのか、という点です。
重要なポイント
- IntercomのCX Scoreは、アンケートCSATに代わるAI生成の指標で、名前の付いた一連の理由を独立して評価し、中立でないものを組み合わせて、クローズした会話を1〜5で評価します。電話の会話はスコアリングされません(Intercom)。
- Intercomは、アンケートCSATについて、自ら回答する小さな集団からのフィードバックを集めるものであり、極端な意見が過剰に反映されることが多いと説明しています(ベンダーの見解)(Intercom)。
- 顧客満足度のモデリングに関する学術研究は、アンケートの回答率が非常に低いと述べ、無回答者は通常、顧客基盤の大半を占めるため、無視すると推定にバイアスが生じうると指摘しています(Toronto Metropolitan University)。
- Zendeskは2016年にSatisfaction Predictionを発表した際、モデルがテキストの説明、返信数、合計待ち時間を含む数百のシグナルを読み取ること、そして月に500件以上の満足度評価を受け取るEnterpriseアカウントで利用できることを説明していました(Zendesk)。
- LLMを審査役とする研究では、強力なモデルが人間の好みと80%を超える一致率に達しうること(人間同士が一致する水準と同じ)が示された一方で、位置、冗長さ、自己強化のバイアスも確認されました(Zhengら、2023年)。
- 十分にキャリブレーションされたモデルとは、スコアが0.8付近のケースのうち、実際に約80%が良い結果になるモデルのことです(scikit-learnのドキュメント)。
アンケートCSATだけでは足りない理由
アンケートCSATは単純です。会話がクローズした後に1問の評価依頼を送り、良い評価の割合を報告します。低コストで、顧客にも分かりやすい方法です。しかし、アンケートの設計をどれだけ工夫しても完全には解消できない、3つの構造的な弱点があります。
カバー範囲。 回答した顧客だけがカウントされます。回答率はチャネル、対象者、アンケートの設計によって異なり、上で紹介した研究は非常に低いとしています。週に何千件もの会話を扱うサポートでは、そのごく一部をもとに、人員配置や製品に関する判断を下している可能性があります。
自己選択バイアス。 回答する人は無作為なサンプルではありません。非常に満足している顧客と非常に不満な顧客は答え、大きな中間層は肩をすくめて立ち去ります。物言わぬ多数派、たとえば少し苛立ちを覚え、1か月後に黙って解約した顧客は、ほとんど見えません。上で引用した研究者も同じ点を指摘しています。無回答者のほうが大きな集団である傾向があり、除外すると結果が歪みかねないということです。
タイミングとチャネルの隙間。 クローズしたメールのスレッドの後に送るアンケートは、放棄されたチャットや、返信されないままのチケットについて何も教えてくれません。アンケートには遅れもあります。悪い週のことを、翌週になって知ることになります。
予測CSATは、1つ目と3つ目の問題に直接対処します。会話がクローズした瞬間(あるいはまだ進行中の間)にスコアリングでき、回答に依存しません。ただし、バイアスを自動的に解消するわけではありません。アンケートの回答で学習したモデルは、アンケートの偏りを引き継ぎます。この記事の残りを通して、これが最も心に留めておくべき点です。
予測CSATの仕組み
大きく分けて2つのアプローチがあり、多くの製品は両者を組み合わせています。
アプローチ1:自社のアンケート履歴で学習させた教師ありモデル
過去の会話のうち、アンケートの回答があったものを取り出し、評価をラベルとして扱い、会話の特徴量から予測するモデルを学習させます。Zendeskの2016年のローンチは、この設計の分かりやすい例です。モデルはチケットのテキスト、返信数、合計待ち時間などのシグナルを使い、学習の元になるラベル付きの履歴が十分にあるよう、製品には月ごとの評価件数の下限が設けられていました(Zendesk)。この件数の要件は、重要な注意点を思い出させてくれます。教師あり予測には、学習に使える実際のアンケート回答が大量に必要であり、置き換えようとしているデータそのものに、ひそかに依存しているのです。
代表的な特徴量は次のとおりです。
- テキストのシグナル: 顧客の言葉遣い、メッセージごとの感情の変化、「まだ動きません」「3回目のお願いです」といった表現。
- 手間のシグナル: 返信数、担当の付け替え、担当者間の引き継ぎ、顧客が同じ説明を繰り返した回数。
- 時間のシグナル: 初回応答時間、合計待ち時間、返信の間隔。
- コンテキスト: チャネル、トピック、顧客のティア、再問い合わせかどうか。
アプローチ2:定義された要因に照らして会話を読む言語モデル
新しい製品は、言語モデルを使って会話の全文を読み、名前の付いた要因に照らして判断し、それを集約してスコアにします。IntercomのCX Scoreはこの方式です。特定の理由(回答の品質、顧客の手間、強い感情、製品またはサービスへのフィードバック、ポリシーへのフィードバック)を評価し、強いシグナルがなければその理由を中立として扱い、中立でない理由の組み合わせから1〜5の評価を導きます。特定の理由を他より重く扱う隠れた重み付けはありません(Intercom)。対象は、メッセンジャーまたはメールでクローズした会話のみで、ここから実践的なことが分かります。予測CSATの製品には必ず適用範囲の制限があり、自社の場合の範囲を把握しておく必要があります。
数値よりも、理由のほうが重要です。「3.2、顧客の手間の大きさとポリシーへの苦情が要因」という説明なら、何を直すべきかが分かります。
センチメントスコアリングの位置付け
感情分析は、このほとんどの土台となる要素です。テキストの感情的なトーンを、メッセージごとにラベル付けします。予測CSATはさらに一歩進み、トーンを手間、結果、コンテキストと組み合わせて、やり取りに対する全体的な評価を推定します。会話は、怒りで始まり、満足で終わることがあります(顧客は憤慨し、担当者が解決し、顧客がお礼を言った場合など)。メッセージ単位の感情分析は、その両方の半分を捉えます。優れたCSAT予測は、結末をより重く見ます。
アンケートCSATと予測CSATの比較
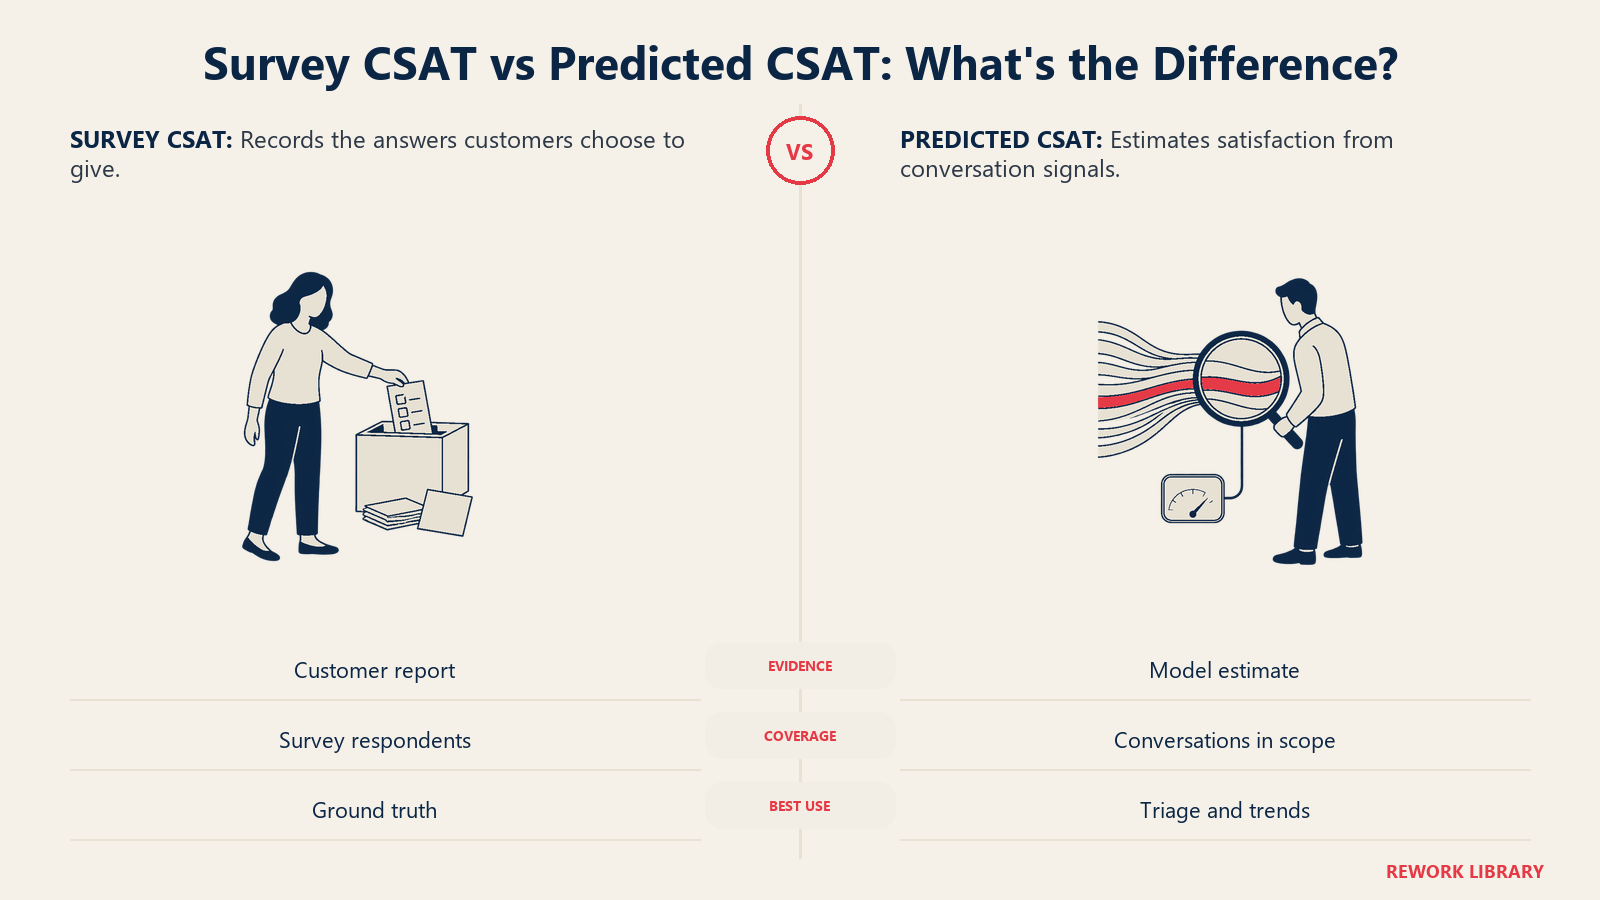
| 観点 | アンケートCSAT | 予測CSAT |
|---|---|---|
| 測定するもの | 顧客が感じたと答えた内容 | 顧客が答えただろう内容についてのモデルの推定 |
| カバー範囲 | 回答した顧客のみ | 対象範囲内のほぼすべての会話 |
| 主なバイアス | 自己選択、極端な意見が過剰に反映される | 学習データから引き継ぐバイアスに加え、モデルの盲点 |
| 速度 | アンケートに回答された後 | 会話のクローズ時、またはその直後 |
| 「なぜ」の説明 | 自由記述のコメントがある場合のみ | 理由と引用を添えられる |
| 向いている用途 | グラウンドトゥルース(正解データ)、報告、ベンチマーク | トリアージ、トレンドの発見、見えない問題の発見 |
| 苦手なこと | 物言わぬ多数派、放棄された会話 | 皮肉、モデルに見えないコンテキスト、新しいトピック |
ここから得られる結論は、「アンケートを置き換える」ことではありません。両者の誤差は互いに補い合う関係にある、ということです。アンケートは範囲が狭い代わりに本物であり、予測は範囲が広い代わりにモデルによるものです。併用すれば、アンケートが予測を正直に保つグラウンドトゥルースとなり、予測がその真実を、誰も評価していない会話にまで広げてくれます。
職種別の実例
カスタマーサポートのリーダー。 サポート責任者は、アンケートCSATが1四半期にわたって同じ水準で横ばいになっているのを目にします。すべての会話に対して動いている予測スコアは、あるトピック(たとえば請求の変更)に限って大きく下がります。その顧客のうち回答した人が少なかったため、アンケートは見逃していました。責任者はそれらの会話のサンプルを人間のレビュアーに回し、根本原因を突き止めます。
プロダクトとエンジニアリング。 トピックと理由で分解したスコアは、顧客を苛立たせている事柄の順位付きリストになります。AIによるチケット要約と組み合わせれば、プロダクトチームは表計算シートではなく、スコアの低いクラスターごとに引用付きの短い説明を得られます。
カスタマーサクセス。 重要なアカウントの直近のチケットで予測CSATが低い場合、アンケートでは浮かび上がらなかった早期の警告となります。ヘルススコアやチャーンを予測するサポートのシグナルの入力のひとつであり、それだけを頼りにしてはいけません。
サポートオペレーションとQA。 予測CSATは、どの会話を人間が読むべきかを決めます。これはトリアージのシグナルです。スコアの低い会話はレビューに回され、レビューの結果がモデルのチェックにフィードバックされます。個々の担当者を採点するために使うべきではありません(それについては、上でリンクしたQAの記事を参照してください)。
プロアクティブなサポート。 会話がまだ進行中のうちに否定的な方向へ傾いていれば、スーパーバイザーはクローズする前に介入できます。
予測スコアをアンケート結果と照らして検証する方法
多くのチームが飛ばしてしまうステップですが、この数値を使う価値があるかどうかを決めるのはここです。原則は、手元にある実際のアンケート回答は、ラベル付きの例だということです。一部を取り分け、学習には決して使わず、モデルをそれに対してテストします。
ステップ1:ホールドアウトセットを作る
直近の期間でアンケートに回答のあった会話を取り出し、別にしておきます。ベンダーが自社の履歴で学習させた場合は、学習にどの期間を使ったのかを尋ね、テストセットがその後のものであることを確認します。学習に使った会話でテストしたモデルは、実力以上に良く見えます。
ステップ2:会話単位で比較する
ホールドアウトの各会話について、予測スコアと実際のアンケート評価を並べます。まず、次のチェックから始めます。
| チェック | 分かること | 見るべき点 |
|---|---|---|
| 順位の一致 | モデルは、顧客と同じ順序で会話を並べているか | 予測スコアが高いほど、アンケート評価も高くなるはず |
| 良い評価と悪い評価の分類 | 満足した顧客と不満な顧客を分けられるか | ROC AUCを使う。2つの集団をスコアがどれだけ分けているかを1つの数値でまとめたもの(scikit-learn) |
| キャリブレーション | 確率が示すとおりの意味を持っているか | スコアが0.8付近の会話のうち、約80%が良い評価になるはず(scikit-learn) |
| セグメント別の誤差 | どこでも同じ精度か | チャネル、言語、トピック、顧客のティア別に結果を分解する |
キャリブレーションは、もう少し詳しく見る価値があります。予測確率を、各区間における実際の良い評価の割合に対してプロットします(信頼性図)。線が対角線に近ければ、スコアは本物の確率のように振る舞っています。そうでなければ、順位付けにはモデルを使えますが、「0.8」を顧客が満足している確率80%と読んではいけません。
ステップ3:集計レベルで比較する
顧客は、1件の会話のスコアで行動を起こすわけではありません。リーダーが読むのは、チーム、トピック、週ごとの平均です。そこで、あるグループの予測CSATの平均が、同じグループのアンケートCSATの平均と、時間を通じて連動しているかも確認します。モデルは会話ごとにはノイズがあっても、集計では真実を語ることがあり、その逆もあります。実際に使うレベルでテストしてください。
ステップ4:アンケートでは見えない部分を確認する
難しい問いは、アンケートが一度も届かなかった会話についてモデルが正しいかどうかです。これを直接テストすることはできませんが、探ることはできます。アンケートを送っていない会話から無作為にサンプルを抽出し、2人のレビュアーに予測スコアを伏せたまま読んでもらい、比較します。レビュアー同士の意見がかなり食い違うなら、それがどのモデルにとっても上限です。LLMを審査役とする研究では、強力なモデルは人間同士の一致率に並びうることが分かっており、これは完璧ではなく、現実的な目標といえます(Zhengら、2023年)。また、アンケートを送っていないスコアの低い数件のケースでは、短いアウトリーチのメッセージを送り、顧客が実際にどう感じたのかを確認します。
ステップ5:ドリフトに注意する
製品、ポリシー、言語構成が変わると、一致度は低下します。ホールドアウトの比較は毎月、また大きな変更があるたびにやり直してください。
既知のバイアスと盲点
学習データの偏り。 教師ありモデルは、回答者から学習します。アンケート履歴で極端な顧客が多数を占めていれば、モデルは極端な顧客がどんな話し方をするかを学び、物言わぬ中間層をうまく扱えないかもしれません。この問題に取り組む研究者は、無回答者のデータを無視せず、モデリングに取り入れるべきだと主張しています(Toronto Metropolitan University)。
中身より体裁。 言語モデルの審査役は、より長くて洗練された回答を好むことがあり、これは冗長さのバイアスとして記録されています(Zhengら、2023年)。サポートでは、言葉数が多く謝罪の多いやり取りが、問題を解決した短いやり取りより満足度が高く見えることがあります。結果を考慮に入れた上で、予測CSATがメッセージの長さに連動していないかを確認してください。
結果への盲目。 満足度は、問題が実際に解決したかどうかに大きく左右されます。会話だけを見るモデルには、返金が届かなかったことが分からないかもしれません。可能な限り解決データを与え、解決率は別のチェックとして扱ってください。
言語と文化。 丁寧さの規範、皮肉、評価の付け方は地域によって異なります。英語のチケットで検証したモデルは、ポルトガル語のチケットについてほとんど何も教えてくれません。言語ごとに検証してください。
AI対応の隙間。 ボットが対応した会話と人間が対応した会話は、振る舞いが異なることがあります。顧客は異なる基準で評価する可能性があり、モデルの精度も両者で異なりえます。1つの結果が両方を網羅すると考えず、2つのグループを別々に検証してください。
予測CSATの導入手順
- 支えたい判断に名前を付ける。 トリアージ、トレンドの報告、アカウントのアラート、担当者のコーチングでは、必要な精度がそれぞれ異なります。最も許容範囲の広いトリアージから始めてください。
- まずデータを整える。 整理されたチケットのテキスト、一貫したチャネルとトピックのタグ、解決の結果があると、予測の質が上がります。サポートデータのAI向け準備を参照してください。
- アンケートを続ける。 それがグラウンドトゥルースです。「アンケートを節約する」ために減らすと、モデルを検証する唯一の手段がなくなります。
- シャドーモードで運用する。 数週間、リーダーや担当者に見せずに会話をスコアリングし、届いたアンケート結果と比較します。
- 上の5つのステップで検証し、見つかった精度をセグメント別に書き留めます。
- その数値が何であるかを公開する。 すべてのダッシュボードで、アンケートCSATの隣に「予測」と明記し、黙って混ぜ合わせることはしません。
- スコアだけでなく理由も加える。 どの要因が低スコアをもたらしたのかを、引用箇所とともにシステムに表示させます。
- それをもとにルーティングする。 予測が低い会話は人間のキューに送り、高い会話はサンプリングして偽りの安心を見つけます。
- 四半期ごとに見直す。 ホールドアウトテストをやり直し、セグメント間の差を確認し、モデルが支えられない用途は廃止します。
よくある落とし穴
予測を測定値として扱う。 それは推定です。予測CSATとアンケートCSATを同じ指標として表示するダッシュボードは、両者が初めて乖離したときに、人々を誤解させます。
アンケートをやめる。 新しいアンケート回答がなければ検証できず、モデルは顧客が実際に感じていることから、少しずつずれていきます。
人の採点に使う。 予測CSATは、担当者のスキルと同じくらい、顧客の状況を反映します。請求トラブルは、パスワードのリセットよりスコアが低くなります。予測スコアの生の値で担当者を比較すると、難しいキューを担当した人が不利になります。
セグメントを無視する。 全体の数値は問題なさそうに見えても、特定のチャネルや言語が静かに誤っていることがあります。必ずセグメント別に切り分けてください。

Customer Success Operations Manager