Privacidade de dados do cliente no suporte com IA: PII, redação e retenção
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
A privacidade de dados do cliente no suporte com IA é o conjunto de controles que decide quais dados pessoais um sistema de IA enxerga, por quanto tempo alguém os guarda, para onde eles vão e quem pode lê-los. Na prática, são seis coisas: mascarar dados pessoais antes que cheguem a um modelo ou a um log, definir um período de retenção e fazê-lo valer, manter os dados de cartão de pagamento totalmente fora dos chats, ler os termos de dados do fornecedor, escolher onde os dados ficam armazenados e limitar quem pode abrir as transcrições.
O suporte é onde a privacidade falha em silêncio. Os clientes colam números de conta e detalhes médicos na caixa de chat porque você perguntou como podia ajudar e, com uma camada de IA, cada mensagem pode parar em um prompt, em um log do provedor, em um conjunto de dados de QA e em um campo de resumo. Este guia é para líderes de suporte que precisam responder "para onde vão os dados?" sem ter um diploma de direito. Não é aconselhamento jurídico, então peça a um especialista em privacidade que confirme o que se aplica às suas regiões. Ele se apoia em preparando os dados de suporte para a IA, que trata da limpeza dos dados. Aqui o foco é protegê-los.
Fatos Principais
- O Artigo 5(1)(c) do GDPR exige que os dados pessoais sejam "adequados, relevantes e limitados ao que é necessário" para as finalidades do tratamento, e o Artigo 5(1)(e) diz que eles podem ser mantidos em formato identificável "apenas durante o período necessário" (GDPR, EUR-Lex).
- O PCI DSS não permite que códigos de verificação de cartão sejam mantidos depois que uma transação é autorizada, mesmo criptografados e mesmo que o cliente concorde (FAQ 1280 do PCI SSC).
- Pelo Artigo 28(3) do GDPR, um operador só pode agir segundo instruções documentadas do controlador e, à escolha do controlador, deve apagar ou devolver os dados pessoais quando o serviço termina (GDPR, EUR-Lex).
- A OpenAI afirma que os dados enviados à sua API não são usados para treinar seus modelos, a menos que o cliente opte por isso, e que os logs de monitoramento de abuso são mantidos por até 30 dias por padrão (OpenAI).
- A biblioteca de código aberto Presidio, da Microsoft, alerta que a detecção automatizada não garante encontrar todas as informações sensíveis (Presidio).
- A FTC diz que pode ser desleal ou enganoso reescrever termos em silêncio para permitir o treinamento de IA com dados coletados sob promessas anteriores (FTC).
Onde os dados do cliente ficam em uma pilha de suporte com IA
Antes de escolher os controles, mapeie os lugares onde os dados realmente ficam. Uma configuração típica de suporte com IA tem mais cópias do que as pessoas esperam.
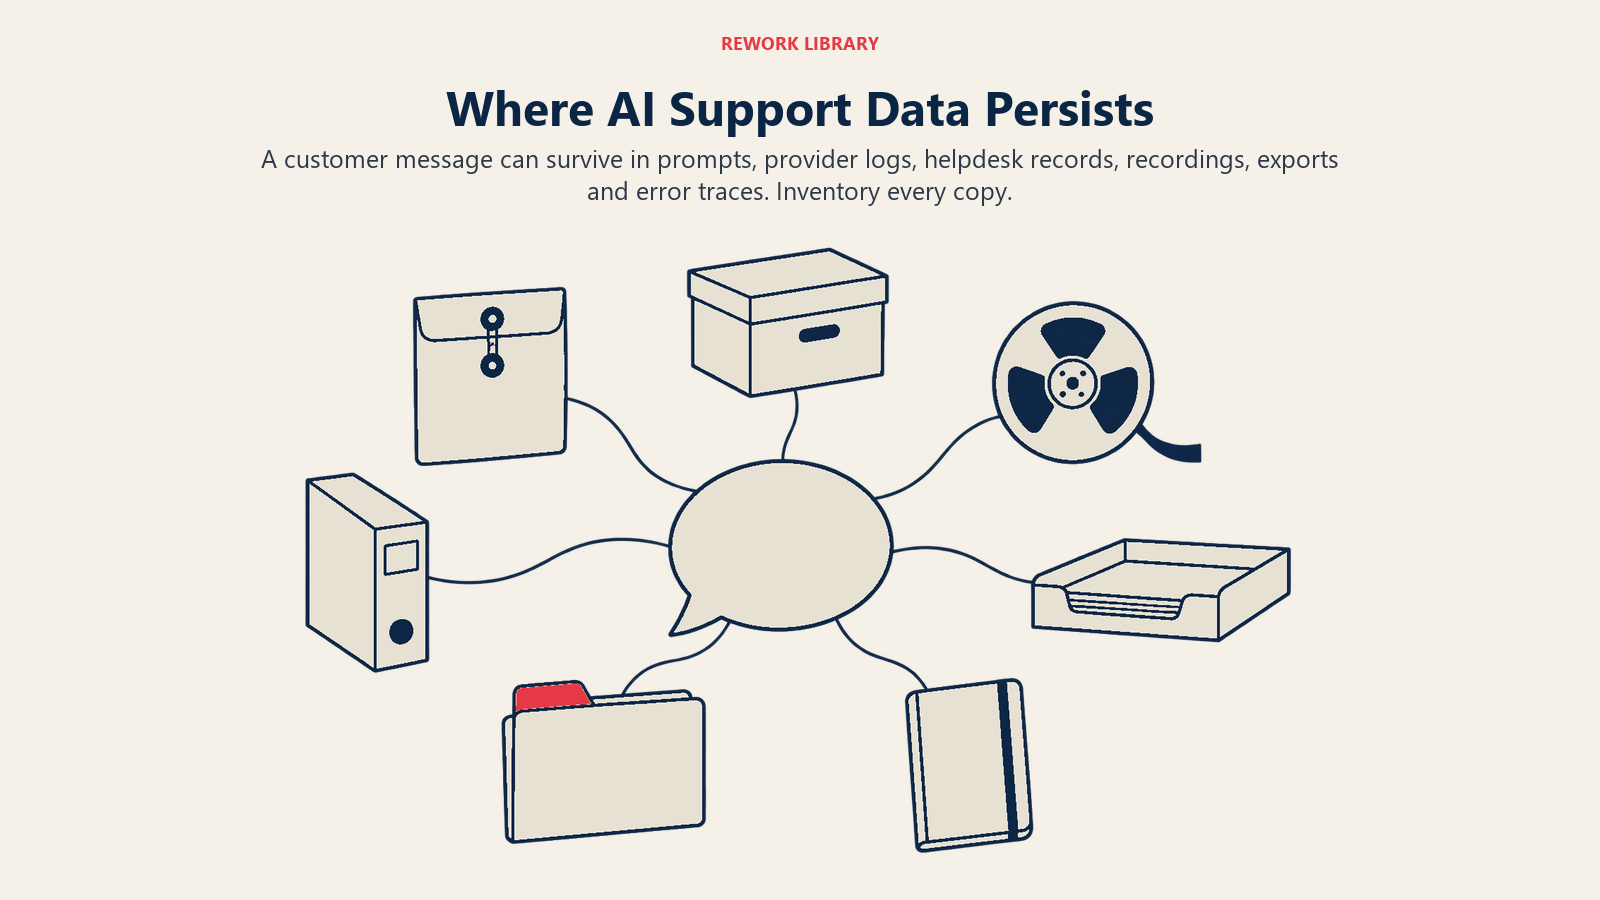
| Local | O que há nele | Quem costuma esquecê-lo |
|---|---|---|
| Conversa ao vivo | Tudo o que o cliente digita, inclusive coisas que você nunca pediu | Ninguém, é o caso óbvio |
| Prompt enviado ao modelo | A mensagem do cliente mais quaisquer campos da conta que você acrescenta como contexto | Equipes que passam o registro inteiro do cliente |
| Logs do provedor do modelo | Prompts e saídas, mantidos para monitoramento ou depuração | Qualquer pessoa que não leu os termos de retenção do provedor |
| Transcrição e ticket do helpdesk | Texto completo, anexos, resumos escritos pela IA | Administradores que definiram o período de retenção uma vez e nunca o revisitaram |
| Gravações de chamadas e transcrições de voz | Números de cartão, nomes e endereços falados | Equipes que adicionaram IA de voz depois do lançamento do chat |
| Análises, QA e conjuntos de treinamento | Amostras exportadas para revisão de qualidade ou ajuste | Quem montou a planilha |
| Logs de aplicação e rastros de erro | Cargas brutas quando algo falha | Engenheiros, em geral |
Se um pedido de privacidade ou uma auditoria chegar à sua mesa, você precisa conseguir listar cada linha da sua própria configuração.
Exemplos por canal
O risco é diferente em cada canal, e é por isso que IA nos canais de suporte merece uma revisão de privacidade própria.
Chat. Uma pessoa que pergunta sobre um pagamento recusado costuma colar o número completo do cartão. Mascare sequências de dígitos que pareçam números de cartão antes que a mensagem seja armazenada ou enviada a um modelo.
E-mail. Os encadeamentos carregam assinaturas, histórico encaminhado e anexos, como documentos de identidade escaneados. Remova o histórico citado e o texto dos anexos, a menos que a tarefa precise deles.
Voz. Os dados falados são os mais difíceis de limpar. O PCI SSC trata disso diretamente: códigos de validação de cartão capturados em gravações de áudio digitais após a autorização violam a regra de armazenamento, deve-se fazer todo esforço para impedir que os dados sejam gravados e, onde a gravação não puder ser impedida, os dados devem ser apagados com segurança imediatamente após a autorização (FAQ 1210 do PCI SSC).
Agent assist interno. Até uma ferramenta que apenas sugere respostas aos seus próprios agentes vê a conversa inteira. O agent assist precisa das mesmas regras de mascaramento e retenção de um bot voltado ao cliente.
Os seis controles
| Controle | O que protege | Como implementar | Norma ou lei |
|---|---|---|---|
| Mascaramento de PII | Nomes, e-mails, documentos e números de cartão em prompts, transcrições e logs | Detectar e mascarar antes de enviar ao modelo e antes de gravar logs; revisar uma amostra para achar falhas | GDPR Art. 5(1)(c), minimização de dados; PCI DSS para dados de cartão |
| Retenção e exclusão | Conversas antigas que já não têm finalidade | Um cronograma escrito por tipo de dado; exclusão automatizada no helpdesk, nos logs e nas exportações | GDPR Art. 5(1)(e), Art. 17 |
| Tratamento de dados de cartão | Números de cartão e códigos de verificação | Nunca pedir dados de cartão no chat; encaminhar a uma página de pagamento ou a um fluxo tokenizado; mascarar se forem digitados | PCI DSS; FAQs 1280, 1210, 1533 do PCI SSC |
| Termos do fornecedor e DPA | Dados nas mãos dos provedores | Confirmar que não há treinamento com os seus dados, a janela de retenção, a exclusão na saída e os suboperadores | GDPR Art. 28(3) |
| Residência dos dados | Onde os dados são armazenados e processados | Escolher a região na configuração do fornecedor; verificar os caminhos de acesso do suporte | GDPR Capítulo V (Art. 44 em diante) |
| Controle de acesso | Quem pode ler as transcrições | Acesso baseado em função, privilégio mínimo, acesso registrado, remoção rápida de quem sai | GDPR Art. 32 (segurança do tratamento) |
As seções a seguir tratam cada um deles na ordem em que você os implementaria.
Mascaramento: PII em transcrições, prompts e logs
O Artigo 5(1)(c) do GDPR é o princípio por trás do mascaramento: os dados pessoais devem ser "adequados, relevantes e limitados ao que é necessário" para as finalidades para as quais são tratados (GDPR, EUR-Lex). Para um assistente de IA, isso se traduz em uma regra de projeto. Envie ao modelo o mínimo de que ele precisa para esta única conversa. Um pedido de redefinição de senha precisa do status da conta, não do histórico de cobrança. Veja personalizando o atendimento com IA para mais sobre o raciocínio do GDPR.
O mascaramento pode ocorrer em três pontos, e em geral você quer os três:
- Antes do modelo. Detecte dados pessoais na mensagem recebida e substitua-os por marcadores como
[EMAIL]ou[CARD_NUMBER]. O modelo ainda pode responder "encontrei a conta vinculada a esse e-mail" sem nunca guardar o endereço real. Se a resposta final precisar do valor real, o seu sistema pode reinseri-lo depois que o modelo responder. - Antes do armazenamento. Aplique o mesmo mascaramento antes que a transcrição seja gravada no helpdesk, no pipeline de logs ou em uma tabela de análises, para que o valor bruto nunca chegue a lugar nenhum duradouro.
- Antes da reutilização. Quando você exportar conversas para QA, coaching ou ajuste, mascare de novo. O kit de ferramentas de IA do ICO sugere usar informações sintéticas ou anonimizadas para treinar um modelo sempre que possível (ICO).
Um alerta sobre as ferramentas: o Presidio, o kit de detecção de código aberto da Microsoft, diz que não há garantia de que encontre todas as informações sensíveis, porque a detecção é automatizada (Presidio). A correspondência de padrões lida bem com números de cartão e e-mails, e mal com nomes dentro de frases ou descrições de doenças. Faça uma amostragem das transcrições mascaradas toda semana e procure falhas.
Logs de depuração, rastreadores de erros e gravações de sessão do widget de chat também guardam texto bruto, então verifique-os separadamente.
Retenção e exclusão
O Artigo 5(1)(e) do GDPR diz que os dados pessoais podem ser mantidos em formato identificável apenas pelo tempo necessário para as finalidades para as quais foram tratados (GDPR, EUR-Lex). Os considerandos acrescentam que os controladores devem fixar prazos para o apagamento ou para a revisão periódica. Os clientes também têm, nos termos do Artigo 17(1), "o direito de obter do controlador o apagamento dos dados pessoais que lhe digam respeito" nas circunstâncias que o artigo lista.
Você não precisa de uma análise jurídica perfeita para começar. Precisa de um cronograma que tenha um responsável:
- Decida a finalidade de cada tipo de dado. Transcrições, gravações, resumos de IA, amostras de QA e logs do provedor existem por um motivo. Escreva-o ao lado do período de retenção.
- Defina períodos que combinem com o motivo. Disputas de garantia e de cobrança podem justificar guardar um ticket por muito tempo. Um chat em que alguém perguntou o horário de funcionamento, não. Os seus times jurídico e financeiro costumam definir os limites externos, já que as leis de guarda de registros variam.
- Apague também os subprodutos da IA. Resumos, pontuações de sentimento, entidades extraídas e embeddings criados a partir de uma conversa são dados derivados sobre a mesma pessoa. Uma exclusão que remove o ticket mas deixa o resumo da IA não apagou grande coisa.
- Automatize. Um cronograma que depende de alguém se lembrar vai falhar. Use as configurações de retenção do helpdesk e as regras de ciclo de vida do armazenamento na sua conta de nuvem.
- Registre as exceções. O kit de ferramentas de IA do ICO pede um cronograma de retenção documentado, a exclusão das informações pessoais mantidas em sistemas de IA de acordo com ele e uma justificativa em DPIA para qualquer retenção além disso (ICO).
Os backups são a armadilha de sempre. Diga na sua política por quanto tempo os dados apagados sobrevivem ali e pergunte o mesmo aos fornecedores.
Dados de cartão de pagamento: mantenha-os fora do chat e dos logs de IA
Os dados de cartão são a única área com uma regra rígida do setor, e as equipes de suporte a violam por acidente mais do que qualquer outra. A distinção central no PCI DSS é entre o número do cartão (PAN) e os dados sensíveis de autenticação, como o código de segurança impresso no cartão.
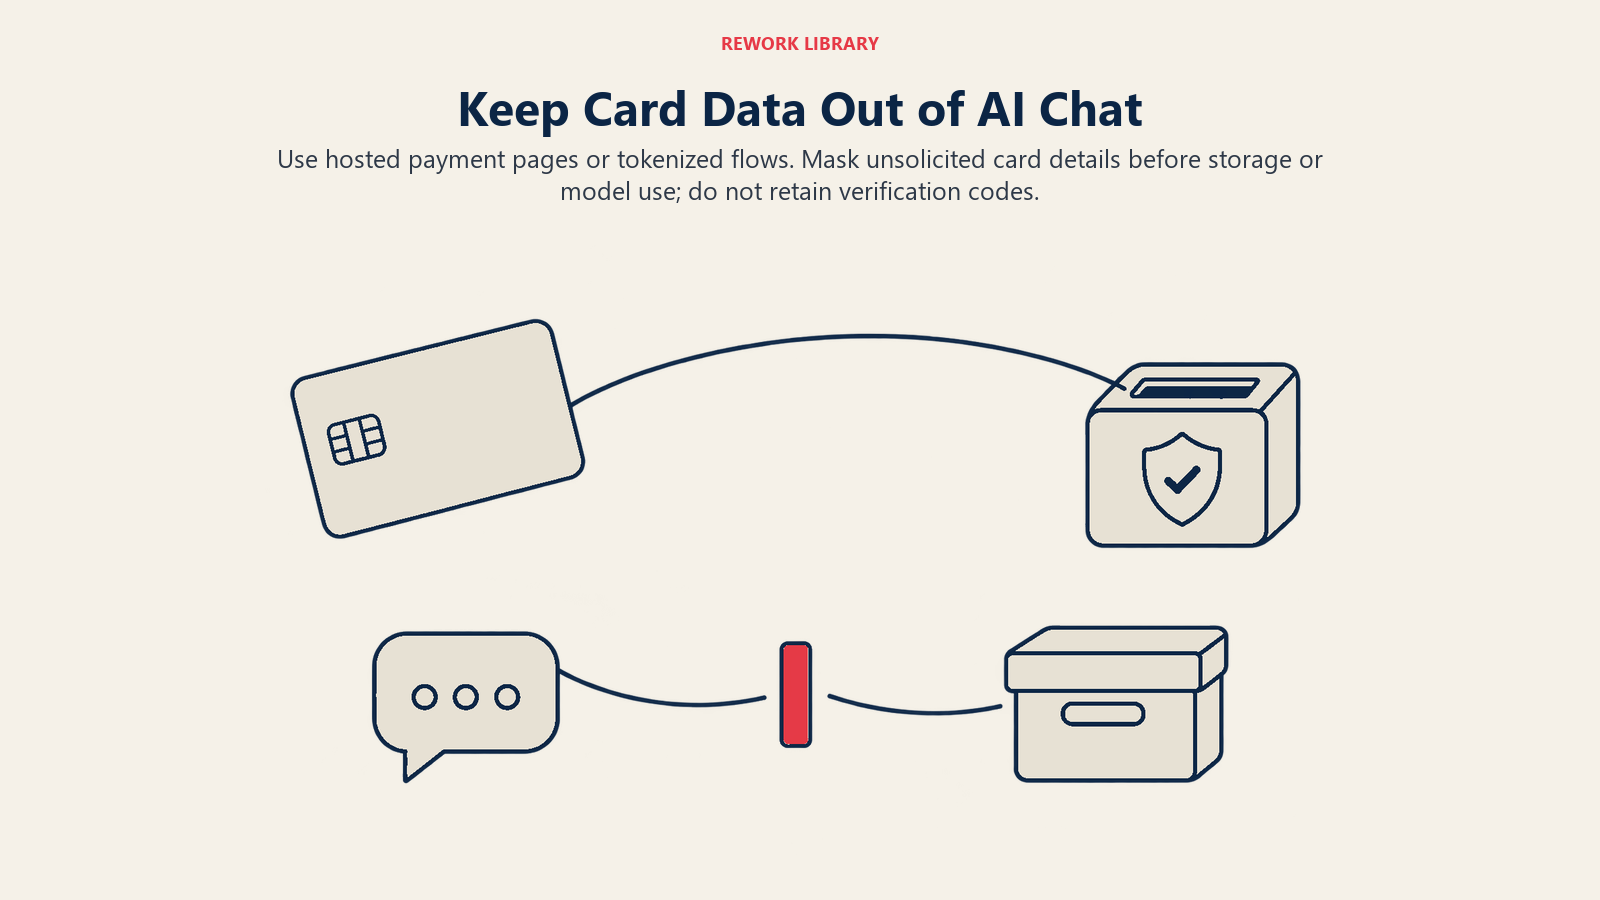
Sobre o código de segurança, o FAQ do PCI SSC é direto: não é permitido reter códigos de verificação de cartão depois que a transação é autorizada, coletá-los antes da autorização é permitido, e a aprovação do cliente não constitui licença para armazená-los (FAQ 1280 do PCI SSC). Outro FAQ acrescenta que os dados sensíveis de autenticação não devem ser armazenados após a autorização, mesmo criptografados, e que isso vale mesmo quando não há PAN presente (FAQ 1533 do PCI SSC).
Se um cliente digita um número de cartão e um código em um chat e a plataforma armazena a transcrição, esse código passa a ficar em um banco de dados depois do pagamento e também pode ir parar em prompts, resumos, exportações de QA e logs de fornecedores. A orientação do PCI SSC sobre gravação de voz define o comportamento esperado mais próximo: impedir a gravação sempre que possível e apagar imediatamente após a autorização quando não for possível impedi-la (FAQ 1210 do PCI SSC).
A abordagem prática é a redução de escopo, ou seja, organizar as coisas para que os dados de cartão nunca toquem os seus sistemas de suporte:
- Não peça dados de cartão no chat, no e-mail nem a uma IA. Encaminhe os clientes a uma página de pagamento hospedada ou a um link seguro operado pelo seu provedor de pagamentos.
- Mascare tudo que pareça um número de cartão assim que chegar. Faça isso antes do armazenamento e antes do modelo, e avise o cliente de que você o fez.
- Use tokens quando a IA precisar fazer referência a um pagamento. Os Princípios de IA do PCI SSC sugerem considerar tokens de pagamento ou PANs de uso único para limitar o escopo e o impacto de um sistema de IA, e dizem que a principal salvaguarda é limitar, desde o início, os dados sensíveis fornecidos ao sistema de IA (blog do PCI SSC).
- Mantenha as credenciais de fora também. Os mesmos princípios dizem que tokens de API, credenciais de usuário e chaves criptográficas devem ficar fora dos conjuntos de dados de IA.
- Confirme o escopo com o seu adquirente ou avaliador. Pergunte como a sua configuração de chat, voz e IA se encaixa e quais dos seus sistemas contam como tratamento de dados de cartão.
Termos do fornecedor: dados de treinamento, DPAs e suboperadores
O fornecedor de IA costuma ser um operador que age por sua conta. O Artigo 28(3) do GDPR diz que o tratamento por um operador é regido por um contrato segundo o qual o operador "trata os dados pessoais apenas mediante instruções documentadas do controlador" e, à escolha do controlador, "apaga ou devolve todos os dados pessoais ao controlador" quando o serviço termina (GDPR, EUR-Lex). Esse contrato é o acordo de processamento de dados (DPA). Faça-o assinar antes que qualquer dado de cliente circule.
Dois pontos fazem as equipes tropeçar.
Os termos variam por produto. Leia a documentação de cada fornecedor para o produto exato que você compra. A OpenAI, por exemplo, afirma que os dados da API não são usados para treinar seus modelos, a menos que você opte por isso, que os logs de monitoramento de abuso são mantidos por até 30 dias por padrão e que o Zero Data Retention exclui o conteúdo desses logs, mas exige aprovação prévia (OpenAI). A IA embutida no seu helpdesk, um fornecedor de chatbot e uma plataforma de voz têm, cada um, os seus próprios termos.
Os termos mudam. A FTC alertou que pode ser desleal ou enganoso uma empresa adotar práticas de dados mais permissivas, como usar dados para treinar IA, e avisar os clientes apenas por meio de uma mudança sub-reptícia e retroativa em seus termos. Ela também afirma que uma empresa que coleta dados sob um conjunto de compromissos de privacidade não pode voltar atrás neles unilateralmente (FTC). Isso protege os clientes, mas também diz a você para tratar os termos do fornecedor como um documento vivo. Coloque o contato de aviso de mudanças na agenda de alguém e revise os termos na renovação.
Lista de perguntas ao fornecedor
Pergunte a todo fornecedor de IA e de ferramentas de suporte, e obtenha as respostas no contrato ou no DPA, não em uma conversa de vendas:
- Os nossos dados são usados para treinar ou melhorar os seus modelos ou os de terceiros? Isso vem desativado por padrão ou depende de adesão?
- Por quanto tempo vocês retêm prompts, saídas e logs, e podemos encurtar esse prazo ou definir retenção zero?
- O que acontece com os nossos dados no fim do contrato, e como a exclusão é confirmada?
- Quais suboperadores tocam os nossos dados, em quais países, e como somos avisados quando mudam?
- Podemos escolher a região de armazenamento e processamento? A equipe de suporte acessa de outras regiões?
- Que registros e controles de acesso existem do seu lado para os nossos dados?
- Como vocês nos notificarão sobre uma violação, e em quanto tempo?
- O produto mascara ou exclui números de cartão, e a gravação de voz recebe tratamento diferente?
Residência dos dados e transferências internacionais
O Capítulo V do GDPR, que se abre com o Artigo 44, rege as transferências de dados pessoais para países terceiros (GDPR, EUR-Lex). Para os líderes de suporte, a pergunta prática é simples: em que país os dados dos nossos clientes ficam armazenados, e quais países podem lê-los?
Muitos provedores de IA oferecem uma configuração regional. A OpenAI documenta a residência de dados como uma opção no nível do projeto que armazena o conteúdo do cliente em repouso na região escolhida para os endpoints compatíveis, com os dados de sistema excluídos (OpenAI). "Em repouso" é mais restrito do que "nunca sai da região", então pergunte a cada fornecedor sobre backups, logs e acesso do suporte humano.
Controle de acesso
O incidente de privacidade mais comum no suporte não é um ataque. É alguém com acesso demais lendo o que não tinha motivo para ler. O Artigo 32(1)(a) do GDPR cita a pseudonimização e a criptografia entre as medidas técnicas a considerar (GDPR, EUR-Lex). Acrescente o básico:
- Acesso baseado em função. Os agentes veem as suas próprias filas. Os revisores de QA veem amostras. Só um grupo pequeno vê exportações brutas e logs de IA.
- Privilégio mínimo para a própria IA. Os Princípios de IA do PCI SSC recomendam dar à IA apenas o acesso de que ela precisa, com credenciais próprias e revogáveis, e registrar as suas ações para que possam ser rastreadas até uma pessoa responsável (blog do PCI SSC). Um bot que pode ler todos os registros de clientes porque foi mais fácil de configurar vai, mais cedo ou mais tarde, ser questionado sobre um deles.
- Logs de auditoria. Saiba quem abriu qual transcrição e quando.
- Desligamento e mascaramento. Remova o acesso no dia em que alguém sai e mostre por padrão apenas os últimos dígitos de documentos ou telefones.
Como implementar isso em oito passos
- Faça o inventário de todos os lugares onde os dados do cliente ficam, usando a tabela perto do início.
- Classifique cada tipo de dado: dados pessoais comuns, dados sensíveis, dados de pagamento, credenciais.
- Retire os dados de pagamento do caminho do suporte com uma página de pagamento hospedada e mascaramento.
- Adicione o mascaramento antes do modelo, antes do armazenamento e antes da reutilização, e faça amostragem toda semana.
- Escreva o cronograma de retenção com um responsável e automatize a exclusão em transcrições, resumos, gravações, logs e exportações.
- Assine o DPA e percorra a lista de perguntas ao fornecedor.
- Defina região e acesso em cada ferramenta e revise a lista de usuários.
- Teste passando dados falsos de cartão e pessoais por um chat e tentando encontrar todas as cópias. Veja implantando IA no atendimento ao cliente para o lançamento mais amplo.
Armadilhas a evitar
Mascarar apenas a entrada do modelo. A mensagem bruta muitas vezes permanece na transcrição, nos logs e nas exportações. Mascare em todo lugar onde ela for registrada e desconfie de qualquer caixa única de "mascaramento de PII" que prometa cobrir o seu data warehouse, o gravador de chamadas e os fornecedores de IA.
Criptografar em vez de apagar. No caso do código de segurança, o PCI SSC diz que a proibição de armazenamento vale mesmo se ele estiver criptografado (FAQ 1280 do PCI SSC).
Deixar exportações pontuais viverem para sempre. Uma planilha feita para uma revisão de QA em março ainda está em uma unidade compartilhada em dezembro. Dê um prazo de validade às exportações.
Esquecer o ponto de vista do cliente. Diga às pessoas quando elas estão falando com uma IA e o que acontece com as suas mensagens. Os riscos da IA no atendimento ao cliente tratam dos problemas mais amplos que as falhas de privacidade alimentam.
Perguntas frequentes sobre privacidade de dados do cliente no suporte com IA
O que é mascaramento de PII no suporte ao cliente com IA?
É o mascaramento automático de dados pessoais, como nomes, endereços de e-mail e números de cartão, antes que uma mensagem chegue a um modelo, a um log ou a uma transcrição armazenada. As ferramentas de detecção deixam passar coisas, então combine o mascaramento com amostragem e com a regra de coletar menos desde o início.
Os clientes podem digitar números de cartão em um chat de IA?
Você deve projetar o fluxo para que não o façam. O PCI DSS não permite manter códigos de verificação de cartão após a autorização, mesmo criptografados, então um chat que os armazena cria uma violação. Encaminhe os clientes a uma página de pagamento hospedada e mascare números parecidos com cartão se eles digitarem um mesmo assim.
Por quanto tempo devemos manter as transcrições do suporte com IA?
Apenas pelo tempo que a finalidade exigir. O Artigo 5(1)(e) do GDPR limita a manutenção de dados identificáveis ao que é necessário, então defina um período por tipo de dado, peça aos times jurídico e financeiro que fixem os limites externos e automatize a exclusão de transcrições, resumos e logs em conjunto.
O nosso fornecedor de IA treina os seus modelos com as conversas dos nossos clientes?
Depende do fornecedor e do nível do produto, então verifique o contrato e a documentação do fornecedor. Alguns provedores afirmam que os dados de API empresariais não são usados para treinamento, a menos que você opte por isso. Obtenha a resposta no seu DPA e fique atento a mudanças nos termos.
Onde os nossos dados de suporte devem ser armazenados?
Onde apontam as suas obrigações legais e as expectativas dos clientes. Escolha uma região nas configurações de cada fornecedor quando a opção existir e pergunte o que fica nessa região, incluindo logs, backups e acesso da equipe de suporte, já que "armazenado em repouso em uma região" é mais restrito do que "nunca sai dela".

Customer Success Operations Manager
On this page
- Fatos Principais
- Onde os dados do cliente ficam em uma pilha de suporte com IA
- Exemplos por canal
- Os seis controles
- Mascaramento: PII em transcrições, prompts e logs
- Retenção e exclusão
- Dados de cartão de pagamento: mantenha-os fora do chat e dos logs de IA
- Termos do fornecedor: dados de treinamento, DPAs e suboperadores
- Lista de perguntas ao fornecedor
- Residência dos dados e transferências internacionais
- Controle de acesso
- Como implementar isso em oito passos
- Armadilhas a evitar