Preparando os dados de suporte para a IA: tickets, macros e conteúdo de conhecimento
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Preparar os dados de suporte para a IA significa colocar três ativos em ordem antes que um modelo toque em um cliente: uma base de conhecimento precisa, sem ambiguidade e atual, um histórico de tickets com tags consistentes e resoluções limpas, e uma biblioteca de macros que corresponda a como a sua equipe realmente responde. Um agente de IA responde com o que você lhe dá. Se a central de ajuda se contradiz, o bot também se contradirá, e dirá isso com educação e em escala.
Este guia é para líderes de suporte, diretores de CX e gerentes de suporte que estão prestes a ligar um agente de IA, ou que já ligaram e estão vendo respostas erradas. Ele se encaixa sob a visão geral de IA no atendimento ao cliente e aprofunda o ponto que decide a maioria dos resultados: o conteúdo e os dados por baixo da ferramenta.
Fatos Principais
- No estudo do NBER "Generative AI at Work", um assistente de IA elevou em cerca de 14%, em média, os problemas resolvidos por hora entre 5.179 agentes de suporte ao cliente, e em 34% entre profissionais novatos e de baixa qualificação (NBER w31161).
- Os mesmos autores encontraram indícios de que a IA "dissemina as melhores práticas dos profissionais mais capazes", o que só funciona se essas práticas estiverem registradas e utilizáveis (NBER w31161).
- A documentação da Intercom diz que, ao contrário dos leitores humanos, a IA "depende muito de estrutura clara, redação sem ambiguidade e forte alinhamento com a intenção do cliente" (Intercom Help Center).
- A Intercom recomenda revisar toda semana as sugestões de conteúdo da IA e os alertas dos colegas, e revisar todo mês os artigos de alto envolvimento e baixa resolução (Intercom Help Center).
- A orientação da Zendesk para o seu agente de IA diz para evitar informações desatualizadas ou pouco confiáveis, porque os agentes de IA as usam (Zendesk Help Center).
De que dados de suporte a IA realmente precisa
A maioria das ferramentas de suporte com IA se divide em duas famílias, e cada uma lê um ativo diferente.
A primeira responde a perguntas a partir da sua documentação. Ela recupera artigos de ajuda relevantes e escreve uma resposta com base neles, um padrão conhecido como geração aumentada por recuperação. Nos termos do ACE Framework, é o padrão rag-assistant. A qualidade dela é limitada pelo seu conteúdo de conhecimento. O modelo não consegue citar uma política que você nunca registrou e não sabe qual de dois artigos conflitantes é o verdadeiro. A página sobre o agente de IA para base de conhecimento mostra como esse agente se comporta quando o conteúdo está no lugar.
A segunda classifica e roteia. Ela lê um ticket recebido, atribui uma categoria, urgência ou sentimento e o envia para a fila certa. É o padrão scoring-routing, e aprende com o seu histórico de tickets. Se as suas tags são inconsistentes, ela aprende hábitos inconsistentes. Veja o agente de IA de triagem de suporte para saber o que faz uma versão bem alimentada.
As macros ficam entre as duas. São a redação aprovada da sua equipe e alimentam tanto as ferramentas de rascunho quanto as sugestões de agent assist.
| Ativo | O que a IA faz com ele | Como é estar "pronto" |
|---|---|---|
| Artigos de ajuda e conhecimento interno | Fonte para respostas e citações | Um tema por artigo, um artigo por tema, responsável e data de revisão, sem contradições |
| Tags e categorias de tickets | Dados de treinamento e de avaliação para o roteamento | Lista curta e controlada, definições escritas, um motivo principal por ticket |
| Texto de tickets resolvidos | Exemplos de boas respostas e de causas raiz | Notas de resolução que dizem o que resolveu, não "feito" |
| Macros | Redação aprovada para rascunhos | Atuais, com responsável, ligadas a uma política e aposentadas quando a política muda |
| Campos de cliente e de pedido | Personalizar e verificar elegibilidade | Estruturados, atuais e disponíveis por meio de uma conexão controlada |
| Políticas (reembolsos, SLAs, escalonamento) | Limites que a IA precisa respeitar | Escritas como regras explícitas com exceções, não como conhecimento tácito |
Para o panorama mais amplo de dados além do suporte, o guia de prontidão de dados para IA percorre as verificações gerais.
As lacunas mais comuns
Cinco problemas aparecem repetidas vezes nas operações de suporte antes de um lançamento de IA.
Contradições entre artigos. Duas páginas sobre reembolsos, escritas com dois anos de diferença, dão prazos diferentes. Um agente humano sabe qual está certa. Um sistema de recuperação pode trazer qualquer uma. A própria central de ajuda da Zendesk observa que os agentes de IA usam informações desatualizadas ou pouco confiáveis, e um artigo antigo é exatamente isso.
Conhecimento que vive na cabeça das pessoas. A solução para aquele caso de borda estranho de cobrança existe só na memória do seu agente mais sênior. É a lacuna para a qual aponta o estudo do NBER: a IA espalha as práticas dos melhores profissionais, mas só as que consegue encontrar registradas.
Proliferação de tags. Depois de três anos você tem 140 tags, seis delas significando "problema de cobrança", e os agentes escolhem a primeira que aparece na lista suspensa. Um modelo de roteamento treinado com esse histórico reproduz a confusão.
Notas de resolução vazias. Tickets fechados com "Resolvido" ou "Feito" não ensinam nada. O valor está na linha que diz "O certificado SSO do cliente expirou; renovado nas configurações de administrador e sincronizado de novo."
Macros que sobreviveram à sua política. A macro que promete um prazo de devolução de 30 dias continua no menu de atalhos muito depois de a política ter mudado para 14 dias. As ferramentas de agent assist a sugerem fielmente.
Como é um bom conteúdo de conhecimento
O guia de práticas do Knowledge-Centered Service (KCS) v6, do Consortium for Service Innovation, é o método mais consolidado para isso. Ele organiza o trabalho em um Solve Loop (ciclo de resolução), em que os agentes capturam, estruturam, reutilizam e melhoram o conhecimento enquanto resolvem tickets, e um Evolve Loop (ciclo de evolução), que cobre a saúde do conteúdo, a integração aos processos, a avaliação de desempenho e a liderança (KCS v6 Practices Guide). As quatro práticas do Solve Loop se encaixam bem na prontidão para IA:
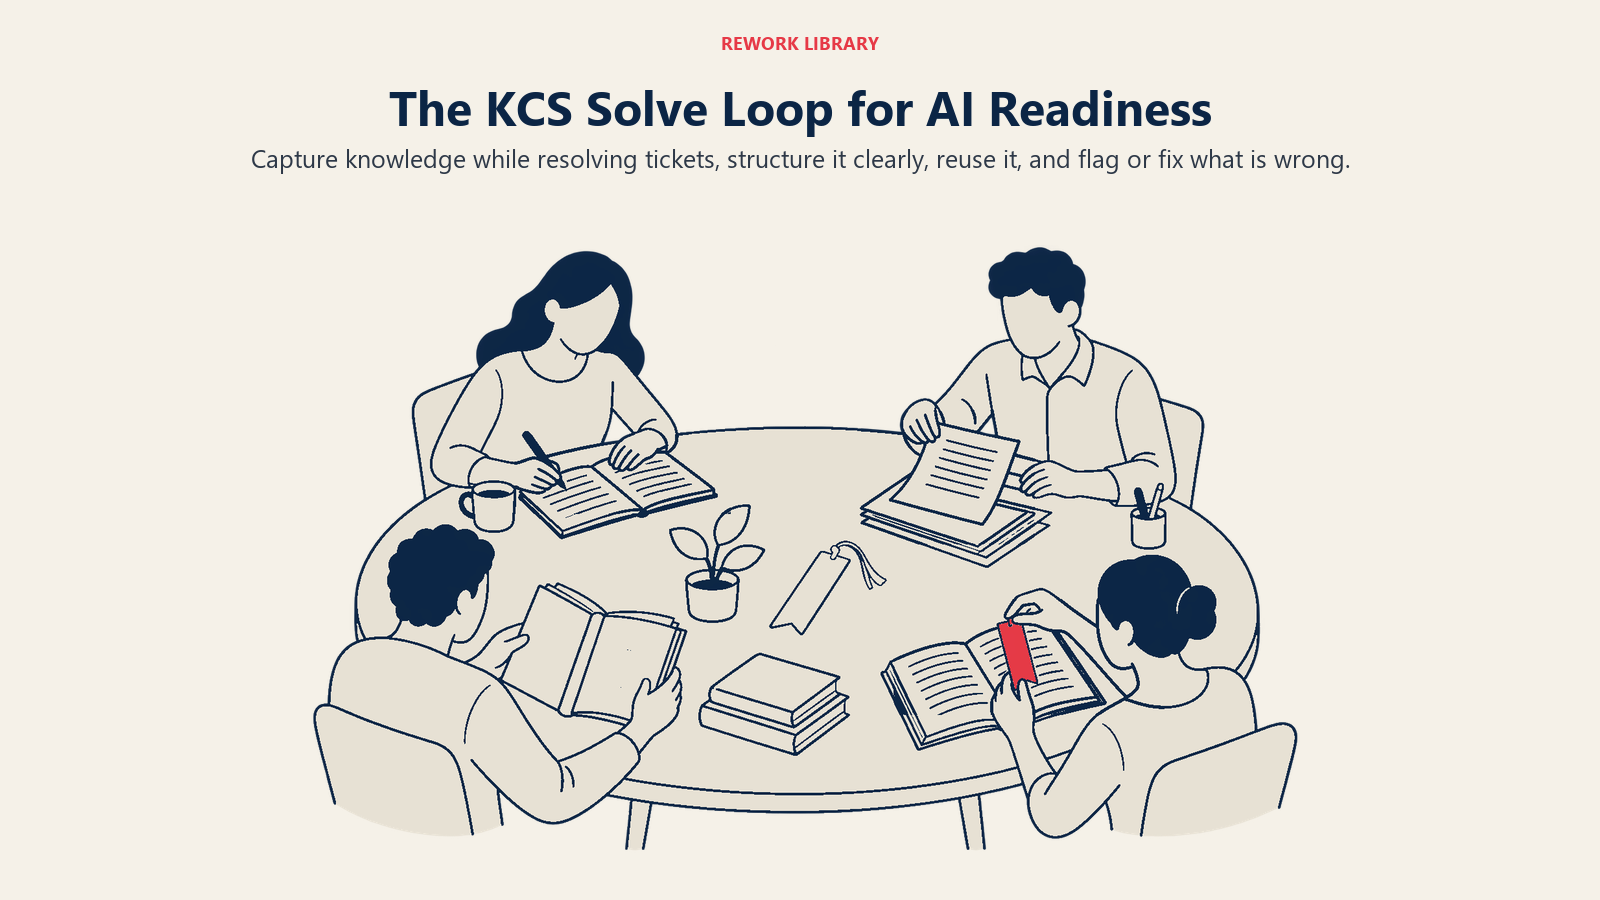
- Capturar (incluindo "Capture Knowledge in the Moment"): escreva o artigo enquanto resolve o ticket, não em um sprint trimestral de documentação.
- Estruturar ("Use A Simple Template"): um modelo consistente, como problema, ambiente, resolução e causa, torna o conteúdo fácil de interpretar tanto para pessoas quanto para sistemas de recuperação.
- Reutilizar ("Search Early Search Often", "Linking"): vincular tickets ao artigo usado mostra qual conteúdo realmente é usado.
- Melhorar ("Flag It or Fix It"): quem encontra um artigo errado o corrige ou o sinaliza, e assim a deterioração é detectada.
Você não precisa adotar o KCS por inteiro para se beneficiar. O princípio é que o conhecimento é um subproduto da resolução de tickets e tem um responsável.
A orientação dos fornecedores aponta na mesma direção. A Intercom diz que a IA depende de estrutura clara e redação sem ambiguidade, e que artigos de finalidade ou escopo pouco claros podem ser recuperados para o tipo errado de consulta (Intercom Help Center). Uma regra prática: se um recém-contratado perguntaria "espere, qual deles vale para mim?" depois de ler, a IA vai chutar.
Alguns hábitos de escrita que ajudam:
- Coloque a resposta na primeira frase e depois as condições e exceções.
- Nomeie o segmento de cliente, o plano ou a região a que a resposta se aplica.
- Use no título as palavras que os clientes usam ("Alterar o e-mail da minha conta"), não o jargão interno.
- Mantenha uma tarefa por artigo e use links em vez de copiar etapas compartilhadas.
- Marque a versão do produto ou a data da política dentro do artigo para que os revisores identifiquem os desatualizados.
Limpando o histórico de tickets e as macros
O histórico de tickets é onde a IA aprende a sua lógica de classificação e onde as ferramentas de agent assist encontram exemplos de respostas.
Tags. Reduza a uma lista controlada que um agente novo consiga memorizar, geralmente de 15 a 40 motivos, conforme a complexidade. Escreva uma definição de uma linha e um exemplo para cada um. Una sinônimos, aposente a cauda longa e torne o motivo principal do contato um campo obrigatório. Depois reclassifique uma amostra (algumas centenas de tickets bastam para testar) e compare o resultado com o que os agentes escolheram originalmente. Uma grande divergência significa que as categorias são pouco claras, não que os agentes são descuidados.
Notas de resolução. Adicione um campo obrigatório "o que resolveu" ou um modelo de fechamento. Até uma nota curta e específica transforma cada ticket em um possível artigo de conhecimento e em um exemplo de treinamento melhor.
Dados sensíveis. Os tickets contêm nomes, trechos de cartões, dados de saúde e senhas que as pessoas colaram por engano. Decida o que será mascarado ou excluído antes de qualquer texto de ticket ser usado para treinamento ou recuperação. Envolva cedo o seu responsável por privacidade ou segurança.
Macros. Exporte a lista completa com a contagem de uso. Aposente tudo o que não foi usado em um ano, atribua um responsável a cada macro restante e vincule cada uma à política que ela expressa. Quando uma política muda, o responsável atualiza a macro e o artigo correspondente na mesma alteração.
Passo a passo: deixando os dados de suporte prontos
- Escolha o primeiro caso de uso. Um bot de deflexão (desvio de solicitações) para dúvidas de senha e cobrança precisa de bons artigos. Um modelo de triagem precisa de boas tags. Comece pelo ativo de que o seu primeiro projeto depende e use o guia de prontidão de dados por padrão para ver o que cada padrão exige.
- Audite os 50 principais tópicos. Levante os principais motivos de contato por volume. Para cada um, verifique se exatamente um artigo atual o responde. Marque os que faltam, os duplicados e os conflitantes.
- Corrija primeiro as contradições. Una duplicatas, exclua ou redirecione a perdedora e resolva a questão da política com quem for o responsável. Esse é o ganho de precisão mais rápido que você vai ter.
- Preencha as lacunas com tickets reais. Para os principais tópicos sem cobertura, leia 20 tickets resolvidos e escreva o artigo a partir da melhor resolução. É a "captura" do KCS feita em lote.
- Padronize o modelo. Adote uma estrutura de artigo e um estilo de título. Reescreva primeiro os 50 principais, não a biblioteca inteira.
- Limpe tags e notas. Publique a lista controlada de tags com definições, remapeie o histórico para ela e exija notas de resolução daqui em diante.
- Revise as macros. Aposente, atualize ou atribua responsáveis e vincule cada uma a uma política.
- Defina responsáveis e datas de revisão. Todo artigo e toda macro recebe um responsável nomeado e um intervalo de revisão. Ordene pela data da última atualização, comece pelos artigos de maior tráfego e coloque a revisão em um calendário regular.
- Monte um conjunto de teste. Escreva de 50 a 100 perguntas reais de clientes com a resposta correta para cada uma, incluindo perguntas que o bot deve recusar. Rode-o antes do lançamento e depois de cada mudança de conteúdo.
- Abra um ciclo de feedback. Dê aos agentes um jeito de sinalizar com um clique uma resposta errada ou ausente e revise os alertas toda semana. A Intercom recomenda a revisão semanal das sugestões de conteúdo da IA e dos alertas dos colegas, e um olhar mensal sobre os artigos muito usados pela IA, mas que raramente resolvem a dúvida (Intercom Help Center).
Checklist de prontidão dos dados de suporte
Pontue cada linha com 0 (não é verdade), 1 (em parte) ou 2 (é verdade). Qualquer resultado abaixo de 10 de 16 no primeiro bloco significa corrigir o conteúdo antes de lançar um bot voltado ao cliente.
| Verificação | Pontuação de 0 a 2 |
|---|---|
| Cada um dos 50 principais motivos de contato tem um artigo atual e correto | |
| Não há dois artigos com respostas conflitantes | |
| Todo artigo tem um responsável e uma data de revisão | |
| As políticas (reembolsos, SLAs, escalonamento) estão escritas como regras com exceções | |
| As tags de tickets vêm de uma lista controlada com definições | |
| O motivo principal do contato é obrigatório em todo ticket | |
| As notas de resolução dizem o que resolveu o problema | |
| As macros são atuais, têm responsável e estão ligadas à política | |
| O tratamento de dados sensíveis para o uso com IA está decidido | |
| Existe um conjunto de teste com perguntas reais e respostas esperadas | |
| Os agentes podem sinalizar respostas erradas ou ausentes com um clique | |
| Alguém é responsável pela revisão semanal de alertas e lacunas |
Use a pontuação para puxar uma conversa com a equipe, não como nota de aprovado ou reprovado. As linhas de menor pontuação são o seu primeiro sprint.
Exemplos por função
Estes são cenários ilustrativos, não estudos de caso medidos.
Atendimento ao cliente. Imagine uma equipe de suporte de software com dois artigos de redefinição de senha, um para o login antigo e outro para o login único (SSO). Uni-los em um só artigo, com uma breve seção "qual login você usa?" no início, dá ao bot uma única fonte. O seu próprio conjunto de teste é o que diz quanto a precisão melhora.
Suporte de cobrança e finanças. A política de reembolso costuma ter exceções que só o líder de cobrança conhece: planos anuais, regras regionais, uso parcial. Escrevê-las como uma tabela de regras explícita em um único artigo permite que a IA e os agentes novos as apliquem com consistência.
Suporte técnico. Digamos que os engenheiros corrijam problemas no código, mas o suporte nunca registre a solução alternativa. Adicionar uma nota obrigatória de "causa e solução" ao modelo de fechamento cria um fluxo constante de rascunhos de artigos, que um especialista de suporte pode revisar toda semana.
Onboarding e sucesso. Se os gerentes de customer success respondem às mesmas dúvidas de configuração com modelos pessoais, levar as melhores versões para macros compartilhadas e com responsável dá à equipe uma redação consistente e dá à IA algo aprovado de onde tirar.
Operações e qualidade. Um líder de QA pode amostrar as respostas da IA contra o conjunto de teste toda semana e registrar cada falha como uma correção de conteúdo, de tags ou uma dúvida de política. Quando as falhas passam de lacunas de conteúdo para casos de borda raros, o trabalho de conteúdo está dando resultado.
Armadilhas a evitar
- Importar tudo. Alimentar a IA com todos os artigos, tópicos de fórum e notas de versão antigas faz com que ela cite os desatualizados. Selecione o conjunto de fontes e exclua o conteúdo arquivado.
- Tratar uma atualização de modelo como correção de conteúdo. Um modelo melhor não resolve duas políticas contraditórias. Ele vai se contradizer com mais eloquência. Veja alucinação de IA para entender por que respostas erradas e fluentes são o principal risco.
- Reescrever primeiro a biblioteca inteira. Comece pelos tópicos que geram volume. Dez ótimos artigos valem mais do que 500 limpos que ninguém consultou.
- Sem responsáveis. Conteúdo sem responsável se deteriora. A primeira mudança de política depois do lançamento vai quebrar alguma coisa.
- Pular o conhecimento privado. Os runbooks internos e as regras de escalonamento importam tanto quanto os artigos públicos, e muitas vezes são os menos organizados. Decida com critério quais recursos de IA podem lê-los. A Zendesk observa que as respostas generativas se baseiam principalmente em artigos de acesso público, então o conteúdo restrito pode não ser usado.
- Ignorar as pessoas. Os agentes que escrevem o conhecimento precisam de tempo e reconhecimento por isso. Veja IA e os papéis na equipe de suporte para saber como o trabalho de conteúdo muda quem faz o quê.
- Lançar sem um conjunto de teste. Se você não consegue medir a qualidade das respostas antes do lançamento, vai descobrir pelos clientes.
Próximos passos
Escolha os 20 principais motivos de contato, confira se cada um tem um artigo atual e corrija os conflitos. Só essa auditoria costuma entregar mais do que qualquer configuração de ferramenta. Depois monte o conjunto de teste, defina os responsáveis e faça a revisão semanal de alertas. Em seguida, use a visão geral para situar este trabalho na implantação mais ampla.

Customer Success Operations Manager
On this page
- Fatos Principais
- De que dados de suporte a IA realmente precisa
- As lacunas mais comuns
- Como é um bom conteúdo de conhecimento
- Limpando o histórico de tickets e as macros
- Passo a passo: deixando os dados de suporte prontos
- Checklist de prontidão dos dados de suporte
- Exemplos por função
- Armadilhas a evitar
- Próximos passos