Detecção de intenção do cliente: como a IA entende por que os clientes entram em contato
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
A detecção de intenção do cliente é a classificação automática da mensagem de um cliente no motivo pelo qual ele entra em contato, como "onde está o meu pedido", "cancelar minha assinatura" ou "fui cobrado duas vezes". O resultado é um rótulo, em geral com uma pontuação de confiança, anexado a um chat, e-mail, ticket ou transcrição de chamada antes que uma pessoa o leia.
Esse rótulo é pequeno, mas muita coisa depende dele. Ele decide em qual fila um ticket cai, se um bot deve responder ou transferir e o que o seu relatório mensal diz que os clientes realmente perguntam. Uma camada de intenção fraca envia dúvidas de cobrança ao suporte técnico e esconde o seu principal motivo de contato dentro de um balde chamado "Geral". Uma boa camada dá um roteamento que funciona desde o primeiro dia e um mapa da demanda em torno do qual você pode planejar.
Este guia cobre como a detecção funciona, como montar a lista de intenções (a taxonomia) da qual tudo depende e como usar os rótulos. Se você quiser antes o panorama mais amplo, a visão geral de IA no atendimento ao cliente é uma boa companhia.
Fatos Principais
- O Dialogflow CX pontua cada intenção candidata de 0,0 (totalmente incerto) a 1,0 (totalmente certo), devolve a intenção principal apenas se ela superar o limiar de classificação e, caso contrário, dispara um evento de no-match (Google Cloud).
- O Google recomenda pelo menos 10 a 20 frases de treinamento por intenção no Dialogflow CX, conforme a complexidade da intenção (Google Cloud).
- O Amazon Lex V2 devolve a intenção mais provável mais até 4 alternativas, e recorre à
AMAZON.FallbackIntentquando todas as pontuações ficam abaixo do seu limiar (AWS). - O próprio exemplo de ambiguidade do Lex: pontuações de 0,75 e 0,72 significam que duas intenções estão próximas demais para decidir, enquanto 0,95 contra 0,65 significa que a primeira provavelmente está certa (AWS).
- O benchmark CLINC150 cobre 150 intenções em 10 domínios, e seus autores constataram que os classificadores vão bem nas intenções dentro do escopo, mas têm dificuldade para identificar consultas fora do escopo (Larson et al., arXiv).
- A Zendesk mostra confiança Alta, Média ou Baixa nas previsões de tópico e idioma de um ticket e diz que as correções dos agentes não treinam o modelo (Zendesk).
O que é, de fato, uma intenção
Uma intenção é o objetivo por trás de uma mensagem, não as suas palavras. "Meu pacote nunca chegou", "Cadê as minhas coisas?" e "O rastreio diz entregue, mas não recebi nada" são três textos diferentes e uma só intenção: status do pedido ou problema de entrega.
Duas coisas são confundidas com ela:
- Tópico ou categoria. "Cobrança" é um tópico. "Pedir reembolso de uma cobrança duplicada" é uma intenção. Os tópicos servem para relatórios num relance; as intenções são específicas o bastante para orientar uma ação.
- Sentimento. Se o cliente está com raiva é algo separado do motivo pelo qual ele escreveu. Você vai querer os dois, mas são campos diferentes. Um cliente furioso perguntando sobre a entrega continua tendo uma intenção de entrega.
Muitas plataformas detectam vários sinais ao mesmo tempo. A triagem inteligente da Zendesk, por exemplo, classifica tickets por tópico, sentimento, idioma e entidades, e a documentação observa que usar esses campos em fluxos de trabalho exige o complemento Copilot (Zendesk). A central de ajuda da Zendesk agora diz "tópico" onde as configurações mais antigas dizem "intenção".
Como funciona a detecção de intenção
Há duas abordagens amplas, e a maioria dos sistemas reais usa uma mistura.
Classificadores treinados
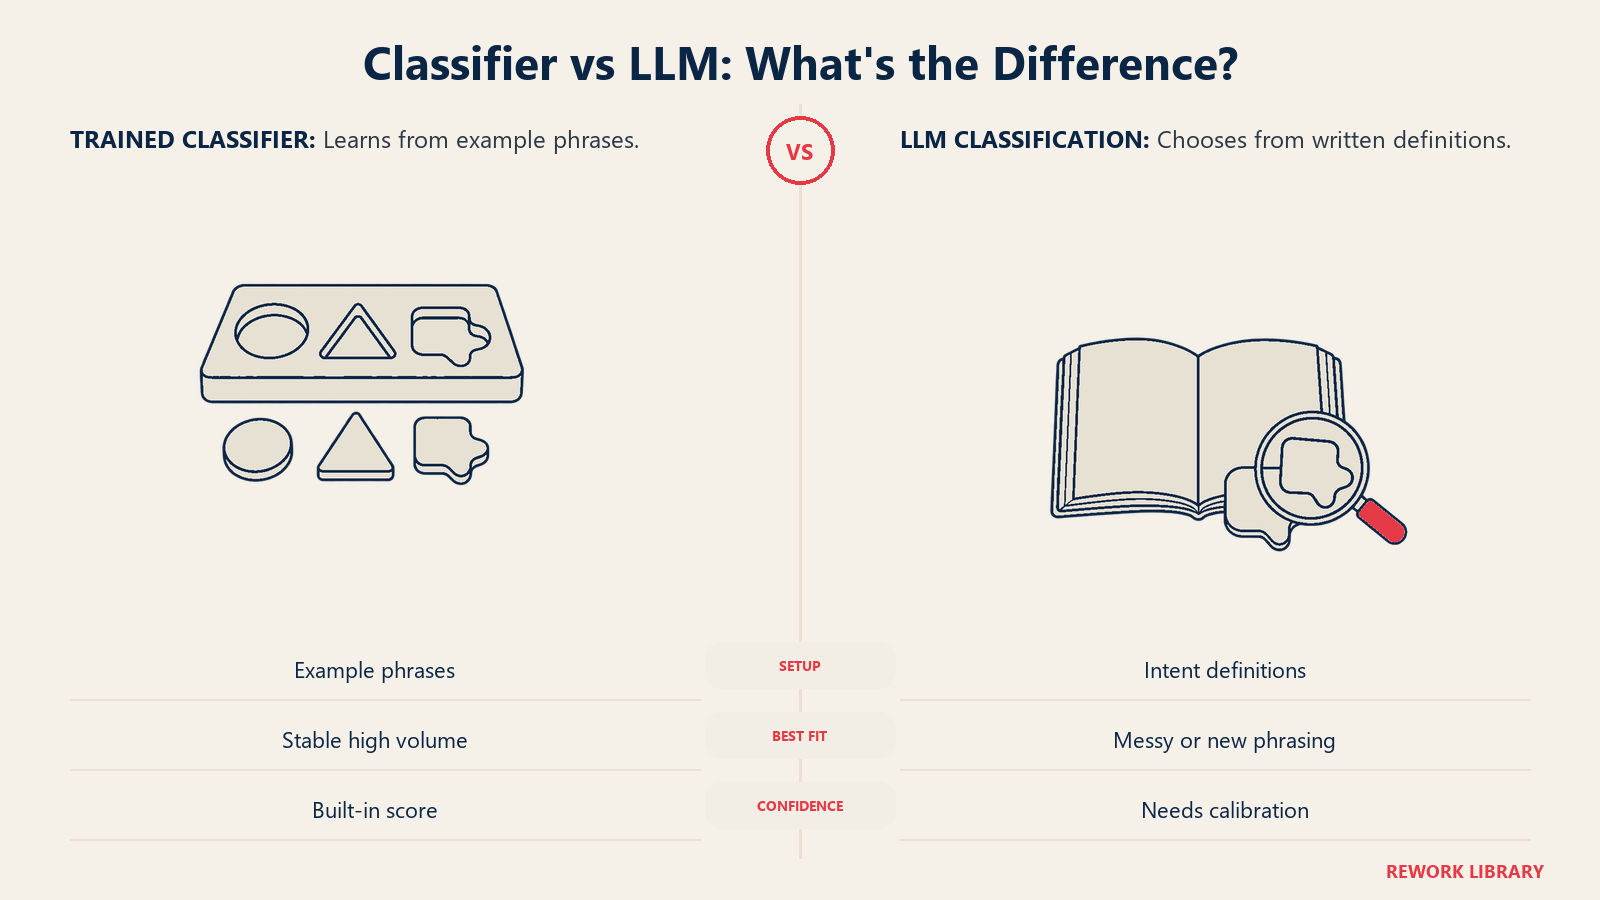
Você define as intenções, dá a cada uma frases de exemplo, e a plataforma treina um modelo para comparar as novas mensagens com elas. O Dialogflow CX e o Amazon Lex funcionam assim. O modelo pontua todas as intenções e escolhe a mais alta.
Pontos fortes: é rápido, barato por mensagem, previsível e devolve uma pontuação sobre a qual se pode definir um limiar. Pontos fracos: só conhece as intenções que você ensinou. Uma mensagem sobre algo novo é forçada para o rótulo mais próximo ou simplesmente não encontra correspondência. A orientação do Google é começar com pelo menos 10 a 20 frases de treinamento por intenção, e ela avisa que encher a intenção negativa padrão com enormes quantidades de frases (cita 10.000 como exemplo) prejudicaria a correspondência normal (Google Cloud).
Classificação baseada em LLM
Aqui você dá a um modelo de linguagem grande a lista de intenções com definições curtas e pede que escolha uma (ou "nenhuma"). Não há conjunto de treinamento para montar, então uma nova intenção pode entrar no ar assim que você escrever a sua definição. As plataformas clássicas de NLU estão indo na mesma direção, acrescentando camadas de LLM sobre os seus modelos de intenção treinados.
Pontos fortes: lida com mensagens confusas e de várias frases, idiomas misturados e formulações totalmente novas. Pontos fracos: custa mais por mensagem, é mais lento, pode se desviar quando os prompts ou os modelos mudam e pode inventar um rótulo, a menos que você o restrinja à sua lista. Calibre a confiança que ele declara com uma amostra rotulada à mão em vez de confiar nela.
| Classificador treinado | Baseado em LLM | |
|---|---|---|
| Esforço de configuração | Frases de exemplo por intenção | Definições escritas por intenção |
| Lida com formulações novas | Só se forem parecidas com as frases de treinamento | Em geral bem |
| Tempo para uma nova intenção | Coletar exemplos, retreinar | Editar a definição |
| Pontuação de confiança | Embutida | Exige calibração |
| Consistência ao longo do tempo | Alta até retreinar | Pode mudar com alterações de modelo ou de prompt |
| Melhor para | Intenções estáveis e de alto volume | Entrada de cauda longa, confusa ou multilíngue |
Uma configuração comum: um classificador trata as 15 a 20 principais intenções, que respondem pela maior parte do volume, e um LLM recolhe o que o classificador rejeita. Se os seus contatos chegam em vários idiomas, leia as notas sobre suporte multilíngue antes de escolher, já que os dados de treinamento por idioma se acumulam rapidamente.
Limiares de confiança e fallback
Toda abordagem precisa de uma regra para o "não tenho certeza". Ela tem três partes.
Um limiar. Tanto o Dialogflow quanto o Lex permitem definir uma pontuação mínima. No Dialogflow CX, a intenção principal só é devolvida se atingir o limiar de classificação definido nas configurações do agente; caso contrário, um evento de no-match é disparado (Google Cloud). No Lex V2, o limiar é um número entre 0,00 e 1,00, definido por idioma, e toda pontuação abaixo dele produz a intenção de fallback (AWS). O Lex também avisa que suas pontuações são valores comparativos, não absolutos, e podem mudar conforme o serviço melhora. Então não copie o 0,7 de outra pessoa; teste o seu.
Uma margem. A distância entre as duas pontuações mais altas importa tanto quanto a pontuação máxima. A documentação do Lex dá o exemplo de 0,75 contra 0,72 como ambiguidade real. Um bom padrão: se a pontuação máxima está abaixo do seu limiar, ou se as duas primeiras estão dentro de uma margem pequena, não adivinhe. Faça uma pergunta de esclarecimento ("É sobre um reembolso ou um cancelamento?") ou encaminhe a uma pessoa.
Um caminho de fallback. Decida de antemão o que acontece em um erro. As opções, do menor ao maior esforço para o cliente:
- Enviar a mensagem a uma fila geral com os dois melhores palpites anexados, para que o agente comece com uma pista.
- Fazer uma pergunta de esclarecimento com dois ou três botões.
- Transferir a um humano com a conversa até aquele ponto.
A pesquisa explica por que isso importa. O conjunto de dados CLINC150 foi construído para incluir consultas fora do escopo justamente porque os classificadores que parecem ótimos em intenções conhecidas sofrem quando alguém pergunta algo fora da lista (Larson et al., arXiv). O seu tráfego real é, em grande parte, esse caso esperando para acontecer.
Defina os limiares conforme o uso. Uma decisão de roteamento (qual fila) tolera um limiar mais baixo, porque um palpite errado custa uma reatribuição. Uma ação automatizada, como cancelar uma conta ou emitir um reembolso, exige um muito mais alto, ou uma etapa de confirmação. Para a pergunta mais difícil de quais tarefas entregar à IA, veja automatizar ou assistir.
Construindo uma taxonomia de intenções
A taxonomia é a lista de intenções, e importa mais do que o modelo. Um ótimo modelo sobre uma lista confusa dá rótulos precisos que ninguém consegue usar.
Comece pelos dados, não pelo organograma
Puxe algumas centenas de tickets ou chats recentes e leia-os. Agrupe pelo que o cliente queria, não pela equipe que hoje cuida do assunto. Se os dados forem escassos ou inconsistentes, corrija isso primeiro: preparando os dados de suporte para a IA trata da limpeza.
Escolha a granularidade certa
Grossa demais e o rótulo não consegue orientar uma ação ("Cobrança" cobre faturas, reembolsos, pagamentos que falharam e dúvidas sobre impostos, que exigem pessoas diferentes). Fina demais e o modelo não distingue os rótulos, os agentes não se lembram deles e os relatórios se fragmentam em 200 linhas de 3 tickets cada.
Um teste que funciona: esta intenção muda o que fazemos em seguida? Se duas intenções candidatas recebem a mesma resposta, vão para a mesma equipe e são reportadas como um só número, una-as. Se receberiam tratamentos diferentes, mantenha-as separadas.
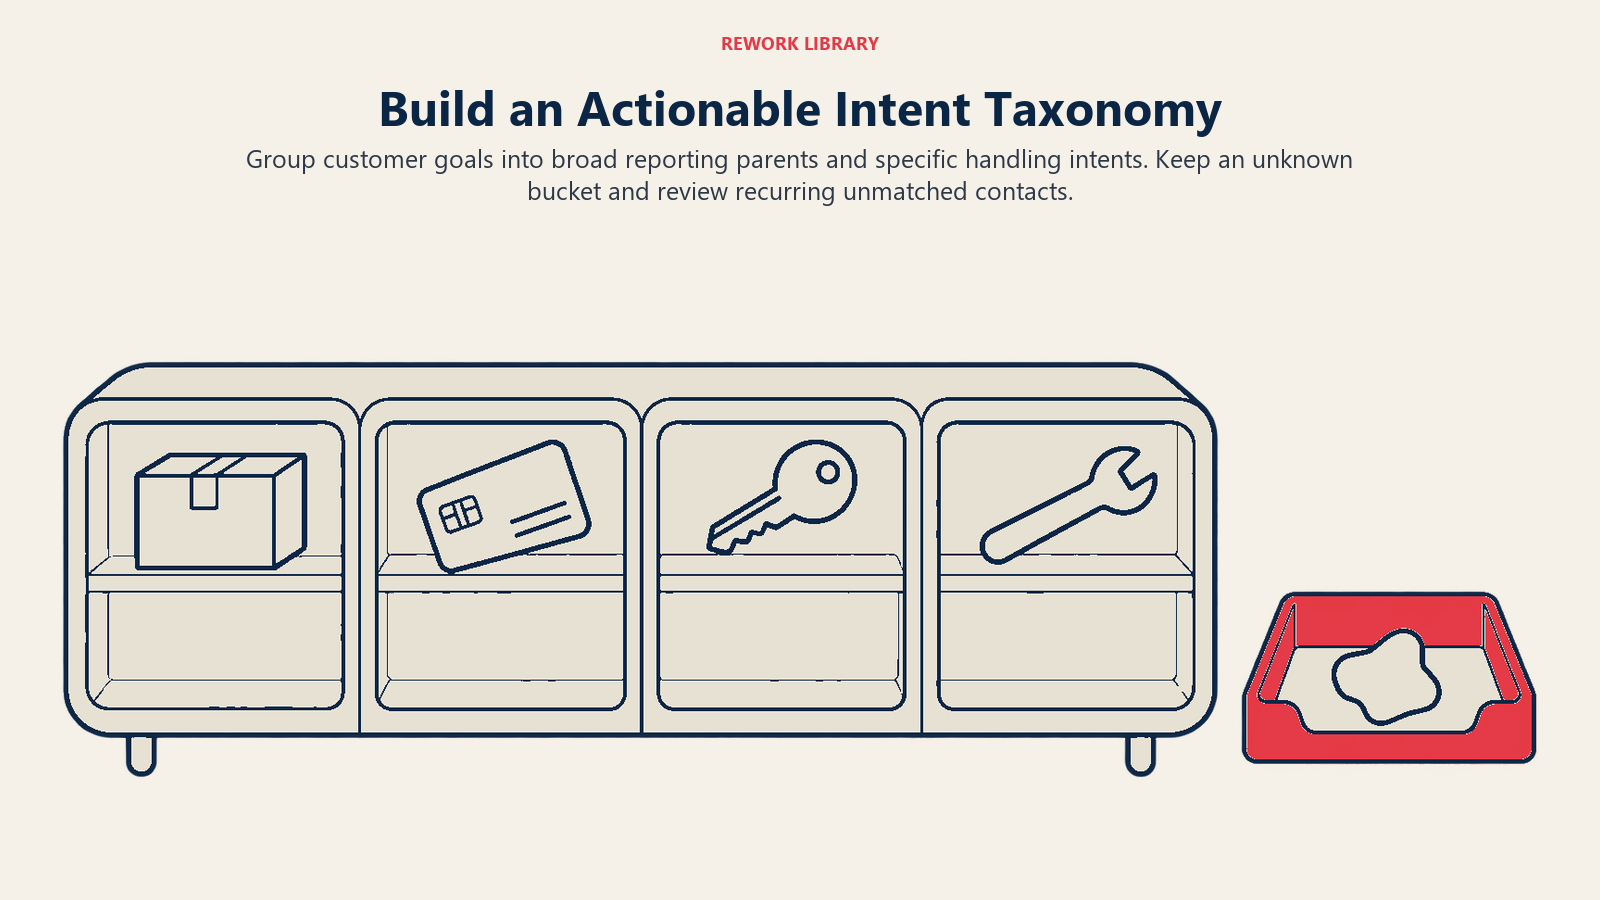
Uma estrutura de dois níveis costuma funcionar: um punhado de categorias-mãe para os relatórios executivos e cerca de 20 a 60 intenções-filhas para roteamento e automação. Essa faixa é uma regra prática, não um padrão; deixe o seu volume decidir. Você não consegue agir sobre uma cauda longa de intenções que aparecem duas vezes por mês.
Nomeie as intenções como objetivos do cliente
Use um padrão consistente que começa pelo verbo: request_refund, change_billing_address, report_login_problem. Evite nomes que descrevem o seu processo interno ("tier2_escalation") ou que são vagos ("other_issue"). Escreva uma definição de uma linha e dois ou três exemplos de mensagem para cada uma, incluindo os casos limítrofes ("Se o cliente mencionar uma cobrança duplicada, use report_billing_error, não request_refund").
Inclua sempre um balde "outros" e vigie-o
Uma intenção "outros" ou "desconhecido" não é uma falha; é o seu sensor de mudança. Novos recursos do produto, uma mudança de preço ou uma indisponibilidade aparecem ali primeiro. Duas regras o mantêm útil:
- Limite-o. Se "outros" passar de cerca de 10% do volume, a sua taxonomia está desatualizada. Esse valor é uma meta de trabalho, não um benchmark do setor.
- Faça amostragem. Leia de 50 a 100 contatos de "outros" por mês e promova qualquer padrão que apareça repetidamente a uma intenção de verdade.
O Dialogflow tem uma versão embutida desse ciclo: suas sugestões de intenção analisam as ocorrências de no-match e recomendam novas intenções ou frases de treinamento, embora o recurso seja limitado a certas regiões e precise ser ativado nas configurações do agente (Google Cloud).
Defina uma cadência de revisão
Revise a taxonomia todo mês no começo e a cada trimestre depois que ela se estabilizar, e sempre após um lançamento de produto ou uma mudança de preço. Aposente intenções silenciosas, divida as amplas e mantenha um registro de mudanças, para que uma queda em "pedidos de reembolso" não seja apenas um rótulo renomeado.
| Categoria-mãe | Exemplos de intenções-filhas | Tratamento típico |
|---|---|---|
| Pedidos e entrega | track_order, report_missing_package, change_delivery_address |
Consulta pelo bot, depois fila de logística |
| Cobrança | request_refund, report_billing_error, update_payment_method |
Fila de cobrança, reembolsos exigem aprovação |
| Acesso à conta | reset_password, report_login_problem, delete_account |
Bot para redefinições, equipe de segurança para exclusão |
| Ajuda com o produto | how_to_use_feature, report_bug, request_feature |
Central de ajuda, suporte ou feedback de produto |
| Cancelamento e retenção | cancel_subscription, downgrade_plan |
Especialista em retenção, nunca só o bot |
| Outros | unknown, out_of_scope |
Fila geral, revisada todo mês |
Usando as intenções em roteamento e relatórios
Roteamento
A intenção se torna útil quando aciona uma regra. As mais comuns:
- Roteamento por habilidades. As intenções de cobrança vão para a equipe de cobrança, as técnicas para a equipe técnica, com o idioma como segundo filtro.
- Bot ou humano. Intenções de baixo risco e bem definidas, como rastrear um pedido, vão para a automação. As sensíveis, como cancelamento, ameaças legais ou segurança, vão sempre para uma pessoa.
- Prioridade. Combine a intenção com o sentimento e a categoria do cliente. Um pedido de "cancelar assinatura" de uma conta de alto valor com sentimento negativo fura a fila.
- Ajuda pré-preenchida para os agentes. Mostre a intenção detectada e um artigo ou macro sugerido na tela do agente. Isso combina naturalmente com o agent assist com IA.
Mantenha humanos no circuito nas correções. A Zendesk permite que os agentes alterem o tópico previsto no painel de propriedades do ticket, mas observa que isso não treina o modelo (Zendesk). Isso significa que as correções precisam ser capturadas em algum lugar utilizável, como um campo que você exporta para rerrotulagem, ou os mesmos erros vão se repetir.
Relatórios
Quando todo contato tem uma intenção, você consegue responder perguntas que antes exigiam uma auditoria manual:
- Quais são os dez principais motivos pelos quais os clientes nos procuram, e como estão evoluindo?
- Quais intenções têm a menor resolução e mais contatos repetidos? Combine a intenção com as medidas de taxa de resolução da IA para ver onde a automação realmente funciona.
- Quais intenções uma central de ajuda melhor poderia responder? Veja busca na central de ajuda com IA.
As contagens por intenção também são o insumo natural da previsão de volume de suporte com IA: prever por motivo de contato é mais útil do que uma única linha total, porque "redefinição de senha" e "disputa de cobrança" respondem a fatores diferentes e exigem dimensionamentos diferentes.
Exemplos por função
Suporte ao cliente. Uma empresa de software etiqueta todos os tickets recebidos. "Como exporto um relatório" vai para uma resposta da central de ajuda; "A exportação está quebrada" vai para o suporte técnico com um sinalizador de bug. Mesmas palavras, intenções diferentes, fila diferente.
Finanças e cobrança. Um negócio de assinaturas separa report_billing_error de request_refund. A primeira vai para uma fila capaz de investigar; a segunda exige regras de aprovação.
Help desk de TI. Um service desk interno detecta request_access, report_outage e reset_password. As redefinições de senha vão para o autoatendimento, as indisponibilidades acionam o engenheiro de plantão e os pedidos de acesso disparam um fluxo de aprovação.
Caixa de entrada de vendas. Uma caixa compartilhada separa request_pricing, request_demo e support_question_from_customer. Tirar a terceira da fila de vendas protege o tempo de resposta para os leads de verdade.
Implementação passo a passo
- Colete e leia uma amostra. De 300 a 500 contatos recentes em todos os canais. Anote os motivos reais, nas palavras do cliente.
- Esboce a taxonomia. Primeiro as mães, depois as filhas, com nomes que começam pelo verbo. Acrescente definições, exemplos e um balde "outros".
- Rotule à mão um conjunto de teste. Peça a duas pessoas que rotulem, cada uma por conta própria, de 200 a 300 mensagens. Onde discordarem, as definições estão pouco claras; corrija-as antes de mexer em um modelo.
- Escolha o método. Classificador treinado para intenções estáveis e de alto volume; LLM para cauda longa ou multilíngue; um híbrido se precisar dos dois.
- Defina limiares e fallbacks. Comece conservador para ações automatizadas e mais frouxo para roteamento. Defina o caminho de fallback antes do lançamento.
- Rode em modo sombra. Preveja as intenções e mostre-as aos agentes, mas ainda não roteie com base nelas. Compare as previsões com o que os agentes de fato fizeram.
- Ative o roteamento nas intenções que têm bom desempenho. A precisão por intenção varia; ligue primeiro as fortes.
- Feche o ciclo. Capture as correções dos agentes, faça amostragem de "outros" todo mês e retreine ou refaça o prompt em um cronograma.
Armadilhas a evitar
Construir a taxonomia em torno de equipes. Se as intenções espelham o seu organograma, uma reorganização quebra os seus relatórios. Baseie-as nos objetivos do cliente.
Perseguir um único número de precisão. A precisão geral esconde que "rastrear pedido" acerta 98% e "cancelar assinatura" acerta 60%. Meça por intenção e pondere pelo volume e pelo custo de um erro.
Nenhum tratamento para o que está fora do escopo. Como os autores do CLINC150 constataram, os classificadores têm dificuldade com consultas fora das suas intenções conhecidas (Larson et al., arXiv). Sem um fallback explícito, as mensagens fora da lista são forçadas para o rótulo errado.
Rotular apenas a primeira mensagem. Os clientes muitas vezes começam vagos e esclarecem depois. Guarde tanto a intenção inicial quanto a final.
Usar a intenção como único sinal. Combine-a com sentimento, categoria do cliente e canal. A mesma intenção merece tratamento diferente para um usuário em teste e para uma conta enterprise.

Customer Success Operations Manager
On this page
- Fatos Principais
- O que é, de fato, uma intenção
- Como funciona a detecção de intenção
- Classificadores treinados
- Classificação baseada em LLM
- Limiares de confiança e fallback
- Construindo uma taxonomia de intenções
- Comece pelos dados, não pelo organograma
- Escolha a granularidade certa
- Nomeie as intenções como objetivos do cliente
- Inclua sempre um balde "outros" e vigie-o
- Defina uma cadência de revisão
- Usando as intenções em roteamento e relatórios
- Roteamento
- Relatórios
- Exemplos por função
- Implementação passo a passo
- Armadilhas a evitar