Meramal CSAT dengan AI: Menilai Setiap Perbualan Tanpa Tinjauan
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
CSAT yang diramal ialah anggaran tentang sejauh mana seorang pelanggan berpuas hati dengan perbualan sokongan, dihasilkan oleh model yang membaca perbualan dan metadatanya dan bukannya menunggu pelanggan mengisi tinjauan. Outputnya biasanya skor (sering 1 hingga 5, untuk sepadan dengan skala tinjauan) atau kebarangkalian bahawa pelanggan akan menilai interaksi itu sebagai baik. Oleh sebab tiada pelanggan perlu membalas, ia boleh meliputi hampir setiap perbualan.
Liputan itulah keseluruhan tawarannya, dan ia juga perangkapnya. Tinjauan memberitahu anda apa yang dikatakan pelanggan. Ramalan memberitahu anda apa yang diteka oleh model bahawa pelanggan akan katakan, berdasarkan corak dalam perbualan lepas. Itu dua perkara yang berbeza, dan jurang antara keduanya ialah tempat pasukan menghadapi masalah. Panduan ini membincangkan cara CSAT yang diramal dan pemarkahan sentimen berfungsi, bagaimana ia dibandingkan dengan CSAT tinjauan, dan cara menyemak skor yang diramal terhadap hasil tinjauan sebenar sebelum anda membiarkannya mengemudi keputusan. Ia terletak dalam koleksi AI for Customer Service, jadi gambaran keseluruhan AI dalam perkhidmatan pelanggan memberi gambaran yang lebih luas.
Satu sempadan dahulu. Menilai betapa baik seorang ejen mengendalikan perbualan berdasarkan rubrik ialah tugas yang berbeza, dibincangkan dalam jaminan kualiti (QA) AI untuk sokongan. Artikel ini mengenai hasil pelanggan: adakah mereka berpuas hati, dan bagaimana kita tahu tanpa bertanya?
Fakta Utama
- CX Score Intercom, alternatif CSAT tinjauan yang dijana AI, menilai perbualan yang ditutup dari 1 hingga 5 dengan menilai satu set sebab bernama secara bebas, kemudian menggabungkan yang tidak neutral. Perbualan telefon tidak dinilai (Intercom).
- Intercom menerangkan CSAT tinjauan sebagai menangkap maklum balas daripada kumpulan kecil yang memilih diri sendiri, yang sering mewakili pendapat ekstrem secara berlebihan (pandangan vendor) (Intercom).
- Kerja akademik tentang pemodelan kepuasan pelanggan menerangkan kadar respons tinjauan sebagai sangat rendah, dan menyatakan bahawa mereka yang tidak menjawab biasanya merupakan bahagian lebih besar daripada pangkalan pelanggan, jadi mengabaikan mereka boleh menyesatkan anggaran (Toronto Metropolitan University).
- Apabila Zendesk melancarkan Satisfaction Prediction pada 2016, ia berkata model itu membaca ratusan isyarat, termasuk huraian teks, bilangan balasan dan jumlah masa menunggu, dan tersedia untuk akaun Enterprise yang menerima sekurang-kurangnya 500 penilaian kepuasan sebulan (Zendesk).
- Penyelidikan tentang penilai LLM mendapati model yang kuat boleh mencapai persetujuan lebih 80% dengan pilihan manusia, tahap yang sama di mana manusia bersetuju sesama mereka, sambil turut menunjukkan bias kedudukan, kepanjangan dan peningkatan diri (Zheng et al., 2023).
- Model yang ditentukur dengan baik ialah model di mana, antara kes yang dinilai hampir 0.8, kira-kira 80% sebenarnya positif (dokumentasi scikit-learn).
Mengapa CSAT Tinjauan Sahaja Tidak Mencukupi
CSAT tinjauan itu mudah: selepas perbualan ditutup, hantar permintaan penilaian satu soalan dan laporkan bahagian penilaian yang baik. Ia murah dan pelanggan memahaminya. Tetapi ia mempunyai tiga kelemahan struktur yang tidak dapat diselesaikan sepenuhnya oleh reka bentuk tinjauan sebaik mana pun.
Liputan. Hanya pelanggan yang menjawab dikira. Kadar respons berbeza mengikut saluran, khalayak dan reka bentuk tinjauan, dan penyelidikan yang diringkaskan di atas menyebutnya sangat rendah. Jika anda mengurus sokongan untuk beribu-ribu perbualan seminggu, anda mungkin membuat keputusan perancangan tenaga kerja dan produk berdasarkan sebahagian kecil daripadanya.
Bias pemilihan sendiri. Mereka yang menjawab bukan sampel rawak. Pelanggan yang sangat gembira dan sangat tidak puas hati menjawab; golongan tengah yang besar mengangkat bahu dan pergi. Majoriti yang senyap, termasuk pelanggan yang sedikit jengkel dan secara senyap membatalkan langganan sebulan kemudian, kebanyakannya tidak kelihatan. Penyelidik yang disebut di atas membuat hujah yang sama: mereka yang tidak menjawab cenderung menjadi kumpulan lebih besar, jadi meninggalkan mereka boleh mencondongkan hasil.
Jurang masa dan saluran. Tinjauan selepas utas e-mel ditutup tidak memberitahu apa-apa tentang sembang yang ditinggalkan, atau tiket yang tidak berjawab. Tinjauan juga ketinggalan: anda mengetahui tentang minggu yang buruk pada minggu berikutnya.
CSAT yang diramal menyerang masalah pertama dan ketiga secara langsung. Ia boleh menilai perbualan sebaik sahaja ia ditutup (atau semasa ia masih terbuka) dan tidak bergantung pada respons. Ia tidak menyelesaikan bias secara automatik. Model yang dilatih pada respons tinjauan mewarisi kecondongan tinjauan itu, dan itulah perkara utama untuk diingat sepanjang baki artikel ini.
Cara CSAT yang Diramal Berfungsi
Terdapat dua pendekatan umum, dan banyak produk menggabungkannya.
Pendekatan 1: Model terselia yang dilatih pada sejarah tinjauan anda
Anda mengambil perbualan lepas yang mendapat respons tinjauan, menganggap penilaian sebagai label, dan melatih model untuk meramalnya daripada ciri perbualan. Pelancaran Zendesk pada 2016 ialah contoh jelas reka bentuk ini: model menggunakan isyarat seperti teks tiket, bilangan balasan dan jumlah masa menunggu, dan produk itu menghendaki isi padu minimum penilaian sebulan supaya ada sejarah berlabel yang mencukupi untuk dipelajari (Zendesk). Keperluan isi padu itu ialah peringatan yang berguna: ramalan terselia memerlukan banyak jawapan tinjauan sebenar untuk dipelajari, yang bermakna ia secara senyap bergantung pada data yang sepatutnya digantikannya.
Ciri lazim:
- Isyarat teks: perkataan pelanggan, peralihan sentimen merentasi mesej, frasa seperti "masih tidak berfungsi" atau "kali ketiga saya bertanya".
- Isyarat usaha: bilangan balasan, penugasan semula, serahan antara ejen, bilangan kali pelanggan terpaksa mengulang diri.
- Isyarat masa: masa respons pertama, jumlah masa menunggu, jurang antara balasan.
- Konteks: saluran, topik, peringkat pelanggan, sama ada ini hubungan berulang.
Pendekatan 2: Model bahasa yang membaca perbualan berdasarkan faktor yang ditakrifkan
Produk yang lebih baharu menggunakan model bahasa untuk membaca seluruh transkrip dan menilainya berdasarkan faktor bernama, kemudian menggabungkannya menjadi skor. CX Score Intercom berfungsi dengan cara ini. Ia menilai sebab tertentu (kualiti jawapan, usaha pelanggan, emosi kuat, maklum balas produk atau perkhidmatan, dan maklum balas dasar), menganggap sesuatu sebab neutral jika tiada isyarat kuat, dan menerbitkan penilaian 1 hingga 5 daripada gabungan sebab yang tidak neutral, tanpa pemberat tersembunyi yang mengutamakan satu sebab berbanding yang lain (Intercom). Ia hanya menilai perbualan yang ditutup melalui messenger atau e-mel, yang memberitahu anda sesuatu yang praktikal: setiap produk CSAT yang diramal mempunyai had skop, dan anda perlu tahu had anda.
Sebab lebih penting daripada angkanya. "3.2, didorong oleh usaha pelanggan yang tinggi dan aduan dasar" memberitahu anda apa yang perlu dibaiki.
Di mana pemarkahan sentimen terletak
Analisis sentimen ialah blok binaan di bawah kebanyakan perkara ini. Ia melabelkan nada emosi teks, mesej demi mesej. CSAT yang diramal melangkah lebih jauh: ia menggabungkan nada dengan usaha, hasil dan konteks untuk menganggar keputusan keseluruhan tentang interaksi itu. Sesuatu perbualan boleh bermula dengan marah dan berakhir dengan gembira (pelanggan kecewa, ejen membetulkannya, pelanggan mengucapkan terima kasih). Sentimen peringkat mesej melihat kedua-dua separuh. Ramalan CSAT yang baik memberi pemberat lebih kepada pengakhirannya.
CSAT Tinjauan berbanding CSAT yang Diramal
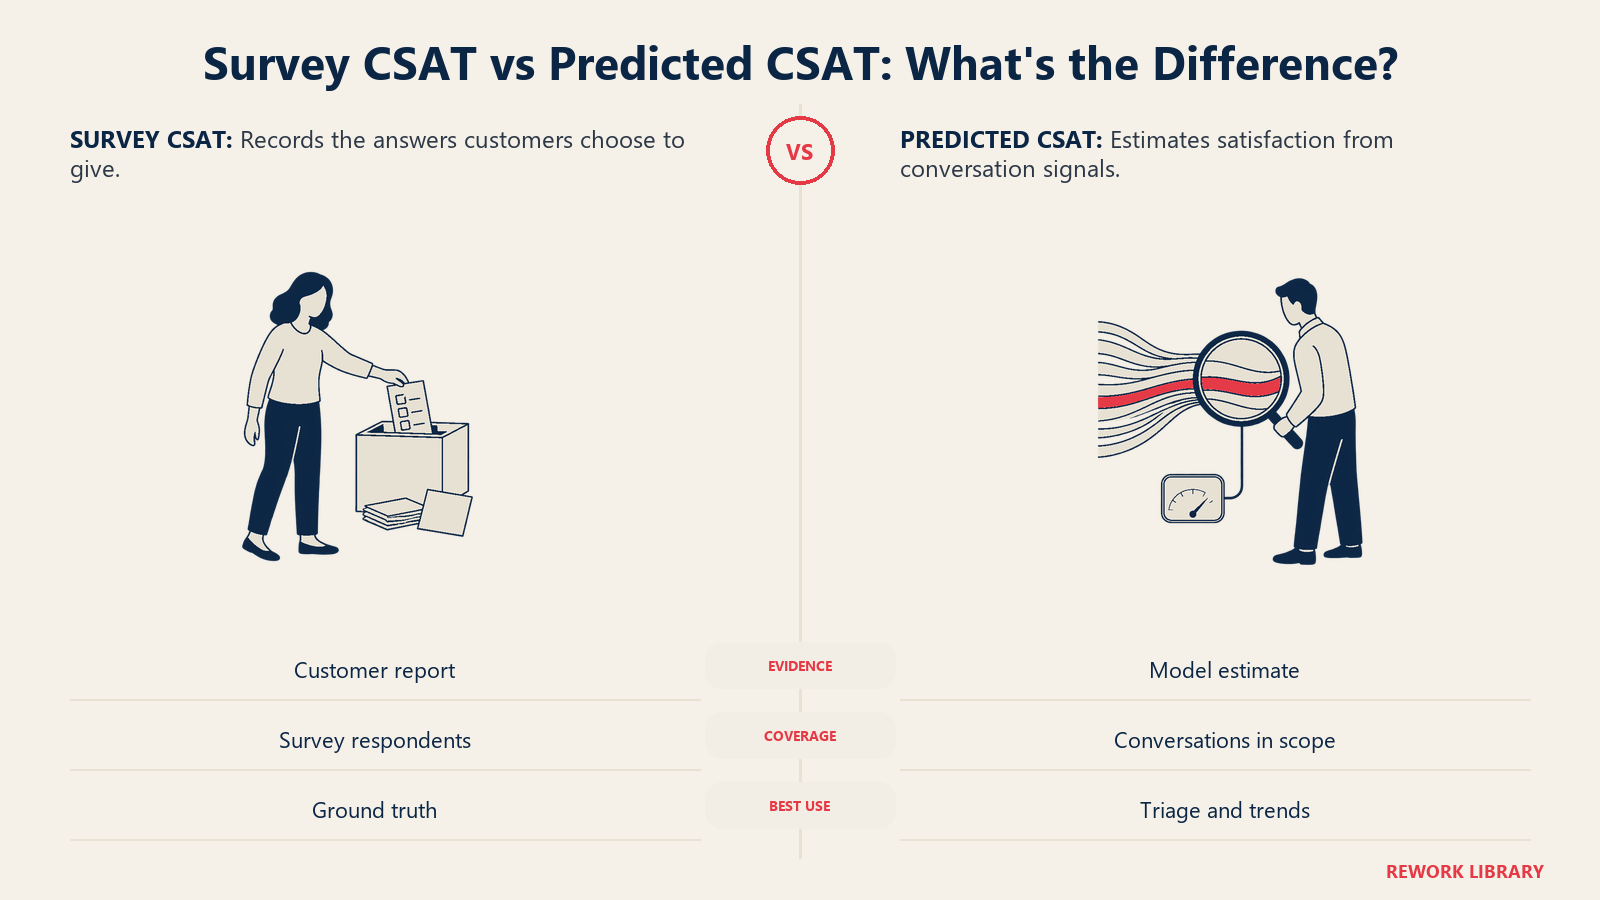
| Dimensi | CSAT tinjauan | CSAT yang diramal |
|---|---|---|
| Apa yang diukur | Apa yang pelanggan katakan mereka rasa | Anggaran model tentang apa yang akan mereka katakan |
| Liputan | Hanya pelanggan yang menjawab | Hampir setiap perbualan dalam skop |
| Bias utama | Pemilihan sendiri, ekstrem terwakili berlebihan | Diwarisi daripada data latihan, ditambah titik buta model |
| Kelajuan | Selepas tinjauan dijawab | Pada atau hampir penutupan perbualan |
| Menerangkan "mengapa" | Hanya jika ada komen teks bebas | Boleh melampirkan sebab dan petikan |
| Baik untuk | Ground truth, pelaporan, penanda aras | Triaj, mengesan trend, mencari masalah senyap |
| Lemah pada | Majoriti senyap, perbualan yang ditinggalkan | Sindiran, konteks yang tidak dapat dilihat model, topik baharu |
Rumusannya bukan "gantikan tinjauan." Ia ialah bahawa kedua-duanya mempunyai ralat yang saling melengkapi. Tinjauan sempit tetapi nyata; ramalan luas tetapi dimodelkan. Apabila digunakan bersama, tinjauan menjadi ground truth yang memastikan ramalan jujur, dan ramalan memanjangkan kebenaran itu kepada perbualan yang tiada siapa nilai.
Contoh Sebenar mengikut Fungsi
Kepimpinan sokongan pelanggan. Seorang pengarah sokongan melihat CSAT tinjauan kekal pada tahap yang sama sepanjang satu suku tahun. Skor yang diramal, yang berjalan pada semua perbualan, merosot mendadak untuk satu topik (katakan, perubahan pengebilan). Tinjauan terlepas pandang kerana sedikit pelanggan itu menjawab. Pengarah itu menghalakan sampel perbualan tersebut kepada penyemak manusia dan menemui punca utama.
Produk dan kejuruteraan. Skor yang dipecahkan mengikut topik dan sebab menjadi senarai berperingkat tentang apa yang mengecewakan pelanggan. Gandingkan dengan ringkasan tiket AI dan pasukan produk mendapat penjelasan ringkas berpetikan bagi setiap kelompok skor rendah dan bukannya hamparan.
Kejayaan pelanggan. CSAT yang diramal rendah pada tiket terkini akaun utama ialah amaran awal yang tidak akan ditonjolkan oleh tinjauan mana pun. Ia satu input antara beberapa input untuk skor kesihatan dan isyarat sokongan yang meramal churn, dan tidak sekali-kali menjadi satu-satunya.
Operasi sokongan dan QA. CSAT yang diramal menentukan perbualan mana yang patut dibaca oleh manusia. Ia isyarat triaj. Perbualan berskor rendah dihantar untuk semakan, dan hasil semakan menyuap semula semakan model. Ia tidak patut digunakan untuk menilai ejen individu (lihat artikel QA yang dipautkan di atas untuk itu).
Perkhidmatan proaktif. Jika perbualan cenderung negatif semasa ia masih terbuka, penyelia boleh campur tangan sebelum ia ditutup.
Cara Mengesahkan Skor yang Diramal terhadap Hasil Tinjauan
Inilah langkah yang dilangkau kebanyakan pasukan, dan ia yang menentukan sama ada angka itu berbaloi digunakan. Prinsipnya: respons tinjauan yang anda ada ialah contoh berlabel. Asingkan sebahagian, jangan sekali-kali latih padanya, dan uji model terhadapnya.
Langkah 1: Bina set holdout
Ambil perbualan yang ditinjau daripada tempoh terkini dan asingkannya. Jika vendor melatih pada sejarah anda, tanya tempoh mana yang digunakan untuk latihan dan pastikan set ujian anda datang selepasnya. Model yang diuji pada perbualan yang dilatihnya akan kelihatan lebih baik daripada hakikatnya.
Langkah 2: Bandingkan pada peringkat perbualan
Bagi setiap perbualan holdout, letakkan skor yang diramal di sebelah penilaian tinjauan sebenar. Mulakan dengan semakan ini:
| Semakan | Apa yang dikatakannya kepada anda | Apa yang perlu dicari |
|---|---|---|
| Persetujuan kedudukan | Adakah model menyusun perbualan seperti yang dilakukan pelanggan? | Skor ramalan yang lebih tinggi patut sejajar dengan penilaian tinjauan yang lebih tinggi |
| Pengelasan baik berbanding buruk | Bolehkah ia memisahkan pelanggan yang berpuas hati daripada yang tidak berpuas hati? | Gunakan ROC AUC, yang meringkaskan seberapa baik skor memisahkan kedua-dua kumpulan dalam satu angka (scikit-learn) |
| Penentukuran | Adakah kebarangkalian bermaksud apa yang dikatakannya? | Antara perbualan yang dinilai hampir 0.8, kira-kira 80% patut dinilai baik (scikit-learn) |
| Ralat mengikut segmen | Adakah ia sama tepat di mana-mana? | Pecahkan hasil mengikut saluran, bahasa, topik, peringkat pelanggan |
Penentukuran wajar diteliti lebih dekat. Plotkan kebarangkalian yang diramal terhadap bahagian sebenar penilaian baik dalam setiap jalur (gambar rajah kebolehpercayaan). Jika garisnya terletak dekat dengan pepenjuru, skor berkelakuan seperti kebarangkalian sebenar. Jika tidak, anda masih boleh menggunakan model untuk penyusunan, tetapi anda tidak patut membaca "0.8" sebagai peluang 80% untuk pelanggan yang gembira.
Langkah 3: Bandingkan pada peringkat agregat
Pelanggan tidak bertindak berdasarkan skor satu perbualan. Pemimpin membaca purata mengikut pasukan, topik dan minggu. Jadi semak juga sama ada purata CSAT yang diramal bagi sesuatu kumpulan menjejaki purata CSAT tinjauan bagi kumpulan yang sama dari semasa ke semasa. Model boleh bising bagi setiap perbualan namun masih berkata benar secara agregat, atau sebaliknya. Uji peringkat yang akan anda gunakan.
Langkah 4: Semak bahagian yang tidak dapat dilihat oleh tinjauan
Soalan sukarnya ialah sama ada model betul tentang perbualan yang tidak pernah mendapat tinjauan. Anda tidak boleh menguji itu secara langsung, tetapi anda boleh menyiasatnya. Ambil sampel rawak perbualan yang tidak ditinjau, minta dua penyemak membacanya secara buta terhadap skor yang diramal, dan bandingkan. Jika penyemak anda banyak tidak bersetuju sesama mereka, itulah siling bagi mana-mana model. Penyelidikan tentang penilai LLM mendapati model yang kuat boleh menyamai kadar di mana manusia bersetuju sesama mereka, iaitu sasaran yang munasabah dan bukan yang sempurna (Zheng et al., 2023). Selain itu, bagi beberapa kes berskor rendah yang tidak ditinjau, buat susulan dengan mesej jangkauan ringkas untuk melihat bagaimana perasaan pelanggan sebenarnya.
Langkah 5: Perhatikan drift
Persetujuan merosot apabila produk, dasar atau campuran bahasa berubah. Jalankan semula perbandingan holdout setiap bulan dan selepas sebarang perubahan besar.
Bias dan Titik Buta yang Diketahui
Kecondongan data latihan. Model terselia belajar daripada mereka yang menjawab. Jika pelanggan ekstrem mendominasi sejarah tinjauan anda, model mempelajari bunyi pelanggan ekstrem dan mungkin tersalah mengendalikan golongan tengah yang senyap. Penyelidik yang mengusahakan masalah ini berhujah bahawa data daripada mereka yang tidak menjawab patut dibawa masuk ke dalam pemodelan dan bukannya diabaikan (Toronto Metropolitan University).
Gaya mengatasi isi. Penilai model bahasa boleh mengutamakan respons yang lebih panjang dan lebih digilap, iaitu bias kepanjangan yang didokumenkan (Zheng et al., 2023). Dalam sokongan, pertukaran yang panjang lebar dan penuh permohonan maaf boleh kelihatan lebih memuaskan daripada yang ringkas dan menyelesaikan masalah. Semak sama ada CSAT yang diramal mengikut panjang mesej selepas anda mengambil kira hasilnya.
Buta terhadap hasil. Kepuasan sangat bergantung pada sama ada masalah itu benar-benar dibaiki. Model yang hanya melihat perbualan mungkin tidak tahu bayaran balik tidak pernah tiba. Suapkan data penyelesaian jika boleh, dan layan kadar penyelesaian sebagai semakan berasingan.
Bahasa dan budaya. Norma kesopanan, sindiran dan tabiat penilaian berbeza mengikut rantau. Model yang disahkan pada tiket Inggeris memberitahu anda sedikit sahaja tentang tiket Portugis. Sahkan bagi setiap bahasa.
Jurang yang dikendalikan AI. Perbualan yang dikendalikan bot dan yang dikendalikan manusia boleh berkelakuan berbeza: pelanggan mungkin menilainya mengikut piawaian berbeza, dan ketepatan model boleh berbeza antara keduanya. Sahkan kedua-dua kumpulan secara berasingan dan bukannya menganggap satu hasil meliputi kedua-duanya.
Melaksanakan CSAT yang Diramal, Langkah demi Langkah
- Namakan keputusan yang akan disokongnya. Triaj, pelaporan trend, amaran akaun dan bimbingan ejen semuanya memerlukan ketepatan berbeza. Mulakan dengan triaj, kegunaan yang paling bertoleransi.
- Baiki data anda dahulu. Teks tiket yang bersih, tag saluran dan topik yang konsisten, serta hasil penyelesaian menjadikan ramalan lebih baik. Lihat menyediakan data sokongan untuk AI.
- Teruskan tinjauan. Ia ground truth anda. Memotongnya untuk "jimat tinjauan" menyingkirkan satu-satunya cara untuk mengesahkan model.
- Jalankan dalam mod bayang. Nilai perbualan selama beberapa minggu tanpa menunjukkannya kepada pemimpin atau ejen, dan bandingkan dengan hasil tinjauan yang masuk.
- Sahkan dengan lima langkah di atas dan tuliskan ketepatan yang anda temui, mengikut segmen.
- Terbitkan apa itu angka tersebut. Labelkannya "diramal" pada setiap dashboard, di sebelah CSAT tinjauan, jangan sekali-kali digabungkan secara senyap ke dalamnya.
- Tambah sebab, bukan hanya skor. Wajibkan sistem menunjukkan faktor mana yang mendorong skor rendah, dengan petikan yang dipetik.
- Halakan berdasarkannya. Hantar perbualan yang diramal rendah ke barisan gilir manusia dan ambil sampel yang tinggi untuk mengesan keselesaan palsu.
- Semak setiap suku tahun. Jalankan semula ujian holdout, semak jurang segmen, dan henti gunakan kegunaan yang tidak dapat disokong oleh model.
Kesilapan Lazim
Menganggap ramalan sebagai ukuran. Ia anggaran. Dashboard yang menunjukkan CSAT yang diramal dan yang ditinjau sebagai metrik yang sama akan mengelirukan orang pada kali pertama keduanya berbeza.
Menggugurkan tinjauan. Tanpa respons tinjauan yang segar, anda tidak dapat mengesahkan, dan model perlahan-lahan menyimpang daripada apa yang sebenarnya dirasakan pelanggan.
Menggunakannya untuk menilai orang. CSAT yang diramal mencerminkan keadaan pelanggan sama seperti kemahiran ejen: pertikaian pengebilan mendapat skor lebih rendah daripada set semula kata laluan. Membandingkan ejen berdasarkan skor ramalan mentah menghukum sesiapa yang mendapat barisan gilir yang sukar.
Mengabaikan segmen. Angka keseluruhan boleh kelihatan baik sementara satu saluran atau bahasa secara senyap salah. Sentiasa pecahkan mengikut segmen.

Customer Success Operations Manager
On this page
- Fakta Utama
- Mengapa CSAT Tinjauan Sahaja Tidak Mencukupi
- Cara CSAT yang Diramal Berfungsi
- Pendekatan 1: Model terselia yang dilatih pada sejarah tinjauan anda
- Pendekatan 2: Model bahasa yang membaca perbualan berdasarkan faktor yang ditakrifkan
- Di mana pemarkahan sentimen terletak
- CSAT Tinjauan berbanding CSAT yang Diramal
- Contoh Sebenar mengikut Fungsi
- Cara Mengesahkan Skor yang Diramal terhadap Hasil Tinjauan
- Langkah 1: Bina set holdout
- Langkah 2: Bandingkan pada peringkat perbualan
- Langkah 3: Bandingkan pada peringkat agregat
- Langkah 4: Semak bahagian yang tidak dapat dilihat oleh tinjauan
- Langkah 5: Perhatikan drift
- Bias dan Titik Buta yang Diketahui
- Melaksanakan CSAT yang Diramal, Langkah demi Langkah
- Kesilapan Lazim