Previsão com IA para volume de suporte e dimensionamento de equipe
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
A previsão de volume de suporte é a prática de estimar quantos contatos de clientes chegarão em cada intervalo (em geral de 30 minutos ou de uma hora) e depois converter essa estimativa no número de agentes de que você precisa no turno para atingir uma meta de nível de serviço. São dois trabalhos colados: uma previsão de demanda e um cálculo de dimensionamento que transforma demanda em pessoas. A IA melhora sobretudo o primeiro. O segundo continua sendo a matemática clássica de filas, e ela não perdoa quando a previsão erra.
Essa é a parte que os gestores tendem a deixar passar. Uma previsão 5% abaixo do real não produz um problema de serviço de 5%, ela pode produzir uma fila que foge do controle. Este guia cobre como funciona a matemática do dimensionamento (o Erlang C e seus limites), como medir a acurácia da previsão com honestidade, quando o machine learning supera uma linha de base simples e como a deflexão (desvio de solicitações) por IA muda tanto o volume quanto a composição do que sobra. Ele faz parte da coleção AI for Customer Service, então a visão geral de IA no atendimento ao cliente é o lugar para começar se você quiser o quadro mais amplo.
Fatos Principais
- O modelo Erlang C pressupõe chegadas de Poisson, tempos de atendimento exponenciais, uma taxa de chegada constante dentro de cada intervalo e que bloqueio, abandono e novas tentativas sejam ignorados (Gans, Koole e Mandelbaum).
- O exemplo do mesmo artigo: uma central planejada para 95% de utilização cuja taxa de chegada vem 5% maior vê a utilização subir para 99,75%, e os tempos de espera explodem ou o abandono excede em muito o planejado (Gans, Koole e Mandelbaum).
- O shrinkage (tempo programado em que o agente não está disponível) de uma central de contato costuma ficar entre 25% e 40% do tempo programado, com médias em torno de 30 a 35% (NICE).
- Orientação dos manuais de previsão: referências simples, como o naive sazonal, devem ser superadas antes de valer a pena considerar um método mais sofisticado (Hyndman e Athanasopoulos, FPP3).
- Em uma grande comparação entre métodos estatísticos e de machine learning, os métodos de machine learning foram superados em ambas as medidas de acurácia e em todos os horizontes de previsão examinados, e exigiram muito mais computação (Makridakis et al., PLOS ONE).
Da previsão à quantidade de pessoas: o que o Erlang C faz
O Erlang C é o cavalo de batalha do dimensionamento de centrais de contato. Você informa uma taxa de chegada, um tempo médio de atendimento e uma meta, e ele diz de quantos agentes você precisa naquele intervalo. A revisão do campo feita por Gans, Koole e Mandelbaum descreve a prática comum: rodar o modelo Erlang C em cada intervalo de meia hora, tratar cada um como um estado estacionário e usar a taxa de chegada e o tempo de atendimento previstos para obter um nível-alvo de pessoal para o período. Esses números por intervalo alimentam então o modelo de escala (Gans, Koole e Mandelbaum).
Quatro termos fazem a maior parte do trabalho:
- Tráfego (em Erlangs) é a carga de trabalho. Os contatos no intervalo vezes o tempo médio de atendimento, divididos pela duração do intervalo. 120 contatos de 300 segundos cada em uma meia hora de 1.800 segundos dão 120 x 300 / 1.800 = 20 Erlangs. Em termos simples, você precisa de 20 agentes só para acompanhar o ritmo.
- Nível de serviço é a parcela dos contatos atendidos dentro de um limite, como 80% em 20 segundos.
- Taxa de ocupação é a parcela do tempo do agente gasta atendendo contatos. Com 25 agentes carregando 20 Erlangs, a ocupação é 20 / 25 = 80%.
- Shrinkage é a parcela do tempo remunerado em que os agentes não estão disponíveis: pausas, treinamento, reuniões, ausências. A NICE o define como as horas perdidas em atividades não produtivas divididas pelo total de horas programadas e o divide em shrinkage interno (planejado) e externo (não planejado) (NICE).
Um exemplo prático
Digamos que uma fila espere 120 contatos em meia hora, com tempo médio de atendimento de 300 segundos, e que você queira 80% atendidos em até 20 segundos. Usando as fórmulas padrão do Erlang C, os números saem assim:
| Agentes na fila | Taxa de ocupação | Nível de serviço (atendidos em 20 s) | Tempo médio de resposta |
|---|---|---|---|
| 22 | 91% | 50,3% | 85 segundos |
| 23 | 87% | 66,0% | 42 segundos |
| 24 | 83% | 77,2% | 22 segundos |
| 25 | 80% | 85,0% | 13 segundos |
| 26 | 77% | 90,4% | 7 segundos |
Vinte e quatro agentes ficam abaixo da meta, vinte e cinco a atingem. Agora acrescente o shrinkage. Com 30% de shrinkage, 25 agentes produtivos significam 25 / (1 - 0,30) = 35,7, então você escalaria 36 pessoas para aquela meia hora.
E aqui está o risco da previsão no mesmo exemplo. Se o volume vier 5% acima do planejado (126 contatos em vez de 120) e você dimensionou 25 agentes, o nível de serviço cai de 85,0% para cerca de 76,5%. Um erro de 5% no volume o levou para baixo da meta. Com 24 agentes, o mesmo erro de 5% empurra o nível de serviço para cerca de 65%. A curva é íngreme, e é exatamente isso que o artigo de Gans alerta: como o desempenho é uma função convexa da taxa de chegada, o desempenho real sob uma previsão incerta tipicamente será pior do que o planejado, e não igual a ele (Gans, Koole e Mandelbaum).
Onde o Erlang C falha
O Erlang C é um modelo, e o modelo tem limites conhecidos. A própria lista da revisão é a que convém ter à mão: taxas constantes dentro de um intervalo, chegadas de Poisson, tempos de atendimento exponenciais e bloqueio, abandono e novas tentativas ignorados (Gans, Koole e Mandelbaum). Na prática, isso significa:
- Nenhum abandono. O Erlang C finge que todo cliente espera o tempo que for preciso. Clientes reais desligam ou fecham o chat. A mesma revisão observa que, sem abandono, uma taxa de chegada acima da capacidade faz a fila crescer sem limite, enquanto os modelos que incluem abandono permanecem estáveis e permitem trocar capacidade por abandono e atraso.
- Taxas de chegada conhecidas. Ele trata a previsão como a verdade. Como o artigo coloca, a taxa de chegada é prevista a partir de dados históricos e não é conhecida com certeza, e ignorar isso pode ser arriscado.
- Um contato por vez. A fórmula clássica serve para canais de contato único, como o telefone. Os agentes de chat e de mensagens conduzem várias conversas ao mesmo tempo, e o e-mail é assíncrono, então as equipes costumam ajustar com um fator de concorrência ou usar outros modelos. Trate a tabela acima como o caso da voz.
- Agentes idênticos. Recém-contratados e veteranos não atendem na mesma velocidade, e o tempo de atendimento muda com a composição dos assuntos.
Nada disso torna o Erlang C inútil. Torna-o uma boa primeira estimativa que precisa de uma folga e de um ciclo de feedback. Muitas equipes adicionam uma margem de segurança acima do número do Erlang, e o melhor trabalho de previsão se concentra em reduzir a incerteza que essa margem precisa cobrir.
Como medir a acurácia da previsão
Antes de comparar qualquer método de previsão, combine a régua. Hyndman e Athanasopoulos definem as medidas padrão em Forecasting: Principles and Practice (FPP3):
| Medida | O que é | Boa para | Cuidado com |
|---|---|---|---|
| MAE | Média dos erros absolutos, em contatos | Fácil de explicar para líderes de operações | Depende da escala, então não dá para comparar uma fila pequena com uma grande |
| RMSE | Raiz quadrada do erro quadrático médio | Penalizar grandes erros | Também depende da escala; mais difícil de interpretar |
| MAPE | Erro percentual absoluto médio | Comparar filas de tamanhos diferentes | Indefinido quando o volume real é zero e extremo perto de zero, como as meias horas da madrugada; penaliza mais os erros negativos do que os positivos |
| MASE | Erro escalado contra uma referência naive | Comparar qualquer método com a linha de base em um único número | Menos familiar para quem não é analista |
Duas consequências práticas. Primeiro, o MAPE se comporta mal justamente nos intervalos que as equipes de suporte têm de sobra: faixas tranquilas da madrugada com um punhado de contatos. Informe o MAPE em totais diários ou por hora e use o MAE ou o MASE no nível de meia hora. Segundo, o FPP3 define o MASE de modo que um valor abaixo de 1 significa que você está superando a referência nos dados de treinamento, e, para séries sazonais, essa referência é o método naive sazonal (FPP3). Esse é o número a colocar diante do seu líder de WFM: "somos melhores do que repetir o padrão da semana passada?"
Meça também o viés, não só o erro. Uma previsão 8% alta em um dia e 8% baixa no seguinte tem o mesmo MAE de uma que é sempre 8% alta, mas a segunda é um problema sistemático de excesso de pessoal. Acompanhe também o erro com sinal.
Quando o machine learning supera uma linha de base simples
Comece pela linha de base. O método naive sazonal do FPP3 define cada previsão como o último valor observado na mesma estação (esta terça às 10h se parece com a terça passada às 10h), e a posição do livro é que esses métodos servem como referências, e um método novo que não consegue superá-los não vale a pena ser considerado (FPP3). Para uma fila estável com forte ritmo semanal, um naive sazonal ou um modelo estatístico clássico costuma ser difícil de bater. Um grande estudo com métodos estatísticos e de machine learning constatou que os métodos de ML foram superados em acurácia em todos os horizontes, além de exigirem muito mais computação (Makridakis et al., PLOS ONE). Encare as promessas de fornecedores de "previsão com IA" tendo esse resultado em mente.
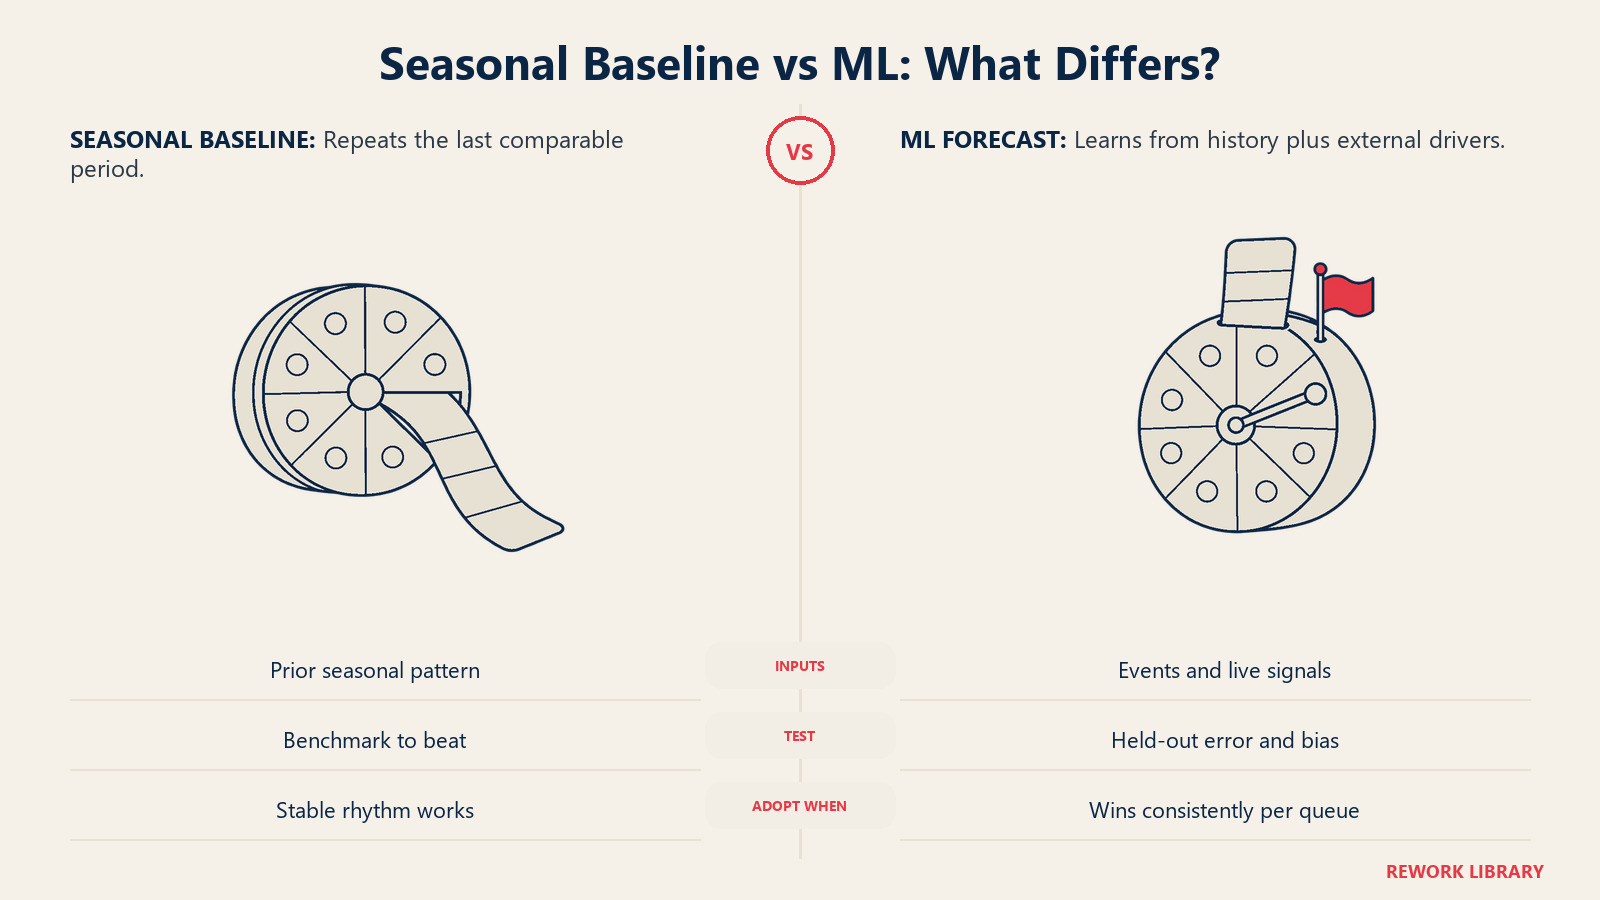
Então onde o ML se justifica? Onde o histórico sozinho não basta e sinais externos explicam as oscilações:
- Fatores conhecidos. Lançamentos de produto, ciclos de cobrança, envios de marketing, quedas e mudanças de preço criam volume que o padrão da semana passada não consegue prever. Os modelos de ML podem receber esses fatores como entradas (um calendário de eventos planejados, um indicador de incidente, o número de clientes recém-faturados).
- Muitas filas ao mesmo tempo. Se você prevê por idioma, nível e canal, um modelo que aprende padrões compartilhados entre as séries pode ajudar nas mais finas, em que cada série tem pouco histórico.
- Correção intradiária. Um modelo que observa as primeiras horas de hoje e refaz a previsão do restante consegue captar um pico cedo. É um padrão de detecção de anomalias: ingerir um fluxo ao vivo, compará-lo com uma linha de base, sinalizar o outlier e alertar um planejador.
- Motivos de contato. Se a detecção de intenção marca cada contato pelo motivo, você pode prever "disputa de fatura" e "redefinição de senha" separadamente, o que é muito mais útil do que um total único.
Uma forma sólida de decidir: rode a linha de base e o modelo de ML lado a lado em pelo menos algumas semanas de dados reservados para teste, compare pelo MASE e adote o ML apenas onde ele vence de forma consistente, e não na média. Um modelo que vence nas semanas comuns e perde nas semanas que importam (lançamentos, quedas) não está ajudando.
Como a deflexão por IA muda o volume e a composição
Quando um agente de IA resolve parte do seu tráfego de entrada, o seu histórico deixa de descrever o seu futuro. Duas coisas mudam.
O volume cai, mas não na mesma proporção. Se a IA atende uma parcela das conversas, a fila humana vê menos contatos. Mas isso depende de como você conta a resolução. Contido não é o mesmo que resolvido, e os clientes que não foram ajudados voltam por outro canal, muitas vezes como contato repetido.
A composição fica mais difícil. Os contatos fáceis saem primeiro: redefinições de senha, status do pedido, dúvidas simples de como fazer. O que sobra é mais longo, mais complexo e mais emocional, então o tempo médio de atendimento sobe. Retome o exemplo prático e suponha que a IA retire 30% do volume (120 contatos viram 84) enquanto os contatos restantes levam 30% mais tempo (390 segundos em vez de 300). A carga de trabalho é 84 x 390 / 1.800 = 18,2 Erlangs, e a meta de 80/20 exige 23 agentes. São dois a menos que 25, uma redução de 8% nos agentes para uma redução de 30% nos contatos. Com 30% de shrinkage, isso dá cerca de 33 escalados em vez de 36.
A conclusão: preveja o volume e o tempo de atendimento separadamente, por motivo de contato. Retreine ou refaça a linha de base depois de qualquer lançamento ou mudança no agente de IA, porque o histórico anterior ao lançamento agora é de outro sistema. E, quando os agentes ganham ferramentas como o agent assist com IA que encurtam o tempo de atendimento nos contatos que restam, isso aparece no AHT, não no volume, então continue acompanhando-o como uma entrada própria.
Como construir isso, passo a passo
- Reúna um histórico limpo. Pelo menos um ano de contagens de contatos por intervalo, canal e motivo de contato, mais os tempos de atendimento. Marque quedas, lançamentos e feriados para que o modelo possa aprender com eles. A preparação dos dados de suporte para a IA trata do trabalho de limpeza.
- Decida a granularidade da previsão. Totais diários para contratações mensais, por hora ou por meia hora para a escala. Não use um único modelo para os dois.
- Defina uma linha de base. Naive sazonal em cada fila. Registre o MAE e o MASE dela. Esse é o número a superar.
- Acrescente fatores. Introduza eventos planejados, calendários de cobrança e indicadores de incidente. Experimente um modelo estatístico com regressores externos antes de um modelo de ML mais pesado.
- Faça backtesting. Compare os métodos em semanas reservadas, incluindo pelo menos uma semana de lançamento ou de queda. Escolha por fila, não de forma global.
- Converta em dimensionamento. Rode o Erlang C (ou uma ferramenta de simulação, se precisar de abandono e de atendimento a vários contatos) por intervalo e depois divida por (1 - shrinkage) para obter a quantidade de pessoas a escalar.
- Adicione uma folga e um ciclo intradiário. Dimensione um pouco acima do número do Erlang nos picos e dê aos planejadores um alerta quando o volume real ficar bem acima da previsão, para que possam remanejar pessoas, oferecer hora extra ou passar trabalho para canais assíncronos.
- Revise todo mês. Acompanhe o MASE, o viés e a taxa de cumprimento do nível de serviço por fila. Refaça a linha de base sempre que o escopo do agente de IA mudar.
Armadilhas a evitar
Usar só o MAPE. Ele esconde o viés e quebra em intervalos de baixo volume. Combine-o com o MAE, o MASE e o erro com sinal.
Prever apenas o total de contatos. Um total plano esconde a mudança de composição. Preveja por motivo de contato e por canal.
Confiar no número do Erlang como exato. É uma estimativa construída sobre premissas que as filas reais violam. Mantenha uma folga e acompanhe o abandono.
Dimensionar pela média diária. O nível de serviço se ganha ou se perde nos intervalos de pico. Planeje intervalo por intervalo.
Ignorar a oscilação do shrinkage. Semanas de treinamento, temporada de gripe e a curva de adaptação dos novatos mudam o shrinkage. Um 30% fixo no modelo é um palpite.
Pular a linha de base. Se você não consegue mostrar que a previsão com IA supera o naive sazonal, está pagando por complexidade. Use a decisão de automatizar ou assistir para delimitar onde a deflexão por IA se aplica antes de cortar os planos de quadro de pessoal em torno dela.
Perguntas frequentes sobre previsão de volume de suporte com IA
O que é o Erlang C no suporte ao cliente?
O Erlang C é uma fórmula de teoria das filas que estima de quantos agentes você precisa em um intervalo para atingir um nível de serviço, dados o volume de contatos e o tempo médio de atendimento. Ele pressupõe chegadas de Poisson e tempos de atendimento exponenciais e ignora abandono e novas tentativas, então trate a resposta dele como um ponto de partida com uma folga.
Qual precisão uma previsão de volume de suporte precisa ter?
Não existe um número universal, porque depende de quão perto da capacidade você opera. Quanto mais a sua ocupação se aproxima de 100%, mais um pequeno erro machuca: em uma revisão muito citada, uma central planejada para 95% de utilização que recebe 5% mais volume chega a 99,75% de utilização. Meça o seu próprio erro e viés por fila e defina as metas a partir daí.
O que é shrinkage e por que ele importa para o dimensionamento?
Shrinkage é a parcela do tempo remunerado em que os agentes não estão disponíveis para atender contatos, por causa de pausas, treinamento, reuniões e ausências. A NICE aponta o shrinkage típico de uma central de contato entre 25% e 40%. Você divide os agentes produtivos que o Erlang C fornece por (1 menos o shrinkage) para obter a quantidade de pessoas que realmente precisa escalar.
O machine learning é melhor do que métodos simples para prever o volume de suporte?
Não automaticamente. A orientação de previsão diz que os métodos novos devem ser comparados com referências simples, como o naive sazonal, e um grande estudo comparativo constatou que os métodos de machine learning foram superados em acurácia e exigiram muito mais computação. O ML tende a ajudar quando fatores externos (lançamentos, ciclos de cobrança, incidentes) explicam as oscilações, então teste-o contra a linha de base fila por fila.
Qual medida de acurácia da previsão devo usar?
Use mais de uma. O MAE é fácil de explicar, o MASE diz se você superou uma referência naive (abaixo de 1 significa que sim) e o MAPE é útil para comparar filas de tamanhos diferentes, mas quebra em intervalos próximos de zero. Acompanhe também o erro com sinal, para ver se você está consistentemente acima ou abaixo.
Como a deflexão por IA muda a previsão de dimensionamento?
Ela reduz o volume de contatos, mas em geral aumenta o tempo de atendimento dos contatos que restam, porque os simples saíram. Preveja o volume e o tempo de atendimento separadamente por motivo de contato e refaça a linha de base depois de qualquer mudança no escopo do agente de IA.

Customer Success Operations Manager
On this page
- Fatos Principais
- Da previsão à quantidade de pessoas: o que o Erlang C faz
- Um exemplo prático
- Onde o Erlang C falha
- Como medir a acurácia da previsão
- Quando o machine learning supera uma linha de base simples
- Como a deflexão por IA muda o volume e a composição
- Como construir isso, passo a passo
- Armadilhas a evitar