Análise de causa raiz com IA para suporte: descobrindo por que os tickets acontecem
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
A análise de causa raiz com IA para suporte é a prática de usar modelos de linguagem para agrupar milhares de tickets pelo motivo de fundo que levou os clientes a escrever, atribuir um custo a cada motivo e enviar os maiores para a equipe de produto ou de operações que pode eliminá-los. O objetivo não é responder aos tickets mais rápido. É impedir que eles existam.
A maioria dos dashboards de suporte informa o que aconteceu: volume por canal, tempo de resposta, CSAT. Pouquíssimos dizem por quê. E o "porquê" é onde está o dinheiro, porque uma equipe de suporte pode ser perfeitamente eficiente ao responder a uma pergunta que uma correção de produto de uma linha teria eliminado. Este artigo mostra como a IA encontra causas, como calcular o custo delas com uma fórmula que você pode rodar em uma planilha e como entregar os achados a quem pode agir. Ele faz parte da coleção AI for Customer Service e pressupõe que os seus tickets estejam razoavelmente limpos (veja a preparação dos dados de suporte para a IA se não estiverem).
Fatos Principais
- O BERTopic, uma abordagem de código aberto muito usada, constrói tópicos em três movimentos: incorpora os documentos com um transformer pré-treinado, agrupa essas incorporações e depois descreve cada cluster com um procedimento de TF-IDF baseado em classes (Grootendorst, 2022).
- O Sentence-BERT reduziu o tempo para encontrar o par mais semelhante em uma coleção de 10.000 frases de cerca de 65 horas com o BERT puro para cerca de 5 segundos, o que tornou prático o clustering (agrupamento) baseado em incorporações de grandes conjuntos de texto (Reimers e Gurevych, 2019).
- A alocação latente de Dirichlet (LDA), o modelo de tópicos clássico, trata cada documento como uma mistura de tópicos, em vez de atribuí-lo a exatamente um (Blei, Ng e Jordan, JMLR, 2003). Isso combina com tickets que mencionam dois problemas ao mesmo tempo.
- O clustering baseado em densidade, como o HDBSCAN, deixa alguns documentos sem atribuição. No BERTopic, esses outliers recebem o rótulo -1 e não são usados para construir as descrições dos tópicos (documentação do BERTopic).
- O k-means exige que o número de clusters seja definido de antemão e tende a produzir grupos de tamanho aproximadamente igual, enquanto o clustering aglomerativo permite definir um limite de similaridade em vez disso (documentação do Sentence Transformers).
- Os modelos de incorporação padrão do BERTopic incluem uma opção multilíngue que cobre mais de 50 idiomas (documentação do BERTopic).
Por que tags e dashboards não enxergam a causa
A maioria das equipes já "categoriza" tickets. O problema é como.
As tags escolhidas pelos agentes são ruidosas. Um agente sob pressão escolhe a opção mais próxima em uma lista longa. "Cobrança" acaba reunindo pedidos de reembolso, dúvidas fiscais, pagamentos que falharam e confusão com o plano, que têm quatro correções diferentes. As tags também são escolhidas pelo que é fácil, não pelo que é preciso.
As taxonomias fixas ficam congeladas. As categorias foram escritas há um ano. Uma nova versão cria um novo problema, e ele cai em "Outros" por seis semanas antes que alguém perceba.
Registram-se sintomas, não causas. "O cliente não consegue entrar" é um sintoma. A causa pode ser um link de convite expirado, uma configuração incorreta de SSO ou uma regra de senha confusa. Três causas, três responsáveis, uma tag.
A IA muda isso porque lê as palavras que os clientes realmente usaram, mais as respostas do agente, e agrupa os tickets por significado em vez de por rótulo. Um cluster chamado "link de convite expirou antes de o novo contratado abri-lo" é algo em que um gerente de produto pode agir. Uma tag chamada "Acesso à conta" não é.
Como a IA encontra causas raiz
Por baixo do capô, a maioria dos fluxos modernos segue as mesmas quatro etapas. Entendê-las ajuda a avaliar as promessas de um fornecedor ou a construir uma versão pequena por conta própria.
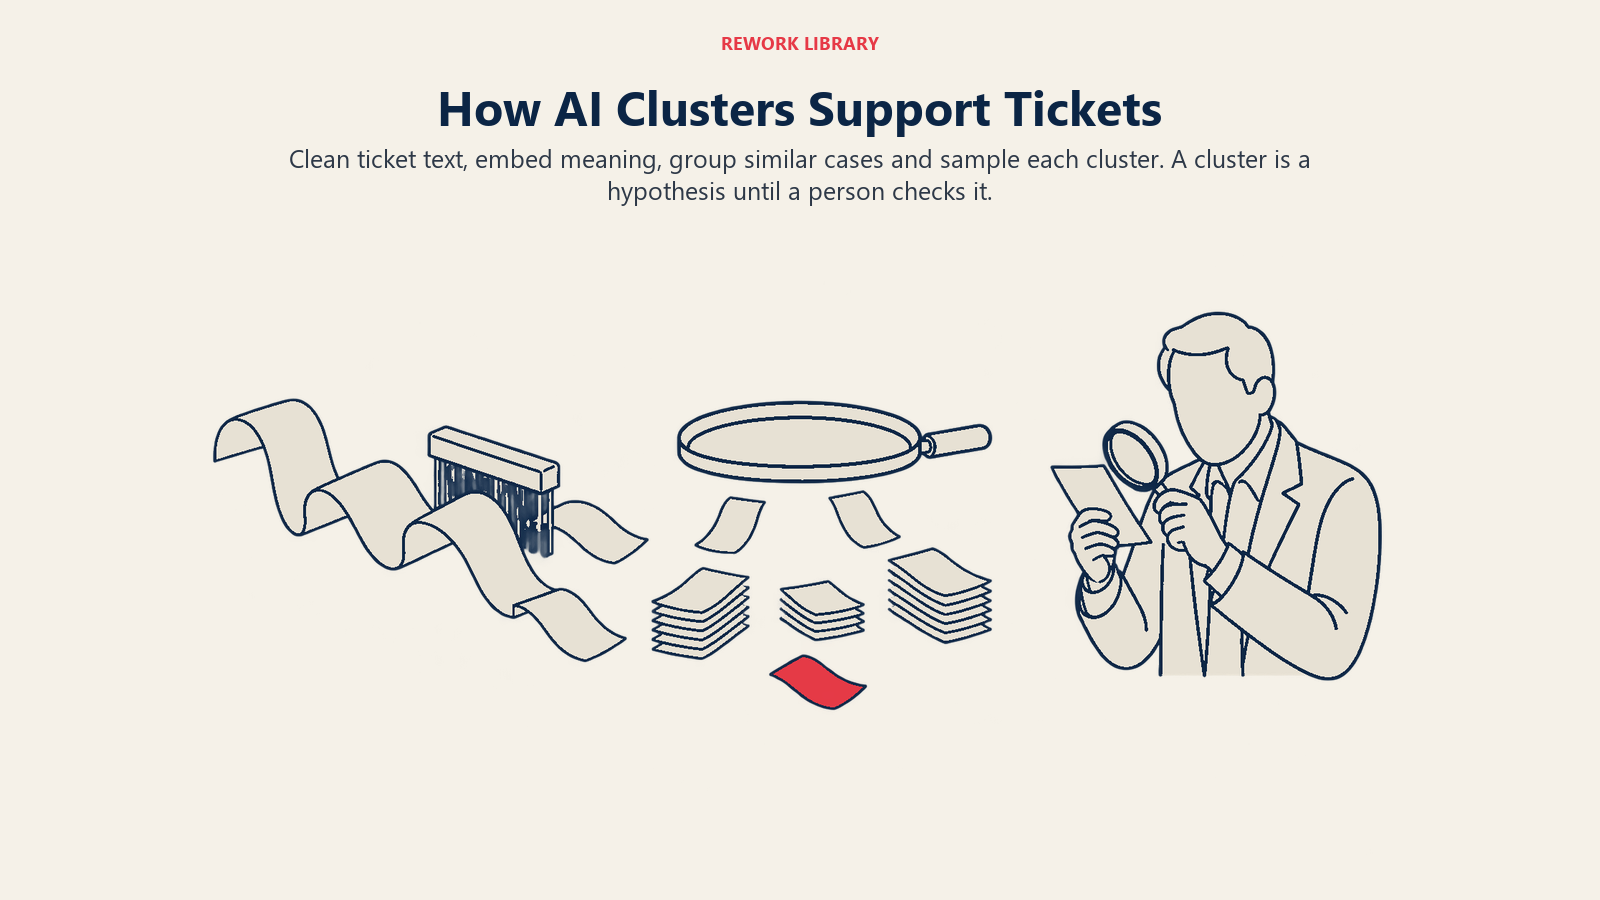
Etapa 1: prepare o texto
Reúna a primeira mensagem do cliente, a nota de resolução final do agente e qualquer resumo interno. Remova assinaturas, cadeias de respostas citadas e texto padrão. Se os seus tickets são longas conversas em sequência, um resumo de ticket costuma ser uma entrada melhor do que a conversa bruta, porque é curto e trata de uma única coisa.
Etapa 2: transforme cada ticket em uma incorporação
Uma incorporação (embedding) é uma lista de números que representa um trecho de texto de modo que significados parecidos fiquem próximos. "Não consigo entrar" e "o login não para de falhar" acabam perto um do outro, mesmo sem compartilhar nenhuma palavra. Os modelos de incorporação em nível de frase tornaram isso rápido o bastante para grandes volumes de tickets (Reimers e Gurevych, 2019). Se você dá suporte em vários idiomas, escolha um modelo de incorporação multilíngue, para que um ticket em espanhol e um em inglês sobre o mesmo bug fiquem juntos.
Etapa 3: agrupe as incorporações
O clustering agrupa os tickets próximos. O método que você escolhe muda o que você obtém:
| Método | Como funciona | Bom para | Cuidado com |
|---|---|---|---|
| k-means | Você escolhe de antemão o número de clusters | Primeira passada rápida quando você sabe, mais ou menos, quantos temas existem | Força os tickets em grupos de tamanho parecido; tickets estranhos são enfiados no mais próximo |
| Aglomerativo (com limite) | Une tickets semelhantes até atingir um limite de similaridade | Número de temas desconhecido; ajustar grupos mais grossos ou mais finos | Lento em conjuntos muito grandes |
| HDBSCAN (via BERTopic) | Encontra regiões densas e deixa o resto como outliers | Dados reais de tickets, que são bagunçados e desiguais | Muitos tickets podem cair no balde de outliers até você ajustar |
| LDA | Cada ticket é uma mistura de tópicos baseados em palavras | Tickets com vários problemas; listas de palavras transparentes | Trabalha com contagem de palavras, então perde o significado que as incorporações captam |
Os quatro são descritos nas fontes acima (Sentence Transformers, BERTopic, Blei et al.). Para a maioria das equipes de suporte, uma incorporação mais um método baseado em densidade é o padrão prático, porque os dados de tickets são desiguais: um punhado de temas enormes e uma cauda longa de temas pequenos. Um método baseado em centroides, como o k-means, pressupõe grupos mais arrumados do que os que você vai encontrar.
Etapa 4: dê um nome a cada cluster e amostre-o
Um cluster é só uma pilha de tickets até ganhar um nome. Há duas formas de rotulá-lo: listar as palavras mais distintivas (a etapa de TF-IDF baseada em classes do BERTopic faz isso) ou pedir a um modelo de linguagem que leia de 10 a 20 tickets representativos e escreva uma descrição de uma frase. Em qualquer caso, uma pessoa deve ler uma amostra de cada cluster em que você pretende agir. Os modelos às vezes colam tickets que soam parecidos, mas têm causas diferentes, como "não consigo exportar" por um problema de permissão e "não consigo exportar" por um limite de tamanho de arquivo.
Relacionado: se você só precisa classificar o que o cliente quer (reembolso, cancelamento, upgrade) e não por que aconteceu, isso é detecção de intenção. A intenção diz o tipo de pedido. A causa raiz diz o que quebrou a montante.
Como lidar com outliers e clusters bagunçados
Espere imperfeição. Alguns hábitos mantêm o resultado utilizável:
- Olhe o balde de outliers todas as vezes. Tickets sem atribuição não são lixo. Os primeiros sinais de um problema novo costumam estar ali, porque ainda não há tickets semelhantes suficientes para formar um cluster.
- Divida os clusters grandes. Se um cluster concentra 20% do seu volume, provavelmente são várias causas. Rode o clustering de novo dentro dele.
- Una os quase duplicados. Dois clusters com a mesma correção devem ser um único item.
- Rode de novo em intervalos fixos. Uma execução mensal nos últimos 90 dias capta picos sazonais e causados por versões. Uma execução semanal nos últimos 14 dias capta regressões.
Como dar um preço a cada causa
Esta é a etapa que transforma um exercício de mineração de texto em um caso de negócio. Você não precisa de benchmarks do setor de ninguém. Precisa de três números do seu próprio helpdesk e da área financeira.
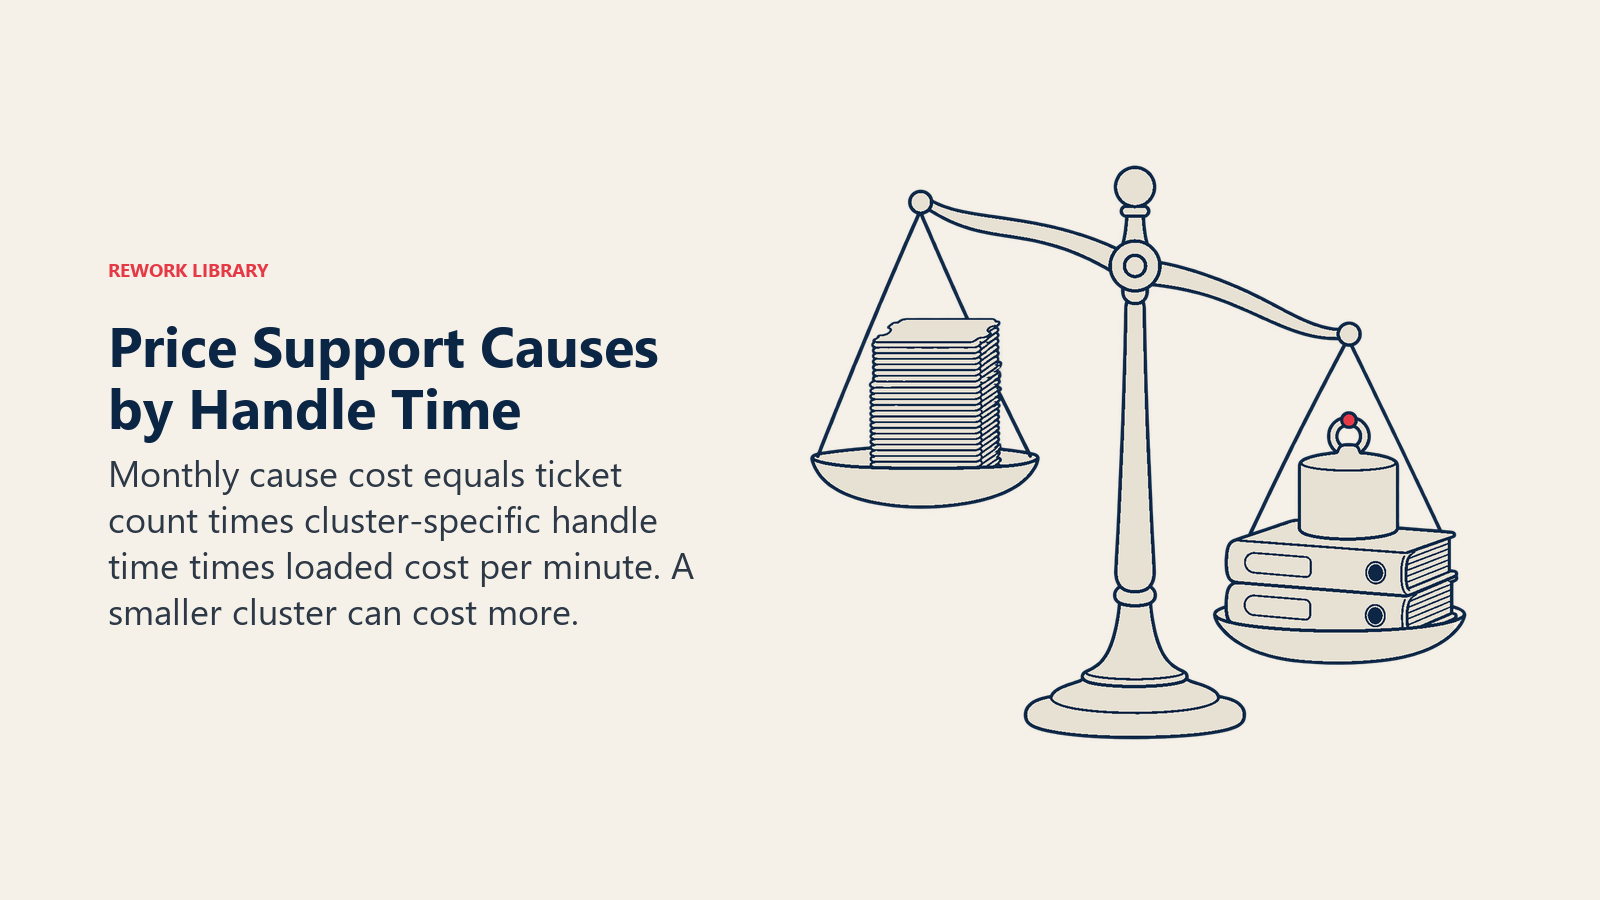
A fórmula:
Custo mensal de uma causa = tickets por mês × tempo médio de atendimento (minutos) × custo total por minuto de agente
- Tickets por mês: o tamanho do cluster, ajustado ao seu volume total se você agrupou uma amostra.
- Tempo médio de atendimento: do seu helpdesk, para os tickets daquele cluster, e não a média da empresa inteira. As causas técnicas costumam levar muito mais tempo do que "onde está o meu pedido".
- Custo total por minuto de agente: o custo total de emprego de um agente (salário, benefícios, ferramentas, despesas de gestão) dividido pelos minutos produtivos que ele trabalha em um mês. Peça esse número à área financeira.
Se você prefere pensar por contato, "tempo de atendimento × custo total por minuto" é o seu custo por contato para aquela causa.
Um exemplo prático
Os números abaixo são inventados para mostrar a aritmética. Substitua pelos seus. Suponha um custo total de $0,75 por minuto de agente.
| Causa (cluster) | Tickets / mês | Tempo médio de atendimento (min) | Custo mensal | Posição por volume | Posição por custo |
|---|---|---|---|---|---|
| Confusão com o status do pedido | 3.000 | 5 | 3.000 × 5 × 0,75 = $11.250 | 1 | 4 |
| E-mail de redefinição de senha não chega | 2.400 | 6 | 2.400 × 6 × 0,75 = $10.800 | 2 | 5 |
| Linha de imposto da fatura pouco clara | 1.200 | 15 | 1.200 × 15 × 0,75 = $13.500 | 3 | 3 |
| Falha ao exportar arquivos grandes | 900 | 22 | 900 × 22 × 0,75 = $14.850 | 4 | 2 |
| Erros de sincronização da integração | 600 | 35 | 600 × 35 × 0,75 = $15.750 | 5 | 1 |
Olhe as duas últimas colunas. A causa com menos tickets é a mais cara, e a mais barulhenta é só a quarta. Uma equipe que corrige por volume ataca primeiro o status do pedido. Uma equipe que calcula o custo das causas ataca primeiro os erros de sincronização. Essa inversão é todo o argumento para fazer essa conta.
Some os custos que a fórmula esconde
O tempo de atendimento subestima. Acrescente o que você consegue medir:
- Contatos repetidos. Se uma causa gera acompanhamentos sobre o mesmo problema, multiplique os tickets pelo número médio de contatos por caso resolvido.
- Escalonamentos. Tickets que chegam à engenharia consomem tempo caro fora do suporte. Some esse tempo pelo custo total do engenheiro.
- Churn e reembolsos ligados à causa. Se os clientes de um cluster cancelam ou pedem créditos com mais frequência, isso entra na conta. A sua análise de churn talvez já rastreie parte disso.
Mantenha esses itens em colunas separadas. O leitor deve poder ver primeiro o custo puro em tempo de agente e depois o custo mais amplo, para que ninguém ache que o número foi inflado.
Estime quanto vale uma correção
Com o custo mensal em mãos, o valor de uma correção é simples:
Economia mensal = custo mensal × parcela dos tickets que a correção elimina
Se uma correção dos erros de sincronização deve eliminar 70% desses tickets, o exemplo acima dá 0,70 × $15.750 = $11.025 por mês. Isso é uma estimativa, então dê aos seus parceiros de produto uma faixa (digamos, de 40% a 80%) e atualize-a depois do lançamento rodando os clusters de novo. Compare a economia com o esforço de engenharia. É assim que você ganha discussões de priorização com números em vez de anedotas.
Como encaminhar as correções ao responsável certo
Encontrar uma causa não a corrige. A maioria dos insights de suporte morre em um slide porque ninguém é dono do passo seguinte. Embuta o encaminhamento no processo.
| Tipo de causa | Responsável típico | O que entregar | Como é "corrigido" |
|---|---|---|---|
| Bug ou fluxo quebrado | Produto / engenharia | Nome do cluster, número de tickets, custo, 5 tickets de exemplo, passos para reproduzir | O cluster diminui depois do lançamento |
| Interface confusa ou funcionalidade ausente | Design de produto / gestão de produto | Frases literais dos clientes, o que esperavam versus o que aconteceu | Menos tickets, ou um caminho de autoatendimento os substitui |
| Política, preço ou cobrança pouco clara | Financeiro / revenue operations | Qual linha da política causa a confusão, impacto em reembolsos | Política reescrita ou layout da fatura alterado |
| Falha de processo ou de transferência | Operações | Onde o caso travou, taxa de contatos repetidos | Nova etapa, responsável ou SLA implantado |
| Conteúdo de ajuda ausente ou errado | Conteúdo de suporte / equipe de conhecimento | Termos de busca, artigos que falharam, exemplos de tickets | Artigo publicado; a deflexão (desvio de solicitações) melhora (veja busca na central de ajuda) |
| Lacuna de educação do cliente | Customer success / onboarding | Qual segmento pergunta, em que etapa do ciclo de vida | Etapa de onboarding ou dica no produto adicionada |
Algumas práticas fazem a entrega pegar:
- Uma página por causa. Nome, descrição em linguagem simples, tendência de volume, custo mensal, tickets de exemplo (sem os dados do cliente), responsável sugerido e uma sugestão de correção.
- Uma revisão recorrente. Coloque na agenda uma reunião mensal de 30 minutos com produto, operações e suporte. Percorra as cinco principais causas por custo, não por volume.
- Um registro compartilhado. Acompanhe cada causa de "identificada" a "correção lançada" e a "queda do volume de tickets confirmada". Fechar esse último ciclo é o que gera confiança. O artigo dos tickets de suporte ao backlog de produto explica como escrever o pedido para que ele caia em uma fila de engenharia, e encaminhar insights de suporte ao produto com IA mostra como manter o fluxo constante.
- Corrija o conteúdo quando não puder corrigir o produto. Se a engenharia não puder agir neste trimestre, um artigo de ajuda melhor ou um aviso proativo ainda reduz o volume.
Onde isto se encaixa na análise de causa raiz clássica
O clustering com IA responde a "quais são as causas e qual o tamanho de cada uma?". Ele não responde a "por que essa causa existe?". Essa segunda pergunta é onde entram os métodos tradicionais, como os cinco porquês e os diagramas de causa e efeito. O guia de análise de causa raiz cobre essas técnicas. Uma divisão viável: a IA encontra e dimensiona a causa no nível do ticket, e depois um pequeno grupo multifuncional faz a análise de causa raiz humana nas duas ou três principais.
Como implantar, passo a passo
- Escolha um escopo. Uma linha de produto, um canal, os últimos 90 dias. Não comece pela empresa toda.
- Exporte e limpe. Texto do ticket, nota de resolução, tempo de atendimento, canal, área do produto, indicador de escalonamento. Remova os dados pessoais de que você não precisa.
- Rode um primeiro clustering com um modelo de incorporação e um método baseado em densidade. Espere um resultado bagunçado.
- Leia amostras de cada um dos 20 principais clusters. Renomeie, divida e una até os agentes dizerem "sim, isso é real".
- Calcule o custo de cada cluster com a fórmula, usando tempos de atendimento específicos de cada cluster.
- Ordene por custo e acrescente as colunas de contatos repetidos e de escalonamentos.
- Atribua responsáveis e entregue resumos de uma página para os cinco primeiros.
- Rode de novo todo mês e acompanhe o volume de cada cluster em relação à data em que a correção foi lançada.
- Devolva os resultados ao planejamento. Separar os picos causados por lançamentos da demanda em regime estável torna as suas previsões de volume mais fáceis de confiar.
Armadilhas comuns
Tratar clusters como verdade. Um cluster é uma hipótese. Leia os tickets antes de falar dele à engenharia.
Ordenar por volume. Como o exemplo prático mostra, a causa mais barata por ticket costuma ter mais tickets. Ordene por custo.
Usar um único tempo de atendimento para tudo. Uma média da empresa inteira esconde os tickets longos e caros. Use o tempo de atendimento por cluster.
Contar economias que você não consegue confirmar. Informe a economia estimada como uma faixa e depois meça a queda real após a correção.
Pular os outliers. Os problemas novos começam pequenos. Se ninguém olha o balde sem atribuição, você só descobre tarde.
Análise única. As causas mudam a cada versão, então um relatório isolado fica obsoleto rápido.
Culpar os agentes pelo volume causado por uma causa. Se uma causa gera um terço dos tickets longos, o coaching não vai resolver. O produto vai.
Compartilhar tickets brutos sem cuidado. Remova nomes, e-mails e dados de conta antes que os tickets saiam do suporte.
Perguntas frequentes sobre análise de causa raiz com IA para suporte
O que é análise de causa raiz com IA para o suporte ao cliente?
É usar modelos de linguagem para agrupar tickets de suporte pelo motivo de fundo que levou os clientes a entrar em contato, medir quanto cada motivo custa e encaminhar os maiores para a equipe que pode corrigi-los. O foco é eliminar a causa dos tickets, e não apenas respondê-los mais rápido.
Como a IA agrupa tickets de suporte?
A maioria das abordagens transforma cada ticket em uma incorporação, um conjunto de números que capta o seu significado, e depois agrupa os tickets cujas incorporações estão próximas. O BERTopic é um exemplo comum de código aberto: ele incorpora os documentos, agrupa-os e descreve cada cluster com um método de TF-IDF baseado em classes. Abordagens mais antigas, como o LDA, partem de padrões de palavras em vez de significado.
Como calculo o custo de uma causa de tickets?
Multiplique o número de tickets do cluster por mês pelo tempo médio de atendimento daquele cluster, em minutos, e depois pelo seu custo total por minuto de agente. Por exemplo, 600 tickets a 35 minutos e $0,75 por minuto dão $15.750 por mês. Acrescente contatos repetidos, escalonamentos e churn relacionado como linhas separadas.
Por que ordenar as causas por custo e não pelo número de tickets?
O número de tickets favorece perguntas simples e frequentes que levam poucos minutos cada. O custo leva em conta o tempo de atendimento, então um cluster menor de tickets longos e técnicos pode superar um cluster grande de tickets rápidos. Ordenar por custo leva o escasso tempo de engenharia para onde ele economiza mais.
A IA consegue encontrar causas raiz sem nenhuma revisão manual?
Não. O clustering pode unir tickets que soam parecidos, mas têm causas diferentes, e os métodos baseados em densidade deixam alguns tickets sem atribuição. Peça a uma pessoa que leia uma amostra de cada cluster antes de ele ir para produto ou operações e revise os tickets sem atribuição em busca de problemas emergentes.
Com que frequência devemos rodar a análise?
Rode uma passada ampla todo mês nos últimos 90 dias e uma passada mais leve toda semana nos últimos 14 dias, para captar regressões depois de lançamentos. Rode um cluster de novo depois que a correção dele for lançada, para confirmar que o volume realmente caiu.
Quem deve ser o responsável pelas correções?
A equipe que controla a causa: produto e engenharia para bugs e fluxos confusos, financeiro para cobrança e políticas, operações para falhas de processo e a equipe de conhecimento para conteúdo de ajuda ausente. O suporte é dono da análise e do acompanhamento, não de todas as correções.

Customer Success Operations Manager
On this page
- Fatos Principais
- Por que tags e dashboards não enxergam a causa
- Como a IA encontra causas raiz
- Etapa 1: prepare o texto
- Etapa 2: transforme cada ticket em uma incorporação
- Etapa 3: agrupe as incorporações
- Etapa 4: dê um nome a cada cluster e amostre-o
- Como lidar com outliers e clusters bagunçados
- Como dar um preço a cada causa
- Um exemplo prático
- Some os custos que a fórmula esconde
- Estime quanto vale uma correção
- Como encaminhar as correções ao responsável certo
- Onde isto se encaixa na análise de causa raiz clássica
- Como implantar, passo a passo
- Armadilhas comuns