QA com IA para suporte: pontuando cada conversa
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
O controle de qualidade com IA (QA com IA) para suporte é a prática de usar um modelo de linguagem para pontuar, com base em uma rubrica escrita, cada conversa com o cliente conduzida por um agente humano, em vez de pedir que um revisor avalie uma pequena amostra escolhida a dedo. O modelo lê a transcrição, responde às perguntas da rubrica (O agente identificou o problema real? A solução estava correta? O tom foi adequado?) e produz uma pontuação que você pode fatiar por agente, equipe, assunto ou semana.
O atrativo é a cobertura. Um programa de QA manual só consegue ler tantos tickets quantas horas os seus revisores têm, então a maioria das conversas, inclusive algumas das piores, nunca é vista. A IA consegue ler todas. Mas ler tudo não é o mesmo que ler corretamente, e uma pontuação em que os agentes não confiam é pior do que nenhuma pontuação. Por isso este guia cobre três coisas: como o QA com IA funciona, como calibrá-lo com revisores humanos e como mantê-lo justo. Ele faz parte da coleção AI for Customer Service, então a visão geral de IA no atendimento ao cliente é um bom ponto de partida se você quiser o contexto mais amplo.
Fatos Principais
- O produto de QA da Zendesk anuncia "100% de cobertura com o AutoQA" e convida as equipes a parar de selecionar tickets manualmente e a analisar todas as interações (Zendesk). Essa é uma afirmação do fornecedor sobre cobertura, não sobre precisão.
- A própria documentação de configurações da Zendesk diz que suas avaliações automáticas servem apenas como orientação, não devem ser usadas para decisões de desempenho e devem complementar, e não substituir, as avaliações de desempenho feitas por pessoas (Zendesk).
- O kappa de Cohen mede a concordância além do acaso. Na interpretação de McHugh, amplamente citada, de 0,60 a 0,79 é concordância moderada, de 0,80 a 0,90 é forte e acima de 0,90 é quase perfeita (McHugh, Biochemia Medica, 2012).
- Uma pesquisa sobre LLMs como juízes constatou que modelos fortes podem chegar a mais de 80% de concordância com as preferências humanas, a mesma taxa com que os humanos concordam entre si, mas também documentou vieses de posição, de verbosidade e de autovalorização (Zheng et al., 2023).
- Pelo EU AI Act, os sistemas de IA usados para monitorar e avaliar o desempenho e o comportamento de trabalhadores são listados como de alto risco no Anexo III, ponto 4(b) (EU AI Act, Annex III).
Como o QA com IA funciona
O QA tradicional é um ciclo com um gargalo no meio. Um analista de QA escolhe tickets, abre cada um, pontua com base em um scorecard, escreve comentários e envia o feedback ao agente. Como o tempo do analista é fixo, a amostra continua pequena, e a amostragem raramente é aleatória. As pessoas tendem a revisar os tickets que foram escalonados, receberam CSAT baixo ou por acaso são curtos.
O QA com IA mantém o scorecard e substitui a etapa de leitura do analista. O fluxo é este:
- Ingest. Conversas de chat, e-mail, transcrições de voz e tickets chegam com metadados: canal, assunto, agente, nível do cliente, desfecho.
- Analyze. Um modelo lê cada conversa e responde a cada pergunta da rubrica, em geral com uma justificativa curta citada da transcrição.
- Score. As respostas se somam em uma pontuação da conversa e depois em visões por agente, equipe e assunto.
- Route. Conversas com pontuação baixa ou de alto risco vão para um revisor humano. As excepcionais vão para uma biblioteca de coaching.
Essa última etapa é o motivo de isto pertencer ao padrão de pontuação e roteamento do ACE Framework: o modelo não apenas avalia, ele decide quais conversas uma pessoa deve olhar. Bem feito, os seus revisores humanos gastam as horas nos 5% que exigem julgamento, e não nos 95% que não exigem.
A pontuação automática do Zendesk QA vem com categorias padrão como Greeting, Empathy, Spelling and grammar, Closing, Solution offered, Tone, Readability e Comprehension. Algumas são verificações simples de sim ou não, Tone é uma nota ponderada e Readability é uma escala fixa de três pontos (Zendesk). "O agente cumprimentou o cliente?" é quase mecânico. "O agente entendeu o problema do cliente?" exige julgamento. Essa diferença orienta o restante deste artigo.
QA manual versus QA com IA
| Dimensão | QA manual | QA com IA |
|---|---|---|
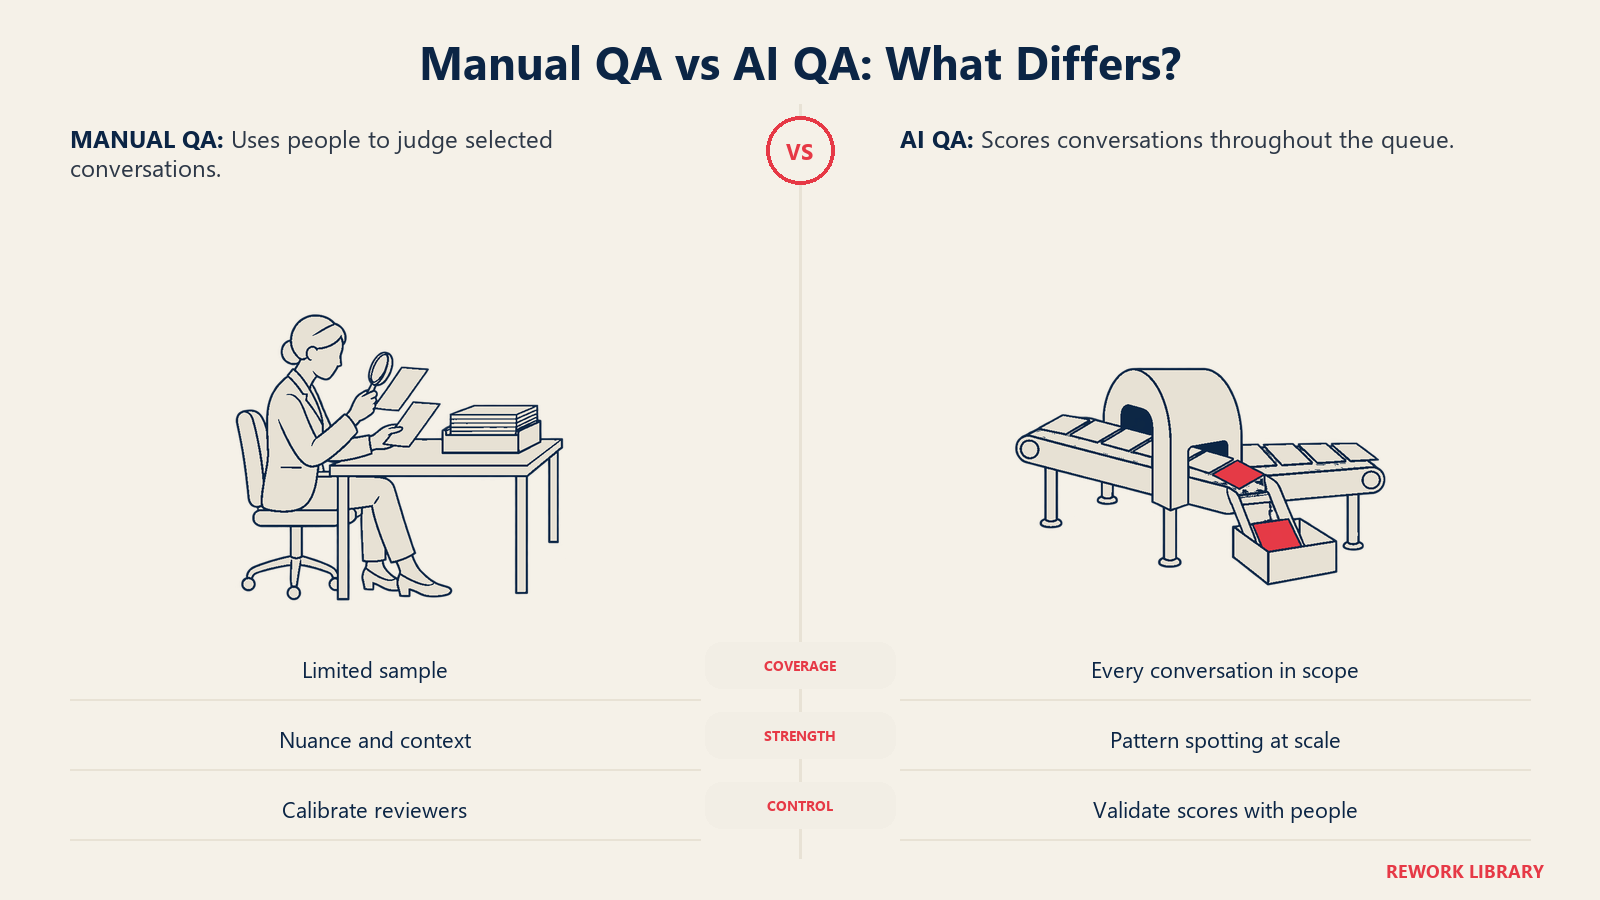
| Cobertura | Uma amostra, escolhida por uma pessoa | Toda conversa dentro do escopo |
| Consistência | Varia conforme o revisor e o humor | Mesmo prompt, mesma rubrica todas as vezes (embora nem sempre a mesma resposta) |
| Melhor em | Nuance, contexto, exceções de política, empatia | Identificar padrões, verificações mecânicas, encontrar casos fora da curva |
| Fraco em | Escala, velocidade, identificar problemas raros | Contexto que não enxerga, sarcasmo, política não escrita |
| Falha típica | Viés de amostragem, deriva do revisor | Pontuações erradas com confiança, viés a favor do estilo em vez da substância |
A conclusão honesta: nenhum substitui o outro. A IA dá amplitude, os humanos dão a ground truth (dados de referência), e o processo de calibração descrito a seguir é o que conecta os dois.
Exemplos reais por função
A rubrica muda conforme o lugar onde a conversa acontece. Alguns casos concretos:
Suporte ao cliente de nível 1. Um cliente escreve sobre uma cobrança em duplicidade. A rubrica verifica se o agente confirmou a identidade, encontrou a duplicidade, explicou o prazo do reembolso e não prometeu algo que a política proíbe. A IA é boa na última verificação: ela consegue sinalizar todas as conversas em que um agente usou uma expressão como "garantido" ou citou um prazo de reembolso que não corresponde à política atual.
Cobrança e recuperação de crédito. A conformidade é o mais importante. A rubrica pode exigir um aviso no início e proibir certas ameaças, e o QA com IA consegue verificar as duas coisas em todas as conversas, enquanto uma amostra manual as pegaria por sorte.
Suporte técnico. O diagnóstico é mais difícil de avaliar automaticamente. Muitas vezes funciona melhor como "sinalizar para revisão se o cliente voltou em uma semana pelo mesmo problema" do que como uma nota absoluta.
Help desk interno de TI. O "cliente" é um funcionário, e as rubricas dão mais peso à qualidade da resolução e a se o agente indicou o artigo certo, o que também expõe lacunas nos seus dados de suporte.
Como desenhar a rubrica
O modelo é tão bom quanto a pergunta que você faz a ele. A maioria dos programas de QA com IA que fracassam falha na rubrica, não no modelo.
Um scorecard viável tem de quatro a oito critérios, cada um escrito como uma pergunta observável e respondível, e não como um traço vago. Compare "O agente foi empático?" com "O agente reconheceu o problema declarado pelo cliente antes de passar para uma solução?". A segunda pode ser verificada na transcrição, e dois revisores têm muito mais chance de concordar sobre ela.
| Critério | Redação fraca | Redação forte | Tipo |
|---|---|---|---|
| Compreensão | "Entendeu o cliente" | "Reformulou ou confirmou o problema real do cliente antes de propor uma correção" | Sim / Não |
| Precisão | "Deu uma boa resposta" | "A solução ou política informada corresponde ao artigo atual da base de conhecimento" | Sim / Não / Não é possível dizer |
| Processo | "Seguiu o procedimento" | "Verificou a identidade antes de compartilhar dados da conta" | Sim / Não / Não se aplica |
| Tom | "Profissional" | "Nenhuma linguagem depreciativa ou acusatória em relação ao cliente" | Sim / Não |
| Encerramento | "Encerrou bem" | "Informou o próximo passo e quem é o responsável, ou confirmou que nada mais era necessário" | Sim / Não |
Duas decisões de desenho compensam. Primeiro, sempre permita "não é possível dizer" ou "não se aplica". Um modelo forçado a escolher sim ou não vai chutar, e chutes diante de contexto ausente são a origem das pontuações injustas. Segundo, pondere os critérios pelo que os clientes realmente sentem. A resolução correta deve pesar mais do que um erro de ortografia.
Calibração: tornando a pontuação confiável
A calibração é a etapa que separa um dashboard com o qual as pessoas discutem de um que elas usam. A ideia é simples: peça a humanos e à IA que pontuem as mesmas conversas, meça com que frequência concordam e corrija as lacunas.
Etapa 1: monte um conjunto de referência
Escolha de 100 a 200 conversas que cubram os seus canais, assuntos e níveis de dificuldade. Inclua algumas fáceis, algumas ambíguas e algumas que você já sabe que correram mal. Peça a pelo menos dois revisores experientes que pontuem cada uma de forma independente e depois reúna-os para resolver as divergências. O resultado é um "conjunto de referência" com respostas acordadas, e as divergências que surgiram pelo caminho têm valor por si só, porque mostram onde a sua rubrica é vaga.
Etapa 2: rode a IA no mesmo conjunto
Pontue o conjunto de referência com o modelo. Compare critério por critério, e não apenas a pontuação total. Um total pode parecer bom enquanto um critério, digamos "Precisão", está silenciosamente errado em metade das vezes.
Etapa 3: meça a concordância do jeito certo
A concordância percentual bruta engana, porque dois avaliadores que dizem "aprovado" na maior parte do tempo vão concordar muitas vezes por acaso. Use o kappa de Cohen, que desconta a concordância por acaso. Eis um exemplo hipotético para mostrar por que isso importa:
| IA diz aprovado | IA diz reprovado | Total | |
|---|---|---|---|
| Revisor diz aprovado | 70 | 10 | 80 |
| Revisor diz reprovado | 10 | 10 | 20 |
| Total | 80 | 20 | 100 |
Os dois concordam em 80 de 100 conversas, então a concordância bruta é de 80%. Mas se ambos aprovam cerca de 80% das conversas, concordariam cerca de 68% das vezes só por sorte. O kappa é (0,80 menos 0,68) dividido por (1 menos 0,68), ou seja, cerca de 0,38. Na escala de McHugh, isso é concordância fraca (McHugh, 2012), embora a manchete diga 80%. Quase toda a "concordância" da IA foi apenas os dois dizendo aprovado.
Calcule o kappa para cada critério e também para os revisores humanos entre si. Esse segundo número é o seu teto. Se os seus dois melhores revisores só chegam a 0,65 entre si, esperar que a IA alcance 0,9 não é realista, e a verdadeira solução é uma rubrica mais clara. A pesquisa sobre LLMs como juízes aponta na mesma direção: modelos fortes podem igualar a taxa com que os humanos concordam entre si, o que é uma meta útil, não uma meta mágica (Zheng et al., 2023).
Etapa 4: corrija as lacunas e teste de novo
Onde a concordância é baixa, você tem três alavancas: reescrever o critério para ser mais concreto, adicionar exemplos práticos (uma transcrição "boa" e uma "ruim") ao prompt ou tirar o critério da pontuação automática e deixá-lo só para humanos. Alguns critérios, como a empatia genuína, talvez nunca alcancem uma concordância aceitável. Pontue o que a IA pontua de forma confiável e deixe o resto para as pessoas.
Etapa 5: continue calibrando
Mantenha uma sessão fixa, semanal ou mensal: um revisor avalia uma nova amostra aleatória sem conhecer a pontuação da IA, e você acompanha o kappa ao longo do tempo. Um número em queda é um alerta precoce de que algo mudou, como uma nova linha de produtos, uma atualização de política ou um novo idioma. Se você opera suporte multilíngue, calibre por idioma, pois a concordância em inglês não diz nada sobre o português.
Justiça: pontuar pessoas é diferente de pontuar tickets
Uma pontuação de QA não é só um dado. Ela alimenta coaching, bônus e, às vezes, avaliações de desempenho. Isso eleva o que está em jogo para erros e vieses, e é a parte que a maioria das equipes planeja menos.
Conheça os vieses conhecidos. A literatura sobre LLM como juiz documenta o viés de posição, o viés de verbosidade (respostas mais longas são favorecidas) e o viés de autovalorização (Zheng et al., 2023). No suporte, o viés de verbosidade tem uma tradução direta: um agente que escreve respostas longas e polidas pode superar um agente que resolve o problema em duas linhas objetivas. Teste isso verificando se a pontuação se correlaciona com o tamanho da mensagem depois de controlar pelo desfecho.
Verifique diferenças entre grupos. Compare as pontuações por tempo de casa, turno, idioma, região e tipo de contato. Algumas diferenças são reais. Outras mostram a rubrica penalizando uma redação de quem não é nativo ou uma fila mais difícil: se os agentes de disputas de cobrança pontuam menos do que os de redefinição de senha, o modelo pode estar avaliando a dificuldade, e não a qualidade. Normalize por assunto antes de comparar pessoas.
Seja transparente com os agentes. Publique a rubrica. Deixe os agentes verem os critérios exatos, as próprias pontuações e o trecho citado que motivou cada julgamento. As pessoas aceitam uma nota baixa quando veem o motivo. Resistem a um número que aparece sem explicação.
Construa um caminho de contestação. Qualquer agente deve poder contestar uma pontuação e conseguir que um humano a analise em um prazo definido. Acompanhe a taxa de reversão. Uma taxa de reversão alta em um critério significa que ele não está pronto para a automação. Devolva os casos revertidos ao seu conjunto de referência.
Mantenha um humano na decisão. Até os fornecedores dizem isso. A documentação da Zendesk afirma que suas avaliações automáticas servem apenas como orientação e devem complementar, e não substituir, as avaliações de desempenho feitas por pessoas (Zendesk). Use a pontuação da IA para decidir quais conversas uma pessoa lê e use o julgamento da pessoa para decidir qualquer coisa que afete remuneração ou emprego.
Conheça a direção regulatória. Na UE, os sistemas de IA destinados a monitorar e avaliar o desempenho e o comportamento de trabalhadores aparecem no Anexo III da lista de alto risco do AI Act (EU AI Act, Annex III), e o Artigo 14 exige que as pessoas que supervisionam esses sistemas permaneçam atentas à tendência de confiar demais no resultado, conhecida como viés de automação (EU AI Act, Article 14). Consulte um assessor jurídico para a sua jurisdição e lembre-se de que conselhos de trabalhadores e leis de monitoramento de funcionários em alguns países acrescentam exigências próprias.
Como implantar o QA com IA, passo a passo
- Defina o propósito. Coaching, conformidade e experiência do cliente pedem rubricas diferentes. Comece por uma.
- Escreva a rubrica com os agentes, e não só com os gestores: de quatro a oito critérios observáveis, com "não é possível dizer" permitido.
- Calibre antes do lançamento. Monte o conjunto de referência e verifique o kappa por critério, como descrito acima.
- Rode em modo sombra por algumas semanas ao lado do seu QA atual, sem mostrar as pontuações aos agentes, ou rotule-as como "beta, não usadas nas avaliações".
- Registre por escrito como as pontuações podem ser usadas. Temas de coaching e quais tickets revisar, sim. Bônus e medidas disciplinares, só depois que a confiança for conquistada.
- Roteie, não apenas reporte. Pontuações baixas, alertas de conformidade e contestações vão para uma fila humana. Conversas de destaque vão para o fluxo de coaching como exemplos.
- Feche o ciclo com os agentes. Mostre os resultados com evidências citadas e um botão de contestação desde o primeiro dia.
- Conecte-o à sua stack. Os achados de QA mostram onde falham as sugestões em tempo real ou os artigos de conhecimento. Para medir um bot voltado ao cliente, veja a taxa de resolução da IA.
- Revise a cada trimestre: rode de novo o conjunto de referência, verifique o kappa e as diferenças de pontuação entre grupos e aposente os critérios que não se sustentam.
Se você ainda está decidindo o que permanece humano, automatizar ou assistir estrutura essa decisão, e como a IA muda os papéis da equipe de suporte trata do que acontece com os analistas de QA: em geral eles deixam de pontuar tickets e passam a cuidar da rubrica, do conjunto de referência e da calibração.
Armadilhas comuns
Confundir cobertura com precisão. "Toda conversa pontuada" não diz nada sobre se as pontuações estão certas. Peça números de concordância com revisores humanos nas suas próprias conversas.
Pontuar o que é fácil, não o que importa. Uma equipe com 98% em cumprimentos e 60% em resolução correta tem um problema de medição, não um sucesso de qualidade.
Pular o "não é possível dizer". Sem ele, o modelo inventa respostas quando a transcrição não tem contexto, como o estado da conta que ele nunca viu.
Ranquear pessoas por pontuações brutas. Agentes em filas difíceis são punidos. Compare dentro do mesmo assunto e trate as diferenças como perguntas a investigar.
Calibração única. A concordância se deteriora conforme produtos e políticas mudam. Agende a recalibração.
Ensinar aos agentes a pontuação, não a habilidade. Se uma frase de empatia aumenta a nota, você vai receber frases de empatia. Mantenha a revisão humana na mistura.
Culpar os agentes por lacunas de conhecimento. Muitas pontuações baixas de precisão remontam a artigos de ajuda desatualizados. Corrija a fonte antes de fazer coaching com a pessoa.
Perguntas frequentes sobre QA com IA para suporte
O que é garantia de qualidade com IA para o suporte ao cliente?
É o uso de um modelo de linguagem para pontuar, com base em uma rubrica escrita, toda conversa conduzida pelos seus agentes humanos, em vez de revisar manualmente uma pequena amostra. As pontuações aparecem por agente, equipe e assunto, e as conversas com pontuação baixa ou arriscadas são encaminhadas a um revisor humano.
O QA com IA pode substituir os revisores de QA humanos?
Não por completo. A IA é boa em cobertura e verificações mecânicas, enquanto as pessoas são melhores em nuance, contexto e exceções de política. A documentação da Zendesk diz que suas avaliações automáticas devem complementar, e não substituir, as avaliações de desempenho feitas por pessoas. A maioria das equipes desloca os revisores para a calibração, as contestações e os critérios mais difíceis.
Como verifico se as pontuações da IA coincidem com as dos meus revisores humanos?
Monte um conjunto de referência de 100 a 200 conversas pontuadas por dois ou mais revisores, rode a IA no mesmo conjunto e compare cada critério usando o kappa de Cohen em vez da concordância percentual bruta. Meça também a concordância entre os revisores, pois esse é o teto realista para a IA.
Qual é um bom valor de kappa para a calibração de QA?
Na interpretação de McHugh, de 0,60 a 0,79 é moderado, de 0,80 a 0,90 é forte e acima de 0,90 é quase perfeito. Para critérios que afetam as avaliações dos agentes, busque concordância forte. Para critérios que só ajudam a escolher quais tickets ler, uma concordância moderada pode ser aceitável.
Como mantenho o QA com IA justo com os agentes?
Publique a rubrica, mostre aos agentes a evidência citada por trás de cada pontuação, compare pessoas dentro do mesmo assunto ou fila, teste vieses como o de favorecer respostas mais longas e dê a todo agente uma forma de contestar. Mantenha um humano em qualquer decisão que afete remuneração ou emprego.
Os agentes devem ser avisados de que a IA pontua as conversas deles?
Sim. A transparência é justa e também prática, pois agentes que entendem a rubrica melhoram mais rápido e contestam menos. Dependendo de onde você opera, as regras de monitoramento de funcionários e de IA, como o tratamento dado pelo EU AI Act aos sistemas de avaliação de trabalhadores como de alto risco, também podem exigir a divulgação, então consulte um assessor jurídico.

Customer Success Operations Manager
On this page
- Fatos Principais
- Como o QA com IA funciona
- QA manual versus QA com IA
- Exemplos reais por função
- Como desenhar a rubrica
- Calibração: tornando a pontuação confiável
- Etapa 1: monte um conjunto de referência
- Etapa 2: rode a IA no mesmo conjunto
- Etapa 3: meça a concordância do jeito certo
- Etapa 4: corrija as lacunas e teste de novo
- Etapa 5: continue calibrando
- Justiça: pontuar pessoas é diferente de pontuar tickets
- Como implantar o QA com IA, passo a passo
- Armadilhas comuns