CSAT mit AI prognostizieren: Jede Konversation bewerten, ganz ohne Umfragen
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Prognostizierter CSAT ist eine Schätzung, wie zufrieden ein Kunde mit einer Support-Konversation war. Sie stammt von einem Modell, das die Konversation und ihre Metadaten liest, statt darauf zu warten, dass der Kunde eine Umfrage ausfüllt. Das Ergebnis ist meist ein Score (oft von 1 bis 5, passend zur Umfrageskala) oder eine Wahrscheinlichkeit, dass der Kunde die Interaktion als gut bewertet hätte. Weil kein Kunde antworten muss, kann er nahezu jede Konversation abdecken.
Diese Abdeckung ist das ganze Verkaufsargument, und zugleich die Falle. Eine Umfrage sagt Ihnen, was ein Kunde gesagt hat. Eine Prognose sagt Ihnen, was ein Modell vermutet, dass ein Kunde gesagt hätte, auf Grundlage von Mustern in früheren Konversationen. Das sind zwei verschiedene Dinge, und in der Lücke dazwischen geraten Teams in Schwierigkeiten. Dieser Leitfaden behandelt, wie prognostizierter CSAT und Sentiment-Scoring funktionieren, wie sie sich zum Umfrage-CSAT verhalten und wie Sie einen prognostizierten Score mit echten Umfrageergebnissen abgleichen, bevor Sie ihn Entscheidungen steuern lassen. Er gehört zur Sammlung AI for Customer Service, daher gibt der Überblick zu AI im Kundenservice das größere Bild.
Zuerst eine Abgrenzung. Zu bewerten, wie gut ein Mitarbeitender eine Konversation anhand eines Bewertungsrasters bearbeitet hat, ist eine andere Aufgabe, die in AI-Qualitätssicherung für den Support behandelt wird. Dieser Artikel handelt vom Ergebnis aus Sicht des Kunden: War er zufrieden, und woher wissen wir das, ohne zu fragen?
Wichtige Fakten
- Der CX Score von Intercom, eine AI-generierte Alternative zum Umfrage-CSAT, bewertet abgeschlossene Konversationen von 1 bis 5, indem er eine Reihe benannter Gründe unabhängig voneinander prüft und dann die nicht neutralen zusammenführt. Telefongespräche werden nicht bewertet (Intercom).
- Intercom beschreibt den Umfrage-CSAT als Rückmeldung einer kleinen, sich selbst auswählenden Gruppe, die oft extreme Meinungen überrepräsentiert (Sicht des Anbieters) (Intercom).
- Wissenschaftliche Arbeiten zur Modellierung der Kundenzufriedenheit beschreiben die Antwortquoten von Umfragen als sehr niedrig und halten fest, dass Nichtantwortende meist den größeren Teil des Kundenstamms stellen, sodass ihr Ausblenden die Schätzungen verzerren kann (Toronto Metropolitan University).
- Als Zendesk 2016 Satisfaction Prediction einführte, hieß es, das Modell lese Hunderte Signale, darunter Textbeschreibung, Zahl der Antworten und gesamte Wartezeit, und stehe Enterprise-Accounts mit mindestens 500 Zufriedenheitsbewertungen pro Monat zur Verfügung (Zendesk).
- Forschung zu LLM-Bewertern ergab, dass starke Modelle über 80% Übereinstimmung mit menschlichen Präferenzen erreichen können, das Niveau, auf dem Menschen untereinander übereinstimmen, zugleich aber Verzerrungen bei Position, Wortreichtum und Selbstbevorzugung zeigen (Zheng et al., 2023).
- Ein gut kalibriertes Modell ist eines, bei dem von den Fällen mit einem Score um 0,8 etwa 80% tatsächlich positiv ausfallen (scikit-learn-Dokumentation).
Warum Umfrage-CSAT allein nicht reicht
Umfrage-CSAT ist einfach: Nach dem Abschluss einer Konversation wird eine Ein-Frage-Bewertungsanfrage verschickt und der Anteil guter Bewertungen berichtet. Er ist günstig und Kunden verstehen ihn. Er hat aber drei strukturelle Schwächen, die sich durch kein Umfragedesign vollständig beheben lassen.
Abdeckung. Nur die Kunden, die antworten, zählen. Die Antwortquoten schwanken nach Kanal, Zielgruppe und Umfragedesign, und die oben zusammengefasste Forschung nennt sie sehr niedrig. Wenn Ihr Support pro Woche Tausende Konversationen bearbeitet, treffen Sie Personal- und Produktentscheidungen womöglich auf Grundlage eines Bruchteils davon.
Selbstselektions-Verzerrung. Die Menschen, die antworten, sind keine Zufallsstichprobe. Sehr zufriedene und sehr unzufriedene Kunden antworten, die große Mitte zuckt mit den Schultern und geht. Die schweigende Mehrheit, darunter der Kunde, der leicht genervt war und einen Monat später still kündigte, bleibt weitgehend unsichtbar. Die oben zitierten Forschenden betonen dasselbe: Nichtantwortende sind tendenziell die größere Gruppe, sodass ihr Ausschluss die Ergebnisse verzerren kann.
Lücken bei Timing und Kanal. Eine Umfrage nach einem abgeschlossenen E-Mail-Thread sagt nichts über den Chat, der abgebrochen wurde, oder das Ticket, das unbeantwortet blieb. Umfragen hinken außerdem hinterher: Von einer schlechten Woche erfahren Sie in der Woche danach.
Prognostizierter CSAT greift das erste und das dritte Problem direkt an. Er kann eine Konversation in dem Moment bewerten, in dem sie schließt (oder solange sie noch offen ist), und er hängt nicht von Antworten ab. Er behebt die Verzerrung nicht automatisch. Ein Modell, das mit Umfrageantworten trainiert wurde, erbt die Schieflage der Umfrage, und das ist das Wichtigste, was Sie im Rest dieses Artikels im Kopf behalten sollten.
So funktioniert prognostizierter CSAT
Es gibt zwei grundlegende Ansätze, und viele Produkte mischen sie.
Ansatz 1: Ein überwachtes Modell, trainiert auf Ihrem Umfrageverlauf
Sie nehmen frühere Konversationen, die eine Umfrageantwort erhalten haben, behandeln die Bewertung als Label und trainieren ein Modell, sie aus Merkmalen der Konversation vorherzusagen. Der Start von Zendesk 2016 ist ein klares Beispiel für dieses Design: Das Modell nutzte Signale wie den Ticket-Text, die Zahl der Antworten und die gesamte Wartezeit, und das Produkt setzte ein monatliches Mindestvolumen an Bewertungen voraus, damit genug beschriftete Historie zum Lernen vorlag (Zendesk). Diese Volumenanforderung ist eine nützliche Erinnerung: Überwachte Prognose braucht viele echte Umfrageantworten zum Lernen und hängt damit stillschweigend von genau den Daten ab, die sie ersetzen soll.
Typische Merkmale:
- Textsignale: die Wortwahl des Kunden, Verschiebungen des Sentiments über Nachrichten hinweg, Formulierungen wie „funktioniert immer noch nicht“ oder „zum dritten Mal frage ich“.
- Aufwandssignale: Zahl der Antworten, Neuzuweisungen, Übergaben zwischen Mitarbeitenden, wie oft der Kunde sich wiederholen musste.
- Zeitsignale: erste Antwortzeit, gesamte Wartezeit, Pausen zwischen Antworten.
- Kontext: Kanal, Thema, Kundenstufe, ob es sich um einen wiederholten Kontakt handelt.
Ansatz 2: Ein Sprachmodell, das die Konversation anhand definierter Faktoren liest
Neuere Produkte nutzen ein Sprachmodell, das das gesamte Transkript liest und es anhand benannter Faktoren beurteilt, die es dann zu einem Score zusammenführt. Der CX Score von Intercom funktioniert so. Er bewertet bestimmte Gründe (Antwortqualität, Kundenaufwand, starke Emotion, Feedback zu Produkt oder Service und Feedback zu Richtlinien), behandelt einen Grund als neutral, wenn kein starkes Signal vorliegt, und leitet aus der Kombination der nicht neutralen Gründe eine Bewertung von 1 bis 5 ab, ohne verdeckte Gewichtung eines Grundes gegenüber einem anderen (Intercom). Er bewertet nur abgeschlossene Konversationen über Messenger oder E-Mail, was etwas Praktisches verrät: Jedes Produkt für prognostizierten CSAT hat Grenzen im Umfang, und Sie müssen Ihre kennen.
Die Gründe sind wichtiger als die Zahl. „3,2, getrieben von hohem Kundenaufwand und einer Beschwerde über die Richtlinie“ sagt Ihnen, was Sie beheben müssen.
Wo Sentiment-Scoring hineinpasst
Die Sentiment-Analyse ist der Baustein unter dem Großteil davon. Sie kennzeichnet den emotionalen Ton von Text, Nachricht für Nachricht. Prognostizierter CSAT geht einen Schritt weiter: Er kombiniert Ton mit Aufwand, Ergebnis und Kontext, um das Gesamturteil über die Interaktion zu schätzen. Eine Konversation kann einen wütenden Beginn und ein glückliches Ende haben (der Kunde war verärgert, der Mitarbeiter hat es behoben, der Kunde bedankte sich). Sentiment auf Nachrichtenebene sieht beide Hälften. Eine gute CSAT-Prognose gewichtet das Ende stärker.
Umfrage-CSAT und prognostizierter CSAT im Vergleich
| Dimension | Umfrage-CSAT | Prognostizierter CSAT |
|---|---|---|
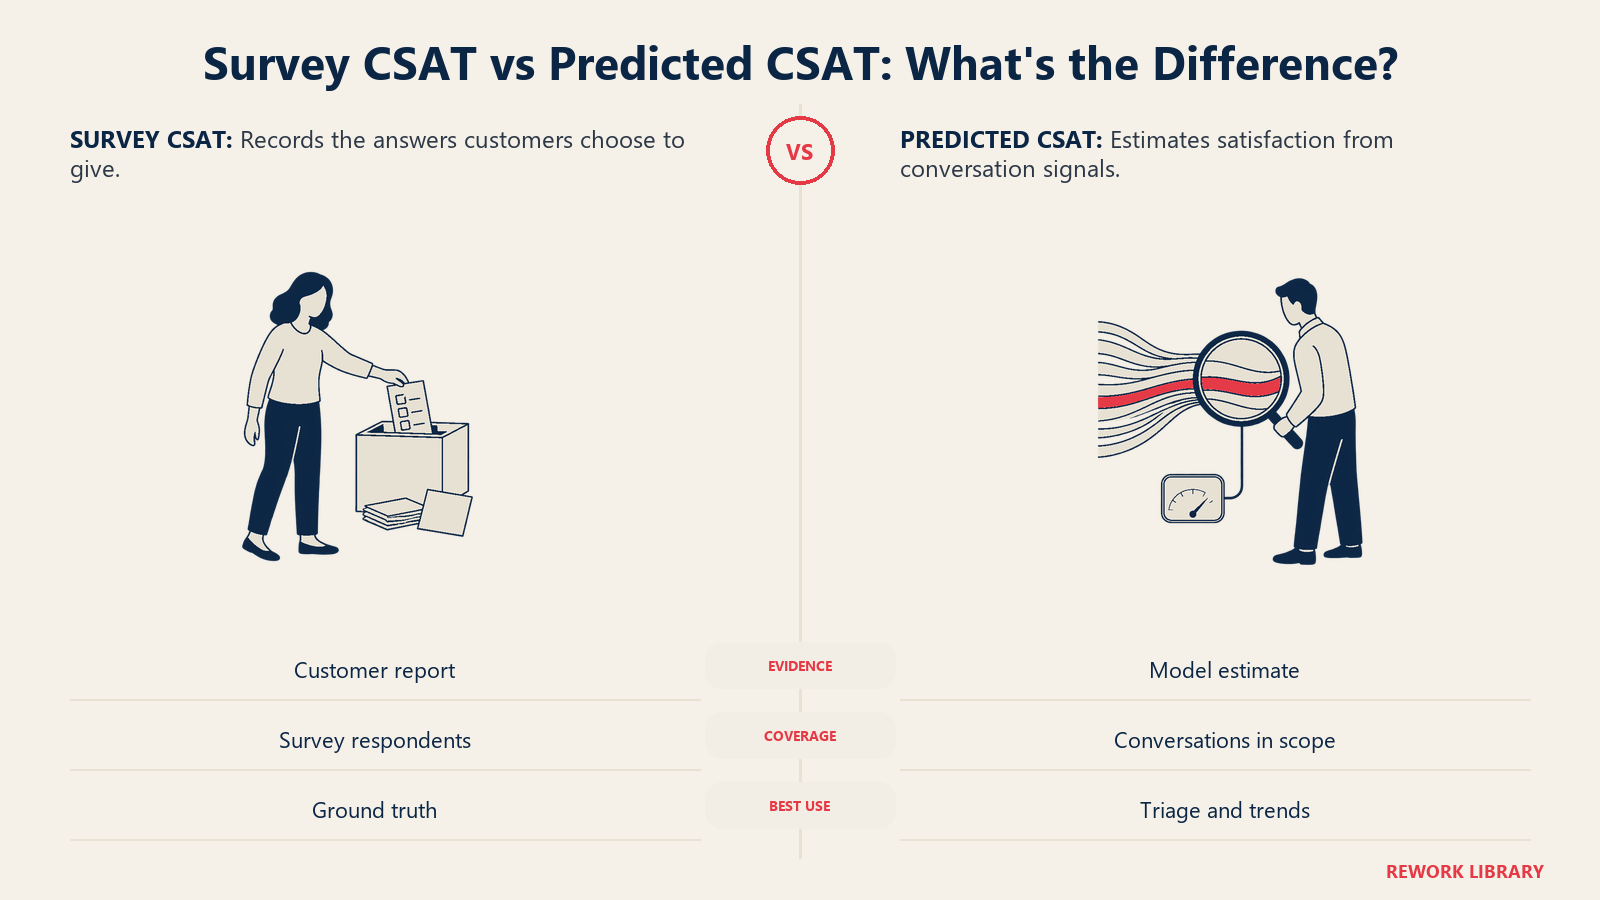
| Was er misst | Was der Kunde sagte, gefühlt zu haben | Die Schätzung eines Modells, was er sagen würde |
| Abdeckung | Nur Kunden, die antworten | Nahezu jede Konversation im Scope |
| Hauptverzerrung | Selbstselektion, Extreme überrepräsentiert | Aus den Trainingsdaten geerbt, plus blinde Flecken des Modells |
| Tempo | Nachdem die Umfrage beantwortet wurde | Bei oder nahe dem Abschluss der Konversation |
| Erklärt das „Warum“ | Nur bei einem Freitextkommentar | Kann Gründe und Zitate anhängen |
| Gut für | Ground Truth (Referenzwerte), Reporting, Benchmarking | Triage, Trenderkennung, stille Probleme aufspüren |
| Schwach bei | Schweigender Mehrheit, abgebrochenen Konversationen | Sarkasmus, Kontext, den das Modell nicht sieht, neuen Themen |
Die Quintessenz ist nicht „ersetzen Sie Umfragen“. Sie lautet, dass beide sich ergänzende Fehler haben. Umfragen sind schmal, aber echt; Prognosen sind breit, aber modelliert. Gemeinsam eingesetzt wird die Umfrage zur Ground Truth (Referenzwerte), die die Prognose ehrlich hält, und die Prognose dehnt diese Wahrheit auf die Konversationen aus, die niemand bewertet hat.
Praxisbeispiele nach Funktion
Leitung im Kundensupport. Eine Support-Leiterin sieht, dass der Umfrage-CSAT über ein Quartal auf demselben Niveau bleibt. Der prognostizierte Score, der über alle Konversationen läuft, fällt für ein Thema (etwa eine Änderung der Abrechnung) stark ab. Die Umfrage hat es übersehen, weil nur wenige dieser Kunden geantwortet haben. Die Leiterin gibt eine Stichprobe dieser Konversationen an einen menschlichen Prüfer und findet die Grundursache.
Produkt und Engineering. Nach Thema und Grund aufgeschlüsselte Scores werden zu einer gerankten Liste dessen, was Kunden frustriert. Kombiniert mit der AI-Ticket-Zusammenfassung erhält das Produktteam für jeden Cluster mit niedrigem Score eine kurze, zitierte Erklärung statt einer Tabelle.
Customer Success. Ein niedriger prognostizierter CSAT bei den jüngsten Tickets eines Schlüsselkunden ist ein Frühwarnsignal, das keine Umfrage zutage gefördert hätte. Er ist ein Input unter mehreren für Gesundheitswerte und Support-Signale, die Churn vorhersagen, und sollte nie der einzige sein.
Support Operations und QA. Prognostizierter CSAT entscheidet, welche Konversationen ein Mensch lesen sollte. Er ist ein Triage-Signal. Konversationen mit niedrigem Score gehen in die Prüfung, und die Ergebnisse der Prüfung fließen in die Kontrollen des Modells zurück. Er sollte nicht zur Bewertung einzelner Mitarbeitender dienen (dafür siehe den oben verlinkten QA-Artikel).
Proaktiver Support. Wenn eine Konversation ins Negative kippt, solange sie noch offen ist, kann eine Führungskraft eingreifen, bevor sie schließt.
So validieren Sie prognostizierte Scores anhand von Umfrageergebnissen
Das ist der Schritt, den die meisten Teams überspringen, und er entscheidet, ob die Zahl nutzbar ist. Das Prinzip: Die Umfrageantworten, die Sie haben, sind beschriftete Beispiele. Halten Sie einige zurück, trainieren Sie nie darauf und testen Sie das Modell dagegen.
Schritt 1: Ein Holdout-Set aufbauen
Nehmen Sie befragte Konversationen aus einem jüngeren Zeitraum und legen Sie sie beiseite. Hat der Anbieter mit Ihrer Historie trainiert, fragen Sie, welcher Zeitraum fürs Training genutzt wurde, und stellen Sie sicher, dass Ihr Testset aus der Zeit danach stammt. Ein Modell, das an Konversationen getestet wird, mit denen es trainiert wurde, sieht besser aus, als es ist.
Schritt 2: Auf Ebene der Konversation vergleichen
Legen Sie für jede Holdout-Konversation den prognostizierten Score neben die tatsächliche Umfragebewertung. Beginnen Sie mit diesen Prüfungen:
| Prüfung | Was sie Ihnen sagt | Worauf Sie achten sollten |
|---|---|---|
| Rangübereinstimmung | Ordnet das Modell Konversationen so, wie es die Kunden taten? | Höhere prognostizierte Scores sollten zu höheren Umfragebewertungen passen |
| Klassifikation gut oder schlecht | Kann es zufriedene von unzufriedenen Kunden trennen? | Nutzen Sie ROC AUC, das in einer Zahl zusammenfasst, wie gut Scores die beiden Gruppen trennen (scikit-learn) |
| Kalibrierung | Bedeuten die Wahrscheinlichkeiten, was sie sagen? | Von den Konversationen mit einem Score um 0,8 sollten etwa 80% als gut bewertet sein (scikit-learn) |
| Fehler nach Segment | Ist es überall gleich genau? | Schlüsseln Sie die Ergebnisse nach Kanal, Sprache, Thema und Kundenstufe auf |
Die Kalibrierung verdient einen genaueren Blick. Tragen Sie die prognostizierte Wahrscheinlichkeit gegen den tatsächlichen Anteil guter Bewertungen in jedem Band auf (ein Reliability Diagram). Liegt die Linie nahe an der Diagonalen, verhalten sich die Scores wie echte Wahrscheinlichkeiten. Wenn nicht, können Sie das Modell weiterhin zum Ranking nutzen, sollten aber eine „0,8“ nicht als 80% Chance auf einen zufriedenen Kunden lesen.
Schritt 3: Auf aggregierter Ebene vergleichen
Niemand handelt auf Grundlage des Scores einer einzelnen Konversation. Führungskräfte lesen Durchschnitte nach Team, Thema und Woche. Prüfen Sie daher auch, ob der durchschnittliche prognostizierte CSAT einer Gruppe dem durchschnittlichen Umfrage-CSAT derselben Gruppe im Zeitverlauf folgt. Ein Modell kann pro Konversation verrauscht sein und im Aggregat dennoch die Wahrheit sagen, oder umgekehrt. Testen Sie die Ebene, die Sie nutzen werden.
Schritt 4: Den Teil prüfen, den Umfragen nicht sehen
Die schwierige Frage ist, ob das Modell bei Konversationen richtig liegt, die nie eine Umfrage erhielten. Direkt testen können Sie das nicht, aber Sie können es abtasten. Ziehen Sie eine Zufallsstichprobe unbefragter Konversationen, lassen Sie zwei Prüfer sie lesen, ohne den prognostizierten Score zu kennen, und vergleichen Sie. Wenn Ihre Prüfer untereinander stark abweichen, ist das die Obergrenze für jedes Modell. Forschung zu LLM-Bewertern ergab, dass starke Modelle die Rate erreichen können, mit der Menschen untereinander übereinstimmen, was ein sinnvolles Ziel ist und kein perfektes (Zheng et al., 2023). Fragen Sie bei einigen unbefragten Fällen mit niedrigem Score außerdem mit einer kurzen Nachricht nach, wie der Kunde sich tatsächlich fühlte.
Schritt 5: Auf Drift achten
Die Übereinstimmung lässt nach, wenn sich Produkt, Richtlinie oder Sprachmix ändern. Wiederholen Sie den Holdout-Vergleich monatlich und nach jeder größeren Änderung.
Bekannte Verzerrungen und blinde Flecken
Schieflage der Trainingsdaten. Ein überwachtes Modell lernt von Antwortenden. Dominieren extreme Kunden Ihren Umfrageverlauf, lernt das Modell, wie extreme Kunden klingen, und geht mit der stillen Mitte womöglich schlecht um. Forschende, die an diesem Problem arbeiten, plädieren dafür, Daten von Nichtantwortenden in die Modellierung einzubeziehen, statt sie zu ignorieren (Toronto Metropolitan University).
Stil vor Substanz. Sprachmodell-Bewerter können längere, geschliffenere Antworten bevorzugen, eine dokumentierte Verzerrung zugunsten von Wortreichtum (Zheng et al., 2023). Im Support kann ein wortreicher, entschuldigender Austausch zufriedenstellender wirken als ein kurzer, der das Problem gelöst hat. Prüfen Sie, ob der prognostizierte CSAT der Nachrichtenlänge folgt, nachdem Sie das Ergebnis herausgerechnet haben.
Blindheit für das Ergebnis. Zufriedenheit hängt stark davon ab, ob das Problem tatsächlich behoben wurde. Ein Modell, das nur die Konversation sieht, weiß womöglich nicht, dass die Rückerstattung nie ankam. Geben Sie ihm Daten zur Lösung, wo Sie können, und behandeln Sie die Lösungsquote als separate Prüfung.
Sprache und Kultur. Höflichkeitsnormen, Sarkasmus und Bewertungsgewohnheiten unterscheiden sich je nach Region. Ein an englischen Tickets validiertes Modell sagt wenig über portugiesische aus. Validieren Sie pro Sprache.
Die Lücke bei AI-bearbeiteten Fällen. Von Bots und von Menschen bearbeitete Konversationen können sich unterschiedlich verhalten: Kunden bewerten sie womöglich nach anderen Maßstäben, und die Genauigkeit des Modells kann sich zwischen beiden unterscheiden. Validieren Sie beide Gruppen getrennt, statt anzunehmen, ein Ergebnis decke beide ab.
Prognostizierten CSAT einführen, Schritt für Schritt
- Benennen Sie die Entscheidung, die er unterstützen soll. Triage, Trend-Reporting, Account-Warnungen und Coaching von Mitarbeitenden verlangen unterschiedliche Genauigkeit. Beginnen Sie mit der Triage, der nachsichtigsten Nutzung.
- Bringen Sie zuerst Ihre Daten in Ordnung. Bereinigter Ticket-Text, konsistente Kanal- und Themen-Tags und Ergebnisse zur Lösung verbessern Prognosen. Siehe Support-Daten für AI aufbereiten.
- Lassen Sie die Umfrage weiterlaufen. Sie ist Ihre Ground Truth (Referenzwerte). Sie zu streichen, um „Umfragen zu sparen“, nimmt Ihnen die einzige Möglichkeit, das Modell zu validieren.
- Fahren Sie im Schattenmodus. Bewerten Sie einige Wochen lang Konversationen, ohne es Führungskräften oder Mitarbeitenden zu zeigen, und vergleichen Sie mit eingehenden Umfrageergebnissen.
- Validieren Sie mit den fünf obigen Schritten und halten Sie die gefundene Genauigkeit nach Segmenten fest.
- Machen Sie transparent, was die Zahl ist. Beschriften Sie sie in jedem Dashboard als „prognostiziert“, neben dem Umfrage-CSAT, und mischen Sie sie nie stillschweigend hinein.
- Ergänzen Sie Gründe, nicht nur Scores. Verlangen Sie, dass das System zeigt, welche Faktoren einen niedrigen Score getrieben haben, mit der zitierten Passage.
- Routen Sie danach. Schicken Sie Konversationen mit niedriger Prognose in eine menschliche Warteschlange und ziehen Sie Stichproben bei hohen, um trügerische Sicherheit zu entdecken.
- Prüfen Sie vierteljährlich. Wiederholen Sie den Holdout-Test, prüfen Sie Lücken bei Segmenten und stellen Sie Nutzungen ein, die das Modell nicht tragen kann.
Häufige Fallstricke
Die Prognose als Messung behandeln. Sie ist eine Schätzung. Ein Dashboard, das prognostizierten und befragten CSAT als dieselbe Kennzahl zeigt, führt Menschen in die Irre, sobald beide auseinanderlaufen.
Die Umfrage streichen. Ohne frische Umfrageantworten können Sie nicht validieren, und das Modell driftet langsam von dem weg, was Kunden tatsächlich empfinden.
Damit Menschen bewerten. Prognostizierter CSAT spiegelt die Situation des Kunden ebenso wider wie das Können des Mitarbeitenden: Ein Streit um die Abrechnung erzielt weniger als das Zurücksetzen eines Passworts. Mitarbeitende anhand roher prognostizierter Scores zu vergleichen bestraft diejenigen, die die schwere Warteschlange bekommen.
Segmente ignorieren. Eine Gesamtzahl kann gut aussehen, während ein Kanal oder eine Sprache unbemerkt danebenliegt. Schlüsseln Sie immer nach Segment auf.

Customer Success Operations Manager
On this page
- Wichtige Fakten
- Warum Umfrage-CSAT allein nicht reicht
- So funktioniert prognostizierter CSAT
- Ansatz 1: Ein überwachtes Modell, trainiert auf Ihrem Umfrageverlauf
- Ansatz 2: Ein Sprachmodell, das die Konversation anhand definierter Faktoren liest
- Wo Sentiment-Scoring hineinpasst
- Umfrage-CSAT und prognostizierter CSAT im Vergleich
- Praxisbeispiele nach Funktion
- So validieren Sie prognostizierte Scores anhand von Umfrageergebnissen
- Schritt 1: Ein Holdout-Set aufbauen
- Schritt 2: Auf Ebene der Konversation vergleichen
- Schritt 3: Auf aggregierter Ebene vergleichen
- Schritt 4: Den Teil prüfen, den Umfragen nicht sehen
- Schritt 5: Auf Drift achten
- Bekannte Verzerrungen und blinde Flecken
- Prognostizierten CSAT einführen, Schritt für Schritt
- Häufige Fallstricke