Sinais do suporte que preveem o churn: usando IA para sinalizar clientes em risco
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Um sinal de churn no suporte é um padrão nos tickets, chats e ligações de um cliente (contatos repetidos, tom que azeda, bugs que continuam abertos, escalonamentos, esforço crescente) que costuma aparecer antes de o cliente cancelar ou deixar de renovar. A IA transforma esses padrões dispersos em um único alerta no nível da conta, e o alerta vai para o customer success manager (CSM) responsável pelo relacionamento.
O suporte vê coisas que o resto da empresa não vê. Um cliente que deixa de fazer login é silencioso. Um cliente que escreve quatro vezes em um mês, cada vez um pouco mais curto e um pouco mais ríspido, é barulhento. O problema é que ninguém é pago para somar essas mensagens. O suporte fecha o ticket, o customer success olha um dashboard de uso, e a conta vai embora com o aviso parado em um help desk que ninguém do lado de CS abriu.
Este guia mostra quais sinais de suporte vale acompanhar, como a IA os combina, como passar o alerta a uma pessoa que possa agir sobre ele e como verificar se o modelo funciona. Se você quer a visão mais ampla de agir antes que o cliente reclame, comece por atendimento proativo com IA.
Fatos Principais
- Pesquisadores da IBM treinaram um modelo de escalonamento de tickets com mais de 2,5 milhões de tickets de suporte e cerca de 10.000 escalonamentos, e relatam 87,36% de recall com uma redução de 88,23% na carga de trabalho dos analistas (Montgomery et al., arXiv). Ele prevê escalonamentos, não churn, mas mostra que o histórico de tickets é uma ótima matéria-prima para modelos de risco.
- As variáveis desse trabalho da IBM incluem aumentos de severidade, dias desde o último contato e o tempo de resposta atual de um cliente comparado ao que ele historicamente recebeu (Montgomery et al., artigo completo). Comparar o cliente com a sua própria linha de base é a ideia central.
- A integração da Gainsight com o Zendesk permite que administradores levem dados de tickets para a Gainsight e "acionem health scores com base em dados de suporte" (Gainsight Marketplace). Essa é uma capacidade descrita pelo fornecedor, não um resultado medido.
- A mesma listagem descreve a criação e a vinculação de Calls to Action (CTAs) a tickets do Zendesk de dentro do help desk, que é o mecanismo de transferência tratado mais adiante.
- Precisão é a parcela das contas sinalizadas que de fato estavam em risco, e recall é a parcela das contas em risco que o modelo pegou (documentação do scikit-learn). Você precisa dos dois números para avaliar um alerta de churn.
- A validação cruzada comum, com dados embaralhados, dá pontuações infladas em dados ordenados no tempo, então os modelos de churn devem ser testados em períodos posteriores aos usados no treinamento (documentação do scikit-learn).
Por que os dados de suporte preveem o churn
O uso do produto mostra o que os clientes fazem. O suporte mostra o que eles sentem a respeito, com as próprias palavras, no momento em que algo deu errado. Isso o torna um sinal excepcionalmente direto, e ele está disponível desde o primeiro dia, antes de você ter meses de histórico de uso.
Três coisas diferenciam os dados de suporte de uma pontuação de uso:
- É texto. A maior parte da informação está no que o cliente escreveu, não em um campo. Ler isso em escala é exatamente o que os modelos de linguagem fazem bem.
- É orientado a eventos. Um health score atualizado uma vez por mês perde a semana em que três coisas quebraram. Os tickets chegam à medida que acontecem.
- Mostra a experiência da conta inteira. Um usuário irritado é um incidente. Cinco usuários de uma mesma empresa levantando problemas na mesma quinzena é um padrão.
Nada disso significa que um ticket seja um veredito. Muitos clientes que abrem vários tickets são usuários intensos e engajados que renovam com satisfação. O objetivo não é tratar o contato como algo ruim. É encontrar a mudança no padrão de uma conta, e por isso a abordagem abaixo compara sempre cada cliente com o seu próprio histórico.
As cinco famílias de sinais
A maioria dos sinais de churn úteis vindos do suporte se encaixa em cinco famílias. Cada uma é barata de calcular depois que seus dados de suporte estão preparados para a IA.
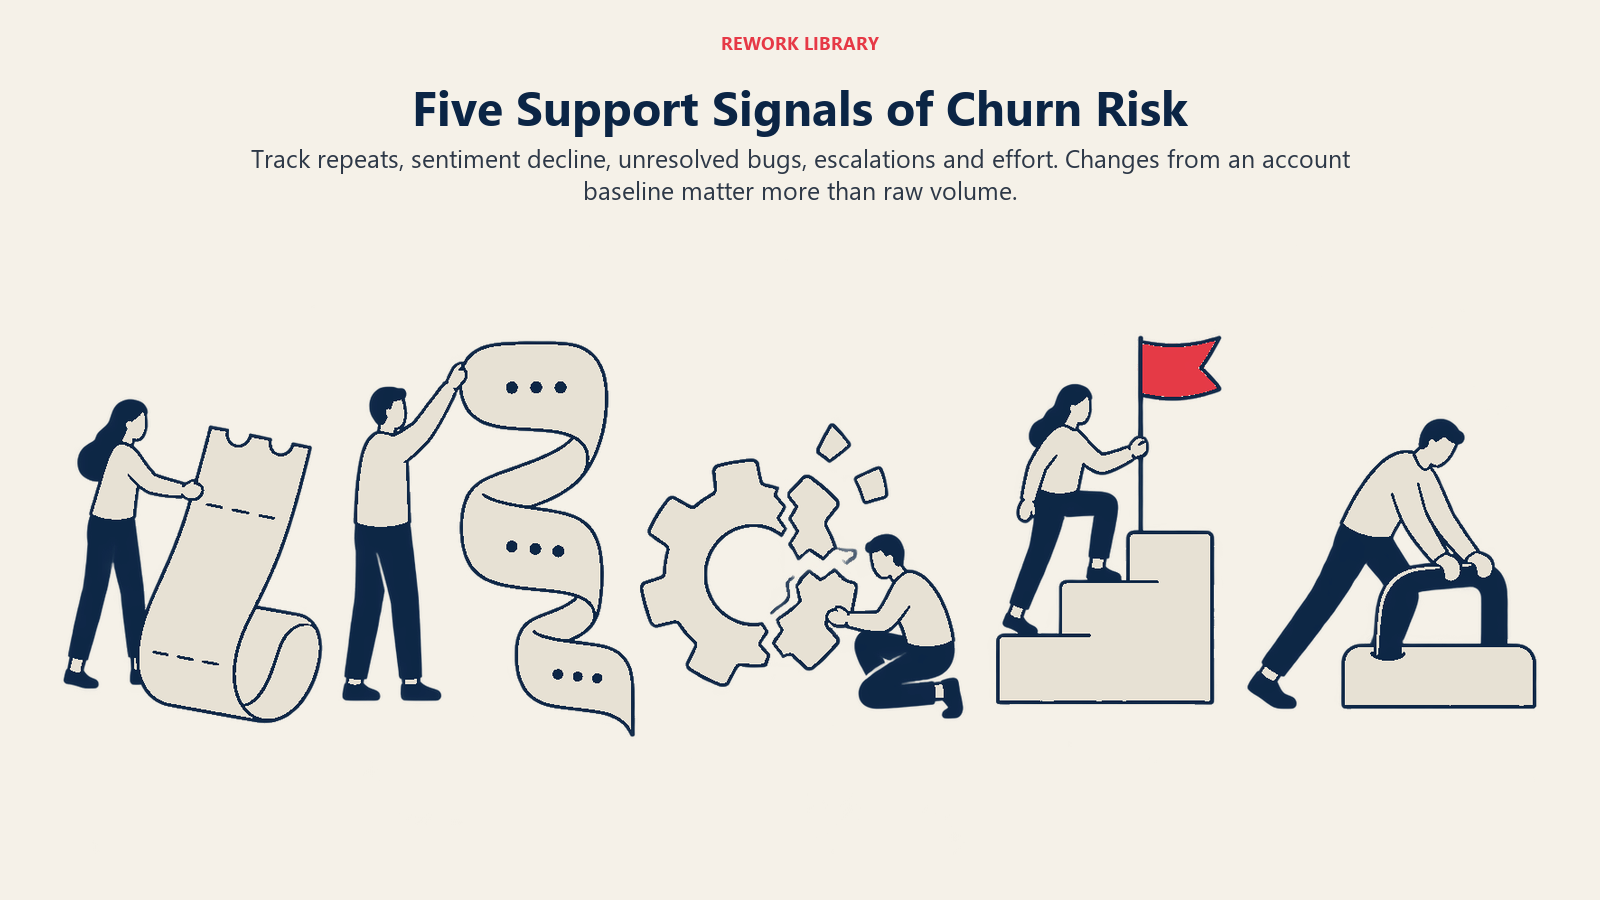
| Família de sinais | Como aparece | Por que importa | Armadilha comum |
|---|---|---|---|
| Contatos repetidos | O mesmo problema levantado de novo em poucos dias, ou o cliente reabre um ticket fechado | A primeira correção não funcionou, e o cliente está gastando esforço duas vezes | Contar todo o volume em vez dos contatos repetidos sobre o mesmo problema |
| Sentimento negativo | O tom piora ao longo de uma conversa ou de vários tickets em semanas | A frustração costuma crescer antes do cancelamento | Tratar uma mensagem ríspida como tendência |
| Bugs não resolvidos | Um defeito que afeta a conta continua aberto além da expectativa do cliente | O cliente está pagando por algo que não funciona | Ignorar bugs que ficam com a engenharia, e não com o suporte |
| Escalonamentos | Severidade elevada, gerente solicitado, patrocinador executivo em cópia | O cliente está aplicando a pressão máxima | Deixar passar escalonamentos silenciosos feitos por e-mail fora do help desk |
| Esforço | Muitas mensagens de ida e volta, muitas transferências, longas esperas pela primeira resposta | Ter de se esforçar muito para obter ajuda corrói a boa vontade | Medir só o tempo de resolução e não o número de etapas |
Contatos repetidos
Um contato repetido é o sinal simples mais forte, porque significa que o processo de suporte já falhou uma vez. Defina-o com cuidado: o mesmo cliente, o mesmo problema de fundo, dentro de uma janela que você escolhe (sete dias é um ponto de partida comum). Isso exige agrupar os tickets por tema, e a detecção de intenção do cliente é a ferramenta para isso, já que os clientes descrevem um mesmo problema com palavras muito diferentes.
Sentimento negativo
O sentimento só é útil como trajetória. Um cliente que é sempre direto não deve ser sinalizado por ser direto. Um cliente que foi caloroso em janeiro e seco em março deve. Se você já usa o CSAT previsto, as pontuações por conversa são uma entrada pronta aqui. Para o trabalho de risco, guarde a pontuação por mensagem e depois acompanhe a variação em uma janela móvel para cada conta.
Bugs não resolvidos
Este é o sinal que a maioria das equipes deixa passar, porque o ticket não está "aberto" na fila do suporte: foi repassado à engenharia e aparece como pendente. Do ponto de vista do cliente, nada mudou. Vincule os tickets aos registros de bugs e meça há quanto tempo cada conta afetada está esperando. O mesmo vínculo permite que as equipes de produto vejam quais defeitos custam mais, como visto em transformar tickets de suporte em itens do backlog de produto.
Escalonamentos
Um escalonamento é o cliente dizendo o quão sério isso é. A pesquisa da IBM sobre escalonamentos é uma boa referência aqui: suas variáveis incluem aumentos de severidade e comparações de tempo de resposta específicas de cada cliente (Montgomery et al.). Você pode aproveitar a ideia sem copiar o modelo. Acompanhe as mudanças de severidade, os pedidos de gerente e a chegada de um novo nome sênior na conversa.
Esforço
O esforço é o mais difícil de enxergar e muitas vezes o mais revelador. Conte as mensagens necessárias para resolver, o número de agentes diferentes envolvidos, o número de trocas de canal (chat para e-mail para telefone) e o intervalo entre a mensagem do cliente e a primeira resposta útil. Um ticket resolvido que levou nove mensagens e três agentes é uma experiência diferente de um que levou duas.
Como a IA combina os sinais
Um sinal isolado é ruidoso. O valor vem de combiná-los e de comparar cada conta com a sua própria normalidade.
O pipeline tem quatro etapas, correspondentes às capacidades ingest, analyze, predict e execute do ACE Framework:
- Ingest. Reúna tickets, transcrições de chat, transcrições de ligações, vínculos de bugs e respostas de CSAT em uma visão única no nível da conta, usando a conta do cliente como chave, e não o usuário individual.
- Analyze. Um modelo de linguagem classifica cada conversa: tema, sentimento, se o problema foi resolvido, se o cliente menciona ir embora, concorrentes ou termos do contrato. Um resumo de ticket de cada conta nos últimos 30 dias mantém a saída legível para as pessoas.
- Predict. Um modelo de pontuação recebe as classificações mais fatos estruturados (plano, tempo de casa, data de renovação, tendência de uso) e produz uma pontuação de risco por conta. Pode ser uma regressão logística simples ou um modelo de gradient boosting. Um modelo mais complexo raramente supera um modelo simples bem construído quando você tem algumas centenas de exemplos de churn.
- Execute. As contas que cruzam um limite criam uma tarefa para o responsável. Essa é a transferência tratada na próxima seção.
Duas decisões de projeto determinam se isso funciona.
Compare com a linha de base da própria conta. A variável de tempo de resposta da equipe da IBM é construída assim: compara o que o cliente recebe agora com o que ele historicamente recebia (Montgomery et al.). Aplique a mesma ideia a volume, sentimento e esforço. "A contagem de tickets é 3x a mediana desta conta" é uma variável muito melhor do que "a contagem de tickets é 12".
Separe o motivo da pontuação. Um número solto como "risco 0,82" é ignorado. Faça o modelo devolver os dois ou três principais sinais que contribuíram, em palavras simples. Esses motivos são o que o CSM lê.
Para a parte de modelagem além dos dados de suporte, modelos de previsão de churn aprofunda algoritmos e dados de treinamento. Os sinais de suporte são mais bem usados como uma entrada de um health score mais amplo, e não como substituto dos dados de uso e comerciais.
Um exemplo prático (hipotético)
Este exemplo é ilustrativo. Os números são inventados para mostrar a lógica.
Uma conta de software de médio porte costuma abrir um ticket por mês. Nas últimas três semanas, abriu cinco. Dois eram sobre a mesma falha de exportação, um foi reaberto, e um bug vinculado está aberto há 19 dias. O tom das mensagens passou de neutro a seco nos três últimos tickets. O mais recente menciona "avaliar outras opções".
Nenhum item isolado é alarmante. Juntos, diante de uma conta que costuma ser quieta, são. O modelo sinaliza a conta e escreve: "Volume de suporte 5x o normal. Mesmo problema de exportação levantado duas vezes, bug aberto há 19 dias. Sentimento em queda. Cliente mencionou avaliar alternativas." Um CSM consegue agir sobre isso em um minuto.
Passando o alerta ao CSM
É aqui que a maioria dos programas falha. Um alerta que ninguém age sobre é só um dashboard. A transferência precisa ser projetada com tanto cuidado quanto o modelo.
Coloque o alerta onde o CSM já trabalha. Se os CSMs vivem no CRM ou na plataforma de customer success, crie a tarefa lá, e não em um relatório que eles tenham de abrir. Existem integrações para isso: a listagem da Gainsight para o Zendesk, por exemplo, descreve a vinculação de CTAs a tickets do Zendesk de dentro do help desk (Gainsight Marketplace).
Envie um pacote, não um alerta solto. Cada alerta deve responder a cinco perguntas sem que o CSM precise abrir mais nada:
| Pergunta | O que o alerta deve conter |
|---|---|
| Quem é? | Conta, responsável, plano, data de renovação |
| O que aconteceu? | Um resumo de duas linhas dos últimos 30 dias de suporte |
| Por que foi sinalizado? | Os principais sinais que contribuíram, em palavras simples |
| O que está aberto? | Tickets não resolvidos e bugs vinculados, com a idade |
| O que devo fazer? | Uma sugestão de primeiro passo, como uma ligação, uma nota executiva ou uma atualização do status do bug |
Defina a responsabilidade e um tempo de resposta. Decida quem é o dono de cada alerta e com que rapidez responde. Sem isso, o suporte presume que o CS está cuidando e o CS presume que é o suporte.
Feche o ciclo. Quando o CSM age, ele registra o resultado (salvo, alarme falso, já saindo, cliente recuperado). Esse retorno são os dados de treinamento da próxima versão do modelo e é a única forma de aprender quanto o alerta vale.
Não os inunde. Se um CSM recebe 40 alertas por semana, ele para de ler na terceira semana. Ajuste o limite para produzir uma quantidade de alertas que a equipe consiga de fato trabalhar e revise-o todo mês. É melhor pegar 60% das contas em risco com alertas em que as pessoas confiam do que 90% com alertas que elas ignoram.
Nem todo alerta pertence ao CSM. Um alerta causado por um defeito recorrente é um problema de produto. Encaminhe-o ao produto com as evidências e acompanhe quais causas continuam aparecendo.
Como validar o modelo
Um alerta de churn que parece sensato em uma demonstração ainda pode estar errado na prática. A validação responde a uma pergunta: as contas que o modelo sinaliza realmente cancelam mais do que as que ele não sinaliza?
Etapa 1: defina o churn e a janela de previsão
Decida o que conta: cancelamento, não renovação ou um downgrade grande. Depois decida a janela, por exemplo "esta conta vai cancelar em até 90 dias após o alerta?". Um modelo sem janela declarada não pode ser testado.
Etapa 2: monte o conjunto de dados a partir do passado
Para cada conta, em cada data passada, registre os sinais de suporte como estavam naquele momento e se a conta cancelou dentro da janela depois disso. Seja rigoroso: se uma variável inclui informação posterior à data do alerta, o modelo está trapaceando. Um vazamento clássico é um campo preenchido quando o cliente cancela, como uma tag de "motivo do cancelamento" no último ticket.
Etapa 3: divida por tempo, não de forma aleatória
Treine em períodos anteriores e teste em períodos posteriores. A validação cruzada padrão com dados embaralhados presume que as amostras são independentes e, em dados ordenados no tempo, produz pontuações infladas porque as amostras de teste ficam próximas no tempo das de treinamento (documentação do scikit-learn). Uma divisão por tempo imita o uso real: o modelo aprende com o passado e é julgado em um futuro que ainda não viu.
Etapa 4: meça as coisas certas
| Métrica | Significado simples | O que observar |
|---|---|---|
| Precisão | Das contas que sinalizamos, quantas estavam de fato em risco? | Precisão baixa significa que os CSMs perdem tempo e deixam de confiar nos alertas |
| Recall | Das contas que cancelaram, quantas sinalizamos? | Recall baixo significa que o modelo perde a maior parte do problema |
| Lift | Quantas vezes mais provável é que as contas sinalizadas cancelem em relação à média? | Um lift próximo de 1 significa que o alerta não agrega nada |
| Antecedência | Quantos dias antes do cancelamento o alerta disparou? | Um alerta que dispara uma semana antes do cancelamento chega tarde demais para ajudar |
Precisão é a parcela das contas sinalizadas que eram de fato positivas, e recall é a parcela de todos os positivos que o modelo encontrou (documentação do scikit-learn). Os dois puxam em direções opostas. Subir o limite dá menos alertas, mais confiáveis, e deixa passar mais clientes que vão cancelar. Escolha o equilíbrio de acordo com quantos alertas os seus CSMs conseguem trabalhar.
Etapa 5: compare com uma linha de base simples
Confronte o modelo com algo sem graça: "sinalizar qualquer conta com três ou mais tickets em 30 dias" ou o seu health score atual. Se um modelo de IA mal supera a regra simples, use a regra. Se o modelo acrescenta sinais de suporte a um health score existente e melhora o lift, essa é a evidência de que você precisa para mantê-lo.
Etapa 6: teste em campo e continue verificando
Rode em modo sombra por um ciclo de renovação, sinalizando contas sem mudar o trabalho dos CSMs, e depois compare as contas sinalizadas com as demais. Depois do lançamento, fique de olho na deriva do modelo. Um novo lançamento de produto, uma mudança de preço ou uma nova equipe de suporte podem mudar o que é "normal". Reveja precisão e recall a cada trimestre e use as notas de resultado dos CSMs para encontrar os alarmes falsos.
Cuidado com a afirmação causal. Um alerta mostra quem provavelmente vai embora. Ele não mostra que a sua intervenção os salvou. Para medir o efeito do contato, separe por um tempo uma fatia aleatória das contas sinalizadas e compare os resultados, se o seu negócio puder aceitar isso.
Checklist de implantação
- Escolha uma definição de churn e uma janela. Não comece com três.
- Conecte o suporte aos registros de conta. Os tickets precisam ser consolidados na conta, e não apenas no usuário.
- Comece pelas cinco famílias de sinais. Acrescente outras apenas quando mostrarem o seu valor.
- Calcule os sinais em relação à linha de base de cada conta.
- Monte primeiro uma regra de linha de base, depois teste um modelo.
- Devolva os motivos junto com cada pontuação.
- Crie tarefas na ferramenta do CSM, com responsável e tempo de resposta.
- Registre os resultados de cada alerta.
- Valide com divisão por tempo e informe precisão, recall, lift e antecedência.
- Revise a cada trimestre e aposente os sinais que deixarem de ajudar.
Armadilhas comuns
Tratar todo contato como algo ruim. Usuários intensos abrem mais tickets. Procure mudanças em relação à linha de base da conta, não contagens brutas.
Pontuar usuários em vez de contas. O churn costuma ser uma decisão no nível da conta. A semana ruim de uma pessoa não é o risco da conta.
Vazar a resposta. Variáveis criadas depois da decisão de cancelar fazem o modelo parecer brilhante no teste e inútil em produção.
Fadiga de alertas. Alertas demais e a equipe para de ler. Ajuste o limite à capacidade.
Alerta sem um Playbook. Se ninguém sabe o que fazer quando um alerta aparece, o modelo não tem valor. Escreva primeiro o Playbook.
Ignorar bugs de responsabilidade da engenharia. Os tickets pendentes na engenharia são onde os clientes esperam mais. Inclua-os.
Punir o cliente. Um alerta de risco serve para ajudar, não para reter o serviço. Não encaminhe clientes sinalizados para filas mais lentas nem use a pontuação para recusar pedidos razoáveis.
Esquecer a privacidade. O texto dos tickets contém dados pessoais. Verifique o que os seus termos de processamento de dados permitem antes de enviar transcrições a um modelo e limite o que o alerta expõe ao CSM.
Perguntas frequentes sobre sinais de suporte e churn
Quais sinais de suporte melhor preveem o churn?
Cinco famílias valem como ponto de partida: contatos repetidos sobre o mesmo problema, sentimento que piora com o tempo, bugs que continuam sem solução, escalonamentos e alto esforço do cliente. Cada uma é mais útil quando medida em relação ao padrão normal da própria conta do que como uma contagem bruta.
A IA consegue mesmo prever o churn só com tickets de suporte?
Os dados de suporte são uma ótima matéria-prima, mas funcionam melhor combinados com dados de uso, de contrato e de renovação. A pesquisa publicada da IBM sobre escalonamentos de tickets mostra quanto o histórico de tickets pode revelar, embora esse estudo prevesse escalonamentos e não churn.
Como devemos passar um alerta de risco a um CSM?
Crie uma tarefa na ferramenta que o CSM já usa, com a conta, um resumo curto, os principais motivos do alerta, os tickets e bugs abertos e uma sugestão de primeira ação. Atribua um responsável e um tempo de resposta e peça ao CSM que registre o resultado para que o modelo possa aprender.
Como saber se o modelo de churn é preciso?
Treine em períodos passados e teste em períodos posteriores, depois informe precisão, recall, lift e antecedência em comparação com uma regra de linha de base simples. Divisões aleatórias com dados embaralhados dão resultados inflados em dados ordenados no tempo, então evite-as. Reverifique a cada trimestre, porque produtos e políticas mudam o que é normal.
Quantos tickets devem disparar um alerta de churn?
Não existe um número universal. Um gatilho melhor é um salto em relação ao volume habitual daquela conta, combinado com outros sinais, como repetições, tom e bugs abertos. Ajuste o limite para que seus CSMs recebam uma quantidade de alertas que consigam trabalhar a cada semana.
É justo pontuar clientes pelo comportamento no suporte?
Tudo bem quando a pontuação é usada para oferecer ajuda mais cedo, e não para limitar o serviço. Mantenha os dados protegidos, explique no seu aviso de privacidade como os dados de suporte são usados e nunca use uma pontuação de risco para negar ou atrasar pedidos legítimos.

Customer Success Operations Manager
On this page
- Fatos Principais
- Por que os dados de suporte preveem o churn
- As cinco famílias de sinais
- Contatos repetidos
- Sentimento negativo
- Bugs não resolvidos
- Escalonamentos
- Esforço
- Como a IA combina os sinais
- Um exemplo prático (hipotético)
- Passando o alerta ao CSM
- Como validar o modelo
- Etapa 1: defina o churn e a janela de previsão
- Etapa 2: monte o conjunto de dados a partir do passado
- Etapa 3: divida por tempo, não de forma aleatória
- Etapa 4: meça as coisas certas
- Etapa 5: compare com uma linha de base simples
- Etapa 6: teste em campo e continue verificando
- Checklist de implantação
- Armadilhas comuns