Bahasa Indonesia
Memprediksi CSAT dengan AI: Menilai Setiap Percakapan Tanpa Survei
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
CSAT prediksi adalah perkiraan seberapa puas pelanggan terhadap suatu percakapan dukungan, dihasilkan oleh model yang membaca percakapan dan metadatanya alih-alih menunggu pelanggan mengisi survei. Keluarannya biasanya berupa skor (sering 1 sampai 5, menyesuaikan skala survei) atau probabilitas bahwa pelanggan akan menilai interaksi itu baik. Karena tidak ada pelanggan yang harus menjawab, cakupannya bisa meliputi hampir semua percakapan.
Cakupan itulah seluruh daya jualnya, dan sekaligus jebakannya. Survei memberi tahu apa yang dikatakan pelanggan. Prediksi memberi tahu apa yang ditebak model akan dikatakan pelanggan, berdasarkan pola dalam percakapan lama. Keduanya berbeda, dan jarak di antara keduanya adalah tempat tim terjebak masalah. Panduan ini membahas cara kerja CSAT prediksi dan penilaian sentimen, perbandingannya dengan CSAT survei, serta cara memeriksa skor prediksi terhadap hasil survei nyata sebelum Anda membiarkannya mengarahkan keputusan. Panduan ini berada dalam koleksi AI for Customer Service, sehingga gambaran umum AI dalam layanan pelanggan memberi gambaran yang lebih luas.
Satu batasan terlebih dahulu. Menilai seberapa baik seorang agen menangani percakapan terhadap sebuah rubrik adalah pekerjaan yang berbeda, dibahas di jaminan kualitas AI untuk dukungan. Artikel ini membahas hasil dari sisi pelanggan: apakah mereka puas, dan bagaimana kita tahu tanpa bertanya?
Fakta Utama
- CX Score dari Intercom, alternatif berbasis AI untuk CSAT survei, menilai percakapan yang sudah ditutup dari 1 sampai 5 dengan mengevaluasi serangkaian alasan bernama secara independen, lalu menggabungkan yang tidak netral. Percakapan telepon tidak dinilai (Intercom).
- Intercom menggambarkan CSAT survei sebagai penangkap umpan balik dari kelompok kecil yang memilih sendiri dan sering kali terlalu banyak mewakili opini ekstrem (pandangan vendor) (Intercom).
- Karya akademik tentang pemodelan kepuasan pelanggan menyebut tingkat respons survei sangat rendah, dan mencatat bahwa non-responden biasanya merupakan bagian yang lebih besar dari basis pelanggan, sehingga mengabaikan mereka dapat membiaskan estimasi (Toronto Metropolitan University).
- Ketika Zendesk meluncurkan Satisfaction Prediction pada 2016, perusahaan itu menyebut model tersebut membaca ratusan sinyal, termasuk deskripsi teks, jumlah balasan, dan total waktu tunggu, dan tersedia bagi akun Enterprise yang menerima setidaknya 500 penilaian kepuasan per bulan (Zendesk).
- Riset tentang LLM sebagai juri menemukan model yang kuat dapat mencapai kesepakatan lebih dari 80% dengan preferensi manusia, tingkat yang sama dengan kesepakatan antarmanusia, sekaligus menunjukkan bias posisi, bias kepanjangan, dan bias menguntungkan diri sendiri (Zheng dkk., 2023).
- Model yang terkalibrasi baik adalah model yang, di antara kasus yang dinilai mendekati 0,8, sekitar 80% benar-benar berakhir positif (dokumentasi scikit-learn).
Mengapa CSAT Survei Saja Tidak Cukup
CSAT survei itu sederhana: setelah percakapan ditutup, kirim permintaan penilaian satu pertanyaan dan laporkan persentase penilaian baik. Murah dan mudah dipahami pelanggan. Namun ia memiliki tiga kelemahan struktural yang tidak sepenuhnya bisa diperbaiki oleh rancangan survei mana pun.
Cakupan. Hanya pelanggan yang menjawab yang dihitung. Tingkat respons bervariasi menurut kanal, audiens, dan rancangan survei, dan riset yang dirangkum di atas menyebutnya sangat rendah. Jika Anda mengelola dukungan dengan ribuan percakapan per minggu, Anda mungkin mengambil keputusan staf dan produk berdasarkan sebagian kecil dari semuanya.
Bias seleksi diri. Orang yang merespons bukan sampel acak. Pelanggan yang sangat senang dan sangat kesal menjawab; kelompok tengah yang besar mengangkat bahu lalu pergi. Mayoritas yang diam, termasuk pelanggan yang agak jengkel dan diam-diam berhenti berlangganan sebulan kemudian, sebagian besar tidak terlihat. Para peneliti yang dikutip di atas menyampaikan hal yang sama: non-responden cenderung kelompok yang lebih besar, sehingga menyingkirkan mereka dapat memiringkan hasil.
Kesenjangan waktu dan kanal. Survei setelah utas email ditutup tidak mengatakan apa pun tentang chat yang ditinggalkan, atau tiket yang tidak terjawab. Survei juga tertinggal: Anda baru tahu tentang minggu yang buruk pada minggu berikutnya.
CSAT prediksi menyerang masalah pertama dan ketiga secara langsung. Ia dapat menilai percakapan begitu ditutup (atau saat masih terbuka) dan tidak bergantung pada respons. Ia tidak otomatis memperbaiki bias. Model yang dilatih pada respons survei mewarisi kemiringan survei itu, yang menjadi hal utama untuk diingat di sepanjang sisa artikel ini.
Cara Kerja CSAT Prediksi
Ada dua pendekatan besar, dan banyak produk memadukannya.
Pendekatan 1: Model terawasi yang dilatih pada riwayat survei Anda
Anda mengambil percakapan lama yang memang mendapat respons survei, memperlakukan penilaian sebagai label, dan melatih model untuk memprediksinya dari fitur percakapan. Peluncuran Zendesk pada 2016 adalah contoh jelas rancangan ini: model memakai sinyal seperti teks tiket, jumlah balasan, dan total waktu tunggu, dan produknya mensyaratkan volume penilaian minimum per bulan agar ada cukup riwayat berlabel untuk dipelajari (Zendesk). Persyaratan volume itu pengingat yang berguna: prediksi terawasi membutuhkan banyak jawaban survei nyata untuk dipelajari, yang berarti secara diam-diam ia bergantung pada data yang justru hendak digantikannya.
Fitur yang lazim:
- Sinyal teks: pilihan kata pelanggan, pergeseran sentimen antarpesan, frasa seperti "masih tidak berfungsi" atau "ini ketiga kalinya saya bertanya".
- Sinyal upaya: jumlah balasan, penugasan ulang, pengalihan antaragen, berapa kali pelanggan harus mengulang diri.
- Sinyal waktu: waktu respons pertama, total waktu tunggu, jeda antarbalasan.
- Konteks: kanal, topik, tingkat pelanggan, apakah ini kontak berulang.
Pendekatan 2: Model bahasa yang membaca percakapan terhadap faktor yang ditentukan
Produk yang lebih baru memakai model bahasa untuk membaca seluruh transkrip dan menilainya terhadap faktor bernama, lalu menggabungkannya menjadi skor. CX Score dari Intercom bekerja seperti ini. Ia mengevaluasi alasan spesifik (kualitas jawaban, upaya pelanggan, emosi kuat, umpan balik produk atau layanan, dan umpan balik kebijakan), memperlakukan suatu alasan sebagai netral bila tidak ada sinyal kuat, dan menurunkan penilaian 1 sampai 5 dari kombinasi alasan yang tidak netral, tanpa pembobotan tersembunyi yang mengutamakan satu alasan di atas yang lain (Intercom). Ia hanya menilai percakapan yang sudah ditutup melalui messenger atau email, yang memberi tahu hal praktis: setiap produk CSAT prediksi memiliki batas cakupan, dan Anda perlu tahu batas milik Anda.
Alasannya lebih penting daripada angkanya. "3,2, didorong oleh upaya pelanggan yang tinggi dan keluhan kebijakan" memberi tahu apa yang harus diperbaiki.
Di mana penilaian sentimen berperan
Analisis sentimen adalah blok pembangun di bawah sebagian besar hal ini. Ia melabeli nada emosional teks, pesan demi pesan. CSAT prediksi melangkah lebih jauh: ia menggabungkan nada dengan upaya, hasil, dan konteks untuk memperkirakan putusan keseluruhan atas interaksi. Sebuah percakapan bisa dibuka dengan marah dan berakhir bahagia (pelanggan kesal, agen memperbaikinya, pelanggan berterima kasih). Sentimen tingkat pesan melihat kedua separuhnya. Prediksi CSAT yang baik memberi bobot lebih pada akhirnya.
CSAT Survei vs. CSAT Prediksi
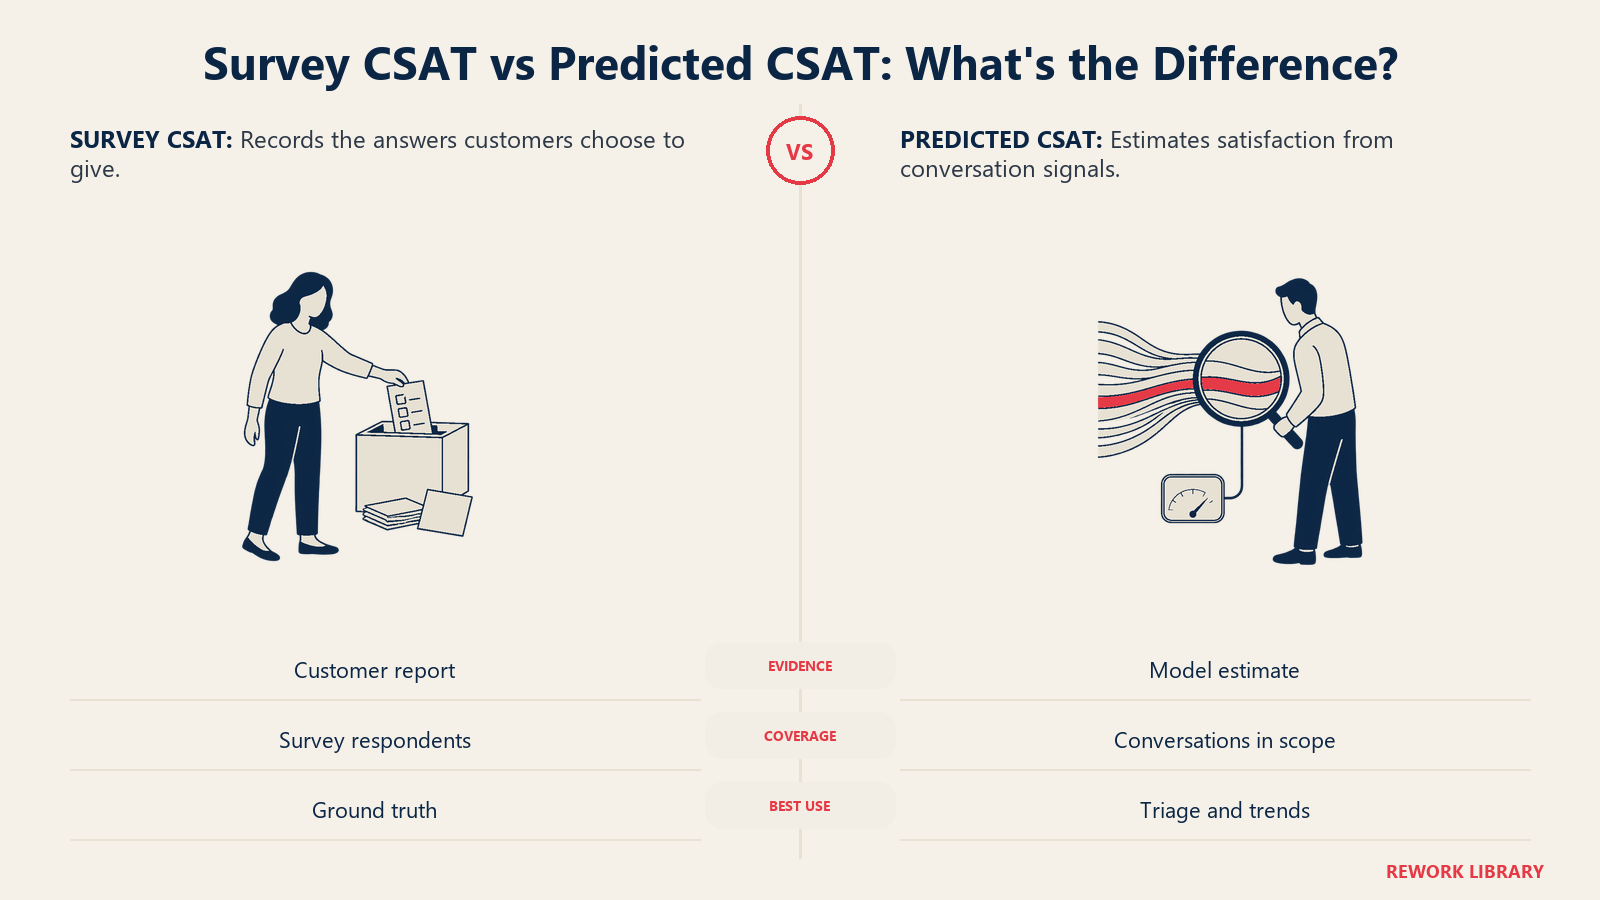
| Dimensi | CSAT survei | CSAT prediksi |
|---|---|---|
| Apa yang diukur | Apa yang dikatakan pelanggan tentang perasaannya | Perkiraan model tentang apa yang akan mereka katakan |
| Cakupan | Hanya pelanggan yang merespons | Hampir setiap percakapan dalam cakupan |
| Bias utama | Seleksi diri, ekstrem terlalu terwakili | Diwarisi dari data pelatihan, ditambah titik buta model |
| Kecepatan | Setelah survei dijawab | Saat atau mendekati penutupan percakapan |
| Menjelaskan "mengapa" | Hanya bila ada komentar teks bebas | Dapat melampirkan alasan dan kutipan |
| Cocok untuk | Ground truth, pelaporan, benchmarking | Triase, pengamatan tren, menemukan masalah yang diam |
| Lemah pada | Mayoritas yang diam, percakapan yang ditinggalkan | Sarkasme, konteks yang tak terlihat model, topik baru |
Intinya bukan "gantikan survei." Intinya, keduanya memiliki kesalahan yang saling melengkapi. Survei sempit tetapi nyata; prediksi luas tetapi dimodelkan. Bila dipakai bersama, survei menjadi ground truth yang menjaga prediksi tetap jujur, dan prediksi memperluas kebenaran itu ke percakapan yang tidak dinilai siapa pun.
Contoh Nyata menurut Fungsi
Kepemimpinan dukungan pelanggan. Seorang direktur dukungan melihat CSAT survei bertahan di level yang sama selama satu kuartal. Skor prediksi, yang berjalan pada semua percakapan, turun tajam untuk satu topik (misalnya, perubahan penagihan). Survei melewatkannya karena sedikit dari pelanggan itu yang menjawab. Direktur mengarahkan sampel percakapan itu ke peninjau manusia dan menemukan akar masalahnya.
Produk dan rekayasa. Skor yang dipecah menurut topik dan alasan menjadi daftar peringkat tentang apa yang membuat pelanggan frustrasi. Padukan dengan ringkasan tiket AI dan tim produk mendapat penjelasan singkat berkutipan untuk setiap klaster berskor rendah alih-alih spreadsheet.
Customer success. CSAT prediksi yang rendah pada tiket terbaru akun kunci adalah peringatan dini yang tidak akan dimunculkan survei mana pun. Ia salah satu masukan di antara beberapa untuk skor kesehatan dan sinyal dukungan yang memprediksi churn, dan tidak boleh menjadi satu-satunya.
Operasi dukungan dan QA. CSAT prediksi menentukan percakapan mana yang perlu dibaca manusia. Ia sinyal triase. Percakapan berskor rendah masuk ke tinjauan, dan hasil tinjauan kembali memberi masukan pada pemeriksaan model. Ia tidak boleh dipakai untuk menilai agen individu (lihat artikel QA yang ditautkan di atas untuk itu).
Dukungan proaktif. Jika sebuah percakapan cenderung negatif selagi masih terbuka, supervisor dapat turun tangan sebelum ditutup.
Cara Memvalidasi Skor Prediksi terhadap Hasil Survei
Inilah langkah yang dilewati sebagian besar tim, dan inilah yang menentukan apakah angkanya layak dipakai. Prinsipnya: respons survei yang memang Anda miliki adalah contoh berlabel. Sisihkan sebagian, jangan pernah melatih dengannya, dan uji model terhadapnya.
Langkah 1: Bangun set holdout
Ambil percakapan yang disurvei dari periode terbaru dan sisihkan. Jika vendor melatih dengan riwayat Anda, tanyakan periode mana yang dipakai untuk pelatihan dan pastikan set uji Anda berasal dari sesudahnya. Model yang diuji pada percakapan yang dipakai melatihnya akan tampak lebih baik daripada kenyataannya.
Langkah 2: Bandingkan di tingkat percakapan
Untuk setiap percakapan holdout, letakkan skor prediksi di samping penilaian survei yang sebenarnya. Mulailah dengan pemeriksaan ini:
| Pemeriksaan | Apa yang diungkapkan | Yang perlu dicari |
|---|---|---|
| Kesesuaian peringkat | Apakah model mengurutkan percakapan seperti yang dilakukan pelanggan? | Skor prediksi yang lebih tinggi harus sejalan dengan penilaian survei yang lebih tinggi |
| Klasifikasi baik vs. buruk | Apakah ia bisa memisahkan pelanggan yang puas dari yang tidak puas? | Gunakan ROC AUC, yang meringkas seberapa baik skor memisahkan kedua kelompok dalam satu angka (scikit-learn) |
| Kalibrasi | Apakah probabilitasnya bermakna sesuai angkanya? | Di antara percakapan yang dinilai mendekati 0,8, sekitar 80% harus dinilai baik (scikit-learn) |
| Galat per segmen | Apakah akurasinya sama di semua tempat? | Pecah hasil menurut kanal, bahasa, topik, tingkat pelanggan |
Kalibrasi layak dilihat lebih dekat. Plot probabilitas prediksi terhadap persentase penilaian baik yang sebenarnya di setiap pita (diagram reliabilitas). Jika garisnya dekat dengan diagonal, skor berperilaku seperti probabilitas nyata. Jika tidak, Anda masih bisa memakai model untuk pemeringkatan, tetapi jangan membaca "0,8" sebagai peluang 80% pelanggan yang bahagia.
Langkah 3: Bandingkan di tingkat agregat
Pelanggan tidak bertindak berdasarkan skor satu percakapan. Para pemimpin membaca rata-rata per tim, topik, dan minggu. Jadi periksa juga apakah rata-rata CSAT prediksi untuk suatu kelompok mengikuti rata-rata CSAT survei untuk kelompok yang sama dari waktu ke waktu. Model bisa berisik per percakapan namun tetap jujur secara agregat, atau sebaliknya. Uji tingkat yang akan Anda pakai.
Langkah 4: Periksa bagian yang tidak bisa dilihat survei
Pertanyaan sulitnya adalah apakah model benar tentang percakapan yang tidak pernah mendapat survei. Anda tidak bisa mengujinya secara langsung, tetapi bisa menyelidikinya. Ambil sampel acak percakapan yang tidak disurvei, minta dua peninjau membacanya tanpa mengetahui skor prediksi, lalu bandingkan. Jika peninjau Anda sering berbeda pendapat satu sama lain, itulah batas atas bagi model mana pun. Riset tentang LLM sebagai juri menemukan bahwa model yang kuat dapat menyamai tingkat kesepakatan antarmanusia, yang merupakan target masuk akal alih-alih yang sempurna (Zheng dkk., 2023). Tindak lanjuti juga, untuk beberapa kasus berskor rendah yang tidak disurvei, dengan pesan jangkauan singkat untuk melihat bagaimana perasaan pelanggan yang sebenarnya.
Langkah 5: Waspadai drift
Kesesuaian menurun bila produk, kebijakan, atau komposisi bahasa berubah. Jalankan ulang perbandingan holdout setiap bulan dan setelah perubahan besar apa pun.
Bias dan Titik Buta yang Diketahui
Kemiringan data pelatihan. Model terawasi belajar dari responden. Jika pelanggan ekstrem mendominasi riwayat survei Anda, model mempelajari seperti apa suara pelanggan ekstrem dan mungkin salah menangani kelompok tengah yang diam. Para peneliti yang menggarap masalah ini berpendapat bahwa data non-responden perlu dimasukkan ke dalam pemodelan alih-alih diabaikan (Toronto Metropolitan University).
Gaya di atas substansi. Model bahasa sebagai juri bisa menyukai respons yang lebih panjang dan lebih rapi, bias kepanjangan yang terdokumentasi (Zheng dkk., 2023). Dalam dukungan, pertukaran yang bertele-tele dan penuh permintaan maaf bisa tampak lebih memuaskan daripada yang singkat tetapi menyelesaikan masalah. Periksa apakah CSAT prediksi mengikuti panjang pesan setelah Anda memperhitungkan hasilnya.
Buta terhadap hasil. Kepuasan sangat bergantung pada apakah masalahnya benar-benar diperbaiki. Model yang hanya melihat percakapan mungkin tidak tahu bahwa pengembalian dana tidak pernah tiba. Berikan data penyelesaian bila bisa, dan perlakukan tingkat penyelesaian sebagai pemeriksaan terpisah.
Bahasa dan budaya. Norma kesopanan, sarkasme, dan kebiasaan memberi penilaian berbeda menurut wilayah. Model yang divalidasi pada tiket berbahasa Inggris hanya sedikit memberi tahu tentang tiket berbahasa Portugis. Validasi per bahasa.
Kesenjangan penanganan oleh AI. Percakapan yang ditangani bot dan yang ditangani manusia bisa berperilaku berbeda: pelanggan mungkin menilainya dengan standar berbeda, dan akurasi model bisa berbeda di antara keduanya. Validasi kedua kelompok secara terpisah alih-alih mengasumsikan satu hasil mencakup keduanya.
Menerapkan CSAT Prediksi, Langkah demi Langkah
- Sebutkan keputusan yang akan didukungnya. Triase, pelaporan tren, peringatan akun, dan coaching agen masing-masing membutuhkan akurasi berbeda. Mulailah dengan triase, penggunaan yang paling memaafkan.
- Perbaiki data Anda lebih dulu. Teks tiket yang bersih, tag kanal dan topik yang konsisten, dan hasil penyelesaian membuat prediksi lebih baik. Lihat menyiapkan data dukungan untuk AI.
- Biarkan survei tetap berjalan. Itu ground truth Anda. Memangkasnya demi "menghemat survei" menghilangkan satu-satunya cara memvalidasi model.
- Jalankan dalam mode bayangan. Nilai percakapan selama beberapa minggu tanpa menampilkannya kepada pemimpin atau agen, dan bandingkan dengan hasil survei yang masuk.
- Validasi dengan lima langkah di atas dan catat akurasi yang Anda temukan, per segmen.
- Umumkan apa angka itu. Beri label "prediksi" di setiap dasbor, di samping CSAT survei, jangan pernah dicampur secara diam-diam.
- Tambahkan alasan, bukan hanya skor. Wajibkan sistem menunjukkan faktor mana yang mendorong skor rendah, beserta kutipan bagiannya.
- Gunakan untuk routing. Kirim percakapan berprediksi rendah ke antrean manusia dan ambil sampel yang tinggi untuk menangkap rasa aman yang palsu.
- Tinjau setiap kuartal. Jalankan ulang uji holdout, periksa kesenjangan segmen, dan hentikan penggunaan yang tidak dapat didukung model.
Kesalahan Umum
Memperlakukan prediksi sebagai pengukuran. Itu perkiraan. Dasbor yang menampilkan CSAT prediksi dan CSAT survei sebagai metrik yang sama akan menyesatkan orang pada saat keduanya pertama kali berbeda.
Meninggalkan survei. Tanpa respons survei yang segar, Anda tidak bisa memvalidasi, dan model perlahan menyimpang dari apa yang sebenarnya dirasakan pelanggan.
Memakainya untuk menilai orang. CSAT prediksi mencerminkan situasi pelanggan sebanyak keterampilan agen: sengketa penagihan berskor lebih rendah daripada reset kata sandi. Membandingkan agen dengan skor prediksi mentah menghukum siapa pun yang mendapat antrean sulit.
Mengabaikan segmen. Angka keseluruhan bisa tampak baik sementara satu kanal atau bahasa diam-diam salah. Selalu pecah per segmen.

Customer Success Operations Manager
On this page
- Fakta Utama
- Mengapa CSAT Survei Saja Tidak Cukup
- Cara Kerja CSAT Prediksi
- Pendekatan 1: Model terawasi yang dilatih pada riwayat survei Anda
- Pendekatan 2: Model bahasa yang membaca percakapan terhadap faktor yang ditentukan
- Di mana penilaian sentimen berperan
- CSAT Survei vs. CSAT Prediksi
- Contoh Nyata menurut Fungsi
- Cara Memvalidasi Skor Prediksi terhadap Hasil Survei
- Langkah 1: Bangun set holdout
- Langkah 2: Bandingkan di tingkat percakapan
- Langkah 3: Bandingkan di tingkat agregat
- Langkah 4: Periksa bagian yang tidak bisa dilihat survei
- Langkah 5: Waspadai drift
- Bias dan Titik Buta yang Diketahui
- Menerapkan CSAT Prediksi, Langkah demi Langkah
- Kesalahan Umum