Predecir el CSAT con IA: puntuar cada conversación sin encuestas
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
El CSAT predicho es una estimación de cuán satisfecho quedó un cliente con una conversación de soporte, producida por un modelo que lee la conversación y sus metadatos en lugar de esperar a que el cliente responda una encuesta. El resultado suele ser una puntuación (a menudo de 1 a 5, para coincidir con la escala de la encuesta) o una probabilidad de que el cliente habría calificado bien la interacción. Como ningún cliente tiene que responder, puede cubrir casi todas las conversaciones.
Esa cobertura es todo el argumento de venta, y también la trampa. Una encuesta le dice lo que un cliente dijo. Una predicción le dice lo que un modelo supone que habría dicho un cliente, a partir de patrones en conversaciones pasadas. Son cosas distintas, y en la brecha entre ambas es donde los equipos se meten en problemas. Esta guía explica cómo funcionan el CSAT predicho y la puntuación de sentimiento, cómo se comparan con el CSAT de encuesta y cómo contrastar una puntuación predicha con resultados reales de encuestas antes de dejar que oriente decisiones. Forma parte de la colección AI for Customer Service, así que la visión general de la IA en el servicio al cliente ofrece el panorama más amplio.
Primero, un límite. Calificar qué tan bien gestionó una conversación un agente frente a una rúbrica es otro trabajo, tratado en el aseguramiento de calidad con IA para soporte. Este artículo trata del resultado para el cliente: ¿quedó satisfecho, y cómo lo sabemos sin preguntar?
Datos clave
- El CX Score de Intercom, una alternativa generada por IA al CSAT de encuesta, califica las conversaciones cerradas de 1 a 5 evaluando de forma independiente un conjunto de motivos con nombre y combinando después los que no son neutrales. Las conversaciones telefónicas no se puntúan (Intercom).
- Intercom describe el CSAT de encuesta como una forma de captar la opinión de un grupo pequeño y autoseleccionado que a menudo sobrerrepresenta las opiniones extremas (visión del proveedor) (Intercom).
- El trabajo académico sobre modelado de la satisfacción del cliente describe las tasas de respuesta de las encuestas como muy bajas y señala que quienes no responden suelen ser la mayor parte de la base de clientes, por lo que ignorarlos puede sesgar las estimaciones (Toronto Metropolitan University).
- Cuando Zendesk lanzó Satisfaction Prediction en 2016, dijo que el modelo leía cientos de señales, entre ellas la descripción en texto, el número de respuestas y el tiempo total de espera, y que estaba disponible para cuentas Enterprise que recibieran al menos 500 calificaciones de satisfacción al mes (Zendesk).
- Una investigación sobre LLM como jueces encontró que los modelos potentes pueden alcanzar más de 80% de coincidencia con las preferencias humanas, el mismo nivel en que las personas coinciden entre sí, aunque también muestran sesgos de posición, de verbosidad y de automejora (Zheng et al., 2023).
- Un modelo bien calibrado es aquel en el que, entre los casos puntuados cerca de 0,8, alrededor del 80% resulta positivo en realidad (documentación de scikit-learn).
Por qué el CSAT de encuesta por sí solo se queda corto
El CSAT de encuesta es sencillo: cuando una conversación se cierra, se envía una solicitud de calificación de una sola pregunta y se reporta la proporción de calificaciones buenas. Es barato y los clientes lo entienden. Pero tiene tres debilidades estructurales que ningún diseño de encuesta corrige del todo.
Cobertura. Solo cuentan los clientes que responden. Las tasas de respuesta varían según el canal, la audiencia y el diseño de la encuesta, y la investigación resumida arriba las llama muy bajas. Si gestiona soporte con miles de conversaciones por semana, quizá esté tomando decisiones de dotación de personal y de producto con una fracción de ellas.
Sesgo de autoselección. Quienes responden no son una muestra aleatoria. Responden los clientes muy contentos y los muy descontentos; el amplio punto medio se encoge de hombros y se va. La mayoría silenciosa, incluido el cliente que se molestó un poco y canceló discretamente un mes después, es en gran parte invisible. Los investigadores citados arriba plantean lo mismo: los que no responden tienden a ser el grupo mayor, así que dejarlos fuera puede sesgar los resultados.
Brechas de momento y de canal. Una encuesta tras un hilo de correo cerrado no dice nada del chat que se abandonó ni del ticket que quedó sin respuesta. Las encuestas además llegan tarde: usted se entera de una mala semana la semana siguiente.
El CSAT predicho ataca directamente el primer y el tercer problema. Puede puntuar una conversación en el momento en que se cierra (o mientras sigue abierta) y no depende de que haya respuesta. No corrige el sesgo de forma automática. Un modelo entrenado con respuestas de encuestas hereda el sesgo de la encuesta, que es lo principal que conviene tener presente en el resto de este artículo.
Cómo funciona el CSAT predicho
Hay dos enfoques generales, y muchos productos los combinan.
Enfoque 1: un modelo supervisado entrenado con su historial de encuestas
Se toman conversaciones pasadas que sí recibieron respuesta a una encuesta, se trata la calificación como etiqueta y se entrena un modelo para predecirla a partir de características de la conversación. El lanzamiento de Zendesk en 2016 es un ejemplo claro de este diseño: el modelo usaba señales como el texto del ticket, el número de respuestas y el tiempo total de espera, y el producto exigía un volumen mínimo de calificaciones al mes para que hubiera suficiente historial etiquetado del que aprender (Zendesk). Ese requisito de volumen es un buen recordatorio: la predicción supervisada necesita muchas respuestas reales de encuestas para aprender, lo que significa que depende en silencio de los mismos datos que pretende reemplazar.
Características típicas:
- Señales de texto: las palabras del cliente, los cambios de sentimiento a lo largo de los mensajes, frases como «sigue sin funcionar» o «es la tercera vez que lo pido».
- Señales de esfuerzo: número de respuestas, reasignaciones, traspasos entre agentes, número de veces que el cliente tuvo que repetirse.
- Señales de tiempo: tiempo de primera respuesta, tiempo total de espera, intervalos entre respuestas.
- Contexto: canal, tema, nivel del cliente, si se trata de un contacto repetido.
Enfoque 2: un modelo de lenguaje que lee la conversación frente a factores definidos
Los productos más nuevos usan un modelo de lenguaje para leer toda la transcripción y juzgarla frente a factores con nombre, y luego los resumen en una puntuación. El CX Score de Intercom funciona así. Evalúa motivos específicos (calidad de la respuesta, esfuerzo del cliente, emoción intensa, opinión sobre el producto o el servicio y opinión sobre la política), trata un motivo como neutral si no hay una señal fuerte y deriva una calificación de 1 a 5 de la combinación de los motivos no neutrales, sin dar un peso oculto a un motivo sobre otro (Intercom). Puntúa solo conversaciones cerradas por messenger o correo, lo que indica algo práctico: todo producto de CSAT predicho tiene límites de alcance, y usted necesita conocer los suyos.
Los motivos importan más que el número. «3,2, impulsado por un alto esfuerzo del cliente y una queja sobre la política» le dice qué corregir.
Dónde encaja la puntuación de sentimiento
El análisis de sentimiento es el bloque de construcción de la mayor parte de esto. Etiqueta el tono emocional del texto, mensaje por mensaje. El CSAT predicho va un paso más allá: combina el tono con el esfuerzo, el resultado y el contexto para estimar el veredicto global sobre la interacción. Una conversación puede tener un comienzo enojado y un final feliz (el cliente estaba molesto, el agente lo resolvió, el cliente dio las gracias). El sentimiento por mensaje ve ambas mitades. Una buena predicción de CSAT da más peso al final.
CSAT de encuesta frente a CSAT predicho
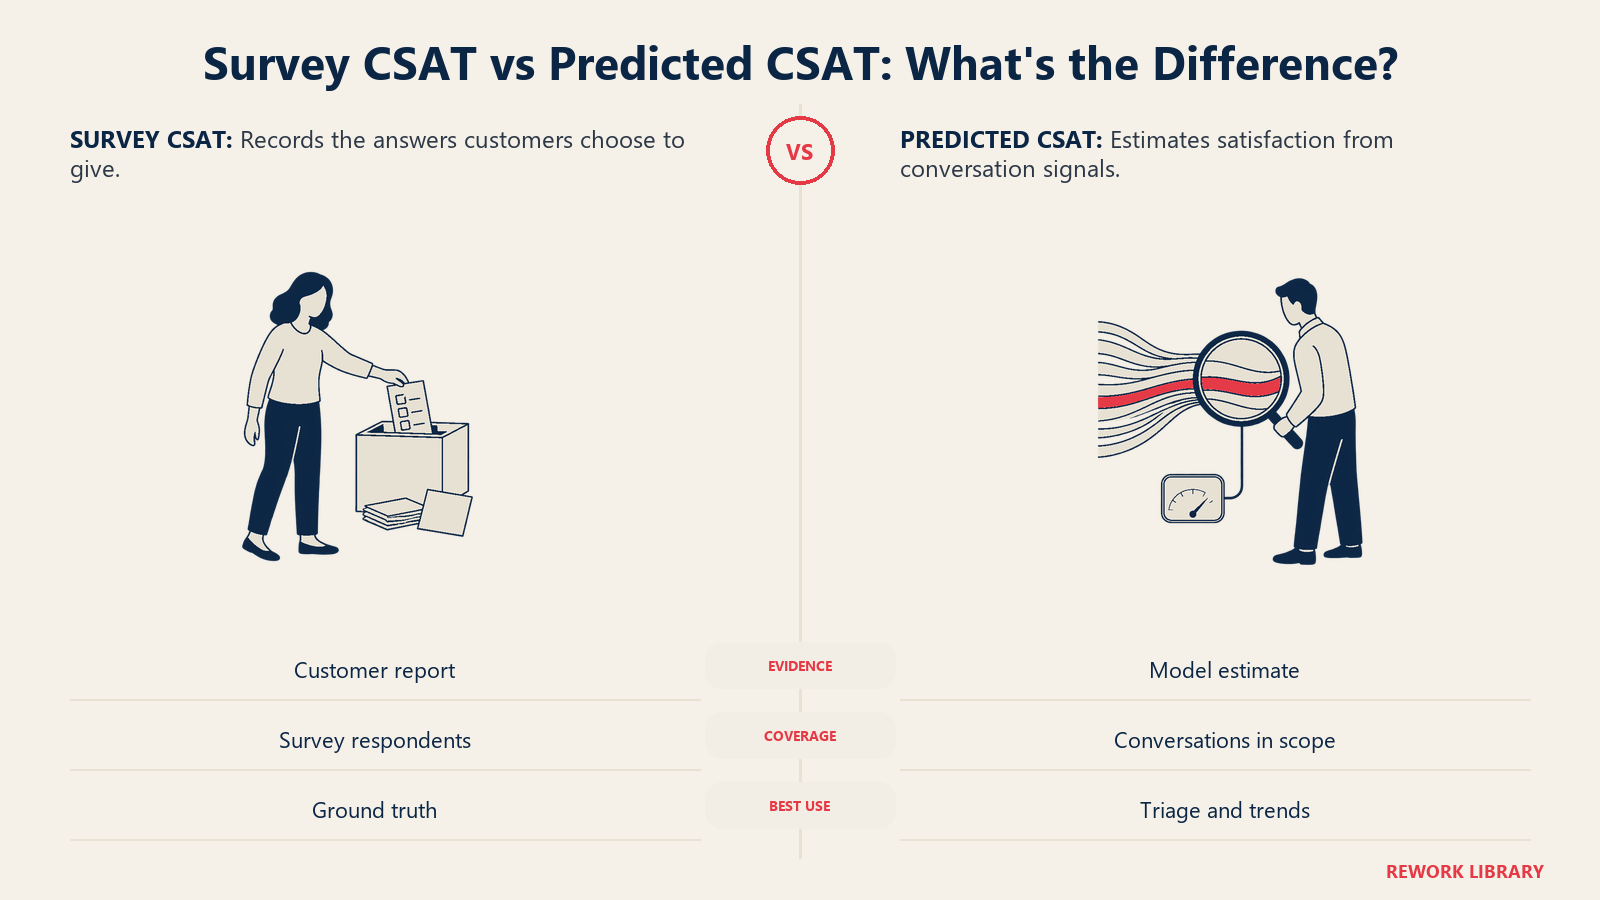
| Dimensión | CSAT de encuesta | CSAT predicho |
|---|---|---|
| Qué mide | Lo que el cliente dijo que sintió | La estimación de un modelo de lo que diría |
| Cobertura | Solo los clientes que responden | Casi todas las conversaciones dentro del alcance |
| Sesgo principal | Autoselección, extremos sobrerrepresentados | Heredado de los datos de entrenamiento, más los puntos ciegos del modelo |
| Rapidez | Después de que se responde la encuesta | Al cierre de la conversación o muy cerca |
| Explica el «porqué» | Solo si hay un comentario de texto libre | Puede adjuntar motivos y citas |
| Bueno para | Ground truth (datos de referencia), reportes, benchmarking | Triaje, detección de tendencias, descubrir problemas silenciosos |
| Débil en | Mayoría silenciosa, conversaciones abandonadas | Sarcasmo, contexto que el modelo no ve, temas nuevos |
La conclusión no es «reemplace las encuestas». Es que ambos tienen errores complementarios. Las encuestas son estrechas pero reales; las predicciones son amplias pero modeladas. Usadas juntas, la encuesta se convierte en el ground truth que mantiene honesta a la predicción, y la predicción extiende esa verdad a las conversaciones que nadie calificó.
Ejemplos reales por función
Liderazgo de soporte. Una directora de soporte ve que el CSAT de encuesta se mantiene estable en el mismo nivel durante un trimestre. La puntuación predicha, que se calcula sobre todas las conversaciones, cae con fuerza en un tema (por ejemplo, un cambio de facturación). La encuesta no lo detectó porque pocos de esos clientes respondieron. La directora enruta una muestra de esas conversaciones a un revisor humano y encuentra la causa raíz.
Producto e ingeniería. Las puntuaciones desglosadas por tema y por motivo se convierten en una lista ordenada de lo que frustra a los clientes. Combínelas con el resumen de tickets con IA y el equipo de producto obtiene una explicación breve y citada para cada grupo de baja puntuación en lugar de una hoja de cálculo.
Customer success. Un CSAT predicho bajo en los tickets recientes de una cuenta clave es una alerta temprana que ninguna encuesta habría revelado. Es una de varias entradas para los índices de salud de la cuenta y para las señales de soporte que predicen el churn, y nunca debería ser la única.
Operaciones de soporte y QA. El CSAT predicho decide qué conversaciones debe leer una persona. Es una señal de triaje. Las conversaciones con puntuación baja van a revisión, y los resultados de la revisión retroalimentan las comprobaciones del modelo. No debería usarse para calificar a agentes individuales (para eso, vea el artículo de QA enlazado arriba).
Soporte proactivo. Si una conversación tiende a lo negativo mientras sigue abierta, un supervisor puede intervenir antes de que se cierre.
Cómo validar las puntuaciones predichas frente a los resultados de las encuestas
Este es el paso que la mayoría de los equipos se salta, y el que decide si el número vale la pena. El principio: las respuestas de encuesta que sí tiene son ejemplos etiquetados. Reserve algunas, no entrene nunca con ellas y pruebe el modelo con ellas.
Paso 1: construya un conjunto de reserva
Tome conversaciones con encuesta de un periodo reciente y apártelas. Si el proveedor entrenó con su historial, pregunte qué periodo se usó para el entrenamiento y asegúrese de que su conjunto de prueba sea posterior. Un modelo probado con conversaciones con las que se entrenó parecerá mejor de lo que es.
Paso 2: compare a nivel de conversación
Para cada conversación reservada, ponga la puntuación predicha junto a la calificación real de la encuesta. Empiece con estas comprobaciones:
| Comprobación | Qué le dice | Qué buscar |
|---|---|---|
| Concordancia de rangos | ¿Ordena el modelo las conversaciones como lo hicieron los clientes? | Las puntuaciones predichas más altas deberían corresponder a calificaciones de encuesta más altas |
| Clasificación de buenas frente a malas | ¿Puede separar a los clientes satisfechos de los insatisfechos? | Use ROC AUC, que resume en un solo número qué tan bien las puntuaciones separan los dos grupos (scikit-learn) |
| Calibración | ¿Significan las probabilidades lo que dicen? | Entre las conversaciones puntuadas cerca de 0,8, alrededor del 80% debería calificarse como buena (scikit-learn) |
| Error por segmento | ¿Es igual de preciso en todas partes? | Desglose los resultados por canal, idioma, tema y nivel del cliente |
La calibración merece una mirada más atenta. Grafique la probabilidad predicha frente a la proporción real de calificaciones buenas en cada tramo (un diagrama de fiabilidad). Si la línea queda cerca de la diagonal, las puntuaciones se comportan como probabilidades reales. Si no, aún puede usar el modelo para ordenar, pero no debería leer un «0,8» como un 80% de probabilidad de un cliente contento.
Paso 3: compare a nivel agregado
Nadie actúa según la puntuación de una sola conversación. Los líderes leen promedios por equipo, tema y semana. Así que compruebe también si el CSAT predicho promedio de un grupo sigue al CSAT de encuesta promedio de ese mismo grupo a lo largo del tiempo. Un modelo puede ser ruidoso por conversación y aun así decir la verdad en conjunto, o al revés. Pruebe el nivel que va a usar.
Paso 4: compruebe lo que las encuestas no pueden ver
La pregunta difícil es si el modelo acierta en las conversaciones que nunca recibieron una encuesta. No puede probarlo directamente, pero sí sondearlo. Extraiga una muestra aleatoria de conversaciones sin encuesta, haga que dos revisores las lean sin conocer la puntuación predicha y compare. Si sus revisores discrepan mucho entre sí, ese es el techo para cualquier modelo. La investigación sobre LLM como jueces encontró que los modelos potentes pueden igualar la tasa en que las personas coinciden entre sí, lo que es una meta razonable y no una perfecta (Zheng et al., 2023). Haga además un seguimiento, en unos pocos casos de baja puntuación sin encuesta, con un mensaje breve para saber cómo se sintió realmente el cliente.
Paso 5: vigile la deriva
La concordancia se deteriora cuando cambian el producto, la política o la mezcla de idiomas. Repita la comparación con el conjunto de reserva cada mes y después de cualquier cambio importante.
Sesgos conocidos y puntos ciegos
Sesgo en los datos de entrenamiento. Un modelo supervisado aprende de quienes responden. Si los clientes extremos dominan su historial de encuestas, el modelo aprende cómo suenan los clientes extremos y puede manejar mal el punto medio silencioso. Los investigadores que trabajan en este problema sostienen que los datos de quienes no responden deberían incorporarse al modelado en lugar de ignorarse (Toronto Metropolitan University).
Estilo por encima del fondo. Los modelos de lenguaje como jueces pueden favorecer respuestas más largas y pulidas, un sesgo de verbosidad documentado (Zheng et al., 2023). En soporte, un intercambio extenso y lleno de disculpas puede parecer más satisfactorio que uno breve que resolvió el problema. Compruebe si el CSAT predicho sigue la longitud del mensaje una vez que se tiene en cuenta el resultado.
Ceguera ante el resultado. La satisfacción depende mucho de si el problema se resolvió de verdad. Un modelo que solo ve la conversación puede no saber que el reembolso nunca llegó. Aliméntelo con datos de resolución donde pueda, y trate la tasa de resolución como una comprobación aparte.
Idioma y cultura. Las normas de cortesía, el sarcasmo y los hábitos de calificación difieren según la región. Un modelo validado con tickets en inglés dice poco sobre los tickets en portugués. Valide por idioma.
La brecha de lo atendido por IA. Las conversaciones atendidas por bots y por personas pueden comportarse de forma distinta: los clientes pueden calificarlas con criterios diferentes, y la precisión del modelo puede diferir entre ellas. Valide los dos grupos por separado en lugar de suponer que un resultado cubre a ambos.
Implementar el CSAT predicho, paso a paso
- Nombre la decisión que apoyará. El triaje, los informes de tendencias, las alertas de cuentas y el coaching de agentes exigen precisiones distintas. Empiece por el triaje, el uso más tolerante.
- Arregle primero sus datos. Un texto de tickets limpio, etiquetas coherentes de canal y tema, y resultados de resolución mejoran las predicciones. Vea preparar los datos de soporte para la IA.
- Mantenga la encuesta en marcha. Es su ground truth. Recortarla para «ahorrar en encuestas» elimina la única forma de validar el modelo.
- Ejecute en modo sombra. Puntúe conversaciones durante unas semanas sin mostrarlas a líderes ni agentes, y compare con los resultados de encuestas que van llegando.
- Valide con los cinco pasos anteriores y anote la precisión que encontró, por segmento.
- Publique qué es el número. Etiquételo como «predicho» en cada Dashboard, junto al CSAT de encuesta, nunca mezclado con él en silencio.
- Agregue motivos, no solo puntuaciones. Exija que el sistema muestre qué factores motivaron una puntuación baja, con el pasaje citado.
- Enrute con él. Envíe las conversaciones con predicción baja a una cola humana y muestree las altas para detectar falsa tranquilidad.
- Revise cada trimestre. Repita la prueba con el conjunto de reserva, revise las brechas por segmento y retire los usos que el modelo no puede sostener.
Errores comunes
Tratar la predicción como una medición. Es una estimación. Un Dashboard que muestra el CSAT predicho y el de encuesta como la misma métrica confundirá a la gente la primera vez que diverjan.
Eliminar la encuesta. Sin respuestas de encuesta recientes no puede validar, y el modelo se aleja poco a poco de lo que los clientes realmente sienten.
Usarlo para calificar a las personas. El CSAT predicho refleja la situación del cliente tanto como la habilidad del agente: una disputa de facturación puntúa menos que un restablecimiento de contraseña. Comparar agentes con puntuaciones predichas en bruto castiga a quien recibe la cola difícil.
Ignorar los segmentos. Un número global puede verse bien mientras un canal o un idioma está equivocado en silencio. Desglose siempre por segmento.

Customer Success Operations Manager
On this page
- Datos clave
- Por qué el CSAT de encuesta por sí solo se queda corto
- Cómo funciona el CSAT predicho
- Enfoque 1: un modelo supervisado entrenado con su historial de encuestas
- Enfoque 2: un modelo de lenguaje que lee la conversación frente a factores definidos
- Dónde encaja la puntuación de sentimiento
- CSAT de encuesta frente a CSAT predicho
- Ejemplos reales por función
- Cómo validar las puntuaciones predichas frente a los resultados de las encuestas
- Paso 1: construya un conjunto de reserva
- Paso 2: compare a nivel de conversación
- Paso 3: compare a nivel agregado
- Paso 4: compruebe lo que las encuestas no pueden ver
- Paso 5: vigile la deriva
- Sesgos conocidos y puntos ciegos
- Implementar el CSAT predicho, paso a paso
- Errores comunes