Analisis Punca Utama AI untuk Sokongan: Mencari Sebab Tiket Wujud
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Analisis punca utama AI untuk sokongan ialah amalan menggunakan model bahasa untuk mengelompokkan beribu tiket mengikut sebab asas pelanggan menghubungi anda, meletakkan kos pada setiap sebab, dan menghantar yang terbesar kepada pasukan produk atau operasi yang boleh menghapuskannya. Matlamatnya bukan untuk menjawab tiket dengan lebih pantas. Ia untuk menghentikan tiket daripada wujud.
Kebanyakan dashboard sokongan melaporkan apa yang berlaku: isi padu mengikut saluran, masa respons, CSAT. Sangat sedikit yang menyatakan mengapa. Dan "mengapa" itulah tempat wang berada, kerana pasukan sokongan boleh sangat cekap menjawab soalan yang sebenarnya dapat dihapuskan oleh pembetulan produk satu baris. Artikel ini menerangkan cara AI mencari punca, cara menilai kosnya dengan formula yang boleh dijalankan dalam hamparan, dan cara menyerahkan dapatan kepada orang yang boleh bertindak. Ia sebahagian daripada koleksi AI for Customer Service, dan menganggap tiket anda agak bersih (lihat menyediakan data sokongan untuk AI jika tidak).
Fakta Utama
- BERTopic, pendekatan sumber terbuka yang digunakan secara meluas, membina topik dalam tiga langkah: ia membenamkan dokumen dengan transformer yang telah dilatih, mengelompokkan benaman itu, kemudian menerangkan setiap kelompok dengan prosedur TF-IDF berasaskan kelas (Grootendorst, 2022).
- Sentence-BERT mengurangkan masa untuk mencari pasangan paling serupa dalam koleksi 10,000 ayat daripada kira-kira 65 jam dengan BERT biasa kepada kira-kira 5 saat, dan itulah yang menjadikan pengelompokan berasaskan benaman bagi set teks besar praktikal (Reimers dan Gurevych, 2019).
- Latent Dirichlet allocation (LDA), model topik klasik, menganggap setiap dokumen sebagai campuran topik dan bukannya menetapkannya kepada tepat satu topik (Blei, Ng dan Jordan, JMLR, 2003). Itu sesuai dengan tiket yang menyebut dua masalah serentak.
- Pengelompokan berasaskan kepadatan seperti HDBSCAN meninggalkan sebahagian dokumen tanpa kelompok. Dalam BERTopic, data terpencil itu dilabel -1 dan tidak digunakan untuk membina huraian topik (dokumentasi BERTopic).
- k-means memerlukan bilangan kelompok ditetapkan terlebih dahulu dan cenderung menghasilkan kumpulan bersaiz hampir sama, manakala pengelompokan aglomeratif membolehkan anda menetapkan ambang kesamaan sebagai gantinya (dokumentasi Sentence Transformers).
- Model benaman lalai BERTopic termasuk pilihan berbilang bahasa yang merangkumi lebih 50 bahasa (dokumentasi BERTopic).
Mengapa Tag dan Dashboard Terlepas Pandang Punca
Kebanyakan pasukan sudah "mengkategorikan" tiket. Masalahnya ialah caranya.
Tag yang dipilih ejen berselerak. Ejen yang berada di bawah tekanan memilih pilihan terdekat daripada senarai juntai bawah yang panjang. "Pengebilan" akhirnya menampung permintaan bayaran balik, soalan cukai, pembayaran gagal dan kekeliruan pelan, yang mempunyai empat pembetulan berbeza. Tag juga dipilih kerana mudah, bukan kerana tepat.
Taksonomi tetap adalah beku. Kategori ditulis setahun lalu. Keluaran baharu mewujudkan masalah baharu, dan ia mendarat dalam "Lain-lain" selama enam minggu sebelum sesiapa menyedarinya.
Gejala dicatat, bukan punca. "Pelanggan tidak boleh log masuk" ialah gejala. Puncanya mungkin pautan jemputan yang tamat tempoh, salah konfigurasi SSO, atau peraturan kata laluan yang mengelirukan. Tiga punca, tiga pemilik, satu tag.
AI mengubah keadaan ini kerana ia membaca perkataan sebenar yang digunakan pelanggan, serta balasan ejen, dan mengelompokkan tiket mengikut makna dan bukannya mengikut label. Kelompok bernama "pautan jemputan tamat tempoh sebelum pekerja baharu membukanya" ialah sesuatu yang boleh ditindak oleh pengurus produk. Tag bernama "Akses akaun" tidak.
Cara AI Mencari Punca Utama
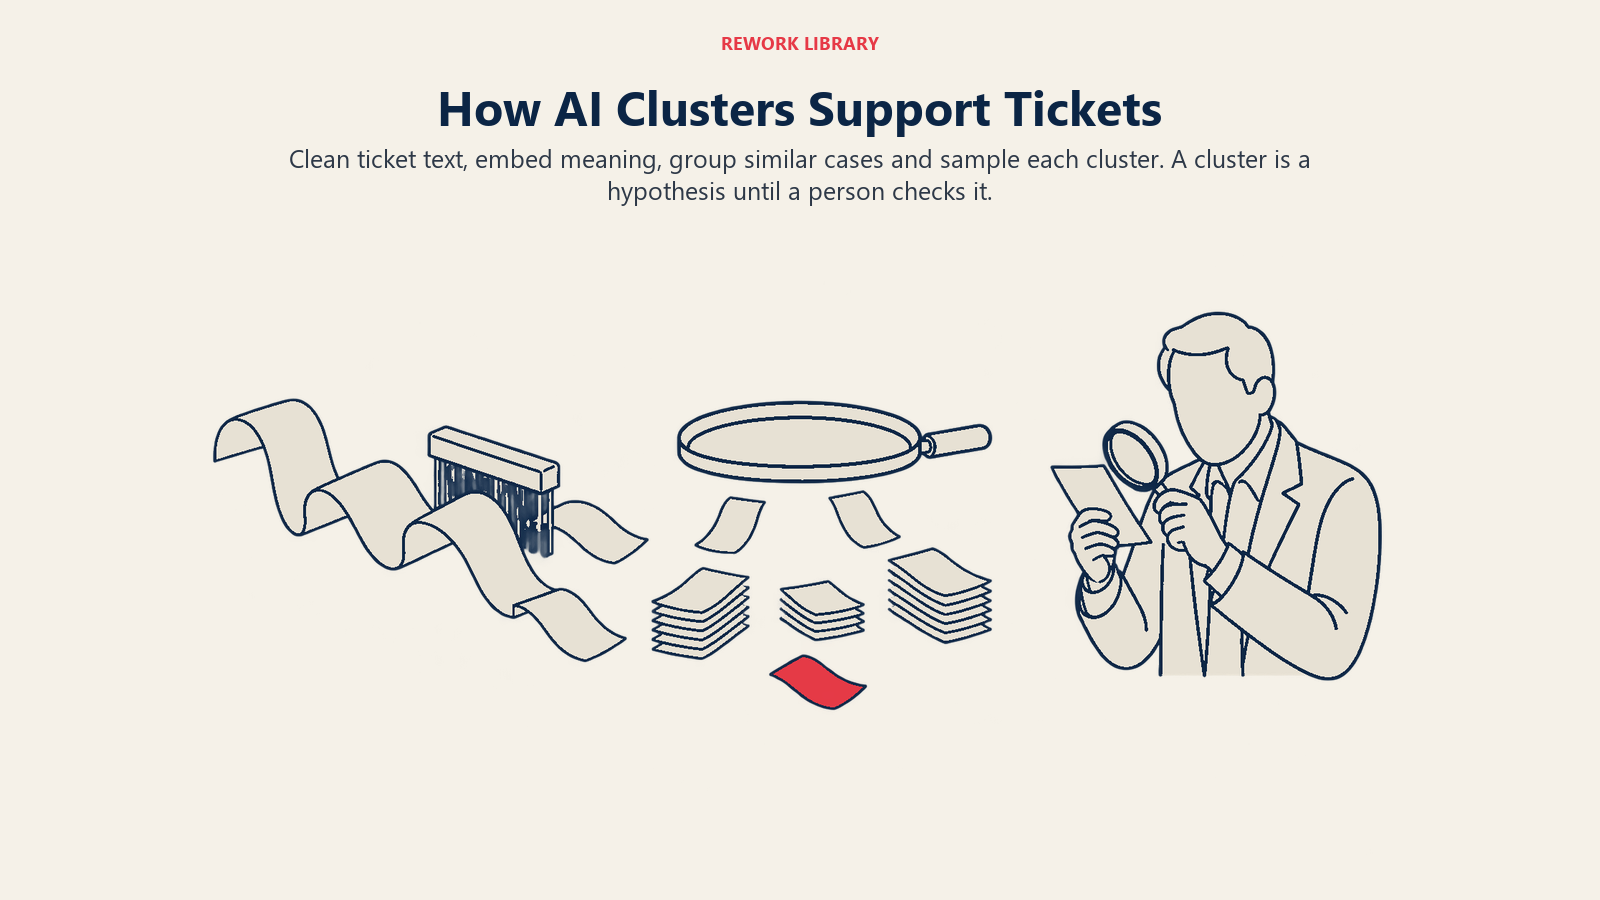
Di sebalik tabir, kebanyakan saluran proses moden mengikut empat langkah yang sama. Memahaminya membantu anda menilai dakwaan vendor atau membina versi kecil sendiri.
Langkah 1: Sediakan teks
Ambil mesej pertama pelanggan, nota penyelesaian akhir ejen, dan sebarang ringkasan dalaman. Buang tandatangan, rantai balasan yang dipetik dan teks piawai. Jika tiket anda berupa urutan panjang, ringkasan tiket selalunya input yang lebih baik daripada urutan mentah, kerana ia pendek dan tentang satu perkara.
Langkah 2: Tukarkan setiap tiket kepada benaman
Benaman ialah senarai nombor yang mewakili sekeping teks supaya makna yang serupa berada berdekatan. "Saya tidak boleh log masuk" dan "log masuk asyik gagal" berakhir berdekatan walaupun tiada perkataan yang sama. Model benaman peringkat ayat menjadikan ini cukup pantas untuk isi padu tiket yang besar (Reimers dan Gurevych, 2019). Jika anda menyokong beberapa bahasa, pilih model benaman berbilang bahasa supaya tiket bahasa Sepanyol dan tiket bahasa Inggeris tentang pepijat yang sama berada bersama.
Langkah 3: Kelompokkan benaman
Pengelompokan mengumpulkan tiket yang berdekatan. Kaedah yang anda pilih mengubah apa yang anda dapat:
| Kaedah | Cara ia berfungsi | Baik untuk | Perhatikan |
|---|---|---|---|
| k-means | Anda memilih bilangan kelompok terlebih dahulu | Pusingan pertama yang pantas apabila anda tahu secara kasar berapa banyak tema wujud | Memaksa tiket ke dalam kumpulan hampir sama saiz; tiket yang ganjil disumbat ke dalam kelompok terdekat |
| Aglomeratif (ambang) | Menggabungkan tiket serupa sehingga ambang kesamaan dicapai | Bilangan tema tidak diketahui; menala kumpulan kasar berbanding halus | Perlahan pada set yang sangat besar |
| HDBSCAN (melalui BERTopic) | Mencari kawasan padat, meninggalkan selebihnya sebagai data terpencil | Data tiket sebenar, yang berselerak dan tidak sekata | Banyak tiket boleh mendarat dalam baldi data terpencil sehingga anda menalanya |
| LDA | Setiap tiket ialah campuran topik berasaskan perkataan | Tiket dengan beberapa isu; senarai perkataan yang telus | Berfungsi pada kiraan perkataan, jadi terlepas makna yang ditangkap benaman |
Keempat-empatnya diterangkan dalam sumber di atas (Sentence Transformers, BERTopic, Blei et al.). Bagi kebanyakan pasukan sokongan, benaman ditambah kaedah berasaskan kepadatan ialah pilihan lalai yang praktikal, kerana data tiket tidak sekata: segelintir tema besar dan ekor panjang tema kecil. Kaedah berasaskan sentroid seperti k-means menganggap kumpulan lebih kemas daripada yang akan anda temui.
Langkah 4: Namakan setiap kelompok dan ambil sampelnya
Kelompok hanyalah longgokan tiket sehingga ia diberi nama. Dua cara melabelnya: senaraikan perkataan yang paling membezakan (langkah TF-IDF berasaskan kelas dalam BERTopic melakukan ini), atau minta model bahasa membaca 10 hingga 20 tiket yang mewakili dan menulis huraian satu ayat. Dengan apa cara sekalipun, seorang manusia patut membaca sampel setiap kelompok yang anda rancang untuk ditindak. Model kadangkala menggabungkan tiket yang kedengaran serupa tetapi mempunyai punca berbeza, seperti "tidak boleh eksport" untuk masalah kebenaran dan "tidak boleh eksport" untuk had saiz fail.
Berkaitan: jika anda hanya perlu mengisih apa yang pelanggan mahu (bayaran balik, batal, naik taraf) dan bukan mengapa ia berlaku, itulah pengesanan niat. Niat memberitahu anda jenis permintaan. Punca utama memberitahu anda apa yang rosak di hulu.
Mengendalikan Data Terpencil dan Kelompok yang Berselerak
Jangkakan ketidaksempurnaan. Beberapa tabiat memastikan hasilnya boleh digunakan:
- Lihat baldi data terpencil setiap kali. Tiket yang tidak ditetapkan bukan sampah. Tanda awal masalah baharu selalunya berada di situ, kerana belum ada cukup tiket serupa untuk membentuk kelompok.
- Pecahkan kelompok besar. Jika satu kelompok memegang 20% isi padu anda, ia mungkin beberapa punca. Jalankan semula pengelompokan di dalamnya.
- Gabungkan hampir-pendua. Dua kelompok dengan pembetulan yang sama patut menjadi satu item baris.
- Jalankan semula mengikut jadual. Larian bulanan pada 90 hari terakhir menangkap lonjakan bermusim dan yang dicetuskan keluaran. Larian mingguan pada 14 hari terakhir menangkap regresi.
Meletakkan Harga pada Setiap Punca
Inilah langkah yang menukar latihan perlombongan teks kepada kes perniagaan. Anda tidak memerlukan penanda aras daripada industri orang lain. Anda memerlukan tiga nombor daripada pasukan helpdesk dan kewangan anda sendiri.
Formula:
Kos bulanan sesuatu punca = tiket sebulan × purata masa pengendalian (minit) × kos terbeban setiap minit ejen
- Tiket sebulan: saiz kelompok, diskalakan kepada isi padu penuh anda jika anda mengelompokkan sampel.
- Purata masa pengendalian: daripada helpdesk anda, bagi tiket dalam kelompok itu, bukan purata seluruh syarikat. Punca teknikal lazimnya mengambil masa jauh lebih lama daripada "di mana pesanan saya."
- Kos terbeban setiap minit ejen: jumlah kos pekerjaan seorang ejen (gaji, faedah, alat, overhed pengurusan) dibahagi dengan minit produktif yang mereka bekerja dalam sebulan. Minta daripada pasukan kewangan.
Jika anda lebih suka berfikir bagi setiap hubungan, "masa pengendalian × kos terbeban seminit" ialah kos setiap hubungan anda bagi punca itu.
Contoh kerja
Nombor di bawah direka untuk menunjukkan aritmetik. Gantikan dengan nombor anda sendiri. Andaikan kos terbeban $0.75 setiap minit ejen.
| Punca (kelompok) | Tiket / bulan | Purata masa pengendalian (min) | Kos bulanan | Kedudukan mengikut isi padu | Kedudukan mengikut kos |
|---|---|---|---|---|---|
| Kekeliruan status pesanan | 3,000 | 5 | 3,000 × 5 × 0.75 = $11,250 | 1 | 4 |
| E-mel tetapan semula kata laluan tidak sampai | 2,400 | 6 | 2,400 × 6 × 0.75 = $10,800 | 2 | 5 |
| Baris cukai invois tidak jelas | 1,200 | 15 | 1,200 × 15 × 0.75 = $13,500 | 3 | 3 |
| Eksport gagal pada fail besar | 900 | 22 | 900 × 22 × 0.75 = $14,850 | 4 | 2 |
| Ralat penyegerakan integrasi | 600 | 35 | 600 × 35 × 0.75 = $15,750 | 5 | 1 |
Lihat dua lajur terakhir. Punca dengan tiket paling sedikit ialah yang paling mahal, dan yang paling bising hanya di tempat keempat. Pasukan yang membaiki mengikut isi padu mengejar status pesanan dahulu. Pasukan yang menilai kos punca mengejar ralat penyegerakan dahulu. Pembalikan itulah keseluruhan hujah untuk melakukan pengiraan ini.
Tambah kos yang disembunyikan formula
Masa pengendalian terkurang kira. Tambahkan apa yang boleh anda ukur:
- Hubungan berulang. Jika sesuatu punca menjana susulan pada isu yang sama, darabkan tiket dengan purata bilangan hubungan bagi setiap kes yang diselesaikan.
- Eskalasi. Tiket yang sampai kepada kejuruteraan menggunakan masa yang mahal di luar sokongan. Tambah masa itu pada kadar terbeban jurutera.
- Churn dan bayaran balik yang dikaitkan dengan punca. Jika pelanggan dalam sesuatu kelompok lebih kerap membatalkan atau meminta kredit, itu patut dimasukkan ke dalam lejar. Analisis churn anda mungkin sudah menjejaki sebahagiannya.
Kekalkan ini sebagai lajur berasingan. Pembaca patut dapat melihat kos masa ejen semata-mata dahulu, kemudian kos yang lebih luas, supaya tiada siapa menyangka nombor itu dibesarkan.
Anggarkan nilai sesuatu pembetulan
Setelah anda mempunyai kos bulanan, nilai pembetulan adalah mudah:
Penjimatan bulanan = kos bulanan × bahagian tiket yang dihapuskan oleh pembetulan
Jika pembetulan pada ralat penyegerakan dijangka menghapuskan 70% tiket tersebut, contoh di atas memberikan 0.70 × $15,750 = $11,025 sebulan. Itu anggaran, jadi berikan julat kepada rakan produk anda (katakan 40% hingga 80%) dan kemas kini selepas keluaran dengan menjalankan semula kelompok. Bandingkan penjimatan dengan usaha kejuruteraan. Beginilah anda memenangi perbahasan keutamaan dengan nombor dan bukannya anekdot.
Menghalakan Pembetulan kepada Pemilik yang Betul
Menemui punca tidak membetulkannya. Kebanyakan pandangan sokongan mati dalam dek slaid kerana tiada siapa memiliki langkah seterusnya. Bina penghalaan ke dalam proses.
| Jenis punca | Pemilik tipikal | Apa yang perlu diserahkan | Rupa "dibaiki" |
|---|---|---|---|
| Pepijat atau aliran rosak | Produk / kejuruteraan | Nama kelompok, bilangan tiket, kos, 5 tiket contoh, langkah untuk menghasilkan semula | Kelompok mengecil selepas keluaran |
| UI mengelirukan atau ciri tiada | Reka bentuk produk / pengurusan produk | Frasa pelanggan secara verbatim, apa yang mereka jangka berbanding apa yang berlaku | Tiket berkurang, atau laluan layan diri menggantikannya |
| Dasar, harga atau pengebilan tidak jelas | Kewangan / operasi hasil | Baris dasar mana yang menyebabkan kekeliruan, kesan bayaran balik | Dasar ditulis semula atau susun atur invois diubah |
| Kegagalan proses atau penyerahan | Operasi | Di mana kes tersekat, kadar hubungan berulang | Langkah, pemilik atau SLA baharu disediakan |
| Kandungan bantuan tiada atau salah | Kandungan sokongan / pasukan pengetahuan | Istilah carian, artikel yang gagal, contoh tiket | Artikel diterbitkan; deflection (pengalihan pertanyaan) bertambah baik (lihat carian pusat bantuan) |
| Jurang pendidikan pelanggan | Kejayaan pelanggan / onboarding | Segmen mana yang bertanya, pada peringkat kitaran hayat mana | Langkah onboarding atau petua dalam aplikasi ditambah |
Beberapa amalan menjadikan penyerahan itu melekat:
- Satu halaman bagi setiap punca. Nama, huraian dalam bahasa mudah, aliran isi padu, kos bulanan, tiket contoh (dengan butiran pelanggan dibuang), pemilik yang dicadangkan dan pembetulan yang disyorkan.
- Semakan tetap. Letakkan mesyuarat bulanan 30 minit dalam kalendar bersama produk, operasi dan sokongan. Bincangkan lima punca teratas mengikut kos, bukan mengikut isi padu.
- Lejar bersama. Jejaki setiap punca daripada "dikenal pasti" kepada "pembetulan dihantar" kepada "isi padu tiket disahkan menurun." Menutup gelung terakhir itulah yang membina kepercayaan. Artikel tiket sokongan kepada backlog produk membincangkan cara menulis permintaan supaya ia sampai ke barisan gilir kejuruteraan, dan menghalakan pandangan sokongan kepada produk dengan AI menunjukkan cara mengekalkan aliran yang stabil.
- Baiki kandungan apabila anda tidak dapat membaiki produk. Jika kejuruteraan tidak dapat bertindak suku tahun ini, artikel bantuan yang lebih baik atau notis proaktif masih mengurangkan isi padu.
Di Mana Ini Sesuai dengan Analisis Punca Utama Klasik
Pengelompokan AI menjawab "apakah punca-puncanya, dan sebesar mana setiap satu?" Ia tidak menjawab "mengapa punca itu wujud?" Soalan kedua itulah tempat kaedah tradisional seperti lima mengapa dan gambar rajah sebab-dan-akibat digunakan. Panduan analisis punca utama membincangkan teknik tersebut. Pembahagian yang berfungsi: AI mencari dan menentukan saiz punca pada peringkat tiket, kemudian kumpulan merentas fungsi yang kecil melakukan RCA manusia pada dua atau tiga teratas.
Melaksanakannya, Langkah demi Langkah
- Pilih skop. Satu barisan produk, satu saluran, 90 hari terakhir. Jangan mulakan di seluruh syarikat.
- Eksport dan bersihkan. Teks tiket, nota penyelesaian, masa pengendalian, saluran, bidang produk, bendera eskalasi. Buang data peribadi yang tidak anda perlukan.
- Jalankan pengelompokan pertama dengan model benaman dan kaedah berasaskan kepadatan. Jangkakan hasil yang berselerak.
- Baca sampel bagi setiap daripada 20 kelompok teratas. Namakan semula, pecahkan dan gabungkan sehingga ejen berkata "ya, itu perkara sebenar."
- Nilai kos setiap kelompok dengan formula, menggunakan masa pengendalian khusus kelompok.
- Susun mengikut kos dan tambah lajur hubungan berulang dan eskalasi.
- Tetapkan pemilik dan serahkan ringkasan satu halaman bagi lima teratas.
- Jalankan semula setiap bulan dan jejaki isi padu setiap kelompok berbanding tarikh pembetulannya dihantar.
- Masukkan semula hasil ke dalam perancangan. Memisahkan lonjakan yang dicetuskan keluaran daripada permintaan keadaan mantap menjadikan ramalan isi padu anda lebih mudah dipercayai.
Kesilapan Lazim
Menganggap kelompok sebagai kebenaran. Kelompok ialah hipotesis. Baca tiket sebelum anda memberitahu kejuruteraan tentangnya.
Menyusun mengikut isi padu. Seperti yang ditunjukkan contoh kerja, punca termurah bagi setiap tiket selalunya mempunyai paling banyak tiket. Susun mengikut kos.
Menggunakan satu masa pengendalian untuk semuanya. Purata seluruh syarikat menyembunyikan tiket yang panjang dan mahal. Gunakan masa pengendalian bagi setiap kelompok.
Mengira penjimatan yang tidak dapat anda sahkan. Laporkan anggaran penjimatan sebagai julat, kemudian ukur penurunan sebenar selepas pembetulan.
Melangkau data terpencil. Masalah baharu bermula kecil. Jika tiada siapa melihat baldi yang tidak ditetapkan, anda mengetahuinya lewat.
Analisis sekali sahaja. Punca berubah dengan setiap keluaran, jadi satu laporan menjadi lapuk dengan cepat.
Menyalahkan ejen atas isi padu yang didorong punca. Jika satu punca menjana sepertiga tiket yang panjang, bimbingan tidak akan membetulkannya. Produklah yang akan.
Berkongsi tiket mentah dengan cuai. Buang nama, e-mel dan butiran akaun sebelum tiket keluar daripada sokongan.
Soalan Lazim tentang Analisis Punca Utama AI untuk Sokongan
Apakah analisis punca utama AI untuk sokongan pelanggan?
Ia ialah penggunaan model bahasa untuk mengelompokkan tiket sokongan mengikut sebab asas pelanggan menghubungi anda, kemudian mengukur kos setiap sebab dan menghalakan yang terbesar kepada pasukan yang boleh membetulkannya. Ia menumpukan pada menghapuskan punca tiket, bukan sekadar menjawabnya dengan lebih pantas.
Bagaimana AI mengelompokkan tiket sokongan?
Kebanyakan pendekatan menukar setiap tiket kepada benaman, satu set nombor yang menangkap maknanya, kemudian mengelompokkan tiket yang benamannya berdekatan. BERTopic ialah contoh sumber terbuka yang biasa: ia membenamkan dokumen, mengelompokkannya, dan menerangkan setiap kelompok dengan kaedah TF-IDF berasaskan kelas. Pendekatan lama seperti LDA berfungsi daripada corak perkataan dan bukannya makna.
Bagaimana saya mengira kos punca tiket?
Darabkan bilangan tiket dalam kelompok sebulan dengan purata masa pengendalian bagi kelompok itu dalam minit, kemudian dengan kos terbeban anda setiap minit ejen. Sebagai contoh, 600 tiket pada 35 minit dan $0.75 seminit ialah $15,750 sebulan. Tambah hubungan berulang, eskalasi dan churn berkaitan sebagai baris berasingan.
Mengapa menyusun punca mengikut kos dan bukan mengikut bilangan tiket?
Bilangan tiket mengutamakan soalan mudah dan kerap yang mengambil beberapa minit setiap satu. Kos mengambil kira masa pengendalian, jadi kelompok kecil tiket teknikal yang panjang boleh mengatasi kelompok besar tiket pantas. Menyusun mengikut kos menghantar masa kejuruteraan yang terhad ke tempat yang paling banyak menjimatkan.
Bolehkah AI mencari punca utama tanpa sebarang semakan manual?
Tidak. Pengelompokan boleh menggabungkan tiket yang kedengaran serupa tetapi mempunyai punca berbeza, dan kaedah berasaskan kepadatan meninggalkan sebahagian tiket tanpa kelompok. Minta seseorang membaca sampel daripada setiap kelompok sebelum ia dihantar kepada produk atau operasi, dan semak tiket yang tidak ditetapkan untuk isu yang sedang muncul.
Seberapa kerap kita patut menjalankan analisis ini?
Jalankan pusingan luas setiap bulan pada 90 hari terakhir, dan pusingan mingguan yang lebih ringan pada 14 hari terakhir untuk menangkap regresi selepas keluaran. Jalankan semula kelompok selepas pembetulannya dihantar untuk mengesahkan isi padu benar-benar menurun.
Siapa yang patut memiliki pembetulan?
Pasukan yang mengawal punca: produk dan kejuruteraan untuk pepijat dan aliran mengelirukan, kewangan untuk pengebilan dan dasar, operasi untuk kegagalan proses, dan pasukan pengetahuan untuk kandungan bantuan yang tiada. Sokongan memiliki analisis dan susulan, bukan setiap pembetulan.

Customer Success Operations Manager
On this page
- Fakta Utama
- Mengapa Tag dan Dashboard Terlepas Pandang Punca
- Cara AI Mencari Punca Utama
- Langkah 1: Sediakan teks
- Langkah 2: Tukarkan setiap tiket kepada benaman
- Langkah 3: Kelompokkan benaman
- Langkah 4: Namakan setiap kelompok dan ambil sampelnya
- Mengendalikan Data Terpencil dan Kelompok yang Berselerak
- Meletakkan Harga pada Setiap Punca
- Contoh kerja
- Tambah kos yang disembunyikan formula
- Anggarkan nilai sesuatu pembetulan
- Menghalakan Pembetulan kepada Pemilik yang Betul
- Di Mana Ini Sesuai dengan Analisis Punca Utama Klasik
- Melaksanakannya, Langkah demi Langkah
- Kesilapan Lazim