Bahasa Indonesia
AI Root Cause Analysis untuk Dukungan: Menemukan Mengapa Tiket Muncul
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI root cause analysis untuk dukungan adalah praktik menggunakan model bahasa untuk mengelompokkan ribuan tiket menurut alasan mendasar mengapa pelanggan menghubungi Anda, memberi biaya pada setiap alasan, dan mengirim yang terbesar ke tim produk atau operasi yang dapat menghapusnya. Tujuannya bukan menjawab tiket lebih cepat. Tujuannya adalah mencegah tiket itu ada.
Sebagian besar dashboard dukungan melaporkan apa yang terjadi: volume per kanal, waktu respons, CSAT. Sangat sedikit yang menjelaskan mengapa. Dan "mengapa" itulah tempat uangnya berada, karena tim dukungan bisa sangat efisien menjawab pertanyaan yang sebenarnya akan lenyap dengan perbaikan produk satu baris. Artikel ini menguraikan cara AI menemukan penyebab, cara menghitung biayanya dengan rumus yang bisa dijalankan di spreadsheet, dan cara menyerahkan temuan kepada orang yang dapat bertindak. Artikel ini bagian dari koleksi AI for Customer Service, dan mengasumsikan tiket Anda cukup bersih (lihat menyiapkan data dukungan untuk AI jika belum).
Fakta Utama
- BERTopic, pendekatan open-source yang banyak dipakai, membangun topik dalam tiga langkah: menyematkan dokumen dengan transformer yang sudah dilatih, mengelompokkan sematan tersebut, lalu mendeskripsikan setiap klaster dengan prosedur TF-IDF berbasis kelas (Grootendorst, 2022).
- Sentence-BERT memangkas waktu untuk menemukan pasangan paling mirip dalam kumpulan 10.000 kalimat dari sekitar 65 jam dengan BERT biasa menjadi sekitar 5 detik, yang membuat pengelompokan berbasis sematan pada kumpulan teks besar menjadi praktis (Reimers dan Gurevych, 2019).
- Latent Dirichlet allocation (LDA), model topik klasik, memperlakukan setiap dokumen sebagai campuran topik, bukan menetapkannya pada tepat satu topik (Blei, Ng dan Jordan, JMLR, 2003). Itu cocok untuk tiket yang menyebut dua masalah sekaligus.
- Pengelompokan berbasis kepadatan seperti HDBSCAN menyisakan sebagian dokumen tanpa klaster. Dalam BERTopic, pencilan itu diberi label -1 dan tidak dipakai untuk menyusun deskripsi topik (dokumentasi BERTopic).
- k-means memerlukan jumlah klaster yang ditetapkan sebelumnya dan cenderung menghasilkan kelompok berukuran hampir sama, sedangkan pengelompokan aglomeratif memungkinkan Anda menetapkan ambang kemiripan (dokumentasi Sentence Transformers).
- Model sematan bawaan BERTopic mencakup opsi multibahasa yang meliputi lebih dari 50 bahasa (dokumentasi BERTopic).
Mengapa Tag dan Dashboard Melewatkan Penyebabnya
Sebagian besar tim sudah "mengategorikan" tiket. Masalahnya ada pada caranya.
Tag pilihan agen itu berisik. Agen yang sedang tertekan memilih opsi terdekat dari dropdown yang panjang. "Penagihan" akhirnya menampung permintaan pengembalian dana, pertanyaan pajak, pembayaran gagal, dan kebingungan paket, yang memiliki empat perbaikan berbeda. Tag juga dipilih karena mudah, bukan karena akurat.
Taksonomi tetap itu membeku. Kategorinya ditulis setahun lalu. Rilis baru menciptakan masalah baru, dan masalah itu mendarat di "Lainnya" selama enam minggu sebelum ada yang menyadari.
Yang dicatat gejala, bukan penyebab. "Pelanggan tidak bisa masuk" adalah gejala. Penyebabnya bisa tautan undangan yang kedaluwarsa, salah konfigurasi SSO, atau aturan kata sandi yang membingungkan. Tiga penyebab, tiga pemilik, satu tag.
AI mengubah ini karena ia membaca kata-kata sebenarnya yang dipakai pelanggan, ditambah balasan agen, dan mengelompokkan tiket menurut makna alih-alih menurut label. Klaster bernama "tautan undangan kedaluwarsa sebelum karyawan baru membukanya" adalah sesuatu yang bisa ditindaklanjuti manajer produk. Tag bernama "Akses akun" tidak.
Cara AI Menemukan Akar Masalah
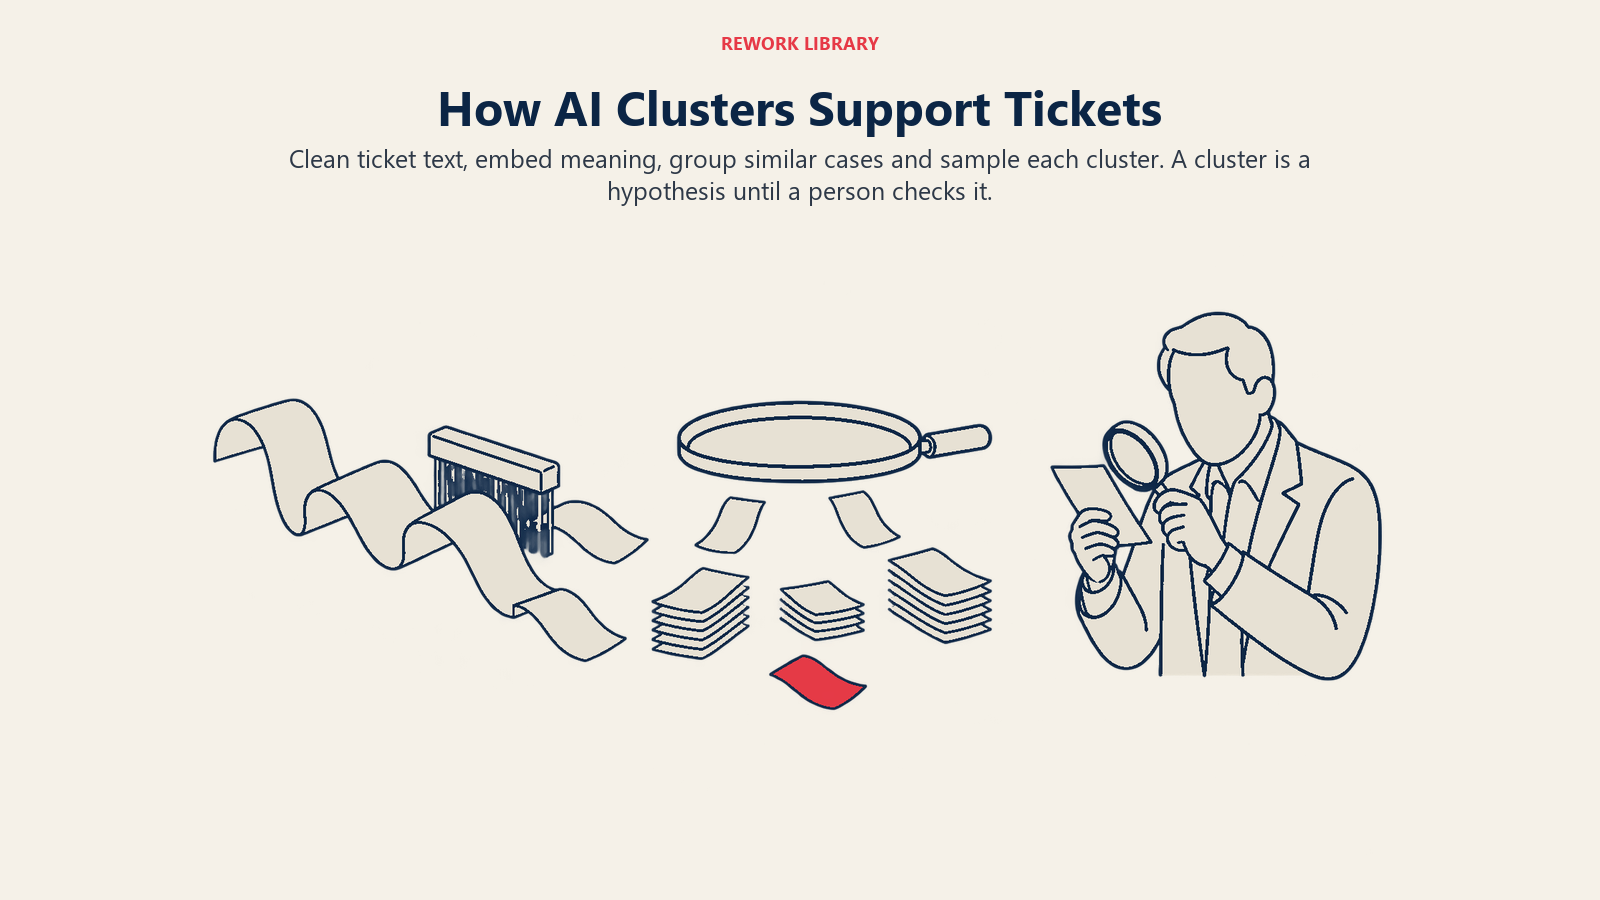
Di balik layar, sebagian besar pipeline modern mengikuti empat langkah yang sama. Memahaminya membantu Anda menilai klaim vendor atau membangun versi kecilnya sendiri.
Langkah 1: Siapkan teksnya
Ambil pesan pertama pelanggan, catatan penyelesaian akhir dari agen, dan ringkasan internal apa pun. Buang tanda tangan, rantai balasan yang dikutip, dan teks boilerplate. Jika tiket Anda berupa utas panjang, ringkasan tiket sering menjadi masukan yang lebih baik daripada utas mentahnya, karena singkat dan membahas satu hal.
Langkah 2: Ubah setiap tiket menjadi sematan
Sematan (embedding) adalah daftar angka yang mewakili sepotong teks sehingga makna yang mirip berada berdekatan. "Saya tidak bisa masuk" dan "login terus gagal" berakhir berdekatan meski tidak berbagi kata. Model sematan tingkat kalimat membuat ini cukup cepat untuk volume tiket besar (Reimers dan Gurevych, 2019). Jika Anda mendukung beberapa bahasa, pilih model sematan multibahasa agar tiket berbahasa Spanyol dan tiket berbahasa Inggris tentang bug yang sama mendarat bersama.
Langkah 3: Kelompokkan sematannya
Pengelompokan menyatukan tiket yang berdekatan. Metode yang Anda pilih mengubah hasil yang Anda dapat:
| Metode | Cara kerja | Bagus untuk | Waspadai |
|---|---|---|---|
| k-means | Anda memilih jumlah klaster di awal | Putaran pertama yang cepat ketika Anda kira-kira tahu berapa banyak tema yang ada | Memaksa tiket ke dalam kelompok yang kurang lebih sama besar; tiket yang janggal dijejalkan ke klaster terdekat |
| Aglomeratif (ambang) | Menggabungkan tiket yang mirip sampai ambang kemiripan tercapai | Jumlah tema tidak diketahui; menyetel kelompok kasar vs. halus | Lambat pada kumpulan yang sangat besar |
| HDBSCAN (lewat BERTopic) | Menemukan wilayah padat, sisanya dibiarkan sebagai pencilan | Data tiket nyata, yang berantakan dan tidak merata | Banyak tiket bisa mendarat di keranjang pencilan sampai Anda menyetelnya |
| LDA | Setiap tiket adalah campuran topik berbasis kata | Tiket dengan beberapa masalah; daftar kata yang transparan | Bekerja pada hitungan kata, sehingga melewatkan makna yang ditangkap sematan |
Keempatnya dijelaskan dalam sumber di atas (Sentence Transformers, BERTopic, Blei et al.). Bagi sebagian besar tim dukungan, sematan ditambah metode berbasis kepadatan adalah pilihan bawaan yang praktis, karena data tiket tidak merata: segelintir tema raksasa dan ekor panjang tema kecil. Metode berbasis centroid seperti k-means mengasumsikan kelompok yang lebih rapi daripada yang akan Anda temukan.
Langkah 4: Beri nama setiap klaster dan ambil sampelnya
Klaster hanyalah tumpukan tiket sampai ia punya nama. Ada dua cara memberi label: daftarkan kata yang paling khas (langkah TF-IDF berbasis kelas di BERTopic melakukan ini), atau minta model bahasa membaca 10 hingga 20 tiket representatif dan menulis deskripsi satu kalimat. Dengan cara apa pun, manusia harus membaca sampel dari setiap klaster yang akan Anda tindaklanjuti. Model kadang menempelkan tiket yang terdengar mirip tetapi penyebabnya berbeda, seperti "tidak bisa ekspor" untuk masalah izin dan "tidak bisa ekspor" untuk batas ukuran file.
Terkait: jika Anda hanya perlu memilah apa yang diinginkan pelanggan (pengembalian dana, berhenti, upgrade) dan bukan mengapa itu terjadi, itulah deteksi intent. Intent memberi tahu jenis permintaan. Akar masalah memberi tahu apa yang rusak di hulu.
Menangani Pencilan dan Klaster yang Berantakan
Harapkan ketidaksempurnaan. Beberapa kebiasaan menjaga hasilnya tetap berguna:
- Lihat keranjang pencilan setiap kali. Tiket yang tidak terklaster bukan sampah. Tanda awal masalah baru sering berada di sana, karena belum ada cukup tiket serupa untuk membentuk klaster.
- Pecah klaster besar. Jika satu klaster menampung 20% volume Anda, kemungkinan itu beberapa penyebab. Jalankan ulang pengelompokan di dalamnya.
- Gabungkan yang nyaris kembar. Dua klaster dengan perbaikan yang sama sebaiknya menjadi satu butir.
- Jalankan ulang secara terjadwal. Putaran bulanan pada 90 hari terakhir menangkap lonjakan musiman dan lonjakan akibat rilis. Putaran mingguan pada 14 hari terakhir menangkap regresi.
Memberi Harga pada Setiap Penyebab
Inilah langkah yang mengubah latihan penambangan teks menjadi kasus bisnis. Anda tidak memerlukan benchmark dari industri orang lain. Anda memerlukan tiga angka dari helpdesk dan tim keuangan Anda sendiri.
Rumusnya:
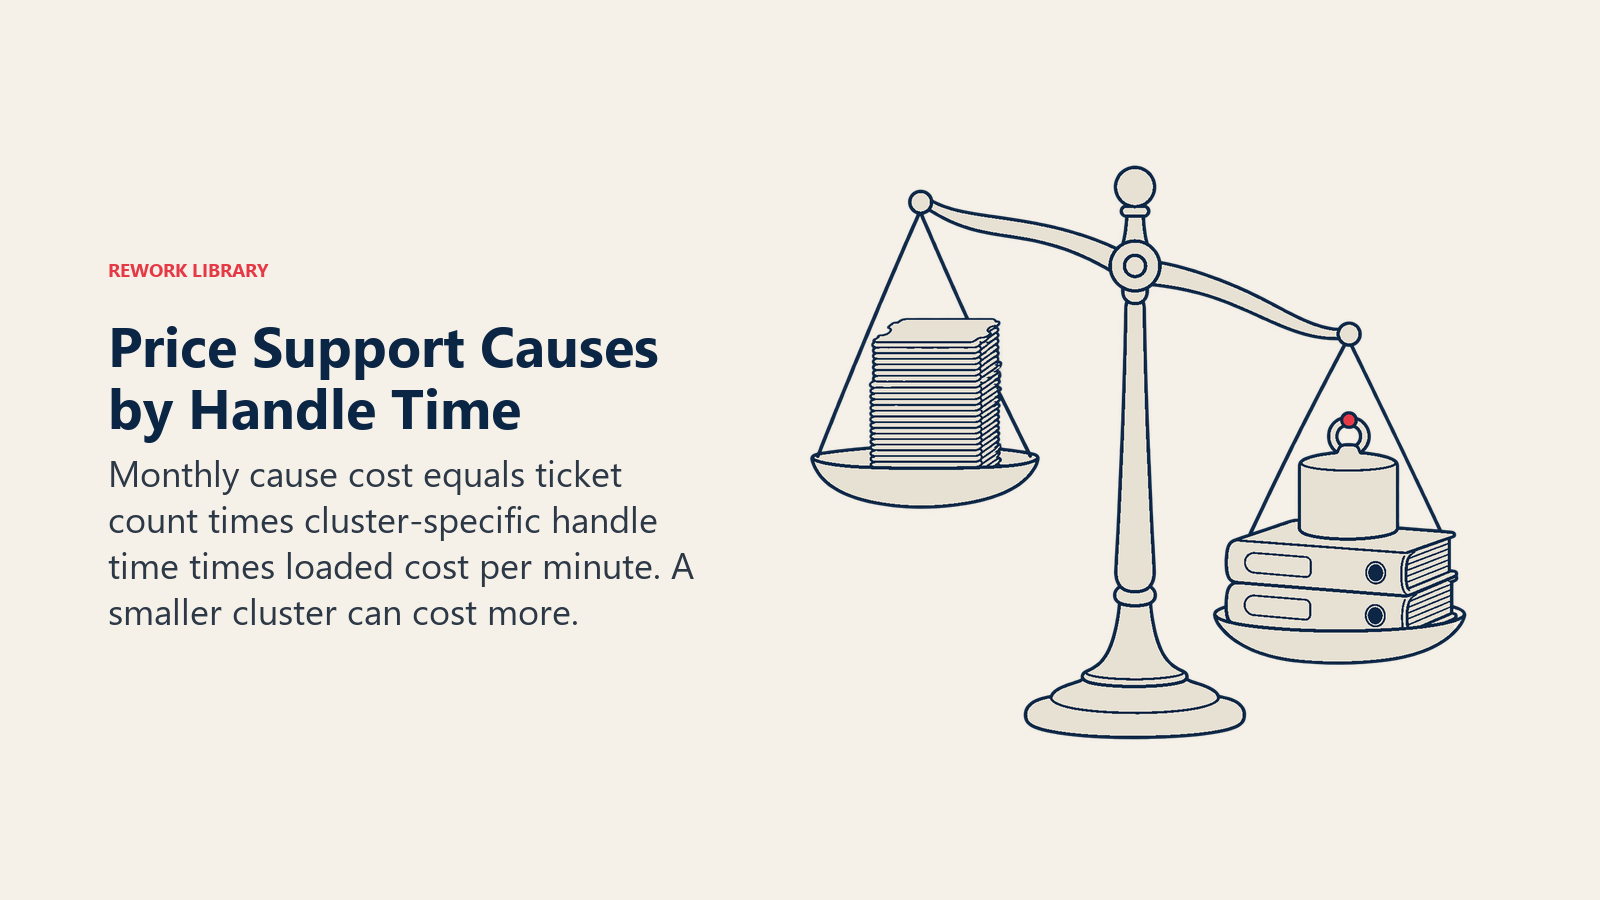
Biaya bulanan suatu penyebab = tiket per bulan × rata-rata waktu penanganan (menit) × biaya penuh per menit agen
- Tiket per bulan: ukuran klaster, diskalakan ke volume penuh Anda jika Anda mengelompokkan sampel.
- Rata-rata waktu penanganan: dari helpdesk Anda, untuk tiket dalam klaster itu, bukan rata-rata seluruh perusahaan. Penyebab teknis biasanya memakan waktu jauh lebih lama daripada "di mana pesanan saya."
- Biaya penuh per menit agen: total biaya kerja seorang agen (gaji, tunjangan, alat, overhead manajemen) dibagi menit produktif yang ia kerjakan dalam sebulan. Mintalah dari tim keuangan.
Jika Anda lebih suka berpikir per kontak, "waktu penanganan × biaya penuh per menit" adalah biaya per kontak untuk penyebab tersebut.
Contoh perhitungan
Angka di bawah ini dibuat-buat untuk menunjukkan aritmetikanya. Gantilah dengan angka Anda sendiri. Anggaplah biaya penuh sebesar $0,75 per menit agen.
| Penyebab (klaster) | Tiket / bulan | Rata-rata waktu penanganan (menit) | Biaya bulanan | Peringkat menurut volume | Peringkat menurut biaya |
|---|---|---|---|---|---|
| Kebingungan status pesanan | 3.000 | 5 | 3.000 × 5 × 0,75 = $11.250 | 1 | 4 |
| Email reset kata sandi tidak sampai | 2.400 | 6 | 2.400 × 6 × 0,75 = $10.800 | 2 | 5 |
| Baris pajak faktur tidak jelas | 1.200 | 15 | 1.200 × 15 × 0,75 = $13.500 | 3 | 3 |
| Ekspor gagal pada file besar | 900 | 22 | 900 × 22 × 0,75 = $14.850 | 4 | 2 |
| Galat sinkronisasi integrasi | 600 | 35 | 600 × 35 × 0,75 = $15.750 | 5 | 1 |
Perhatikan dua kolom terakhir. Penyebab dengan tiket paling sedikit adalah yang paling mahal, dan yang paling ramai hanya peringkat keempat. Tim yang memperbaiki menurut volume akan mengejar status pesanan lebih dulu. Tim yang menghitung biaya penyebab akan mengejar galat sinkronisasi lebih dulu. Pembalikan itulah seluruh argumen untuk melakukan perhitungan ini.
Tambahkan biaya yang disembunyikan rumus
Waktu penanganan menghitung terlalu rendah. Tambahkan apa yang bisa Anda ukur:
- Kontak berulang. Jika suatu penyebab menghasilkan tindak lanjut untuk masalah yang sama, kalikan tiket dengan rata-rata jumlah kontak per kasus yang diselesaikan.
- Eskalasi. Tiket yang sampai ke engineering menyita waktu mahal di luar dukungan. Tambahkan waktu itu dengan tarif penuh engineer.
- Churn dan pengembalian dana yang terkait penyebab. Jika pelanggan dalam suatu klaster lebih sering berhenti atau meminta kredit, itu masuk ke buku besar. Analisis churn Anda mungkin sudah menelusuri sebagian di antaranya.
Simpan semuanya sebagai kolom terpisah. Pembaca harus bisa melihat biaya waktu agen murni lebih dulu, baru biaya yang lebih luas, agar tak seorang pun mengira angkanya digelembungkan.
Perkirakan nilai sebuah perbaikan
Setelah Anda punya biaya bulanan, nilai sebuah perbaikan sederhana:
Penghematan bulanan = biaya bulanan × porsi tiket yang dihapus perbaikan
Jika perbaikan galat sinkronisasi diperkirakan menghapus 70% tiket tersebut, contoh di atas memberi 0,70 × $15.750 = $11.025 per bulan. Itu perkiraan, jadi berikan rentang kepada mitra produk Anda (misalnya 40% hingga 80%) dan perbarui setelah rilis dengan menjalankan ulang klaster. Bandingkan penghematan dengan upaya engineering. Beginilah Anda memenangkan perdebatan prioritas dengan angka, bukan anekdot.
Mengarahkan Perbaikan ke Pemilik yang Tepat
Menemukan penyebab tidak memperbaikinya. Sebagian besar wawasan dukungan mati di slide deck karena tak ada yang memiliki langkah berikutnya. Bangun pengarahan itu ke dalam proses.
| Jenis penyebab | Pemilik tipikal | Apa yang diserahkan | Seperti apa "sudah diperbaiki" |
|---|---|---|---|
| Bug atau alur yang rusak | Produk / engineering | Nama klaster, jumlah tiket, biaya, 5 contoh tiket, langkah reproduksi | Klaster menyusut setelah rilis |
| UI membingungkan atau fitur hilang | Desain produk / manajemen produk | Frasa pelanggan apa adanya, apa yang mereka harapkan vs. apa yang terjadi | Tiket berkurang, atau jalur swalayan menggantikannya |
| Kebijakan, harga, atau penagihan tidak jelas | Keuangan / operasi pendapatan | Baris kebijakan mana yang menimbulkan kebingungan, dampak pengembalian dana | Kebijakan ditulis ulang atau tata letak faktur diubah |
| Kegagalan proses atau serah terima | Operasi | Di mana kasus macet, tingkat kontak berulang | Langkah, pemilik, atau SLA baru diterapkan |
| Konten bantuan hilang atau salah | Tim konten dukungan / pengetahuan | Istilah pencarian, artikel yang gagal, contoh tiket | Artikel terbit; deflection (pengalihan pertanyaan) membaik (lihat pencarian pusat bantuan) |
| Kesenjangan edukasi pelanggan | Customer success / onboarding | Segmen mana yang bertanya, pada tahap siklus hidup apa | Langkah onboarding atau tip dalam aplikasi ditambahkan |
Beberapa praktik membuat serah terima itu melekat:
- Satu halaman per penyebab. Nama, deskripsi bahasa sederhana, tren volume, biaya bulanan, contoh tiket (dengan detail pelanggan dihapus), usulan pemilik, dan saran perbaikan.
- Tinjauan rutin. Pasang rapat bulanan 30 menit di kalender bersama produk, operasi, dan dukungan. Telusuri lima penyebab teratas menurut biaya, bukan menurut volume.
- Buku besar bersama. Lacak setiap penyebab dari "teridentifikasi" ke "perbaikan dirilis" ke "volume tiket terkonfirmasi turun." Menutup putaran terakhir itulah yang membangun kepercayaan. Artikel dari tiket dukungan ke backlog produk membahas cara menulis permintaan agar masuk ke antrean engineering, dan mengarahkan wawasan dukungan ke produk dengan AI menunjukkan cara menjaga alirannya tetap stabil.
- Perbaiki konten ketika produk tak bisa diperbaiki. Jika engineering tak bisa bertindak kuartal ini, artikel bantuan yang lebih baik atau pemberitahuan proaktif tetap mengurangi volume.
Di Mana Ini Cocok dengan Root Cause Analysis Klasik
Pengelompokan AI menjawab "apa saja penyebabnya, dan seberapa besar masing-masing?" Ia tidak menjawab "mengapa penyebab itu ada?" Pertanyaan kedua itulah tempat metode tradisional seperti lima mengapa dan diagram sebab-akibat masuk. Panduan root cause analysis membahas teknik-teknik itu. Pembagian yang layak: AI menemukan dan mengukur penyebab di tingkat tiket, lalu kelompok lintas fungsi kecil melakukan RCA manusia pada dua atau tiga teratas.
Menerapkannya, Langkah demi Langkah
- Pilih lingkup. Satu lini produk, satu kanal, 90 hari terakhir. Jangan mulai dari seluruh perusahaan.
- Ekspor dan bersihkan. Teks tiket, catatan penyelesaian, waktu penanganan, kanal, area produk, penanda eskalasi. Hapus data pribadi yang tidak Anda perlukan.
- Jalankan pengelompokan pertama dengan model sematan dan metode berbasis kepadatan. Harapkan hasil yang berantakan.
- Baca sampel dari setiap 20 klaster teratas. Ganti nama, pecah, dan gabungkan sampai agen berkata "ya, itu hal yang nyata."
- Beri harga setiap klaster dengan rumus, memakai waktu penanganan khusus klaster.
- Urutkan menurut biaya dan tambahkan kolom kontak berulang dan eskalasi.
- Tetapkan pemilik dan serahkan ringkasan satu halaman untuk lima teratas.
- Jalankan ulang setiap bulan dan lacak volume tiap klaster terhadap tanggal perbaikannya dirilis.
- Masukkan hasilnya kembali ke perencanaan. Memisahkan lonjakan akibat rilis dari permintaan stabil membuat peramalan volume Anda lebih bisa dipercaya.
Kesalahan Umum
Memperlakukan klaster sebagai kebenaran. Klaster adalah hipotesis. Baca tiketnya sebelum Anda memberi tahu engineering.
Mengurutkan menurut volume. Seperti ditunjukkan contoh perhitungan, penyebab dengan biaya per tiket terendah sering memiliki tiket terbanyak. Urutkan menurut biaya.
Memakai satu waktu penanganan untuk semuanya. Rata-rata seluruh perusahaan menyembunyikan tiket panjang yang mahal. Gunakan waktu penanganan per klaster.
Menghitung penghematan yang tak bisa Anda konfirmasi. Laporkan perkiraan penghematan sebagai rentang, lalu ukur penurunan aktualnya setelah perbaikan.
Melewatkan pencilan. Masalah baru dimulai dari kecil. Jika tak ada yang melihat keranjang tanpa klaster, Anda mengetahuinya terlambat.
Analisis sekali jalan. Penyebab bergeser dengan setiap rilis, jadi satu laporan cepat basi.
Menyalahkan agen atas volume yang digerakkan penyebab. Jika satu penyebab menghasilkan sepertiga tiket panjang, coaching tak akan memperbaikinya. Produklah yang akan.
Membagikan tiket mentah secara ceroboh. Hapus nama, email, dan detail akun sebelum tiket meninggalkan tim dukungan.
Pertanyaan yang Sering Diajukan tentang AI Root Cause Analysis untuk Dukungan
Apa itu AI root cause analysis untuk dukungan pelanggan?
Itu adalah penggunaan model bahasa untuk mengelompokkan tiket dukungan menurut alasan mendasar pelanggan menghubungi Anda, lalu mengukur biaya setiap alasan dan mengarahkan yang terbesar ke tim yang dapat memperbaikinya. Fokusnya menghapus penyebab tiket, bukan sekadar menjawabnya lebih cepat.
Bagaimana AI mengelompokkan tiket dukungan?
Sebagian besar pendekatan mengubah setiap tiket menjadi sematan, sekumpulan angka yang menangkap maknanya, lalu mengelompokkan tiket yang sematannya berdekatan. BERTopic adalah contoh open-source yang umum: ia menyematkan dokumen, mengelompokkannya, dan mendeskripsikan setiap klaster dengan metode TF-IDF berbasis kelas. Pendekatan lama seperti LDA bekerja dari pola kata, bukan makna.
Bagaimana menghitung biaya penyebab tiket?
Kalikan jumlah tiket dalam klaster per bulan dengan rata-rata waktu penanganan klaster itu dalam menit, lalu dengan biaya penuh per menit agen Anda. Misalnya, 600 tiket pada 35 menit dan $0,75 per menit adalah $15.750 per bulan. Tambahkan kontak berulang, eskalasi, dan churn terkait sebagai baris terpisah.
Mengapa mengurutkan penyebab menurut biaya, bukan jumlah tiket?
Jumlah tiket menguntungkan pertanyaan sederhana yang sering muncul dan memakan beberapa menit masing-masing. Biaya memperhitungkan waktu penanganan, sehingga klaster kecil berisi tiket teknis yang panjang bisa mengungguli klaster besar berisi tiket cepat. Mengurutkan menurut biaya mengarahkan waktu engineering yang langka ke tempat yang paling banyak menghemat.
Dapatkah AI menemukan akar masalah tanpa tinjauan manual?
Tidak. Pengelompokan bisa menggabungkan tiket yang terdengar mirip tetapi penyebabnya berbeda, dan metode berbasis kepadatan menyisakan sebagian tiket tanpa klaster. Minta seseorang membaca sampel dari setiap klaster sebelum diteruskan ke produk atau operasi, dan tinjau tiket yang tidak terklaster untuk menemukan masalah yang baru muncul.
Seberapa sering kami harus menjalankan analisis ini?
Jalankan putaran luas setiap bulan pada 90 hari terakhir, dan putaran mingguan yang lebih ringan pada 14 hari terakhir untuk menangkap regresi setelah rilis. Jalankan ulang sebuah klaster setelah perbaikannya dirilis untuk memastikan volumenya benar-benar turun.
Siapa yang harus memiliki perbaikannya?
Tim yang mengendalikan penyebabnya: produk dan engineering untuk bug dan alur yang membingungkan, keuangan untuk penagihan dan kebijakan, operasi untuk kegagalan proses, dan tim pengetahuan untuk konten bantuan yang hilang. Dukungan memiliki analisis dan tindak lanjutnya, bukan setiap perbaikan.

Customer Success Operations Manager
On this page
- Fakta Utama
- Mengapa Tag dan Dashboard Melewatkan Penyebabnya
- Cara AI Menemukan Akar Masalah
- Langkah 1: Siapkan teksnya
- Langkah 2: Ubah setiap tiket menjadi sematan
- Langkah 3: Kelompokkan sematannya
- Langkah 4: Beri nama setiap klaster dan ambil sampelnya
- Menangani Pencilan dan Klaster yang Berantakan
- Memberi Harga pada Setiap Penyebab
- Contoh perhitungan
- Tambahkan biaya yang disembunyikan rumus
- Perkirakan nilai sebuah perbaikan
- Mengarahkan Perbaikan ke Pemilik yang Tepat
- Di Mana Ini Cocok dengan Root Cause Analysis Klasik
- Menerapkannya, Langkah demi Langkah
- Kesalahan Umum