Análisis de causa raíz con IA para soporte: descubrir por qué surgen los tickets
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
El análisis de causa raíz con IA para soporte es la práctica de usar modelos de lenguaje para agrupar miles de tickets según el motivo de fondo por el que los clientes escribieron, ponerle un costo a cada motivo y enviar los más grandes al equipo de producto u operaciones que puede eliminarlos. El objetivo no es responder los tickets más rápido. Es evitar que existan.
La mayoría de los dashboards de soporte informan de lo que pasó: volumen por canal, tiempo de respuesta, CSAT. Muy pocos dicen por qué. Y el «por qué» es donde está el dinero, porque un equipo de soporte puede ser perfectamente eficiente respondiendo una pregunta que una corrección de producto de una sola línea habría eliminado. Este artículo explica cómo encuentra la IA las causas, cómo ponerles precio con una fórmula que puede ejecutar en una hoja de cálculo y cómo entregar los hallazgos a las personas que pueden actuar. Forma parte de la colección AI for Customer Service y supone que sus tickets están razonablemente limpios (vea preparar los datos de soporte para la IA si no lo están).
Datos clave
- BERTopic, un enfoque de código abierto muy utilizado, construye los temas en tres movimientos: incrusta los documentos con un transformer preentrenado, agrupa esas incrustaciones y luego describe cada grupo con un procedimiento TF-IDF basado en clases (Grootendorst, 2022).
- Sentence-BERT redujo el tiempo para encontrar el par más similar en una colección de 10 000 oraciones de unas 65 horas con BERT simple a unos 5 segundos, lo que hizo viable el clustering basado en incrustaciones de grandes conjuntos de texto (Reimers y Gurevych, 2019).
- La asignación latente de Dirichlet (LDA), el modelo de temas clásico, trata cada documento como una mezcla de temas en lugar de asignarlo a uno solo (Blei, Ng y Jordan, JMLR, 2003). Eso encaja con los tickets que mencionan dos problemas a la vez.
- El clustering basado en densidad, como HDBSCAN, deja algunos documentos sin asignar. En BERTopic esos valores atípicos se etiquetan con -1 y no se usan para construir las descripciones de los temas (documentación de BERTopic).
- k-means necesita que se fije de antemano el número de grupos y tiende a producir grupos de tamaño parecido, mientras que el clustering aglomerativo permite fijar en su lugar un umbral de similitud (documentación de Sentence Transformers).
- Los modelos de incrustación predeterminados de BERTopic incluyen una opción multilingüe que cubre más de 50 idiomas (documentación de BERTopic).
Por qué las etiquetas y los dashboards no captan la causa
La mayoría de los equipos ya «categoriza» los tickets. El problema es cómo.
Las etiquetas elegidas por los agentes son ruidosas. Un agente bajo presión elige la opción más cercana de un menú largo. «Facturación» acaba reuniendo solicitudes de reembolso, preguntas de impuestos, pagos fallidos y confusión con el plan, que tienen cuatro soluciones distintas. Además, las etiquetas se eligen por lo que es fácil, no por lo que es exacto.
Las taxonomías fijas están congeladas. Las categorías se escribieron hace un año. Una nueva versión crea un problema nuevo y este cae en «Otros» durante seis semanas antes de que alguien lo note.
Se registran síntomas, no causas. «El cliente no puede iniciar sesión» es un síntoma. La causa puede ser un enlace de invitación vencido, una mala configuración de SSO o una regla de contraseñas confusa. Tres causas, tres responsables, una etiqueta.
La IA cambia esto porque lee las palabras reales que usaron los clientes, más las respuestas del agente, y agrupa los tickets por significado en lugar de por etiqueta. Un grupo llamado «el enlace de invitación venció antes de que el nuevo empleado lo abriera» es algo sobre lo que un product manager puede actuar. Una etiqueta llamada «Acceso a la cuenta» no.
Cómo encuentra la IA las causas raíz
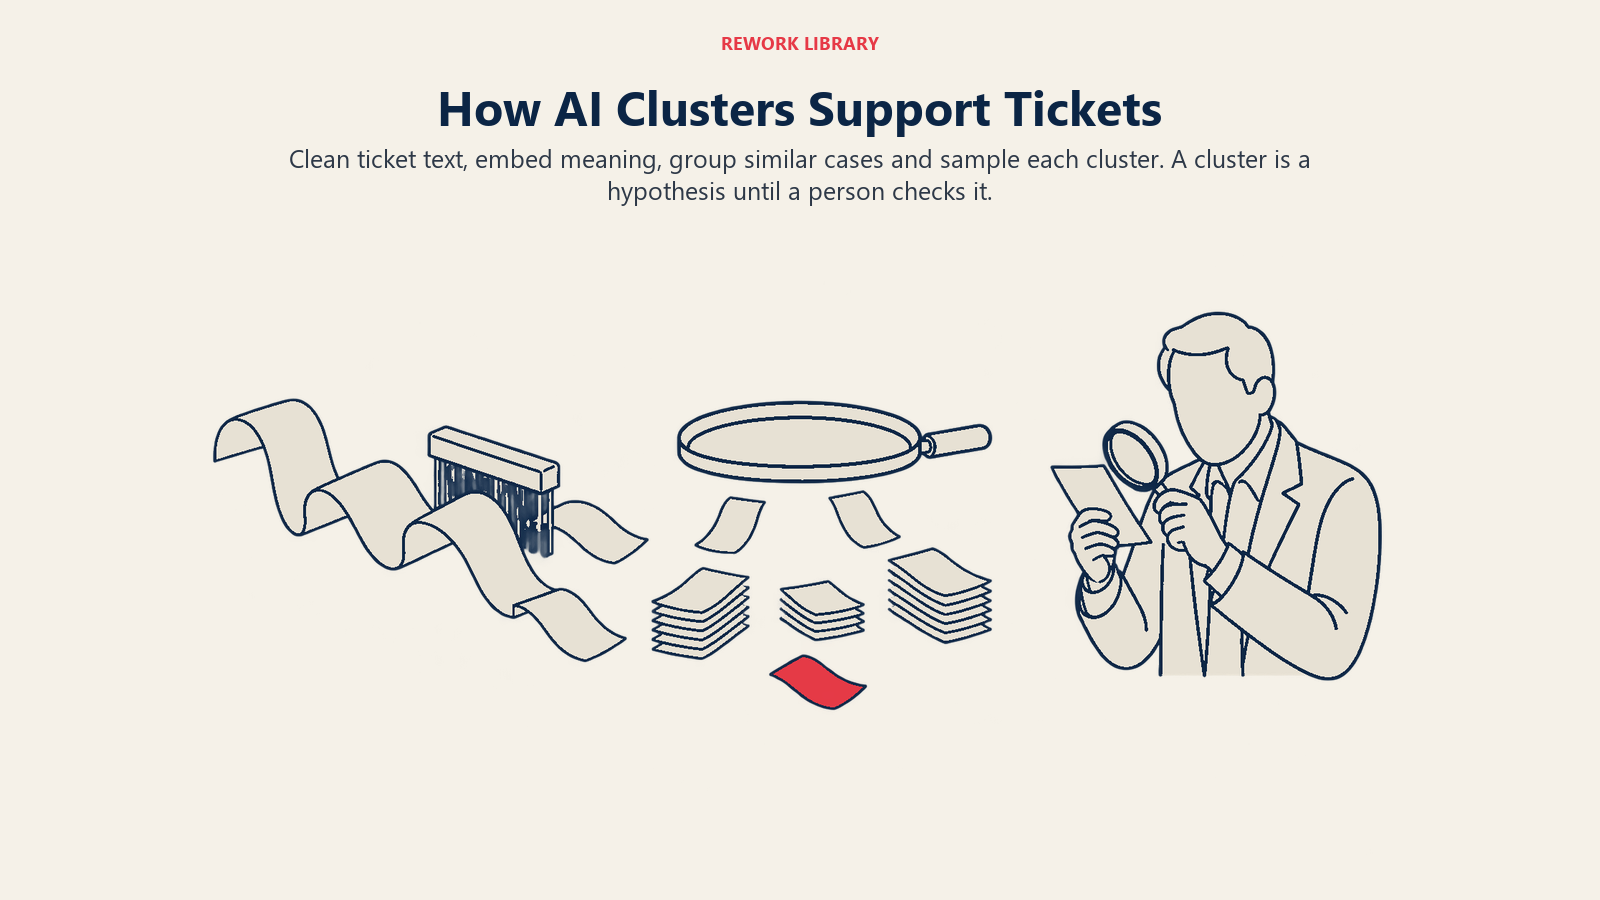
Por dentro, la mayoría de los flujos modernos siguen los mismos cuatro pasos. Entenderlos le ayuda a juzgar las afirmaciones de un proveedor o a construir usted mismo una versión pequeña.
Paso 1: prepare el texto
Extraiga el primer mensaje del cliente, la nota de resolución final del agente y cualquier resumen interno. Elimine las firmas, las cadenas de respuestas citadas y el texto repetitivo. Si sus tickets son hilos largos, un resumen del ticket suele ser mejor entrada que el hilo original, porque es corto y trata de una sola cosa.
Paso 2: convierta cada ticket en una incrustación
Una incrustación es una lista de números que representa un texto de modo que los significados parecidos queden cerca entre sí. «No puedo iniciar sesión» y «el acceso sigue fallando» terminan cerca aunque no compartan palabras. Los modelos de incrustación a nivel de oración hicieron esto lo bastante rápido para grandes volúmenes de tickets (Reimers y Gurevych, 2019). Si da soporte en varios idiomas, elija un modelo de incrustación multilingüe para que un ticket en español y uno en inglés sobre el mismo error queden juntos.
Paso 3: agrupe las incrustaciones
El clustering agrupa los tickets cercanos. El método que elija cambia lo que obtiene:
| Método | Cómo funciona | Bueno para | Cuidado con |
|---|---|---|---|
| k-means | Usted elige de antemano el número de grupos | Una primera pasada rápida cuando se sabe más o menos cuántos temas existen | Fuerza a los tickets a entrar en grupos de tamaño parecido; los tickets raros se meten en el grupo más cercano |
| Aglomerativo (umbral) | Fusiona tickets similares hasta alcanzar un umbral de similitud | Número de temas desconocido; ajustar grupos gruesos o finos | Lento con conjuntos muy grandes |
| HDBSCAN (vía BERTopic) | Encuentra regiones densas y deja el resto como valores atípicos | Datos reales de tickets, que son desordenados y desiguales | Muchos tickets pueden caer en el grupo de valores atípicos hasta que se ajusta |
| LDA | Cada ticket es una mezcla de temas basados en palabras | Tickets con varios problemas; listas de palabras transparentes | Trabaja con recuentos de palabras, así que pierde significados que las incrustaciones captan |
Los cuatro se describen en las fuentes anteriores (Sentence Transformers, BERTopic, Blei et al.). Para la mayoría de los equipos de soporte, una incrustación más un método basado en densidad es la opción práctica por defecto, porque los datos de tickets son desiguales: un puñado de temas enormes y una cola larga de otros pequeños. Un método basado en centroides como k-means supone grupos más ordenados de los que encontrará.
Paso 4: ponga nombre a cada grupo y revise una muestra
Un grupo es solo un montón de tickets hasta que tiene nombre. Hay dos formas de etiquetarlo: listar las palabras más distintivas (el paso TF-IDF basado en clases de BERTopic hace esto) o pedir a un modelo de lenguaje que lea de 10 a 20 tickets representativos y escriba una descripción de una oración. En cualquier caso, una persona debe leer una muestra de cada grupo sobre el que piense actuar. A veces los modelos pegan tickets que suenan parecidos pero tienen causas distintas, como «no puedo exportar» por un problema de permisos y «no puedo exportar» por un límite de tamaño de archivo.
Relacionado: si solo necesita clasificar lo que quiere el cliente (reembolso, cancelar, mejorar el plan) en lugar de por qué ocurrió, eso es detección de intención. La intención le dice el tipo de solicitud. La causa raíz le dice qué se rompió aguas arriba.
Manejar valores atípicos y grupos desordenados
Espere imperfecciones. Unos cuantos hábitos mantienen utilizable el resultado:
- Mire siempre el grupo de valores atípicos. Los tickets sin asignar no son basura. Los primeros indicios de un problema nuevo suelen estar ahí, porque todavía no hay suficientes tickets parecidos para formar un grupo.
- Divida los grupos grandes. Si un grupo concentra 20% de su volumen, probablemente son varias causas. Vuelva a ejecutar el clustering dentro de él.
- Fusione los casi duplicados. Dos grupos con la misma solución deben ser una sola partida.
- Vuelva a ejecutar de forma programada. Una ejecución mensual sobre los últimos 90 días capta los picos estacionales y los provocados por versiones. Una ejecución semanal sobre los últimos 14 días capta regresiones.
Poner precio a cada causa
Este es el paso que convierte un ejercicio de minería de texto en un caso de negocio. No necesita referencias de la industria de nadie más. Necesita tres cifras de su propio helpdesk y de su equipo de finanzas.
La fórmula:
Costo mensual de una causa = tickets por mes × tiempo medio de gestión (minutos) × costo total por minuto de agente
- Tickets por mes: el tamaño del grupo, escalado a su volumen total si agrupó una muestra.
- Tiempo medio de gestión: de su helpdesk, para los tickets de ese grupo, no el promedio de toda la empresa. Las causas técnicas suelen tardar mucho más que «¿dónde está mi pedido?».
- Costo total por minuto de agente: el costo total de empleo de un agente (salario, beneficios, herramientas, gastos generales de gestión) dividido entre los minutos productivos que trabaja en un mes. Pídaselo a finanzas.
Si prefiere pensar por contacto, «tiempo de gestión × costo total por minuto» es su costo por contacto para esa causa.
Un ejemplo resuelto
Las cifras siguientes son inventadas para mostrar la aritmética. Reemplácelas por las suyas. Suponga un costo total de $0,75 por minuto de agente.
| Causa (grupo) | Tickets / mes | Tiempo medio de gestión (min) | Costo mensual | Posición por volumen | Posición por costo |
|---|---|---|---|---|---|
| Confusión con el estado del pedido | 3000 | 5 | 3000 × 5 × 0,75 = $11 250 | 1 | 4 |
| El correo de restablecimiento de contraseña no llega | 2400 | 6 | 2400 × 6 × 0,75 = $10 800 | 2 | 5 |
| Línea de impuestos de la factura poco clara | 1200 | 15 | 1200 × 15 × 0,75 = $13 500 | 3 | 3 |
| La exportación falla con archivos grandes | 900 | 22 | 900 × 22 × 0,75 = $14 850 | 4 | 2 |
| Errores de sincronización de la integración | 600 | 35 | 600 × 35 × 0,75 = $15 750 | 5 | 1 |
Mire las dos últimas columnas. La causa con menos tickets es la más cara, y la más ruidosa es solo la cuarta. Un equipo que corrige por volumen empieza por el estado del pedido. Un equipo que pone precio a las causas empieza por los errores de sincronización. Ese vuelco es todo el argumento para hacer estas cuentas.
Añada los costos que la fórmula oculta
El tiempo de gestión se queda corto. Sume lo que pueda medir:
- Contactos repetidos. Si una causa genera seguimientos sobre el mismo problema, multiplique los tickets por el número medio de contactos por caso resuelto.
- Escalaciones. Los tickets que llegan a ingeniería consumen tiempo caro fuera de soporte. Sume ese tiempo a la tarifa total del ingeniero.
- Churn y reembolsos vinculados a la causa. Si los clientes de un grupo cancelan o piden créditos con más frecuencia, eso pertenece al registro. Su análisis de churn puede que ya rastree parte de ello.
Mantenga estos costos en columnas separadas. Un lector debería poder ver primero el costo puro en tiempo de agentes y luego el costo ampliado, para que nadie piense que la cifra se infló.
Estime cuánto vale una solución
Una vez que tiene un costo mensual, el valor de una solución es simple:
Ahorro mensual = costo mensual × proporción de tickets que la solución elimina
Si se espera que una corrección de los errores de sincronización elimine 70% de esos tickets, el ejemplo anterior da 0,70 × $15 750 = $11 025 al mes. Es una estimación, así que dé a sus socios de producto un rango (por ejemplo, de 40% a 80%) y actualícelo después del lanzamiento volviendo a ejecutar los grupos. Compare el ahorro con el esfuerzo de ingeniería. Así se ganan las discusiones de priorización con números en lugar de anécdotas.
Enrutar las soluciones al responsable adecuado
Encontrar una causa no la resuelve. La mayoría de los hallazgos de soporte mueren en una presentación porque nadie es responsable del siguiente paso. Incorpore el enrutamiento al proceso.
| Tipo de causa | Responsable habitual | Qué entregar | Cómo se ve «resuelto» |
|---|---|---|---|
| Error o flujo roto | Producto / ingeniería | Nombre del grupo, número de tickets, costo, 5 tickets de ejemplo, pasos para reproducirlo | El grupo se reduce tras el lanzamiento |
| Interfaz confusa o función ausente | Diseño de producto / gestión de producto | Frases textuales de los clientes, qué esperaban frente a qué ocurrió | Menos tickets, o una vía de autoservicio los reemplaza |
| Política, precios o facturación poco claros | Finanzas / revenue operations | Qué línea de la política causa la confusión, impacto en reembolsos | Política reescrita o diseño de la factura modificado |
| Fallo de proceso o de traspaso | Operaciones | Dónde se detuvo el caso, tasa de contactos repetidos | Nuevo paso, responsable o SLA establecido |
| Contenido de ayuda ausente o erróneo | Contenido de soporte / equipo de conocimiento | Términos de búsqueda, artículos fallidos, ejemplos de tickets | Artículo publicado; mejora la deflexión (vea la búsqueda en el centro de ayuda) |
| Brecha de formación del cliente | Éxito del cliente / onboarding | Qué segmento pregunta, en qué etapa del ciclo de vida | Paso de onboarding o consejo dentro de la aplicación añadido |
Unas pocas prácticas hacen que el traspaso se sostenga:
- Una página por causa. Nombre, descripción en lenguaje sencillo, tendencia del volumen, costo mensual, tickets de ejemplo (sin los datos del cliente), responsable propuesto y una solución sugerida.
- Una revisión periódica. Ponga en el calendario una reunión mensual de 30 minutos con producto, operaciones y soporte. Repase las cinco causas principales por costo, no por volumen.
- Un registro compartido. Siga cada causa desde «identificada» hasta «solución lanzada» y «reducción del volumen de tickets confirmada». Cerrar ese último ciclo es lo que genera confianza. El artículo de los tickets de soporte al backlog de producto explica cómo redactar la solicitud para que llegue a una cola de ingeniería, y enrutar los hallazgos de soporte a producto con IA muestra cómo mantener estable el flujo.
- Corrija el contenido cuando no pueda corregir el producto. Si ingeniería no puede actuar este trimestre, un mejor artículo de ayuda o un aviso proactivo igualmente reduce el volumen.
Dónde encaja con el análisis de causa raíz clásico
El clustering con IA responde a «¿cuáles son las causas y qué tamaño tiene cada una?». No responde a «¿por qué existe esa causa?». Esa segunda pregunta es donde entran los métodos tradicionales, como los cinco porqués y los diagramas de causa y efecto. La guía de análisis de causa raíz cubre esas técnicas. Un reparto viable: la IA encuentra y dimensiona la causa a nivel de ticket y luego un pequeño grupo multifuncional hace el análisis de causa raíz humano de las dos o tres principales.
Implementarlo, paso a paso
- Elija un alcance. Una línea de producto, un canal, los últimos 90 días. No empiece a nivel de toda la empresa.
- Exporte y limpie. Texto del ticket, nota de resolución, tiempo de gestión, canal, área de producto, indicador de escalación. Elimine los datos personales que no necesite.
- Ejecute un primer clustering con un modelo de incrustación y un método basado en densidad. Espere un resultado desordenado.
- Lea muestras de cada uno de los 20 grupos principales. Renombre, divida y fusione hasta que los agentes digan «sí, eso es algo real».
- Ponga precio a cada grupo con la fórmula, usando los tiempos de gestión específicos de cada grupo.
- Ordene por costo y añada las columnas de contactos repetidos y escalaciones.
- Asigne responsables y entregue informes de una página para los cinco primeros.
- Vuelva a ejecutar cada mes y siga el volumen de cada grupo frente a la fecha en que se lanzó su solución.
- Devuelva los resultados a la planificación. Separar los picos provocados por versiones de la demanda estable hace que sus pronósticos de volumen sean más fáciles de creer.
Errores comunes
Tratar los grupos como la verdad. Un grupo es una hipótesis. Lea los tickets antes de hablar de él con ingeniería.
Ordenar por volumen. Como muestra el ejemplo resuelto, la causa más barata por ticket suele ser la que tiene más tickets. Ordene por costo.
Usar un único tiempo de gestión para todo. Un promedio de toda la empresa oculta los tickets largos y costosos. Use el tiempo de gestión por grupo.
Contar ahorros que no puede confirmar. Informe los ahorros estimados como un rango y luego mida la caída real tras la solución.
Saltarse los valores atípicos. Los problemas nuevos empiezan siendo pequeños. Si nadie mira el grupo sin asignar, se entera tarde.
Un análisis único. Las causas cambian con cada versión, así que un informe aislado queda obsoleto rápido.
Culpar a los agentes por un volumen causado por el producto. Si una causa genera un tercio de los tickets largos, el coaching no lo resolverá. El producto sí.
Compartir tickets en bruto sin cuidado. Elimine nombres, correos y datos de cuenta antes de que los tickets salgan de soporte.
Preguntas frecuentes sobre el análisis de causa raíz con IA para soporte
¿Qué es el análisis de causa raíz con IA para el soporte al cliente?
Es el uso de modelos de lenguaje para agrupar los tickets de soporte según el motivo de fondo por el que los clientes lo contactaron, medir cuánto cuesta cada motivo y enrutar los más grandes al equipo que puede resolverlos. Se centra en eliminar la causa de los tickets, no solo en responderlos más rápido.
¿Cómo agrupa la IA los tickets de soporte?
La mayoría de los enfoques convierte cada ticket en una incrustación, un conjunto de números que capta su significado, y luego agrupa los tickets cuyas incrustaciones están cerca. BERTopic es un ejemplo común de código abierto: incrusta los documentos, los agrupa y describe cada grupo con un método TF-IDF basado en clases. Los enfoques más antiguos, como LDA, trabajan con patrones de palabras en lugar de con el significado.
¿Cómo calculo el costo de la causa de un ticket?
Multiplique el número de tickets del grupo por mes por el tiempo medio de gestión de ese grupo en minutos y luego por su costo total por minuto de agente. Por ejemplo, 600 tickets a 35 minutos y $0,75 el minuto son $15 750 al mes. Añada los contactos repetidos, las escalaciones y el churn relacionado como líneas separadas.
¿Por qué ordenar las causas por costo en lugar de por número de tickets?
El número de tickets favorece las preguntas simples y frecuentes que tardan unos pocos minutos cada una. El costo tiene en cuenta el tiempo de gestión, de modo que un grupo pequeño de tickets técnicos y largos puede superar a un grupo grande de tickets rápidos. Ordenar por costo dirige el escaso tiempo de ingeniería adonde más ahorra.
¿Puede la IA encontrar causas raíz sin ninguna revisión manual?
No. El clustering puede fusionar tickets que suenan parecidos pero tienen causas distintas, y los métodos basados en densidad dejan algunos tickets sin asignar. Pida a una persona que lea una muestra de cada grupo antes de que pase a producto u operaciones, y revise los tickets sin asignar en busca de problemas emergentes.
¿Con qué frecuencia deberíamos ejecutar el análisis?
Haga una pasada amplia cada mes sobre los últimos 90 días y una pasada semanal más ligera sobre los últimos 14 días para detectar regresiones tras los lanzamientos. Vuelva a ejecutar un grupo después de que se lance su solución para confirmar que el volumen realmente bajó.
¿Quién debería ser responsable de las soluciones?
El equipo que controla la causa: producto e ingeniería para errores y flujos confusos, finanzas para facturación y políticas, operaciones para fallos de proceso y el equipo de conocimiento para contenido de ayuda ausente. Soporte es responsable del análisis y del seguimiento, no de todas las soluciones.

Customer Success Operations Manager
On this page
- Datos clave
- Por qué las etiquetas y los dashboards no captan la causa
- Cómo encuentra la IA las causas raíz
- Paso 1: prepare el texto
- Paso 2: convierta cada ticket en una incrustación
- Paso 3: agrupe las incrustaciones
- Paso 4: ponga nombre a cada grupo y revise una muestra
- Manejar valores atípicos y grupos desordenados
- Poner precio a cada causa
- Un ejemplo resuelto
- Añada los costos que la fórmula oculta
- Estime cuánto vale una solución
- Enrutar las soluciones al responsable adecuado
- Dónde encaja con el análisis de causa raíz clásico
- Implementarlo, paso a paso
- Errores comunes