AI Ursachenanalyse für den Support: Herausfinden, warum Tickets entstehen
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI Ursachenanalyse für den Support bedeutet, mit Sprachmodellen Tausende Tickets nach dem eigentlichen Grund zu gruppieren, aus dem Kunden sich gemeldet haben, jeden Grund mit Kosten zu beziffern und die größten an das Produkt- oder Operations-Team weiterzuleiten, das sie beseitigen kann. Das Ziel ist nicht, Tickets schneller zu beantworten. Es ist, sie gar nicht erst entstehen zu lassen.
Die meisten Support-Dashboards berichten, was passiert ist: Volumen pro Kanal, Antwortzeit, CSAT. Nur sehr wenige sagen, warum. Und im „Warum“ steckt das Geld, denn ein Support-Team kann äußerst effizient eine Frage beantworten, die eine einzeilige Produktkorrektur beseitigt hätte. Dieser Beitrag zeigt, wie AI Ursachen findet, wie Sie sie mit einer Formel beziffern, die Sie in einer Tabellenkalkulation rechnen können, und wie Sie die Ergebnisse an Menschen übergeben, die handeln können. Er gehört zur Collection AI for Customer Service und setzt voraus, dass Ihre Tickets einigermaßen sauber sind (siehe Support-Daten für AI vorbereiten, falls nicht).
Wichtige Fakten
- BERTopic, ein weit verbreiteter Open-Source-Ansatz, bildet Themen in drei Schritten: Er bettet Dokumente mit einem vortrainierten Transformer ein, clustert diese Einbettungen und beschreibt dann jedes Cluster mit einem klassenbasierten TF-IDF-Verfahren (Grootendorst, 2022).
- Sentence-BERT verkürzte die Zeit, das ähnlichste Paar in einer Sammlung von 10.000 Sätzen zu finden, von etwa 65 Stunden mit gewöhnlichem BERT auf etwa 5 Sekunden, und machte damit das Clustering großer Textmengen auf Basis von Einbettungen praktikabel (Reimers und Gurevych, 2019).
- Latent Dirichlet Allocation (LDA), das klassische Themenmodell, behandelt jedes Dokument als Mischung von Themen, statt es genau einem zuzuordnen (Blei, Ng und Jordan, JMLR, 2003). Das passt zu Tickets, die zwei Probleme zugleich ansprechen.
- Dichtebasiertes Clustering wie HDBSCAN lässt einige Dokumente unzugeordnet. In BERTopic werden diese Ausreißer mit -1 gekennzeichnet und nicht zur Bildung der Themenbeschreibungen verwendet (BERTopic documentation).
- k-means braucht die vorab festgelegte Zahl der Cluster und neigt zu Gruppen etwa gleicher Größe, während agglomeratives Clustering stattdessen einen Ähnlichkeitsschwellenwert erlaubt (Sentence Transformers documentation).
- Zu den Standard-Einbettungsmodellen von BERTopic gehört eine mehrsprachige Option für mehr als 50 Sprachen (BERTopic documentation).
Warum Tags und Dashboards die Ursache verfehlen
Die meisten Teams „kategorisieren“ Tickets bereits. Das Problem ist das Wie.
Von Mitarbeitenden gewählte Tags sind verrauscht. Eine Mitarbeitende unter Druck wählt aus einem langen Dropdown die nächstliegende Option. Unter „Abrechnung“ landen dann Rückerstattungsanfragen, Steuerfragen, fehlgeschlagene Zahlungen und Verwirrung um den Tarif, für die es vier verschiedene Lösungen gibt. Tags werden außerdem danach gewählt, was einfach ist, nicht danach, was zutrifft.
Feste Taxonomien sind eingefroren. Die Kategorien wurden vor einem Jahr geschrieben. Ein neues Release erzeugt ein neues Problem, und es landet sechs Wochen unter „Sonstiges“, bevor es jemand bemerkt.
Es werden Symptome erfasst, keine Ursachen. „Kunde kann sich nicht anmelden“ ist ein Symptom. Die Ursache kann ein abgelaufener Einladungslink sein, eine falsch konfigurierte SSO oder eine verwirrende Passwortregel. Drei Ursachen, drei Verantwortliche, ein Tag.
AI verändert das, weil sie die tatsächlichen Worte der Kunden liest, dazu die Antworten der Mitarbeitenden, und Tickets nach Bedeutung statt nach Etikett gruppiert. Ein Cluster namens „Einladungslink abgelaufen, bevor die neue Mitarbeiterin ihn öffnete“ ist etwas, womit ein Product Manager arbeiten kann. Ein Tag namens „Kontozugriff“ ist es nicht.
So findet AI Grundursachen
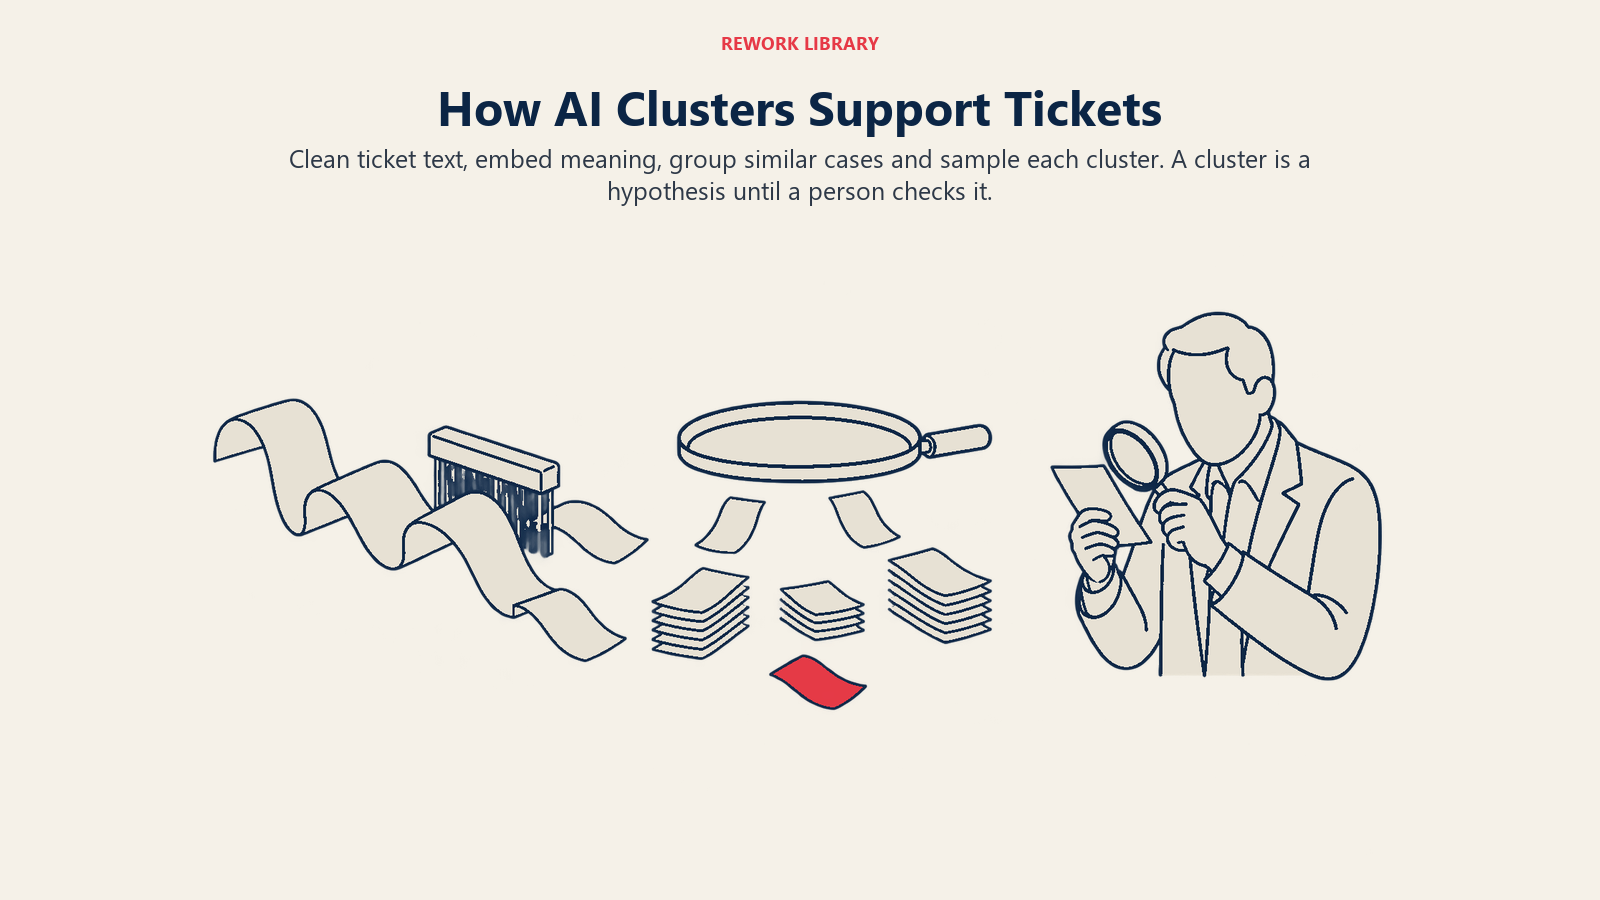
Im Kern folgen die meisten modernen Pipelines denselben vier Schritten. Wer sie versteht, kann die Aussagen eines Anbieters besser beurteilen oder selbst eine kleine Version bauen.
Schritt 1: Den Text vorbereiten
Ziehen Sie die erste Nachricht des Kunden, den abschließenden Lösungsvermerk der Mitarbeitenden und jede interne Zusammenfassung heran. Entfernen Sie Signaturen, zitierte Antwortketten und Standardtexte. Wenn Ihre Tickets lange Verläufe sind, ist eine Ticket-Zusammenfassung oft die bessere Eingabe als der rohe Verlauf, weil sie kurz ist und von einer einzigen Sache handelt.
Schritt 2: Jedes Ticket in eine Einbettung verwandeln
Eine Einbettung ist eine Liste von Zahlen, die ein Stück Text so darstellt, dass ähnliche Bedeutungen nah beieinanderliegen. „Ich kann mich nicht anmelden“ und „Der Login schlägt ständig fehl“ liegen nah beieinander, obwohl sie kein Wort teilen. Einbettungsmodelle auf Satzebene haben das für große Ticketvolumen schnell genug gemacht (Reimers und Gurevych, 2019). Wenn Sie mehrere Sprachen unterstützen, wählen Sie ein mehrsprachiges Einbettungsmodell, damit ein spanisches und ein englisches Ticket zum selben Fehler zusammenfinden.
Schritt 3: Die Einbettungen clustern
Das Clustering gruppiert die benachbarten Tickets. Die gewählte Methode verändert, was Sie bekommen:
| Methode | So funktioniert sie | Gut für | Worauf zu achten ist |
|---|---|---|---|
| k-means | Sie wählen die Zahl der Cluster vorab | Schneller erster Durchgang, wenn Sie ungefähr wissen, wie viele Themen es gibt | Zwingt Tickets in etwa gleich große Gruppen; ungewöhnliche Tickets werden ins nächstgelegene gestopft |
| Agglomerativ (Schwellenwert) | Verschmilzt ähnliche Tickets, bis ein Ähnlichkeitsschwellenwert erreicht ist | Unbekannte Zahl von Themen; grobe oder feine Gruppen abstimmen | Langsam bei sehr großen Mengen |
| HDBSCAN (über BERTopic) | Findet dichte Bereiche, lässt den Rest als Ausreißer | Echte Ticketdaten, die unordentlich und ungleichmäßig sind | Viele Tickets können im Ausreißer-Bucket landen, bis Sie nachjustieren |
| LDA | Jedes Ticket ist eine Mischung wortbasierter Themen | Tickets mit mehreren Anliegen; transparente Wortlisten | Arbeitet mit Wortzählungen und verpasst daher Bedeutung, die Einbettungen erfassen |
Alle vier sind in den oben genannten Quellen beschrieben (Sentence Transformers, BERTopic, Blei et al.). Für die meisten Support-Teams ist eine Einbettung plus ein dichtebasiertes Verfahren die praktische Voreinstellung, weil Ticketdaten ungleichmäßig sind: eine Handvoll riesiger Themen und ein Long Tail (seltene Anliegen) kleiner Themen. Ein zentroidbasiertes Verfahren wie k-means setzt ordentlichere Gruppen voraus, als Sie vorfinden werden.
Schritt 4: Jedes Cluster benennen und stichprobenartig prüfen
Ein Cluster ist nur ein Haufen Tickets, bis es einen Namen hat. Es gibt zwei Wege, es zu benennen: die markantesten Wörter auflisten (das leistet der klassenbasierte TF-IDF-Schritt in BERTopic) oder ein Sprachmodell 10 bis 20 repräsentative Tickets lesen und eine einzeilige Beschreibung schreiben lassen. In beiden Fällen gilt: Ein Mensch sollte eine Stichprobe jedes Clusters lesen, auf das Sie reagieren wollen. Modelle verkleben manchmal Tickets, die ähnlich klingen, aber unterschiedliche Ursachen haben, etwa „Export nicht möglich“ bei einem Berechtigungsproblem und „Export nicht möglich“ bei einer Dateigrößenbegrenzung.
Verwandt damit: Wenn Sie nur sortieren müssen, was der Kunde will (Rückerstattung, Kündigung, Upgrade) statt warum es passiert ist, ist das Intent-Erkennung. Der Intent sagt Ihnen die Art der Anfrage. Die Grundursache sagt Ihnen, was vorgelagert kaputtgegangen ist.
Mit Ausreißern und unsauberen Clustern umgehen
Rechnen Sie mit Unvollkommenheit. Ein paar Gewohnheiten halten das Ergebnis brauchbar:
- Den Ausreißer-Bucket jedes Mal ansehen. Unzugeordnete Tickets sind kein Müll. Frühe Anzeichen eines neuen Problems sitzen oft dort, weil es noch nicht genug ähnliche Tickets für ein Cluster gibt.
- Große Cluster aufteilen. Wenn ein Cluster 20% Ihres Volumens enthält, sind es vermutlich mehrere Ursachen. Führen Sie das Clustering darin erneut aus.
- Beinahe-Duplikate zusammenführen. Zwei Cluster mit derselben Lösung sollten ein einziger Posten sein.
- Nach Zeitplan neu laufen lassen. Ein monatlicher Lauf über die letzten 90 Tage erfasst saisonale und releasegetriebene Spitzen. Ein wöchentlicher Lauf über die letzten 14 Tage erfasst Rückschritte.
Jeder Ursache einen Preis geben
Dieser Schritt macht aus einer Textanalyse eine Business-Case-Rechnung. Sie brauchen keine Benchmarks aus der Branche anderer. Sie brauchen drei Zahlen aus Ihrem eigenen Helpdesk und von Ihrem Finanzteam.
Die Formel:
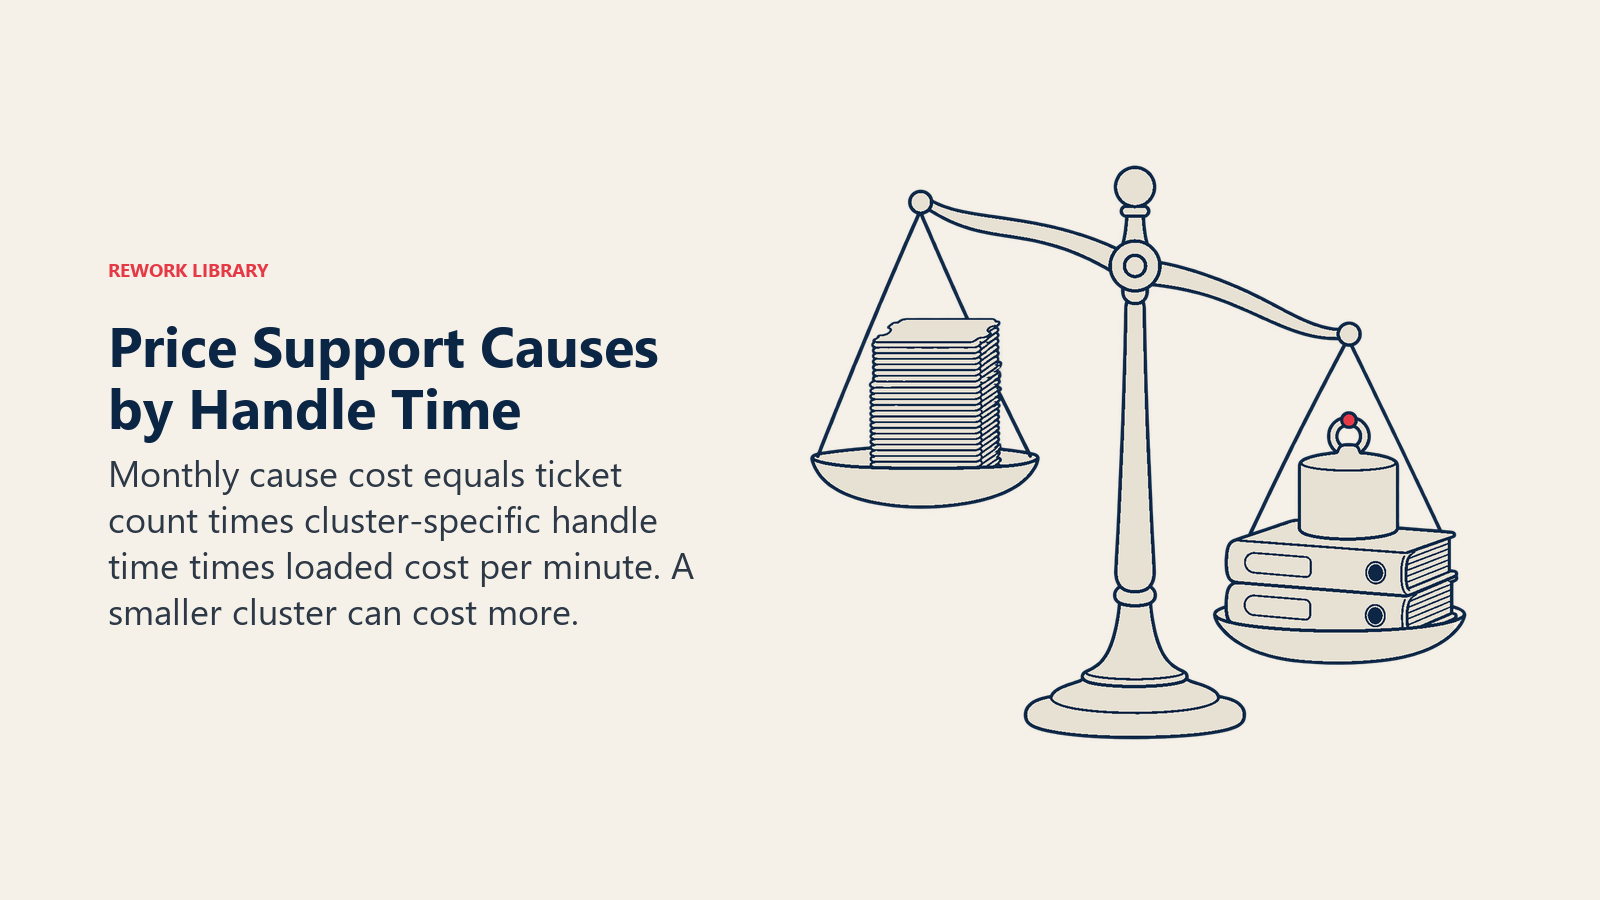
Monatliche Kosten einer Ursache = Tickets pro Monat × durchschnittliche Bearbeitungszeit (Minuten) × Vollkosten pro Mitarbeitenden-Minute
- Tickets pro Monat: die Clustergröße, hochgerechnet auf Ihr gesamtes Volumen, wenn Sie eine Stichprobe geclustert haben.
- Durchschnittliche Bearbeitungszeit: aus Ihrem Helpdesk, für die Tickets in diesem Cluster, nicht der unternehmensweite Durchschnitt. Technische Ursachen dauern meist deutlich länger als „Wo ist meine Bestellung?“.
- Vollkosten pro Mitarbeitenden-Minute: die gesamten Beschäftigungskosten einer Mitarbeitenden (Gehalt, Nebenleistungen, Tools, Führungsaufwand), geteilt durch die produktiven Minuten, die sie in einem Monat arbeitet. Fragen Sie das Finanzteam danach.
Wenn Sie lieber pro Kontakt denken: „Bearbeitungszeit × Vollkosten pro Minute“ ist Ihr Kontaktpreis für diese Ursache.
Ein durchgerechnetes Beispiel
Die folgenden Zahlen sind erfunden, um die Rechnung zu zeigen. Ersetzen Sie sie durch Ihre eigenen. Angenommen werden Vollkosten von $0,75 pro Mitarbeitenden-Minute.
| Ursache (Cluster) | Tickets / Monat | Durchschn. Bearbeitungszeit (Min.) | Monatliche Kosten | Rang nach Volumen | Rang nach Kosten |
|---|---|---|---|---|---|
| Verwirrung beim Bestellstatus | 3.000 | 5 | 3.000 × 5 × 0,75 = $11.250 | 1 | 4 |
| E-Mail zum Zurücksetzen des Passworts kommt nicht an | 2.400 | 6 | 2.400 × 6 × 0,75 = $10.800 | 2 | 5 |
| Steuerzeile auf der Rechnung unklar | 1.200 | 15 | 1.200 × 15 × 0,75 = $13.500 | 3 | 3 |
| Export scheitert bei großen Dateien | 900 | 22 | 900 × 22 × 0,75 = $14.850 | 4 | 2 |
| Synchronisierungsfehler bei Integrationen | 600 | 35 | 600 × 35 × 0,75 = $15.750 | 5 | 1 |
Sehen Sie sich die letzten beiden Spalten an. Die Ursache mit den wenigsten Tickets ist die teuerste, und die lauteste liegt nur auf Platz vier. Ein Team, das nach Volumen korrigiert, geht zuerst den Bestellstatus an. Ein Team, das Ursachen bepreist, geht zuerst die Synchronisierungsfehler an. Diese Umkehrung ist das ganze Argument für diese Rechnung.
Die Kosten ergänzen, die die Formel verbirgt
Die Bearbeitungszeit zählt zu wenig. Ergänzen Sie, was Sie messen können:
- Wiederholte Kontakte. Wenn eine Ursache Folgekontakte zum selben Anliegen erzeugt, multiplizieren Sie die Tickets mit der durchschnittlichen Zahl der Kontakte pro gelöstem Fall.
- Eskalationen. Tickets, die das Engineering erreichen, verbrauchen teure Zeit außerhalb des Supports. Rechnen Sie diese Zeit mit dem Vollkostensatz des Engineers hinzu.
- Abwanderung und Rückerstattungen im Zusammenhang mit der Ursache. Wenn Kunden in einem Cluster häufiger kündigen oder Gutschriften verlangen, gehört das in die Rechnung. Ihre Churn-Analyse verfolgt vielleicht einen Teil davon bereits.
Halten Sie diese als getrennte Spalten. Ein Leser sollte zuerst die reinen Kosten der Bearbeitungszeit sehen können, dann die weiteren Kosten, damit niemand denkt, die Zahl sei aufgebläht worden.
Abschätzen, was eine Korrektur wert ist
Sobald Sie monatliche Kosten haben, ist der Wert einer Korrektur einfach:
Monatliche Einsparung = monatliche Kosten × Anteil der Tickets, den die Korrektur beseitigt
Wenn eine Korrektur der Synchronisierungsfehler voraussichtlich 70% dieser Tickets beseitigt, ergibt das Beispiel oben 0,70 × $15.750 = $11.025 im Monat. Das ist eine Schätzung, geben Sie Ihren Produktpartnern also eine Spanne an (etwa 40% bis 80%) und aktualisieren Sie sie nach dem Release, indem Sie die Cluster erneut laufen lassen. Vergleichen Sie die Einsparung mit dem Engineering-Aufwand. So gewinnen Sie Priorisierungsdiskussionen mit Zahlen statt mit Anekdoten.
Korrekturen an den richtigen Verantwortlichen leiten
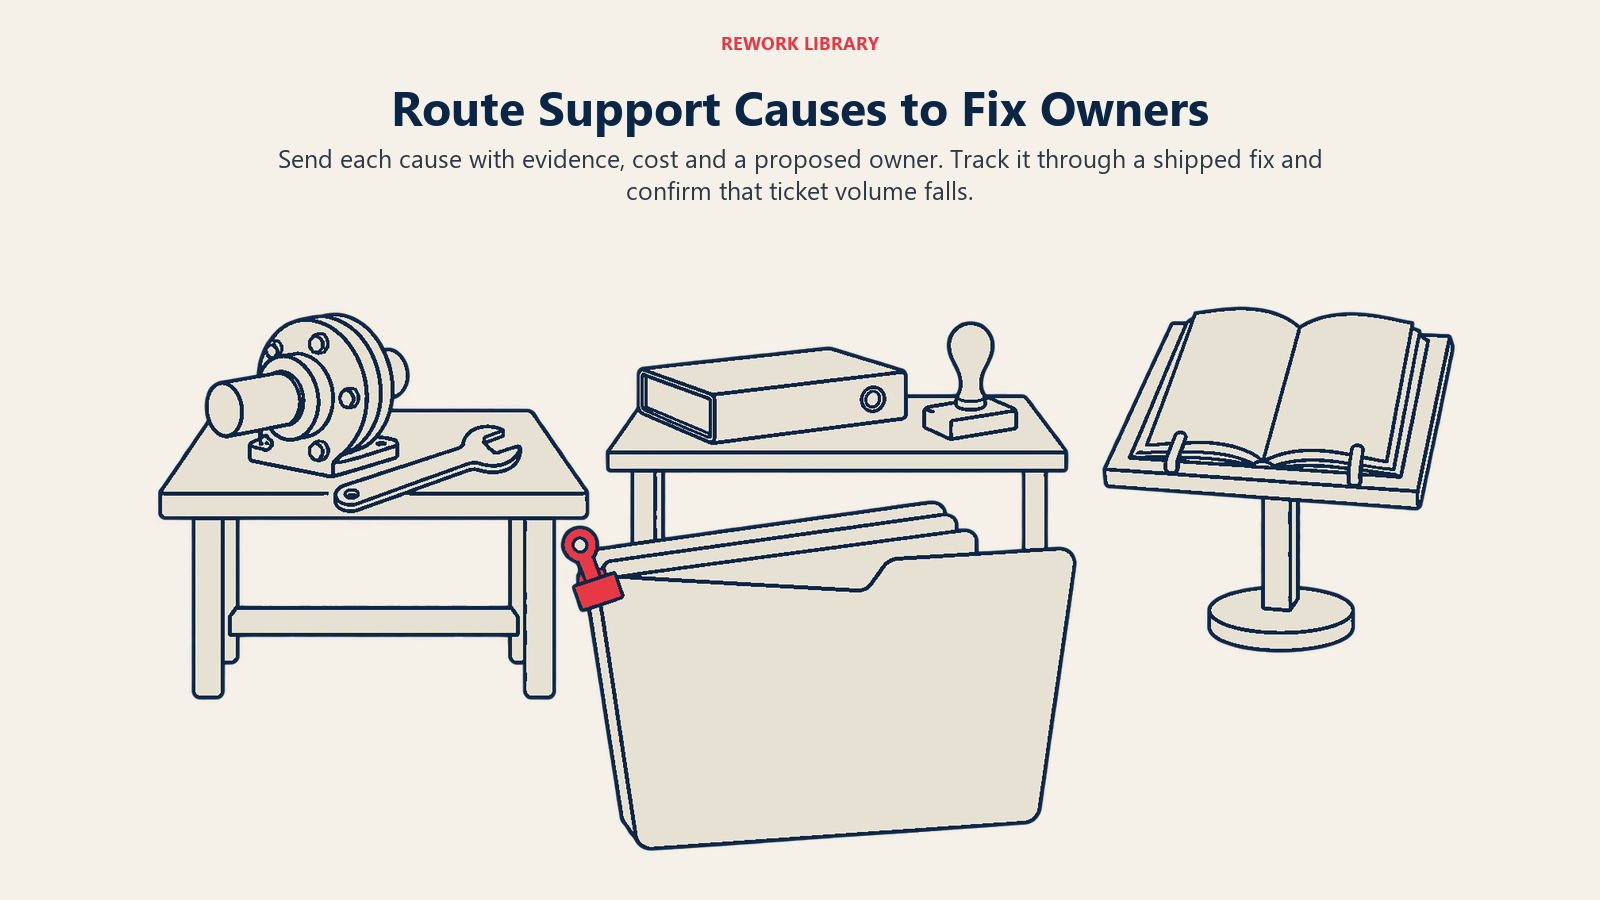
Eine Ursache zu finden, behebt sie nicht. Die meisten Support-Erkenntnisse sterben in einer Präsentation, weil niemand den nächsten Schritt verantwortet. Bauen Sie das Routing in den Prozess ein.
| Art der Ursache | Typischer Verantwortlicher | Was zu übergeben ist | Woran man „behoben“ erkennt |
|---|---|---|---|
| Fehler oder defekter Ablauf | Produkt / Engineering | Clustername, Ticketzahl, Kosten, 5 Beispieltickets, Schritte zur Reproduktion | Das Cluster schrumpft nach dem Release |
| Verwirrende Oberfläche oder fehlende Funktion | Produktdesign / Produktmanagement | Wörtliche Kundenformulierungen, was sie erwartet haben im Vergleich zu dem, was geschah | Weniger Tickets, oder ein Self-Service-Weg ersetzt sie |
| Unklare Richtlinie, Preisgestaltung oder Abrechnung | Finanzen / Revenue Operations | Welche Zeile der Richtlinie die Verwirrung verursacht, Auswirkung auf Rückerstattungen | Richtlinie umgeschrieben oder Rechnungslayout geändert |
| Prozess- oder Übergabefehler | Operations | Wo der Fall stockte, Quote wiederholter Kontakte | Neuer Schritt, Verantwortlicher oder SLA eingeführt |
| Fehlende oder falsche Hilfeinhalte | Support-Content- / Wissensteam | Suchbegriffe, gescheiterte Artikel, Tickets als Beispiele | Artikel veröffentlicht; Deflection (Anfragenvermeidung) verbessert sich (siehe Hilfecenter-Suche) |
| Lücke in der Kundenschulung | Customer Success / Onboarding | Welches Segment fragt, in welcher Phase des Lebenszyklus | Onboarding-Schritt oder In-App-Tipp ergänzt |
Ein paar Praktiken sorgen dafür, dass die Übergabe hält:
- Eine Seite pro Ursache. Name, Beschreibung in einfacher Sprache, Volumentrend, monatliche Kosten, Beispieltickets (ohne Kundendaten), vorgeschlagener Verantwortlicher und ein Lösungsvorschlag.
- Ein festes Review. Legen Sie einen 30-minütigen monatlichen Termin mit Produkt, Operations und Support in den Kalender. Gehen Sie die fünf wichtigsten Ursachen nach Kosten durch, nicht nach Volumen.
- Ein gemeinsames Verzeichnis. Verfolgen Sie jede Ursache von „erkannt“ über „Korrektur ausgeliefert“ bis „Ticketvolumen bestätigt gesunken“. Diese letzte Schleife zu schließen, schafft Vertrauen. Der Beitrag Support-Tickets ins Produkt-Backlog beschreibt, wie Sie die Anfrage so schreiben, dass sie in einer Engineering-Queue landet, und Support-Erkenntnisse mit AI ans Produkt weiterleiten zeigt, wie Sie den Fluss stabil halten.
- Den Inhalt korrigieren, wenn Sie das Produkt nicht korrigieren können. Wenn das Engineering in diesem Quartal nicht handeln kann, senkt ein besserer Hilfeartikel oder ein proaktiver Hinweis das Volumen dennoch.
Wie das zur klassischen Ursachenanalyse passt
AI-Clustering beantwortet „Was sind die Ursachen, und wie groß ist jede?“. Es beantwortet nicht „Warum gibt es diese Ursache?“. Bei dieser zweiten Frage kommen traditionelle Methoden wie die Fünf-Warum-Technik und Ursache-Wirkungs-Diagramme ins Spiel. Der Leitfaden zur Ursachenanalyse behandelt diese Techniken. Eine praktikable Aufteilung: AI findet und beziffert die Ursache auf Ticketebene, danach führt eine kleine funktionsübergreifende Gruppe die menschliche Ursachenanalyse für die ersten zwei oder drei durch.
Schritt für Schritt einführen
- Einen Umfang wählen. Eine Produktlinie, ein Kanal, die letzten 90 Tage. Fangen Sie nicht unternehmensweit an.
- Exportieren und bereinigen. Tickettext, Lösungsvermerk, Bearbeitungszeit, Kanal, Produktbereich, Eskalationskennzeichen. Entfernen Sie personenbezogene Daten, die Sie nicht brauchen.
- Ein erstes Clustering ausführen mit einem Einbettungsmodell und einem dichtebasierten Verfahren. Rechnen Sie mit unordentlichem Ergebnis.
- Stichproben lesen aus jedem der 20 größten Cluster. Benennen Sie um, teilen Sie auf und führen Sie zusammen, bis die Mitarbeitenden sagen: „Ja, das ist eine reale Sache.“
- Jedes Cluster bepreisen mit der Formel, unter Verwendung clusterspezifischer Bearbeitungszeiten.
- Nach Kosten ranken und die Spalten für wiederholte Kontakte und Eskalationen ergänzen.
- Verantwortliche zuweisen und Einseiter für die fünf wichtigsten übergeben.
- Monatlich neu laufen lassen und das Volumen jedes Clusters mit dem Datum vergleichen, an dem seine Korrektur ausgeliefert wurde.
- Die Ergebnisse in die Planung zurückspielen. Wer releasegetriebene Spitzen vom stetigen Grundbedarf trennt, macht seine Volumenprognosen vertrauenswürdiger.
Häufige Fallstricke
Cluster als Wahrheit behandeln. Ein Cluster ist eine Hypothese. Lesen Sie die Tickets, bevor Sie dem Engineering davon erzählen.
Nach Volumen ranken. Wie das durchgerechnete Beispiel zeigt, hat die Ursache mit den geringsten Kosten pro Ticket oft die meisten Tickets. Ranken Sie nach Kosten.
Eine einzige Bearbeitungszeit für alles verwenden. Ein unternehmensweiter Durchschnitt verbirgt die langen, teuren Tickets. Nutzen Sie die Bearbeitungszeit pro Cluster.
Einsparungen zählen, die Sie nicht bestätigen können. Melden Sie geschätzte Einsparungen als Spanne und messen Sie dann den tatsächlichen Rückgang nach der Korrektur.
Die Ausreißer überspringen. Neue Probleme fangen klein an. Wenn niemand den unzugeordneten Bucket ansieht, erfahren Sie spät von ihnen.
Einmalige Analyse. Ursachen verschieben sich mit jedem Release, ein einzelner Bericht veraltet daher schnell.
Mitarbeitende für ursachenbedingtes Volumen verantwortlich machen. Wenn eine Ursache ein Drittel der langen Tickets erzeugt, löst Coaching das nicht. Das Produkt löst es.
Rohe Tickets unachtsam weitergeben. Entfernen Sie Namen, E-Mail-Adressen und Kontodaten, bevor Tickets den Support verlassen.
Häufig gestellte Fragen zu AI Ursachenanalyse für den Support
Was ist AI Ursachenanalyse für den Kundensupport?
Es ist der Einsatz von Sprachmodellen, um Support-Tickets nach dem eigentlichen Grund zu gruppieren, aus dem Kunden sich gemeldet haben, dann zu messen, was jeder Grund kostet, und die größten an das Team weiterzuleiten, das sie beheben kann. Der Fokus liegt darauf, die Ursache von Tickets zu beseitigen, nicht nur darauf, sie schneller zu beantworten.
Wie clustert AI Support-Tickets?
Die meisten Ansätze verwandeln jedes Ticket in eine Einbettung, eine Zahlenfolge, die seine Bedeutung erfasst, und gruppieren dann Tickets, deren Einbettungen nah beieinanderliegen. BERTopic ist ein verbreitetes Open-Source-Beispiel: Es bettet Dokumente ein, clustert sie und beschreibt jedes Cluster mit einem klassenbasierten TF-IDF-Verfahren. Ältere Ansätze wie LDA arbeiten statt mit Bedeutung mit Wortmustern.
Wie berechne ich die Kosten einer Ticketursache?
Multiplizieren Sie die Zahl der Tickets im Cluster pro Monat mit der durchschnittlichen Bearbeitungszeit für dieses Cluster in Minuten und dann mit Ihren Vollkosten pro Mitarbeitenden-Minute. Zum Beispiel sind 600 Tickets mit 35 Minuten und $0,75 pro Minute $15.750 im Monat. Ergänzen Sie wiederholte Kontakte, Eskalationen und damit verbundene Abwanderung als getrennte Zeilen.
Warum Ursachen nach Kosten statt nach Ticketzahl ranken?
Die Ticketzahl bevorzugt einfache, häufige Fragen, die jeweils wenige Minuten dauern. Die Kosten berücksichtigen die Bearbeitungszeit, sodass ein kleineres Cluster aus langen, technischen Tickets ein großes Cluster aus schnellen übertreffen kann. Das Ranking nach Kosten lenkt knappe Engineering-Zeit dorthin, wo sie am meisten einspart.
Kann AI Grundursachen ganz ohne manuelle Prüfung finden?
Nein. Clustering kann Tickets verschmelzen, die ähnlich klingen, aber unterschiedliche Ursachen haben, und dichtebasierte Verfahren lassen einige Tickets unzugeordnet. Lassen Sie einen Menschen eine Stichprobe aus jedem Cluster lesen, bevor es an Produkt oder Operations geht, und prüfen Sie die unzugeordneten Tickets auf entstehende Probleme.
Wie oft sollten wir die Analyse durchführen?
Führen Sie monatlich einen breiten Durchgang über die letzten 90 Tage durch und wöchentlich einen leichteren über die letzten 14 Tage, um Rückschritte nach Releases zu erfassen. Lassen Sie ein Cluster erneut laufen, nachdem seine Korrektur ausgeliefert wurde, um zu bestätigen, dass das Volumen wirklich gesunken ist.
Wer sollte die Korrekturen verantworten?
Das Team, das die Ursache kontrolliert: Produkt und Engineering für Fehler und verwirrende Abläufe, Finanzen für Abrechnung und Richtlinien, Operations für Prozessfehler und das Wissensteam für fehlende Hilfeinhalte. Der Support verantwortet die Analyse und das Nachverfolgen, nicht jede Korrektur.

Customer Success Operations Manager
On this page
- Wichtige Fakten
- Warum Tags und Dashboards die Ursache verfehlen
- So findet AI Grundursachen
- Schritt 1: Den Text vorbereiten
- Schritt 2: Jedes Ticket in eine Einbettung verwandeln
- Schritt 3: Die Einbettungen clustern
- Schritt 4: Jedes Cluster benennen und stichprobenartig prüfen
- Mit Ausreißern und unsauberen Clustern umgehen
- Jeder Ursache einen Preis geben
- Ein durchgerechnetes Beispiel
- Die Kosten ergänzen, die die Formel verbirgt
- Abschätzen, was eine Korrektur wert ist
- Korrekturen an den richtigen Verantwortlichen leiten
- Wie das zur klassischen Ursachenanalyse passt
- Schritt für Schritt einführen
- Häufige Fallstricke