サポートのためのAI根本原因分析:チケットが発生する理由を突き止める
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
サポートのAI根本原因分析とは、言語モデルを使って、数千件のチケットを顧客が問い合わせてきた根本的な理由ごとにまとめ、それぞれの理由にコストを付け、最も大きなものを、それを取り除ける製品部門や業務部門に送る取り組みです。 目的は、チケットにより速く答えることではありません。チケットが生まれないようにすることです。
ほとんどのサポートダッシュボードが報告するのは、何が起きたかです。チャネル別の件数、応答時間、CSATなどです。なぜ起きたかを示すものは、ほとんどありません。そして、お金がかかっているのは「なぜ」の部分です。1行の製品修正でなくせたはずの質問に、サポートチームがどれほど効率よく答えても、無駄は残るからです。この記事では、AIがどのように原因を見つけるか、スプレッドシートで計算できる式で原因をどう金額化するか、そして結果を行動できる人たちにどう渡すかを解説します。AI for Customer Serviceコレクションの一部で、チケットがある程度きれいであることを前提にしています(そうでない場合は、AIのためのサポートデータの準備をご覧ください)。
重要なポイント
- 広く使われているオープンソースの手法であるBERTopicは、3つの手順でトピックを作ります。事前学習済みのトランスフォーマーでドキュメントを埋め込みにし、その埋め込みをクラスタリングし、クラスごとのTF-IDFの手順で各クラスターを説明します(Grootendorst, 2022)。
- Sentence-BERTは、1万文のコレクションで最も類似したペアを見つけるのにかかる時間を、通常のBERTでの約65時間から約5秒に短縮しました。これにより、大規模なテキスト集合を埋め込みでクラスタリングすることが現実的になりました(Reimers and Gurevych, 2019)。
- 古典的なトピックモデルである潜在ディリクレ配分法(LDA)は、各ドキュメントをちょうど1つのトピックに割り当てるのではなく、複数のトピックの混合として扱います(Blei, Ng and Jordan, JMLR, 2003)。これは、2つの問題に同時に触れているチケットに適しています。
- HDBSCANのような密度ベースのクラスタリングでは、一部のドキュメントがどこにも割り当てられません。BERTopicでは、そうした外れ値に-1というラベルが付き、トピックの説明の作成には使われません(BERTopic documentation)。
- k-meansは、クラスター数を事前に設定する必要があり、ほぼ同じ大きさのグループを作る傾向があります。一方、階層的クラスタリング(agglomerative)では、代わりに類似度のしきい値を設定できます(Sentence Transformers documentation)。
- BERTopicのデフォルトの埋め込みモデルには、50以上の言語に対応する多言語のオプションが含まれます(BERTopic documentation)。
タグとダッシュボードが原因を見逃す理由
ほとんどのチームは、すでにチケットを「分類」しています。問題はその方法です。
担当者が選ぶタグはノイズが多い。 忙しい担当者は、長いドロップダウンから最も近い選択肢を選びます。「請求」には、返金依頼、税金の質問、決済の失敗、プランの混乱が入ってしまい、この4つは修正方法がそれぞれ違います。タグも、正確なものではなく、楽なものが選ばれます。
固定の分類体系は凍りついている。 カテゴリは1年前に作られたものです。新しいリリースが新しい問題を生んでも、誰かが気づくまでの6週間は「その他」に入ったままになります。
記録されるのは原因ではなく症状。 「顧客がログインできない」は症状です。原因は、期限切れの招待リンク、SSOの設定ミス、わかりにくいパスワードルールかもしれません。原因が3つ、担当者が3つ、タグが1つです。
AIは、顧客が実際に使った言葉と担当者の返信を読み、ラベルではなく意味でチケットをまとめるので、状況が変わります。「新入社員が開く前に招待リンクが期限切れになった」というクラスターは、プロダクトマネージャーが行動に移せるものです。「アカウントアクセス」というタグは、そうではありません。
AIが根本原因を見つける仕組み
内部では、最近のパイプラインの大半が同じ4つのステップをたどります。それを理解しておくと、ベンダーの主張を判断したり、小さなバージョンを自分で作ったりするのに役立ちます。
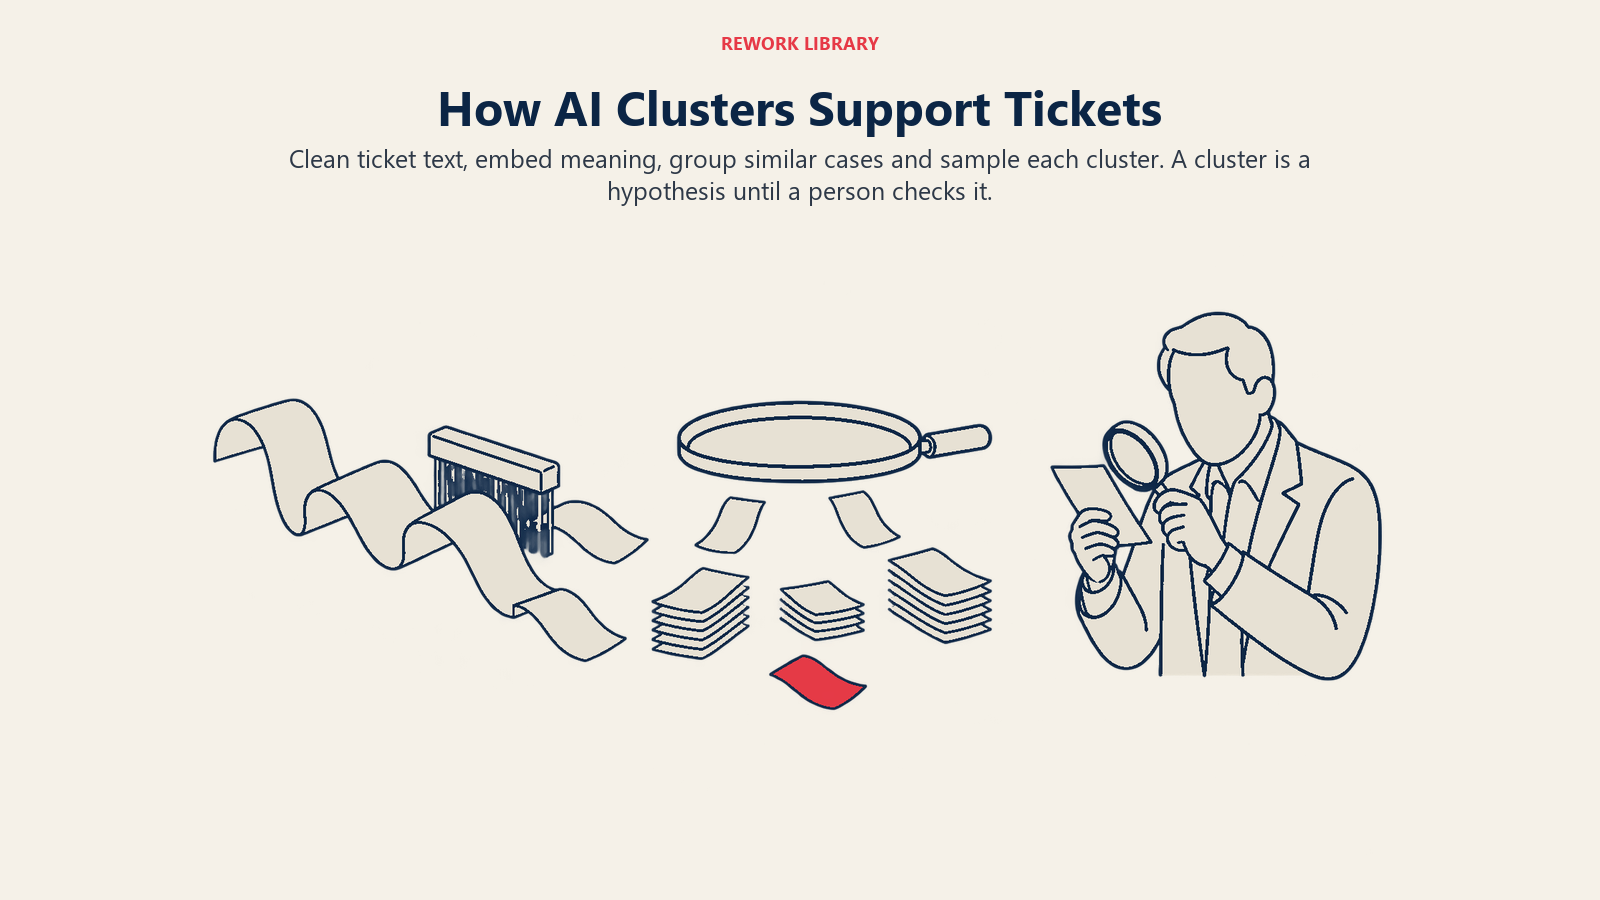
ステップ1:テキストを準備する
顧客の最初のメッセージ、担当者の最終的な解決メモ、社内の要約を取り出します。署名、引用された返信の連鎖、定型文は取り除きます。チケットが長いスレッドの場合は、元のスレッドよりチケット要約のほうが、短く、ひとつのことについて書かれているため、入力として優れていることがよくあります。
ステップ2:各チケットを埋め込みにする
埋め込みとは、テキストを数値のリストで表したもので、似た意味のものが近くに配置されます。「サインインできません」と「ログインが失敗し続けます」は、共通する単語がなくても近くに配置されます。文レベルの埋め込みモデルのおかげで、大量のチケットでも十分な速さで処理できるようになりました(Reimers and Gurevych, 2019)。複数の言語をサポートしているなら、多言語の埋め込みモデルを選んでください。同じバグに関するスペイン語のチケットと英語のチケットが、同じ場所にまとまります。
ステップ3:埋め込みをクラスタリングする
クラスタリングは、近くにあるチケットをグループにまとめます。どの手法を選ぶかで、得られる結果が変わります。
| 手法 | 仕組み | 向いているケース | 注意点 |
|---|---|---|---|
| k-means | クラスター数を最初に自分で決める | テーマの数がおおよそわかっているときの、手早い最初の確認 | チケットをほぼ同じ大きさのグループに押し込む。変わったチケットは、最も近いグループに詰め込まれる |
| 階層的クラスタリング(しきい値) | 類似度のしきい値に達するまで、似たチケットを統合する | テーマの数が不明なとき。粗いグループと細かいグループの調整 | 非常に大きなデータセットでは遅い |
| HDBSCAN(BERTopic経由) | 密度の高い領域を見つけ、残りは外れ値にする | 雑然として不均一な実際のチケットデータ | チューニングするまで、多くのチケットが外れ値のバケットに入ることがある |
| LDA | 各チケットを、単語ベースのトピックの混合として扱う | 複数の問題を含むチケット。透明性の高い単語リスト | 単語の出現数に基づくため、埋め込みが捉える意味を見逃す |
4つとも、上記の出典で説明されています(Sentence Transformers、BERTopic、Blei et al.)。ほとんどのサポートチームにとって、埋め込みと密度ベースの手法の組み合わせが実用的な標準です。チケットデータは不均一で、巨大なテーマが少数と、小さなテーマのロングテールがあるからです。k-meansのような重心ベースの手法は、実際より整ったグループを想定しています。
ステップ4:各クラスターに名前を付けてサンプルを確認する
クラスターは、名前が付くまではただのチケットの山です。ラベルを付ける方法は2つあります。最も特徴的な単語を挙げる方法(BERTopicのクラスごとのTF-IDFのステップがこれを行います)と、言語モデルに代表的なチケットを10〜20件読ませて、1文の説明を書かせる方法です。いずれにしても、対応を計画するすべてのクラスターについて、人がサンプルを読むべきです。 モデルは、似て聞こえても原因が違うチケットを結びつけてしまうことがあります。たとえば、権限の問題による「エクスポートできない」と、ファイルサイズの制限による「エクスポートできない」です。
関連する話として、なぜそうなったかではなく、顧客が何を望んでいるか(返金、解約、アップグレード)を分類するだけでよいなら、それはインテント検出です。インテントはリクエストの種類を示します。根本原因は、上流で何が壊れたかを示します。
外れ値と雑然としたクラスターへの対処
完璧ではないことを前提にしてください。いくつかの習慣で、出力を使えるものに保てます。
- 毎回、外れ値のバケットを見る。 割り当てられなかったチケットはゴミではありません。新しい問題の初期の兆候は、類似のチケットがまだ少なくてクラスターを作れないため、そこにあることがよくあります。
- 大きなクラスターを分割する。 1つのクラスターが件数の20%を占めているなら、おそらく複数の原因が混ざっています。その中でクラスタリングをやり直します。
- ほぼ重複するものを統合する。 同じ修正で解決する2つのクラスターは、1つの項目にすべきです。
- 定期的に再実行する。 過去90日を対象にした月次の実行で、季節要因やリリース起因の急増を捉えられます。過去14日を対象にした週次の実行で、リグレッションを捉えられます。
各原因に金額を付ける
これが、テキストマイニングの演習を、ビジネスケースに変えるステップです。他の業界のベンチマークは必要ありません。自社のヘルプデスクと経理から得られる3つの数字があれば十分です。
計算式:
ある原因の月間コスト = 月間チケット数 × 平均対応時間(分)× エージェント1分あたりの総コスト
- 月間チケット数: クラスターの大きさです。サンプルをクラスタリングした場合は、全体の件数に拡大して換算します。
- 平均対応時間: 全社の平均ではなく、そのクラスターのチケットについて、ヘルプデスクから取得します。技術的な原因は通常、「注文はどこですか」よりはるかに時間がかかります。
- エージェント1分あたりの総コスト: 担当者の雇用コストの合計(給与、福利厚生、ツール、管理の間接費)を、月に働く生産的な時間(分)で割ったものです。経理に確認してください。
問い合わせ1件あたりで考えたいなら、「対応時間 × 1分あたりの総コスト」が、その原因の問い合わせ1件あたりのコストです。
具体的な計算例
以下の数字は、計算の流れを示すために作った架空のものです。自社の数字に置き換えてください。エージェント1分あたりの総コストを$0.75と仮定します。
| 原因(クラスター) | 月間チケット数 | 平均対応時間(分) | 月間コスト | 件数順の順位 | コスト順の順位 |
|---|---|---|---|---|---|
| 注文状況の混乱 | 3,000 | 5 | 3,000 × 5 × 0.75 = $11,250 | 1 | 4 |
| パスワードリセットのメールが届かない | 2,400 | 6 | 2,400 × 6 × 0.75 = $10,800 | 2 | 5 |
| 請求書の税金の行がわかりにくい | 1,200 | 15 | 1,200 × 15 × 0.75 = $13,500 | 3 | 3 |
| 大きなファイルでエクスポートが失敗する | 900 | 22 | 900 × 22 × 0.75 = $14,850 | 4 | 2 |
| 連携の同期エラー | 600 | 35 | 600 × 35 × 0.75 = $15,750 | 5 | 1 |
最後の2列を見てください。チケット数が最も少ない原因が最もコストが高く、最も声の大きい原因は4位にすぎません。件数で修正するチームは、まず注文状況から手を付けます。原因を金額化するチームは、まず同期エラーから手を付けます。この逆転こそが、この計算をする理由のすべてです。
計算式が隠すコストを加える
対応時間だけでは過小評価になります。測定できるものを重ねてください。
- 再問い合わせ。 ある原因が同じ問題でのフォローアップを生んでいるなら、チケット数に、解決した案件あたりの平均問い合わせ回数を掛けます。
- エスカレーション。 エンジニアリングに届くチケットは、サポート以外の高価な時間を消費します。その時間を、エンジニアの総コストの単価で加えます。
- その原因に関連する解約と返金。 クラスター内の顧客が、より頻繁に解約したりクレジットを求めたりするなら、それも帳簿に載せるべきです。解約分析で、すでに一部を追跡できているかもしれません。
これらは別の列にしておきます。読む人が、まず純粋なエージェント工数のコストを見て、その次により広いコストを見られるようにすれば、数字が水増しされたと思われずに済みます。
修正の価値を見積もる
月間コストがわかれば、修正の価値は簡単です。
月間の削減額 = 月間コスト × 修正でなくなるチケットの割合
同期エラーの修正でそのチケットの70%がなくなると見込まれる場合、上の例では0.70 × $15,750 = 月$11,025になります。これは見積もりなので、プロダクトのパートナーには幅(たとえば40%〜80%)を示し、リリース後にクラスターを再実行して更新してください。削減額を、エンジニアリングの工数と比較します。こうして、優先順位の議論を、逸話ではなく数字で勝ち取ります。
修正を適切な担当者へ回す
原因を見つけただけでは、修正にはなりません。サポートの知見の大半は、次のステップの担当者がいないため、スライド資料の中で終わります。ルーティングをプロセスに組み込んでください。
| 原因の種類 | 通常の担当者 | 引き渡す内容 | 「修正済み」の状態 |
|---|---|---|---|
| バグまたは壊れたフロー | プロダクト / エンジニアリング | クラスター名、チケット数、コスト、例となるチケット5件、再現手順 | リリース後にクラスターが縮小する |
| わかりにくいUIまたは足りない機能 | プロダクトデザイン / プロダクトマネジメント | 顧客の言葉そのまま、期待していたことと実際に起きたこと | チケットが減る、またはセルフサービスの手段に置き換わる |
| 不明確なポリシー、価格設定、請求 | 経理 / レベニューオペレーション | 混乱の原因となるポリシーの行、返金への影響 | ポリシーが書き直される、または請求書のレイアウトが変更される |
| プロセスまたは引き継ぎの失敗 | オペレーション | 案件が止まった場所、再問い合わせ率 | 新しいステップ、担当者、SLAが整う |
| ヘルプコンテンツの不足または誤り | サポートコンテンツ / ナレッジチーム | 検索キーワード、役に立たなかった記事、チケットの例 | 記事が公開され、デフレクション(問い合わせ削減)が改善する(ヘルプセンター検索を参照) |
| 顧客教育のギャップ | カスタマーサクセス / オンボーディング | どのセグメントが、どのライフサイクルの段階で問い合わせているか | オンボーディングのステップまたはアプリ内のヒントが追加される |
いくつかの工夫で、引き渡しが定着します。
- 原因ごとに1ページ。 名前、わかりやすい説明、件数の推移、月間コスト、例となるチケット(顧客の詳細は削除)、提案する担当者、修正案を載せます。
- 定例レビュー。 プロダクト、オペレーション、サポートで、毎月30分の会議をカレンダーに入れます。件数ではなく、コストの上位5つの原因を順に確認します。
- 共有の台帳。 各原因を、「特定済み」から「修正リリース済み」、「チケット数の減少を確認済み」まで追跡します。この最後のループを閉じることが、信頼を築きます。サポートチケットからプロダクトバックログへの記事では、リクエストをエンジニアリングのキューに届く形で書く方法を扱い、AIでサポートの知見をプロダクトにルーティングするでは、その流れを安定させる方法を示しています。
- 製品を直せないときは、コンテンツを直す。 エンジニアリングが今四半期は動けなくても、より良いヘルプ記事や事前のお知らせで、件数は減らせます。
従来の根本原因分析との関係
AIによるクラスタリングが答えるのは、「原因は何で、それぞれどのくらいの大きさか」です。「その原因はなぜ存在するのか」には答えません。この2つ目の問いに、なぜなぜ分析や特性要因図といった従来の手法が登場します。これらの手法は、根本原因分析のガイドで扱っています。実用的な役割分担はこうです。AIがチケットのレベルで原因を見つけて大きさを測り、その後、小さな部門横断のグループが、上位2、3件について人間によるRCAを行います。
段階的な導入方法
- 範囲を決める。 1つの製品ライン、1つのチャネル、過去90日です。全社では始めないでください。
- エクスポートしてクリーニングする。 チケットのテキスト、解決メモ、対応時間、チャネル、製品領域、エスカレーションのフラグです。不要な個人データは削除します。
- 最初のクラスタリングを実行する。 埋め込みモデルと密度ベースの手法を使います。雑然とした出力になることを覚悟してください。
- サンプルを読む。 上位20のクラスターそれぞれについて読みます。担当者が「そう、それは実際にあることだ」と言うまで、名前を付け直し、分割し、統合します。
- 各クラスターを金額化する。 計算式を使い、クラスターごとの対応時間を用います。
- コスト順に並べ、 再問い合わせとエスカレーションの列を加えます。
- 担当者を割り当てて引き渡す。 上位5件について、1ページの概要書を渡します。
- 毎月再実行する。 各クラスターの件数を、修正がリリースされた日付と照らして追跡します。
- 結果を計画にフィードバックする。 リリース起因の急増と、定常的な需要を切り分けると、問い合わせ件数の予測がより信頼しやすくなります。
よくある落とし穴
クラスターを真実として扱う。 クラスターは仮説です。エンジニアリングに伝える前に、チケットを読んでください。
件数で順位を付ける。 計算例が示すように、チケット1件あたりのコストが最も安い原因が、最も件数が多いことがよくあります。コストで順位を付けてください。
すべてに同じ対応時間を使う。 全社の平均は、長くてコストのかかるチケットを隠します。クラスターごとの対応時間を使ってください。
確認できない削減額を数える。 見積もりの削減額は幅で報告し、修正後に実際の減少を測定します。
外れ値を飛ばす。 新しい問題は小さく始まります。割り当てられなかったバケットを誰も見なければ、気づくのが遅れます。
一度きりの分析。 原因はリリースのたびに変わるため、1回きりのレポートはすぐに古くなります。
原因に起因する件数を担当者のせいにする。 ある原因が長いチケットの3分の1を生んでいるなら、コーチングでは直りません。直すのは製品です。
生のチケットを不用意に共有する。 チケットがサポートの外に出る前に、名前、メールアドレス、アカウントの詳細を取り除いてください。
サポートのAI根本原因分析に関するよくある質問
カスタマーサポートのAI根本原因分析とは何ですか?
言語モデルを使って、サポートチケットを顧客が問い合わせてきた根本的な理由ごとにまとめ、それぞれの理由にどれだけコストがかかっているかを測り、最も大きなものを修正できる部門へ回す取り組みです。チケットにより速く答えることではなく、チケットの原因を取り除くことに焦点を当てています。
AIはどのようにサポートチケットをクラスタリングしますか?
ほとんどの手法は、各チケットを、その意味を捉えた数値の集まりである埋め込みに変換し、埋め込みが近いチケットをまとめます。BERTopicは一般的なオープンソースの例で、ドキュメントを埋め込みにし、クラスタリングして、クラスごとのTF-IDF手法で各クラスターを説明します。LDAのような古い手法は、意味ではなく単語のパターンから処理します。
チケットの原因のコストはどう計算しますか?
クラスター内の月間チケット数に、そのクラスターの平均対応時間(分)を掛け、さらにエージェント1分あたりの総コストを掛けます。たとえば、600件のチケット、35分、1分あたり$0.75なら、月$15,750です。再問い合わせ、エスカレーション、関連する解約は、別の行として加えます。
件数ではなくコストで原因に順位を付けるのはなぜですか?
件数で見ると、数分で終わる単純で頻度の高い質問が有利になります。コストは対応時間を考慮するため、長くて技術的なチケットの小さなクラスターが、素早く片付く大きなクラスターを上回ることがあります。コストで順位を付ければ、限られたエンジニアリングの時間を、最も多くを節約できるところに向けられます。
AIは手作業のレビューなしで根本原因を見つけられますか?
できません。クラスタリングは、似て聞こえるが原因の異なるチケットを統合することがあり、密度ベースの手法は、一部のチケットを割り当てないままにします。プロダクトやオペレーションに回す前に、各クラスターのサンプルを人が読み、割り当てられなかったチケットも、新たな問題がないか確認してください。
分析はどのくらいの頻度で実行すべきですか?
過去90日を対象にした幅広い分析を月次で、過去14日を対象にした軽めの分析を週次で実行し、リリース後のリグレッションを捉えます。修正がリリースされたら、そのクラスターを再実行して、件数が本当に減ったかを確認してください。
修正は誰が担当すべきですか?
原因を管理するチームです。バグやわかりにくいフローはプロダクトとエンジニアリング、請求とポリシーは経理、プロセスの失敗はオペレーション、ヘルプコンテンツの不足はナレッジチームです。サポートが担うのは、分析とフォローアップであり、すべての修正ではありません。
