AI Quality Assurance für den Support: Jede Konversation bewerten
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI Quality Assurance (AI QA) für den Support bedeutet, mit einem Sprachmodell jede Kundenkonversation, die eine menschliche Mitarbeiterin oder ein menschlicher Mitarbeiter bearbeitet, anhand eines schriftlichen Bewertungsrasters zu bewerten, statt einen Prüfer eine kleine, handverlesene Stichprobe benoten zu lassen. Das Modell liest das Transkript, beantwortet die Fragen des Rasters (Hat die Mitarbeitende das eigentliche Problem erkannt? War die Lösung korrekt? War der Ton angemessen?) und erzeugt einen Wert, den Sie nach Mitarbeitenden, Team, Thema oder Woche aufschlüsseln können.
Der Reiz liegt in der Abdeckung. Ein manuelles QA-Programm kann nur so viele Tickets lesen, wie seine Prüfer Stunden haben, sodass die meisten Konversationen, darunter einige der schlechtesten, nie angesehen werden. AI kann alle lesen. Aber alles zu lesen heißt nicht, es richtig zu lesen, und ein Wert, dem die Mitarbeitenden nicht trauen, ist schlechter als gar kein Wert. Dieser Leitfaden behandelt deshalb drei Dinge: wie AI QA funktioniert, wie Sie sie an menschlichen Prüfern kalibrieren und wie Sie sie fair halten. Er gehört zur Collection AI for Customer Service. Der Überblick zu AI im Kundenservice ist daher ein guter Einstieg, wenn Sie den größeren Zusammenhang möchten.
Wichtige Fakten
- Das QA-Produkt von Zendesk wirbt mit „100% coverage with AutoQA“ und fordert Teams auf, Tickets nicht mehr manuell auszuwählen und stattdessen jede Interaktion zu analysieren (Zendesk). Das ist eine Herstelleraussage zur Abdeckung, nicht zur Genauigkeit.
- Die Einstellungsdokumentation von Zendesk selbst besagt, dass die automatischen Bewertungen nur zur Orientierung dienen, nicht für Leistungsentscheidungen verwendet werden sollten und menschliche Leistungsbeurteilungen ergänzen, nicht ersetzen sollten (Zendesk).
- Cohens Kappa misst die Übereinstimmung über den Zufall hinaus. Nach der vielzitierten Interpretation von McHugh ist 0,60 bis 0,79 eine mäßige Übereinstimmung, 0,80 bis 0,90 eine starke und über 0,90 eine nahezu perfekte (McHugh, Biochemia Medica, 2012).
- Forschung zu LLM-Bewertern ergab, dass starke Modelle über 80% Übereinstimmung mit menschlichen Präferenzen erreichen können, derselbe Wert, mit dem Menschen untereinander übereinstimmen, dokumentierte aber auch Verzerrungen durch Position, Wortreichtum und Selbstbevorzugung (Zheng et al., 2023).
- Nach dem EU AI Act gelten AI-Systeme zur Überwachung und Bewertung von Leistung und Verhalten von Beschäftigten als Hochrisiko-Systeme, aufgeführt in Anhang III, Nummer 4 Buchstabe b (EU AI Act, Annex III).
So funktioniert AI QA
Klassische QA ist ein Kreislauf mit einem Engpass in der Mitte. Ein QA-Analyst wählt Tickets aus, öffnet jedes einzelne, bewertet es anhand einer Scorecard, schreibt Kommentare und schickt Feedback an die Mitarbeitenden. Weil die Zeit des Analysten begrenzt ist, bleibt die Stichprobe klein, und die Auswahl ist selten zufällig. Meist prüfen Menschen die Tickets, die eskaliert wurden, einen schlechten CSAT erhielten oder zufällig kurz sind.
AI QA behält die Scorecard und ersetzt den Leseschritt des Analysten. Die Pipeline sieht so aus:
- Ingest. Konversationen aus Chat, E-Mail, Transkripten von Telefonaten und Tickets fließen mit Metadaten ein: Kanal, Thema, Mitarbeitende, Kundenstufe, Ergebnis.
- Analyze. Ein Modell liest jede Konversation und beantwortet jede Frage des Rasters, meist mit einer kurzen Begründung, die aus dem Transkript zitiert wird.
- Score. Die Antworten werden zu einem Konversationswert verdichtet und dann zu Ansichten nach Mitarbeitenden, Team und Thema.
- Route. Konversationen mit niedrigem Wert oder hohem Risiko gehen an einen menschlichen Prüfer. Herausragende gehen in eine Coaching-Bibliothek.
Dieser letzte Schritt ist der Grund, warum dieses Thema zum Muster Scoring und Routing im ACE Framework gehört: Das Modell bewertet nicht nur, es entscheidet, welche Konversationen sich ein Mensch ansehen sollte. Gut umgesetzt, verbringen Ihre menschlichen Prüfer ihre Stunden mit den 5%, die Urteilsvermögen brauchen, statt mit den 95%, die es nicht brauchen.
Das Autoscoring von Zendesk QA wird mit Standardkategorien wie Greeting, Empathy, Spelling and grammar, Closing, Solution offered, Tone, Readability und Comprehension geliefert. Einige sind einfache Ja/Nein-Prüfungen, Tone ist ein gewichteter Wert, und Readability ist eine feste Dreipunkteskala (Zendesk). „Hat die Mitarbeitende den Kunden begrüßt?“ ist fast mechanisch. „Hat die Mitarbeitende das Anliegen des Kunden verstanden?“ erfordert Urteilsvermögen. Dieser Unterschied bestimmt den Rest dieses Beitrags.
Manuelle QA im Vergleich zu AI QA
| Dimension | Manuelle QA | AI QA |
|---|---|---|
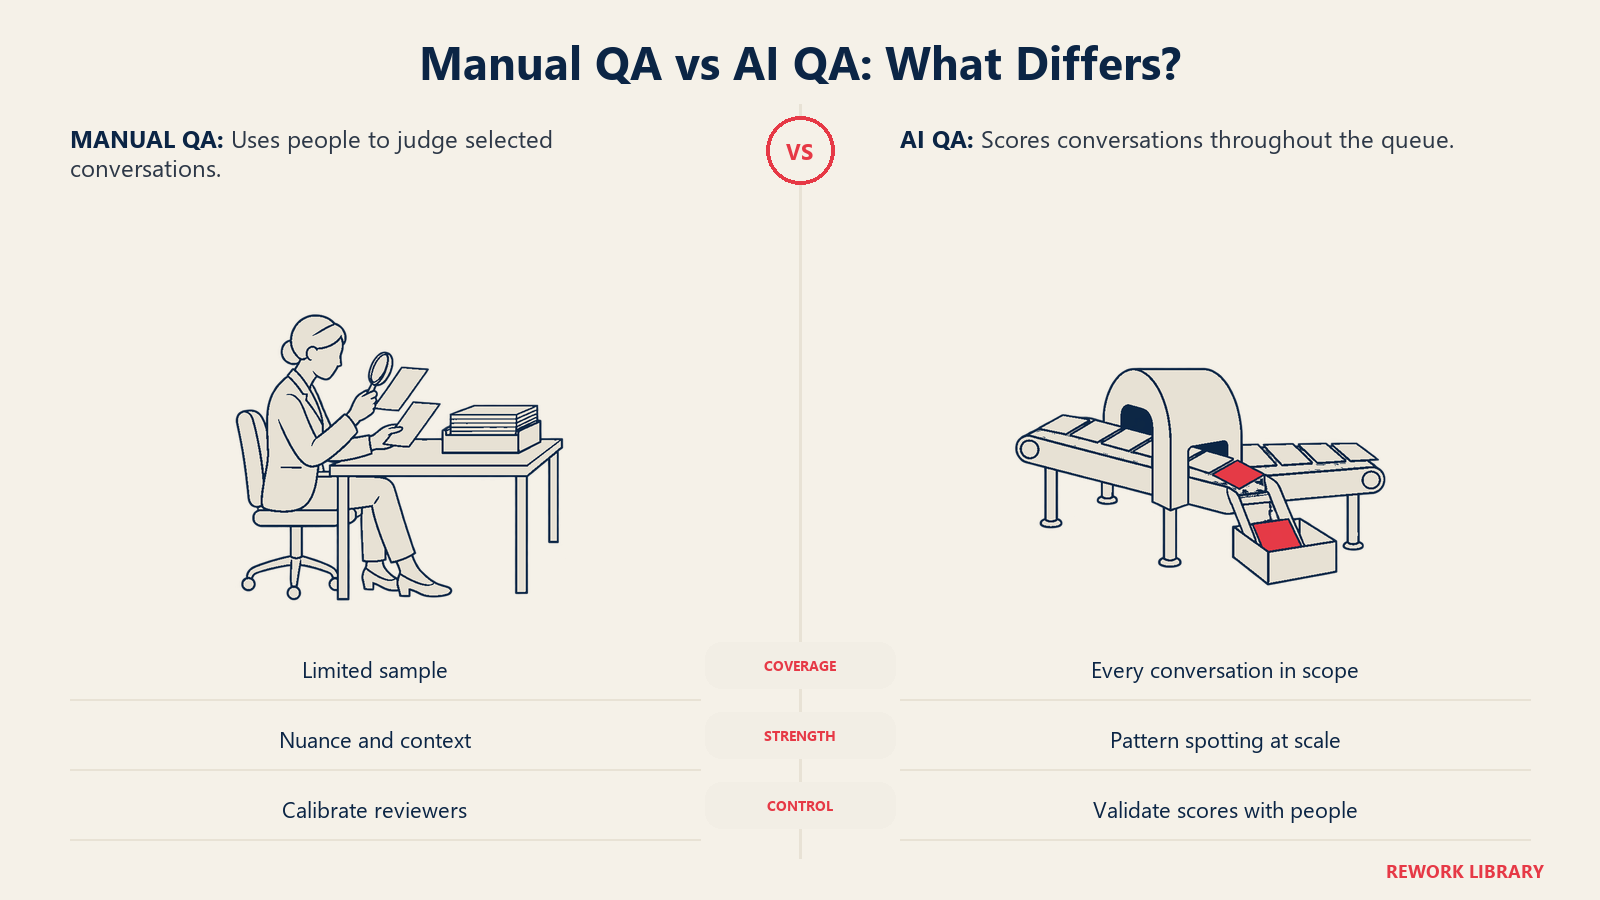
| Abdeckung | Eine Stichprobe, von einem Menschen gewählt | Jede Konversation im Geltungsbereich |
| Konsistenz | Schwankt je nach Prüfer und Tagesform | Jedes Mal derselbe Prompt, dasselbe Raster (aber nicht immer dieselbe Antwort) |
| Am besten bei | Nuancen, Kontext, Richtlinienausnahmen, Empathie | Mustererkennung, mechanische Prüfungen, Ausreißer finden |
| Schwach bei | Skalierung, Tempo, seltene Probleme erkennen | Kontext, den es nicht sieht, Sarkasmus, ungeschriebene Richtlinien |
| Typisches Versagen | Stichprobenverzerrung, Prüferdrift | Selbstsicher falsche Werte, Vorliebe für Stil statt Substanz |
Das ehrliche Fazit: Keines ersetzt das andere. AI liefert Breite, Menschen liefern Ground Truth (Referenzwerte), und der unten beschriebene Kalibrierungsprozess verbindet beides.
Praxisbeispiele nach Funktion
Das Raster ändert sich je nachdem, wo die Konversation stattfindet. Ein paar konkrete Fälle:
Kundensupport auf Tier 1. Ein Kunde meldet sich wegen einer doppelten Abbuchung. Das Raster prüft, ob die Mitarbeitende die Identität verifiziert, die Dublette gefunden, den Zeitplan der Rückerstattung erklärt und nichts versprochen hat, was die Richtlinie verbietet. Bei der letzten Prüfung ist AI gut: Sie kann jede Konversation markieren, in der eine Mitarbeitende eine Formulierung wie „garantiert“ verwendet oder eine Rückerstattungsfrist genannt hat, die nicht zur aktuellen Richtlinie passt.
Abrechnung und Inkasso. Hier zählt die Compliance am meisten. Das Raster könnte eine Offenlegung zu Beginn verlangen und bestimmte Drohungen verbieten, und AI QA kann jede Konversation auf beides prüfen, wo eine manuelle Stichprobe sie nur zufällig erwischen würde.
Technischer Support. Die Diagnose lässt sich schwerer automatisch benoten. Oft funktioniert sie besser als „zur Prüfung markieren, wenn der Kunde innerhalb einer Woche wegen desselben Problems zurückkam“ als als absolute Note.
Interner IT-Helpdesk. Der „Kunde“ ist ein Mitarbeitender, und die Raster stützen sich auf die Lösungsqualität und darauf, ob die Mitarbeitende auf den richtigen Artikel verwiesen hat, was zugleich Lücken in Ihren Support-Daten aufdeckt.
Das Bewertungsraster gestalten
Das Modell ist nur so gut wie die Frage, die Sie ihm stellen. Die meisten gescheiterten AI-QA-Programme scheitern am Raster, nicht am Modell.
Eine brauchbare Scorecard hat vier bis acht Kriterien, jedes als beobachtbare, beantwortbare Frage formuliert statt als vages Merkmal. Vergleichen Sie „War die Mitarbeitende empathisch?“ mit „Hat die Mitarbeitende das genannte Problem des Kunden anerkannt, bevor sie zu einer Lösung überging?“. Die zweite Frage lässt sich am Transkript prüfen, und zwei Prüfer sind sich dabei sehr viel wahrscheinlicher einig.
| Kriterium | Schwache Formulierung | Starke Formulierung | Typ |
|---|---|---|---|
| Verständnis | „Hat den Kunden verstanden“ | „Hat das tatsächliche Problem des Kunden wiederholt oder bestätigt, bevor sie eine Lösung vorschlug“ | Ja / Nein |
| Genauigkeit | „Hat eine gute Antwort gegeben“ | „Die genannte Lösung oder Richtlinie stimmt mit dem aktuellen Artikel der Wissensdatenbank überein“ | Ja / Nein / Nicht beurteilbar |
| Prozess | „Hat das Verfahren befolgt“ | „Hat die Identität verifiziert, bevor Kontodaten weitergegeben wurden“ | Ja / Nein / Nicht erforderlich |
| Ton | „Professionell“ | „Keine abwertende oder beschuldigende Sprache gegenüber dem Kunden“ | Ja / Nein |
| Abschluss | „Gut abgeschlossen“ | „Hat den nächsten Schritt und seinen Verantwortlichen genannt oder bestätigt, dass nichts weiter nötig war“ | Ja / Nein |
Zwei Gestaltungsentscheidungen zahlen sich aus. Erstens: Erlauben Sie immer „nicht beurteilbar“ oder „nicht zutreffend“. Ein Modell, das zwischen Ja und Nein wählen muss, rät, und Raten bei fehlendem Kontext ist die Quelle unfairer Werte. Zweitens: Gewichten Sie die Kriterien danach, was Kunden tatsächlich spüren. Eine korrekte Lösung sollte schwerer wiegen als ein Rechtschreibfehler.
Kalibrierung: Den Wert glaubwürdig machen
Die Kalibrierung ist der Schritt, der ein Dashboard, über das gestritten wird, von einem unterscheidet, das genutzt wird. Die Idee ist einfach: Lassen Sie Menschen und AI dieselben Konversationen bewerten, messen Sie, wie oft sie übereinstimmen, und schließen Sie die Lücken.
Schritt 1: Ein Gold-Set aufbauen
Wählen Sie 100 bis 200 Konversationen, die Ihre Kanäle, Themen und Schwierigkeitsgrade abdecken. Nehmen Sie einige einfache, einige mehrdeutige und einige dazu, von denen Sie schon wissen, dass sie schlecht liefen. Lassen Sie jede mindestens von zwei erfahrenen Prüfern unabhängig bewerten und klären Sie Abweichungen dann gemeinsam. Das Ergebnis ist ein „Gold-Set“ mit abgestimmten Antworten, und die Meinungsverschiedenheiten unterwegs sind für sich genommen wertvoll, weil sie zeigen, wo Ihr Raster vage ist.
Schritt 2: Die AI auf demselben Set laufen lassen
Bewerten Sie das Gold-Set mit dem Modell. Vergleichen Sie Kriterium für Kriterium, nicht nur den Gesamtwert. Ein Gesamtwert kann gut aussehen, während ein Kriterium, sagen wir „Genauigkeit“, unbemerkt in der Hälfte der Fälle falsch liegt.
Schritt 3: Die Übereinstimmung richtig messen
Die rohe prozentuale Übereinstimmung ist irreführend, denn zwei Bewerter, die meistens beide „bestanden“ sagen, stimmen zufällig oft überein. Nutzen Sie Cohens Kappa, das die zufällige Übereinstimmung herausrechnet. Ein hypothetisches Beispiel zeigt, warum das wichtig ist:
| AI sagt bestanden | AI sagt nicht bestanden | Gesamt | |
|---|---|---|---|
| Prüfer sagt bestanden | 70 | 10 | 80 |
| Prüfer sagt nicht bestanden | 10 | 10 | 20 |
| Gesamt | 80 | 20 | 100 |
Die beiden stimmen bei 80 von 100 Konversationen überein, die rohe Übereinstimmung beträgt also 80%. Wenn aber beide etwa 80% der Konversationen bestehen lassen, würden sie allein durch Zufall etwa zu 68% übereinstimmen. Kappa ist (0,80 minus 0,68) geteilt durch (1 minus 0,68), also etwa 0,38. Auf McHughs Skala ist das eine schwache Übereinstimmung (McHugh, 2012), obwohl die Schlagzeile 80% sagt. Der Großteil der „Übereinstimmung“ der AI bestand schlicht darin, dass beide „bestanden“ sagten.
Berechnen Sie Kappa für jedes Kriterium und auch für die menschlichen Prüfer untereinander. Diese zweite Zahl ist Ihre Obergrenze. Wenn Ihre beiden besten Prüfer untereinander nur 0,65 erreichen, ist es unrealistisch, von der AI 0,9 zu erwarten, und die eigentliche Lösung ist ein klareres Raster. Die Forschung zu LLM-Bewertern weist in dieselbe Richtung: Starke Modelle können die Rate erreichen, mit der Menschen untereinander übereinstimmen, was ein nützliches Ziel ist, kein magisches (Zheng et al., 2023).
Schritt 4: Die Lücken schließen, dann erneut testen
Wo die Übereinstimmung niedrig ist, haben Sie drei Hebel: das Kriterium konkreter formulieren, durchgespielte Beispiele (ein „gutes“ und ein „schlechtes“ Transkript) in den Prompt aufnehmen oder das Kriterium aus der automatischen Bewertung nehmen und ausschließlich Menschen überlassen. Manche Kriterien, etwa echte Empathie, erreichen womöglich nie eine akzeptable Übereinstimmung. Bewerten Sie, was die AI zuverlässig bewertet, und überlassen Sie den Rest den Menschen.
Schritt 5: Weiter kalibrieren
Halten Sie eine feste wöchentliche oder monatliche Sitzung ab: Ein Prüfer bewertet eine frische Zufallsstichprobe, ohne den Wert der AI zu kennen, und Sie verfolgen Kappa im Zeitverlauf. Eine sinkende Zahl ist ein Frühwarnsignal dafür, dass sich etwas geändert hat, etwa eine neue Produktlinie, eine Richtlinienänderung oder eine neue Sprache. Wenn Sie mehrsprachigen Support betreiben, kalibrieren Sie pro Sprache, denn die Übereinstimmung im Englischen sagt nichts über Portugiesisch.
Fairness: Menschen zu bewerten ist etwas anderes als Tickets zu bewerten
Ein QA-Wert ist nicht nur ein Datenpunkt. Er fließt in Coaching, Boni und manchmal in Leistungsbeurteilungen ein. Das erhöht den Einsatz bei Fehlern und bei Verzerrungen, und es ist der Teil, den die meisten Teams zu wenig einplanen.
Die bekannten Verzerrungen kennen. Die Literatur zu LLM-as-Judge dokumentiert Positionsverzerrung, Wortreichtumsverzerrung (längere Antworten werden bevorzugt) und Selbstbevorzugung (Zheng et al., 2023). Im Support hat die Wortreichtumsverzerrung eine direkte Entsprechung: Eine Mitarbeitende, die lange, ausgefeilte Antworten schreibt, kann besser abschneiden als eine, die das Problem in zwei knappen Zeilen löst. Prüfen Sie das, indem Sie kontrollieren, ob der Wert mit der Nachrichtenlänge korreliert, nachdem Sie das Ergebnis herausgerechnet haben.
Auf Unterschiede zwischen Gruppen achten. Vergleichen Sie die Werte nach Betriebszugehörigkeit, Schicht, Sprache, Region und Kontaktart. Manche Unterschiede sind real. Andere zeigen, dass das Raster nicht muttersprachliche Formulierungen oder eine schwierigere Queue bestraft: Wenn Mitarbeitende für Abrechnungsstreitigkeiten schlechter abschneiden als solche für Passwort-Zurücksetzungen, bewertet das Modell womöglich die Schwierigkeit, nicht die Qualität. Normalisieren Sie nach Thema, bevor Sie Personen vergleichen.
Gegenüber den Mitarbeitenden transparent sein. Veröffentlichen Sie das Raster. Lassen Sie die Mitarbeitenden die genauen Kriterien, ihre eigenen Werte und die zitierte Passage sehen, die jedes Urteil ausgelöst hat. Menschen akzeptieren einen niedrigen Wert, wenn sie den Grund dafür sehen. Eine Zahl ohne Erklärung lehnen sie ab.
Einen Widerspruchsweg schaffen. Jede Mitarbeitende sollte einen Wert anfechten können und innerhalb einer festgelegten Frist einen Menschen darauf blicken lassen. Verfolgen Sie die Quote der aufgehobenen Bewertungen. Eine hohe Aufhebungsquote bei einem Kriterium bedeutet, dass dieses Kriterium nicht reif für die Automatisierung ist. Geben Sie aufgehobene Fälle in Ihr Gold-Set zurück.
Einen Menschen in der Entscheidung behalten. Selbst die Anbieter sagen das. Die Dokumentation von Zendesk hält fest, dass die automatischen Bewertungen nur zur Orientierung dienen und menschliche Leistungsbeurteilungen ergänzen, nicht ersetzen sollen (Zendesk). Nutzen Sie den AI-Wert, um zu entscheiden, welche Konversationen ein Mensch liest, und das Urteil des Menschen für alles, was Vergütung oder Beschäftigung betrifft.
Die regulatorische Richtung kennen. In der EU stehen AI-Systeme, die Leistung und Verhalten von Beschäftigten überwachen und bewerten sollen, in Anhang III des AI Act auf der Hochrisiko-Liste (EU AI Act, Annex III), und Artikel 14 verlangt, dass die Personen, die solche Systeme beaufsichtigen, sich der Neigung bewusst bleiben, sich zu stark auf deren Ergebnis zu verlassen, bekannt als Automatisierungsverzerrung (EU AI Act, Article 14). Fragen Sie für Ihre Rechtsordnung Ihre Rechtsberatung, und bedenken Sie, dass Betriebsräte und Gesetze zur Mitarbeiterüberwachung in manchen Ländern eigene Anforderungen stellen.
AI QA Schritt für Schritt einführen
- Den Zweck festlegen. Coaching, Compliance und Kundenerlebnis brauchen unterschiedliche Raster. Beginnen Sie mit einem.
- Das Raster gemeinsam mit den Mitarbeitenden schreiben, nicht nur mit Managern: vier bis acht beobachtbare Kriterien, „nicht beurteilbar“ erlaubt.
- Vor dem Start kalibrieren. Bauen Sie das Gold-Set auf und prüfen Sie Kappa pro Kriterium, wie oben beschrieben.
- Einige Wochen im Schattenmodus laufen lassen, parallel zu Ihrer bisherigen QA, ohne den Mitarbeitenden die Werte zu zeigen, oder sie als „Beta, nicht für Beurteilungen verwendet“ kennzeichnen.
- Festhalten, wie die Werte verwendet werden dürfen. Coaching-Themen und die Auswahl der zu prüfenden Tickets, ja. Boni und Disziplinarmaßnahmen, erst wenn Vertrauen verdient ist.
- Routen, nicht nur berichten. Niedrige Werte, Compliance-Markierungen und Widersprüche gehen in eine menschliche Queue. Herausragende Konversationen gehen als Beispiele in den Coaching-Workflow.
- Den Kreis mit den Mitarbeitenden schließen. Zeigen Sie die Ergebnisse von Anfang an mit zitierten Belegen und einer Widerspruchsschaltfläche.
- Mit dem Stack verbinden. QA-Erkenntnisse zeigen, wo Echtzeit-Vorschläge oder Wissensartikel versagen. Wenn Sie stattdessen einen kundenseitigen Bot messen möchten, lesen Sie AI-Lösungsquote.
- Vierteljährlich prüfen: Lassen Sie das Gold-Set erneut laufen, prüfen Sie Kappa und Wertunterschiede zwischen Gruppen und streichen Sie Kriterien, die sich nicht bewähren.
Wenn Sie noch entscheiden, was in menschlicher Hand bleibt, rahmt automatisieren oder unterstützen diese Entscheidung, und wie AI die Rollen im Support-Team verändert beschreibt, was mit QA-Analysten geschieht: Sie wechseln meist vom Bewerten von Tickets dazu, das Raster, das Gold-Set und die Kalibrierung zu verantworten.
Häufige Fallstricke
Abdeckung mit Genauigkeit verwechseln. „Jede Konversation bewertet“ sagt nichts darüber aus, ob die Werte stimmen. Verlangen Sie Übereinstimmungszahlen gegenüber menschlichen Prüfern anhand Ihrer eigenen Konversationen.
Bewerten, was einfach ist, nicht was zählt. Ein Team, das bei Begrüßungen 98% und bei korrekter Lösung 60% erreicht, hat ein Messproblem, keinen Qualitätserfolg.
„Nicht beurteilbar“ weglassen. Ohne diese Option erfindet das Modell Antworten, wenn dem Transkript der Kontext fehlt, etwa der Kontostatus, den es nie gesehen hat.
Menschen nach Rohwerten ranken. Mitarbeitende in schwierigen Queues werden bestraft. Vergleichen Sie innerhalb eines Themas und behandeln Sie Unterschiede als Fragen, denen Sie nachgehen.
Einmalige Kalibrierung. Die Übereinstimmung lässt nach, wenn sich Produkte und Richtlinien ändern. Planen Sie die erneute Kalibrierung ein.
Den Mitarbeitenden den Wert beibringen, nicht die Fähigkeit. Wenn eine Empathie-Formulierung den Wert erhöht, bekommen Sie Empathie-Formulierungen. Behalten Sie menschliche Prüfung im Mix.
Mitarbeitende für Wissenslücken verantwortlich machen. Viele niedrige Genauigkeitswerte gehen auf veraltete Hilfeartikel zurück. Beheben Sie die Quelle, bevor Sie die Person coachen.
Häufig gestellte Fragen zu AI Quality Assurance für den Support
Was ist AI Quality Assurance für den Kundensupport?
Es ist der Einsatz eines Sprachmodells, um jede Konversation Ihrer menschlichen Mitarbeitenden anhand eines schriftlichen Bewertungsrasters zu bewerten, statt eine kleine Stichprobe manuell zu prüfen. Die Werte erscheinen nach Mitarbeitenden, Team und Thema, und Konversationen mit niedrigem Wert oder Risiko werden an einen menschlichen Prüfer weitergeleitet.
Kann AI QA menschliche QA-Prüfer ersetzen?
Nicht vollständig. AI ist gut bei Abdeckung und mechanischen Prüfungen, Menschen sind besser bei Nuancen, Kontext und Richtlinienausnahmen. Die Dokumentation von Zendesk sagt, dass die automatischen Bewertungen menschliche Leistungsbeurteilungen ergänzen, nicht ersetzen sollen. Die meisten Teams verlagern ihre Prüfer auf Kalibrierung, Widersprüche und die schwierigeren Kriterien.
Wie prüfe ich, ob die AI-Werte mit denen meiner menschlichen Prüfer übereinstimmen?
Bauen Sie ein Gold-Set aus 100 bis 200 Konversationen auf, die von zwei oder mehr Prüfern bewertet wurden, lassen Sie die AI auf demselben Set laufen und vergleichen Sie jedes Kriterium mit Cohens Kappa statt mit der rohen prozentualen Übereinstimmung. Messen Sie auch die Übereinstimmung der Prüfer untereinander, denn sie ist die realistische Obergrenze für die AI.
Was ist ein guter Kappa-Wert für die QA-Kalibrierung?
Nach McHughs Interpretation ist 0,60 bis 0,79 mäßig, 0,80 bis 0,90 stark und über 0,90 nahezu perfekt. Streben Sie bei Kriterien, die in die Beurteilung der Mitarbeitenden einfließen, eine starke Übereinstimmung an. Bei Kriterien, die nur helfen, die zu lesenden Tickets auszuwählen, kann eine mäßige Übereinstimmung akzeptabel sein.
Wie halte ich AI QA gegenüber den Mitarbeitenden fair?
Veröffentlichen Sie das Raster, zeigen Sie den Mitarbeitenden die zitierten Belege hinter jedem Wert, vergleichen Sie Personen innerhalb desselben Themas oder derselben Queue, prüfen Sie auf Verzerrungen wie die Bevorzugung längerer Antworten und geben Sie jeder Mitarbeitenden eine Möglichkeit zum Widerspruch. Behalten Sie einen Menschen bei jeder Entscheidung, die Vergütung oder Beschäftigung betrifft.
Sollten Mitarbeitende erfahren, dass AI ihre Konversationen bewertet?
Ja. Transparenz ist fair und zugleich praktisch, denn Mitarbeitende, die das Raster verstehen, verbessern sich schneller und widersprechen seltener. Je nachdem, wo Sie tätig sind, können Regeln zur Mitarbeiterüberwachung und zu AI, etwa die Einstufung von Systemen zur Mitarbeiterbewertung als Hochrisiko im EU AI Act, auch eine Offenlegung verlangen. Fragen Sie daher Ihre Rechtsberatung.

Customer Success Operations Manager
On this page
- Wichtige Fakten
- So funktioniert AI QA
- Manuelle QA im Vergleich zu AI QA
- Praxisbeispiele nach Funktion
- Das Bewertungsraster gestalten
- Kalibrierung: Den Wert glaubwürdig machen
- Schritt 1: Ein Gold-Set aufbauen
- Schritt 2: Die AI auf demselben Set laufen lassen
- Schritt 3: Die Übereinstimmung richtig messen
- Schritt 4: Die Lücken schließen, dann erneut testen
- Schritt 5: Weiter kalibrieren
- Fairness: Menschen zu bewerten ist etwas anderes als Tickets zu bewerten
- AI QA Schritt für Schritt einführen
- Häufige Fallstricke