サポートのためのAI品質保証:すべての会話をスコアリングする
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
サポートのAI品質保証(AI QA)とは、レビュー担当者が手作業で選んだ少数のサンプルを採点する代わりに、言語モデルを使って、人間の担当者が対応したすべての顧客との会話を、文書化した評価基準に沿ってスコアリングする取り組みです。 モデルはトランスクリプトを読み、評価基準の質問(担当者は本当の問題を特定したか。解決策は正しかったか。トーンは適切だったか)に答え、担当者、チーム、トピック、週ごとに切り分けられるスコアを出力します。
魅力はカバレッジです。手作業のQAプログラムは、レビュー担当者の持ち時間の分しかチケットを読めないため、最悪の会話を含む大半の会話は、一度も目を通されません。AIならすべてを読めます。ただし、すべてを読むことと、正しく読むことは同じではなく、担当者が信頼しないスコアは、スコアがないより悪い結果を招きます。そこでこのガイドでは、AI QAの仕組み、人間のレビュー担当者とのキャリブレーション、公平性の保ち方という3点を取り上げます。AI for Customer Serviceコレクションの一部なので、より広い文脈を知りたい方は、カスタマーサービスにおけるAIの概要から始めるとよいでしょう。
重要なポイント
- ZendeskのQA製品は「AutoQAによる100%のカバレッジ」をうたい、チケットを手作業で選ぶのをやめて、すべてのやり取りを分析するよう呼びかけています(Zendesk)。これはカバレッジに関するベンダーの主張であり、精度に関するものではありません。
- Zendesk自身の設定ドキュメントには、自動評価は参考情報にすぎず、業績に関する判断には使うべきではなく、人間による業績評価を置き換えるのではなく補完するものだと記載されています(Zendesk)。
- Cohenのカッパ係数は、偶然を超えた一致度を測ります。広く引用されているMcHughの解釈では、0.60〜0.79が中程度の一致、0.80〜0.90が強い一致、0.90を超えるとほぼ完全な一致です(McHugh, Biochemia Medica, 2012)。
- LLMを審査役にする研究では、強力なモデルは人間の選好と80%を超える一致率に達しうることが示されました。これは人間同士が一致する割合と同じです。一方で、位置バイアス、冗長性バイアス、自己強化バイアスも報告されています(Zheng et al., 2023)。
- EU AI Actでは、労働者の業績と行動を監視、評価するために使われるAIシステムは、附属書III第4項(b)でハイリスクに分類されています(EU AI Act, Annex III)。
AI QAの仕組み
従来のQAは、途中にボトルネックのあるループです。QAアナリストがチケットを選び、1件ずつ開いてスコアカードで採点し、コメントを書いて、担当者にフィードバックを送ります。アナリストの時間は限られているため、サンプルは小さいままで、しかもサンプリングが無作為であることはまれです。エスカレーションされたチケット、CSATが低かったチケット、たまたま短いチケットが、レビューされやすくなります。
AI QAは、スコアカードはそのままに、アナリストが読む工程を置き換えます。パイプラインは次のようになります。
- Ingest。 チャット、メール、音声のトランスクリプト、チケットからの会話が、メタデータ(チャネル、トピック、担当者、顧客ティア、結果)とともに流れ込みます。
- Analyze。 モデルが各会話を読み、評価基準の各質問に答えます。通常は、トランスクリプトから引用した短い根拠が付きます。
- Score。 回答が会話のスコアにまとめられ、さらに担当者、チーム、トピックのビューに集計されます。
- Route。 スコアが低い、またはリスクの高い会話は、人間のレビュー担当者に回されます。優れた会話は、コーチング用のライブラリに回されます。
この最後のステップがあるため、これはACE Frameworkのスコアリングとルーティングのパターンに属します。モデルは採点するだけでなく、どの会話を人が見るべきかも決めます。うまくいけば、人間のレビュー担当者は、判断の要らない95%ではなく、判断の必要な5%に時間を使えます。
Zendesk QAの自動スコアリングには、Greeting、Empathy、Spelling and grammar、Closing、Solution offered、Tone、Readability、Comprehensionといったデフォルトのカテゴリが用意されています。単純なはい・いいえのチェックもあれば、Toneは重み付きのスコアで、Readabilityは固定の3段階です(Zendesk)。「担当者は顧客に挨拶したか」はほぼ機械的に判定できます。「担当者は顧客の問題を理解したか」には判断が必要です。この違いが、この記事の残りの部分を方向づけます。
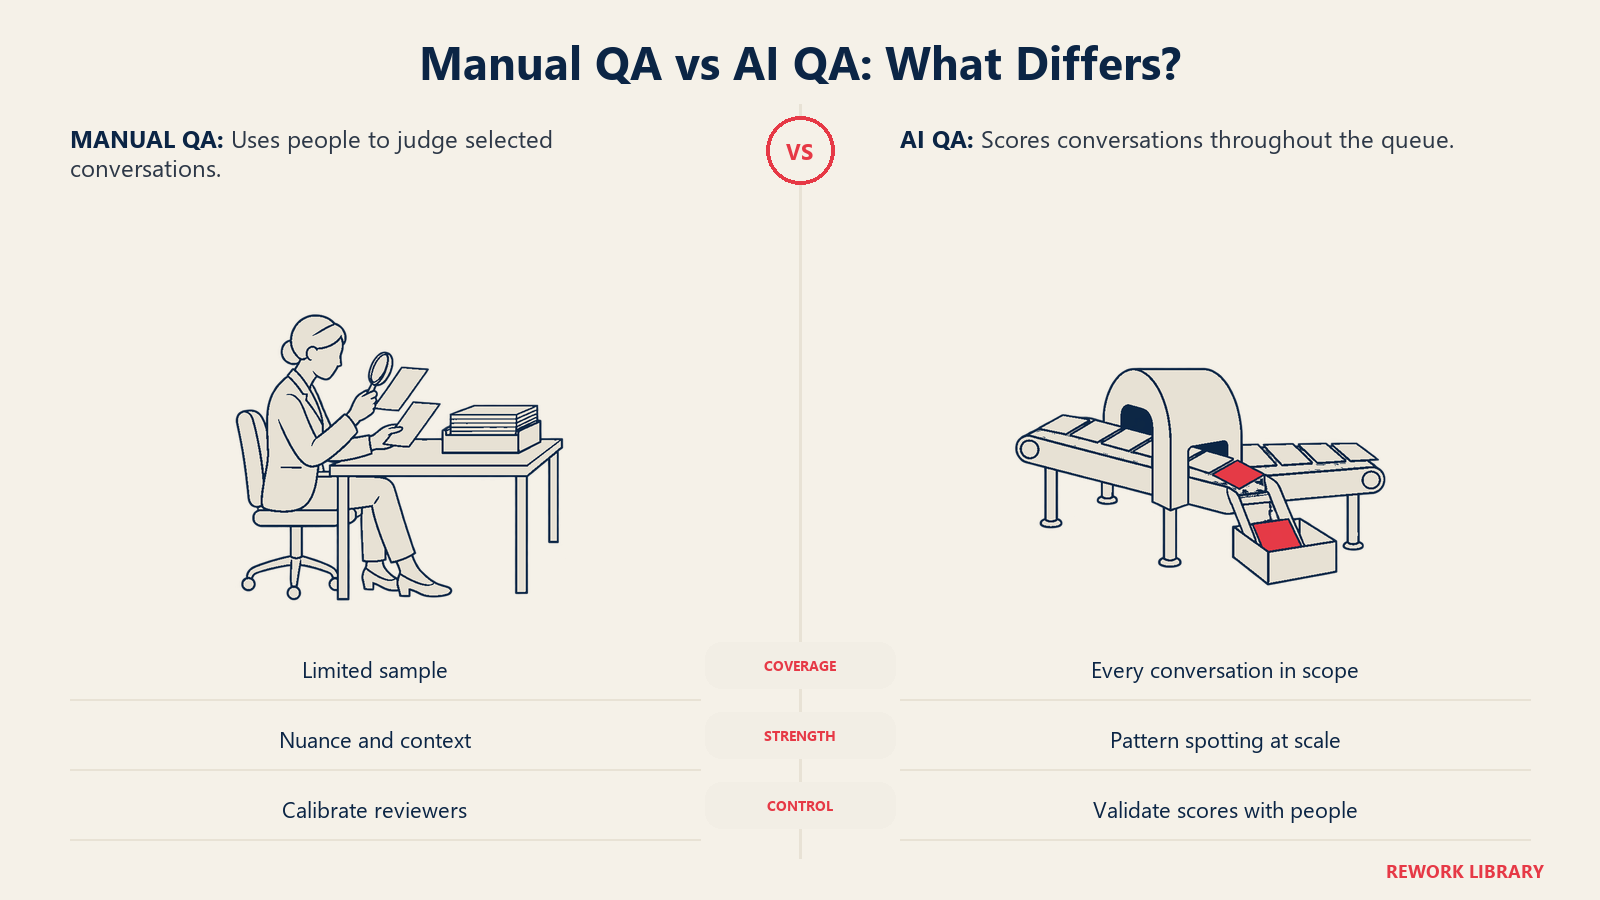
手作業のQAとAI QA
| 観点 | 手作業のQA | AI QA |
|---|---|---|
| カバレッジ | 人が選んだサンプル | 対象範囲のすべての会話 |
| 一貫性 | レビュー担当者や気分によって変わる | 毎回同じプロンプト、同じ評価基準(ただし、答えが常に同じとは限らない) |
| 得意なこと | ニュアンス、文脈、ポリシーの例外、共感 | パターンの発見、機械的なチェック、外れ値の検出 |
| 苦手なこと | 規模、速度、まれな問題の発見 | 見えない文脈、皮肉、明文化されていないポリシー |
| 典型的な失敗 | サンプリングバイアス、レビュー担当者のドリフト | 自信に満ちた誤ったスコア、内容より文体を優遇する偏り |
正直な結論はこうです。どちらも、もう一方の代わりにはなりません。AIは幅広さを、人間はグラウンドトゥルース(正解データ)を提供し、両者をつなぐのが、以下で説明するキャリブレーションのプロセスです。
職種別の実例
評価基準は、会話が行われる場所によって変わります。具体的なケースをいくつか挙げます。
ティア1のカスタマーサポート。 顧客が二重請求について問い合わせてきます。評価基準では、担当者が本人確認を行い、重複を見つけ、返金のタイムラインを説明し、ポリシーで禁じられていることを約束しなかったかを確認します。AIは最後のチェックが得意です。「保証します」のような表現を使った、または現行のポリシーと合わない返金期間を伝えた会話を、すべて検出できます。
請求と債権回収。 コンプライアンスが最も重要です。評価基準には、冒頭での開示を必須とし、特定の脅しを禁止する項目が入るかもしれません。AI QAならすべての会話で両方を確認できますが、手作業のサンプルでは、見つかるかどうかは運次第です。
テクニカルサポート。 診断の自動採点は、より難しいものです。絶対的な評点よりも、「顧客が1週間以内に同じ問題で再び連絡してきたら、レビュー対象にする」というほうがうまくいくことが多くあります。
社内ITヘルプデスク。 「顧客」は従業員であり、評価基準は解決の質と、担当者が適切な記事を案内したかに重点が置かれます。これは、サポートデータの不足も明らかにします。
評価基準の設計
モデルの性能は、投げかける質問の質で決まります。AI QAプログラムの失敗の大半は、モデルではなく評価基準で起きています。
実用的なスコアカードの基準は4〜8個で、それぞれがあいまいな資質ではなく、観察可能で答えられる質問として書かれています。「担当者は共感的だったか」と、「担当者は解決策に移る前に、顧客が述べた問題を認めたか」を比べてみてください。後者はトランスクリプトから確認でき、2人のレビュー担当者が一致する可能性もはるかに高くなります。
| 基準 | 弱い表現 | 強い表現 | 種類 |
|---|---|---|---|
| 理解 | 「顧客を理解した」 | 「修正案を提示する前に、顧客の実際の問題を言い換えるか確認した」 | はい / いいえ |
| 正確さ | 「良い回答をした」 | 「示された解決策やポリシーが、現行のナレッジベース記事と一致している」 | はい / いいえ / 判断できない |
| プロセス | 「手順に従った」 | 「アカウントの詳細を共有する前に本人確認を行った」 | はい / いいえ / 不要 |
| トーン | 「プロフェッショナルだった」 | 「顧客に対して、見下したり責めたりする言葉がない」 | はい / いいえ |
| クロージング | 「うまく締めくくった」 | 「次のステップと担当者を伝えた、または、それ以上は不要であることを確認した」 | はい / いいえ |
2つの設計上の選択が効果を生みます。1つ目は、必ず「判断できない」または「該当なし」を許可することです。はいかいいえかを強制されたモデルは推測し、足りない文脈についての推測が、不公平なスコアの原因になります。2つ目は、顧客が実際に感じることに応じて基準に重みを付けることです。正しい解決は、スペルミスより重くあるべきです。
キャリブレーション:スコアを信頼できるものにする
キャリブレーションは、人が議論するだけのダッシュボードと、実際に使うダッシュボードを分けるステップです。考え方は単純です。人間とAIに同じ会話をスコアリングさせ、どのくらいの頻度で一致するかを測り、差を埋めます。
ステップ1:ゴールドセットを作る
チャネル、トピック、難易度の幅をカバーする100〜200件の会話を選びます。簡単なもの、あいまいなもの、すでにうまくいかなかったとわかっているものを含めてください。経験豊富なレビュー担当者が少なくとも2人、それぞれ独立して各会話を採点し、その後で集まって意見の違いを解消します。その結果が、合意した答えのある「ゴールドセット」です。その過程で生じた意見の違いも、評価基準のどこがあいまいかを示すため、それだけで価値があります。
ステップ2:同じセットでAIを実行する
ゴールドセットをモデルでスコアリングします。合計点だけでなく、基準ごとに比較してください。合計は問題なく見えても、たとえば「正確さ」の1基準が、半分の確率でひそかに誤っていることがあります。
ステップ3:一致度を正しく測る
単純な一致率は誤解を招きます。2人の評価者がどちらもほとんどの場合「合格」と言うなら、偶然でも頻繁に一致するからです。偶然の一致を割り引くCohenのカッパ係数を使います。なぜ重要かを示す仮の例を挙げます。
| AIが合格 | AIが不合格 | 合計 | |
|---|---|---|---|
| レビュー担当者が合格 | 70 | 10 | 80 |
| レビュー担当者が不合格 | 10 | 10 | 20 |
| 合計 | 80 | 20 | 100 |
100件の会話のうち80件で2人は一致しているので、単純な一致率は80%です。しかし、両方の評価者が会話の約80%を合格にするなら、偶然だけでも約68%の確率で一致します。カッパ係数は(0.80から0.68を引いた値)を(1から0.68を引いた値)で割ったもので、約0.38です。McHughの尺度では弱い一致であり(McHugh, 2012)、見出しの数字は80%でもそうなります。AIの「一致」の大半は、両者がただ合格と言っただけでした。
基準ごとにカッパ係数を計算し、人間のレビュー担当者同士でも計算してください。この2つ目の数値が上限です。最も優秀な2人のレビュー担当者の間で0.65しか出ないのに、AIに0.9を期待するのは非現実的で、本当の対策は、より明確な評価基準です。LLMを審査役にする研究も同じ方向を指しています。強力なモデルは、人間同士が一致する割合に並びうるということで、それは有用な目標ですが、魔法の数字ではありません(Zheng et al., 2023)。
ステップ4:差を埋めて、再テストする
一致度が低いところには、3つの手段があります。基準をより具体的に書き直す、プロンプトに具体例(「良い」トランスクリプトと「悪い」トランスクリプト)を追加する、または、その基準を自動スコアリングから外して人間だけで行うことです。本物の共感のように、許容できる一致度に決して届かない基準もあるでしょう。AIが確実にスコアリングできるものを採点し、残りは人に任せてください。
ステップ5:キャリブレーションを続ける
毎週または毎月の定例セッションを設けます。レビュー担当者が、AIのスコアを見ずに新しい無作為のサンプルを採点し、カッパ係数を継続的に追跡します。数値が下がるのは、新しい製品ライン、ポリシーの更新、新しい言語といった変化が起きたことを知らせる早期警告です。多言語サポートを運用しているなら、言語ごとにキャリブレーションしてください。英語での一致度は、ポルトガル語については何も教えてくれません。
公平性:人を採点することは、チケットを採点することとは違う
QAスコアは単なるデータではありません。コーチング、ボーナス、ときには業績評価にも使われます。そのため、誤りやバイアスのリスクが高まり、多くのチームが計画不足になっているのがこの部分です。
既知のバイアスを知る。 LLMを審査役にする文献では、位置バイアス、冗長性バイアス(長い回答が優遇される)、自己強化バイアスが報告されています(Zheng et al., 2023)。サポートでは、冗長性バイアスはそのまま次のような形で現れます。長く、きれいに整えた返信を書く担当者が、2行の簡潔な文章で問題を解決する担当者より高いスコアを取りうるのです。結果をそろえたうえで、スコアがメッセージの長さと相関していないかを確認して、検証してください。
グループ間の差を確認する。 在籍期間、シフト、言語、地域、問い合わせの種類ごとにスコアを比較します。実際の差もあります。一方で、評価基準が母語でない人の言い回しにペナルティを与えていたり、より難しいキューを反映していたりすることもあります。請求トラブルを担当する担当者のスコアがパスワードリセットの担当者より低いなら、モデルが品質ではなく難易度を採点しているのかもしれません。人を比較する前に、トピックごとに正規化してください。
担当者に対して透明にする。 評価基準を公開します。担当者が、正確な基準、自分のスコア、それぞれの判定のきっかけとなった引用箇所を見られるようにしてください。人は、理由が見えれば低いスコアも受け入れます。説明のないまま現れる数字には抵抗します。
異議申し立ての経路を設ける。 どの担当者も、スコアに異議を唱え、決められた期間内に人間に確認してもらえるようにします。覆された割合を追跡してください。ある基準で覆される割合が高いなら、その基準は自動化の準備ができていません。覆された事例は、ゴールドセットに戻します。
判断には人を関与させる。 ベンダー自身もそう言っています。Zendeskのドキュメントには、自動評価は参考情報にすぎず、人間による業績評価を置き換えるのではなく補完するものだと記載されています(Zendesk)。AIのスコアは、どの会話を人が読むかを決めるために使い、給与や雇用に影響することは、人の判断で決めてください。
規制の方向性を知る。 EUでは、労働者の業績と行動を監視、評価することを目的としたAIシステムは、AI Actのハイリスク一覧の附属書IIIに載っており(EU AI Act, Annex III)、第14条は、そうしたシステムを監督する人が、出力に過度に依存する傾向、いわゆる自動化バイアスを意識し続けることを求めています(EU AI Act, Article 14)。自社の管轄については法務の担当者に確認してください。また、国によっては、労使協議会や従業員の監視に関する法律が、独自の要件を加えることにも留意してください。
AI QAを段階的に導入する方法
- 目的を定義する。 コーチング、コンプライアンス、顧客体験では、必要な評価基準が異なります。まず1つから始めます。
- 評価基準を書く。 マネージャーだけでなく担当者とともに、観察可能な4〜8個の基準を作り、「判断できない」を許可します。
- 導入前にキャリブレーションする。 上記のとおり、ゴールドセットを作り、基準ごとにカッパ係数を確認します。
- シャドーモードで運用する。 数週間、現在のQAと並行して、担当者にスコアを見せずに、または「ベータ版、評価には使用しません」と表示して運用します。
- スコアの使い方を文書にする。 コーチングのトピックやレビュー対象のチケットの選定は使ってよい用途です。ボーナスや懲戒は、信頼が築かれるまで使いません。
- 報告するだけでなく、ルーティングする。 低スコア、コンプライアンス上のフラグ、異議申し立ては、人間のキューに回します。際立った会話は、お手本としてコーチングのワークフローに回します。
- 担当者とループを閉じる。 初日から、引用した根拠と異議申し立てのボタンを添えて結果を示します。
- スタックにつなげる。 QAの結果は、リアルタイムの提案やナレッジ記事がどこでうまく機能していないかを示します。顧客向けボットの測定については、AIの解決率をご覧ください。
- 四半期ごとに見直す。 ゴールドセットを再実行し、カッパ係数とグループ間のスコア差を確認し、基準として通用しないものは廃止します。
何を人の手に残すかをまだ決めかねているなら、自動化か支援かがその判断の枠組みを示し、AIがサポートチームの役割をどう変えるかでは、QAアナリストがどうなるかを扱っています。多くの場合、チケットを採点する役割から、評価基準、ゴールドセット、キャリブレーションを担う役割へ移ります。
よくある落とし穴
カバレッジを精度と取り違える。 「すべての会話をスコアリングした」は、そのスコアが正しいかどうかについて何も語りません。自社の会話での、人間のレビュー担当者との一致度の数値を求めてください。
重要なことではなく、簡単なことを採点する。 挨拶で98%、正しい解決で60%というチームは、品質の成功ではなく、測定の問題を抱えています。
「判断できない」を省く。 これがないと、モデルは、見たことのないアカウントの状態のように、トランスクリプトに文脈が足りないとき、答えをでっち上げます。
素のスコアで人を順位付けする。 難しいキューを担当する担当者が罰せられます。トピックの中で比較し、差は調べるべき問いとして扱ってください。
一度きりのキャリブレーション。 製品やポリシーが変わるにつれて、一致度は低下します。再キャリブレーションを予定に組み込んでください。
担当者にスキルではなくスコアを教える。 共感のフレーズがスコアを上げるなら、共感のフレーズが増えるだけです。人間によるレビューを組み合わせ続けてください。
ナレッジの不足を担当者のせいにする。 正確さのスコアが低い原因の多くは、古いヘルプ記事にたどり着きます。人をコーチングする前に、元を直してください。
サポートのAI品質保証に関するよくある質問
カスタマーサポートのAI品質保証とは何ですか?
少数のサンプルを手作業でレビューする代わりに、言語モデルを使って、人間の担当者が対応したすべての会話を、文書化した評価基準に沿ってスコアリングする取り組みです。スコアは担当者、チーム、トピックごとに表示され、スコアが低い会話やリスクのある会話は、人間のレビュー担当者に回されます。
AI QAは人間のQAレビュー担当者の代わりになりますか?
完全にはなりません。AIはカバレッジと機械的なチェックが得意で、人間はニュアンス、文脈、ポリシーの例外に優れています。Zendeskのドキュメントには、自動評価は人間による業績評価を置き換えるのではなく補完するものだと記載されています。多くのチームは、レビュー担当者の役割を、キャリブレーション、異議申し立て、より難しい基準へと移しています。
AIのスコアが人間のレビュー担当者と一致しているかは、どう確認すればよいですか?
2人以上のレビュー担当者が採点した100〜200件の会話でゴールドセットを作り、同じセットでAIを実行して、単純な一致率ではなくCohenのカッパ係数を使って基準ごとに比較します。レビュー担当者同士の一致度も測ってください。それがAIにとって現実的な上限だからです。
QAのキャリブレーションで、良いカッパ係数はどのくらいですか?
McHughの解釈では、0.60〜0.79が中程度、0.80〜0.90が強い一致、0.90を超えるとほぼ完全な一致です。担当者の評価に影響する基準では、強い一致を目指してください。どのチケットを読むかを選ぶだけに使う基準であれば、中程度の一致でも許容できる場合があります。
AI QAを担当者に公平に運用するには、どうすればよいですか?
評価基準を公開し、各スコアの根拠となる引用を担当者に示し、同じトピックやキューの中で人を比較し、長い返信を優遇するといったバイアスを検証し、すべての担当者に異議申し立ての手段を用意します。給与や雇用に影響する判断には、人間を関与させてください。
AIが会話をスコアリングすることを、担当者に伝えるべきですか?
はい。透明性は公平であるだけでなく実用的でもあり、評価基準を理解した担当者は、より早く成長し、異議申し立ても減ります。事業を行う地域によっては、従業員の監視やAIに関するルール、たとえばEU AI Actが労働者評価システムをハイリスクとして扱うことにより、開示が義務づけられる場合もあるため、法務の担当者に確認してください。
