QA con IA para soporte: puntuar cada conversación
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
El aseguramiento de calidad con IA (QA con IA) para soporte es la práctica de usar un modelo de lenguaje para puntuar, según una rúbrica escrita, cada conversación con un cliente que atiende un agente humano, en lugar de pedir a un revisor que califique una pequeña muestra elegida a mano. El modelo lee la transcripción, responde las preguntas de la rúbrica (¿identificó el agente el problema real? ¿Fue correcta la solución? ¿Fue apropiado el tono?) y produce una puntuación que usted puede desglosar por agente, equipo, tema o semana.
El atractivo es la cobertura. Un programa de QA manual solo puede leer tantos tickets como horas tengan sus revisores, así que la mayoría de las conversaciones, incluidas algunas de las peores, nunca se revisan. La IA puede leerlas todas. Pero leerlo todo no es lo mismo que leerlo correctamente, y una puntuación en la que los agentes no confían es peor que no tener ninguna. Por eso esta guía cubre tres cosas: cómo funciona el QA con IA, cómo calibrarlo frente a revisores humanos y cómo mantenerlo justo. Forma parte de la colección AI for Customer Service, así que la visión general de la IA en el servicio al cliente es un buen punto de partida si quiere el contexto más amplio.
Datos clave
- El producto de QA de Zendesk anuncia «100% de cobertura con AutoQA» e invita a los equipos a dejar de seleccionar tickets manualmente y a analizar cada interacción (Zendesk). Es una afirmación del proveedor sobre la cobertura, no sobre la precisión.
- La propia documentación de configuración de Zendesk dice que sus evaluaciones automáticas son solo orientativas, que no deben usarse para decisiones de desempeño y que deben complementar, no reemplazar, las evaluaciones de desempeño humanas (Zendesk).
- El kappa de Cohen mide el acuerdo más allá del azar. En la interpretación de McHugh, ampliamente citada, de 0,60 a 0,79 es un acuerdo moderado, de 0,80 a 0,90 es fuerte y por encima de 0,90 es casi perfecto (McHugh, Biochemia Medica, 2012).
- Una investigación sobre LLM como jueces halló que los modelos potentes pueden alcanzar más de 80% de acuerdo con las preferencias humanas, la misma tasa con la que los humanos coinciden entre sí, pero también documentó sesgos de posición, de verbosidad y de autopreferencia (Zheng et al., 2023).
- Según el EU AI Act, los sistemas de IA usados para supervisar y evaluar el desempeño y el comportamiento de los trabajadores figuran como de alto riesgo en el Anexo III, punto 4(b) (EU AI Act, Annex III).
Cómo funciona el QA con IA
El QA tradicional es un ciclo con un cuello de botella en el medio. Un analista de QA elige tickets, abre cada uno, lo puntúa con un scorecard, escribe comentarios y envía la retroalimentación al agente. Como el tiempo del analista es fijo, la muestra sigue siendo pequeña, y el muestreo rara vez es aleatorio. Las personas tienden a revisar los tickets que se escalaron, que recibieron un CSAT bajo o que resultan ser cortos.
El QA con IA conserva el scorecard y reemplaza el paso de lectura del analista. El flujo es así:
- Ingest. Las conversaciones de chat, correo, transcripciones de voz y tickets llegan con metadatos: canal, tema, agente, nivel del cliente, resultado.
- Analyze. Un modelo lee cada conversación y responde cada pregunta de la rúbrica, normalmente con una breve justificación citada de la transcripción.
- Score. Las respuestas se consolidan en una puntuación por conversación y luego en vistas por agente, equipo y tema.
- Route. Las conversaciones de baja puntuación o alto riesgo pasan a un revisor humano. Las excepcionales pasan a una biblioteca de coaching.
Ese último paso es la razón por la que esto pertenece al patrón de puntuación y enrutamiento del ACE Framework: el modelo no solo califica, también decide qué conversaciones debe mirar una persona. Si se hace bien, sus revisores humanos dedican sus horas al 5% que necesita criterio en lugar de al 95% que no.
La puntuación automática de Zendesk QA incluye categorías predeterminadas como Saludo, Empatía, Ortografía y gramática, Cierre, Solución ofrecida, Tono, Legibilidad y Comprensión. Algunas son simples comprobaciones de sí o no, Tono es una puntuación ponderada y Legibilidad es una escala fija de tres puntos (Zendesk). «¿Saludó el agente al cliente?» es casi mecánico. «¿Entendió el agente el problema del cliente?» requiere criterio. Esa diferencia determina el resto de este artículo.
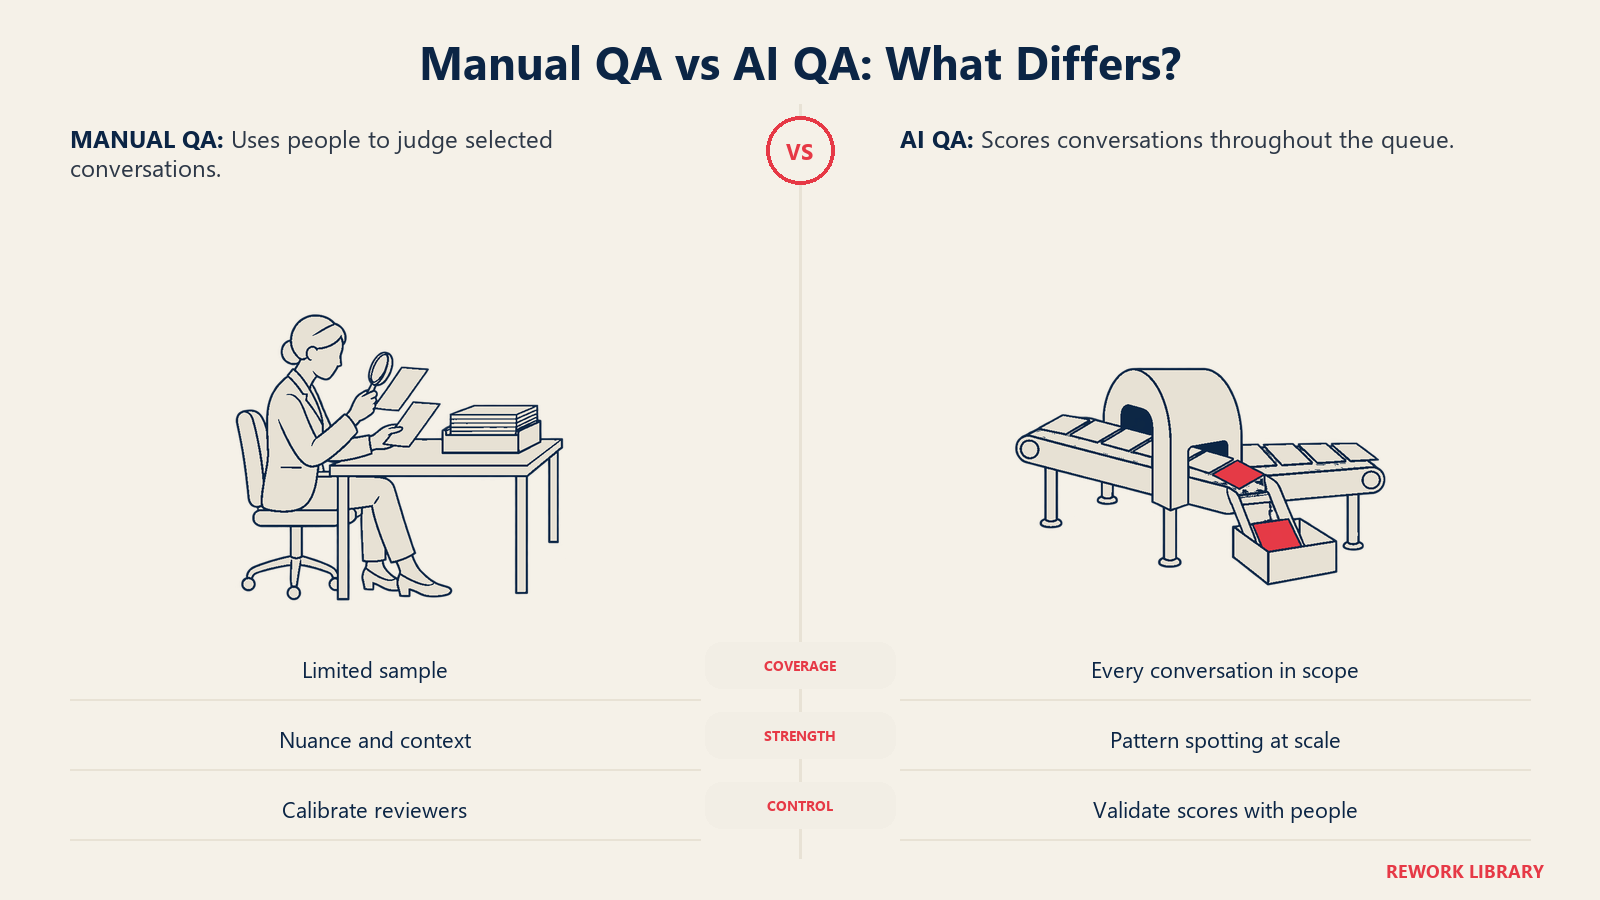
QA manual frente a QA con IA
| Dimensión | QA manual | QA con IA |
|---|---|---|
| Cobertura | Una muestra, elegida por una persona | Todas las conversaciones dentro del alcance |
| Consistencia | Varía según el revisor y su estado de ánimo | El mismo prompt y la misma rúbrica cada vez (aunque no siempre la misma respuesta) |
| Mejor en | Matices, contexto, excepciones de política, empatía | Detectar patrones, comprobaciones mecánicas, encontrar casos atípicos |
| Débil en | Escala, velocidad, detectar problemas poco frecuentes | El contexto que no puede ver, el sarcasmo, la política no escrita |
| Fallo típico | Sesgo de muestreo, deriva del revisor | Puntuaciones erróneas dichas con seguridad, sesgo a favor del estilo sobre el fondo |
La conclusión honesta: ninguno reemplaza al otro. La IA le da amplitud, las personas le dan ground truth (datos de referencia), y el proceso de calibración que se describe más abajo es lo que los conecta.
Ejemplos reales por función
La rúbrica cambia según dónde ocurre la conversación. Algunos casos concretos:
Soporte al cliente de nivel 1. Un cliente escribe por un cobro duplicado. La rúbrica comprueba que el agente verificó la identidad, encontró el duplicado, explicó el plazo del reembolso y no prometió algo que la política prohíbe. La IA es buena en la última comprobación: puede marcar cada conversación en la que un agente usó una frase como «garantizado» o citó un plazo de reembolso que no coincide con la política vigente.
Facturación y cobranza. Aquí lo más importante es el cumplimiento. La rúbrica podría exigir una divulgación al comienzo y prohibir ciertas amenazas, y el QA con IA puede comprobar ambas cosas en cada conversación, mientras que una muestra manual las detectaría por casualidad.
Soporte técnico. El diagnóstico es más difícil de calificar automáticamente. A menudo funciona mejor como «marcar para revisión si el cliente volvió en una semana por el mismo problema» que como una calificación absoluta.
Mesa de ayuda de TI interna. El «cliente» es un empleado, y las rúbricas se apoyan en la calidad de la resolución y en si el agente señaló el artículo correcto, lo que también deja al descubierto lagunas en sus datos de soporte.
Diseñar la rúbrica
El modelo es tan bueno como la pregunta que usted le hace. La mayoría de los programas de QA con IA que fracasan fallan en la rúbrica, no en el modelo.
Un scorecard viable tiene de cuatro a ocho criterios, cada uno redactado como una pregunta observable y que se puede responder, no como un rasgo vago. Compare «¿Fue empático el agente?» con «¿Reconoció el agente el problema que planteó el cliente antes de pasar a una solución?». La segunda se puede comprobar en la transcripción, y es mucho más probable que dos revisores coincidan en ella.
| Criterio | Redacción débil | Redacción sólida | Tipo |
|---|---|---|---|
| Comprensión | «Entendió al cliente» | «Reformuló o confirmó el problema real del cliente antes de proponer una solución» | Sí / No |
| Precisión | «Dio una buena respuesta» | «La solución o política indicada coincide con el artículo vigente de la base de conocimiento» | Sí / No / No se puede saber |
| Proceso | «Siguió el procedimiento» | «Verificó la identidad antes de compartir los datos de la cuenta» | Sí / No / No aplica |
| Tono | «Profesional» | «Sin lenguaje despectivo ni acusatorio hacia el cliente» | Sí / No |
| Cierre | «Cerró bien» | «Indicó el siguiente paso y quién es responsable, o confirmó que no hacía falta nada más» | Sí / No |
Dos decisiones de diseño dan resultado. Primero, permita siempre «no se puede saber» o «no aplica». Un modelo obligado a elegir sí o no adivinará, y las conjeturas sobre contexto que falta son el origen de las puntuaciones injustas. Segundo, pondere los criterios según lo que los clientes realmente perciben. La resolución correcta debe pesar más que un descuido ortográfico.
Calibración: hacer creíble la puntuación
La calibración es el paso que separa un dashboard que la gente discute de uno que la gente usa. La idea es simple: pida a humanos y a la IA que puntúen las mismas conversaciones, mida con qué frecuencia coinciden y corrija las diferencias.
Paso 1: construya un conjunto de referencia (gold set)
Elija de 100 a 200 conversaciones que cubran sus canales, temas y niveles de dificultad. Incluya algunas fáciles, algunas ambiguas y algunas que usted ya sabe que salieron mal. Pida a al menos dos revisores con experiencia que puntúen cada una de forma independiente y luego reúnalos para resolver los desacuerdos. El resultado es un «gold set» con respuestas acordadas, y los desacuerdos que tuvieron por el camino son valiosos por sí mismos, porque muestran dónde su rúbrica es vaga.
Paso 2: ejecute la IA sobre el mismo conjunto
Puntúe el gold set con el modelo. Compare criterio por criterio, no solo la puntuación total. Un total puede verse bien mientras un criterio, por ejemplo «Precisión», se equivoca en silencio la mitad de las veces.
Paso 3: mida el acuerdo como corresponde
El porcentaje bruto de acuerdo engaña, porque dos evaluadores que casi siempre dicen «aprobado» coincidirán a menudo por azar. Use el kappa de Cohen, que descuenta el acuerdo por azar. Este es un ejemplo hipotético para mostrar por qué importa:
| La IA dice aprobado | La IA dice reprobado | Total | |
|---|---|---|---|
| El revisor dice aprobado | 70 | 10 | 80 |
| El revisor dice reprobado | 10 | 10 | 20 |
| Total | 80 | 20 | 100 |
Los dos coinciden en 80 de 100 conversaciones, así que el acuerdo bruto es de 80%. Pero si ambos aprueban cerca de 80% de las conversaciones, coincidirían alrededor de 68% de las veces solo por suerte. El kappa es (0,80 menos 0,68) dividido entre (1 menos 0,68), es decir, aproximadamente 0,38. En la escala de McHugh eso es un acuerdo débil (McHugh, 2012), aunque el titular diga 80%. La mayor parte del «acuerdo» de la IA fue simplemente que ambos dijeron aprobado.
Calcule el kappa para cada criterio y también para los revisores humanos entre sí. Ese segundo número es su techo. Si sus dos mejores revisores solo llegan a 0,65 entre ellos, esperar que la IA alcance 0,9 es poco realista, y la solución real es una rúbrica más clara. La investigación sobre LLM como jueces apunta en la misma dirección: los modelos potentes pueden igualar la tasa con la que los humanos coinciden entre sí, que es un objetivo útil, no mágico (Zheng et al., 2023).
Paso 4: corrija las diferencias y vuelva a probar
Donde el acuerdo es bajo, tiene tres palancas: reescribir el criterio para hacerlo más concreto, añadir ejemplos resueltos (una transcripción «buena» y una «mala») al prompt, o sacar el criterio de la puntuación automática y dejarlo solo para humanos. Algunos criterios, como la empatía real, quizá nunca alcancen un acuerdo aceptable. Puntúe lo que la IA puntúa de forma fiable y deje el resto a las personas.
Paso 5: siga calibrando
Mantenga una sesión permanente semanal o mensual: un revisor califica una muestra aleatoria nueva sin conocer la puntuación de la IA, y usted sigue el kappa a lo largo del tiempo. Una cifra que baja es una alerta temprana de que algo cambió, como una nueva línea de producto, una actualización de política o un idioma nuevo. Si ofrece soporte multilingüe, calibre por idioma, porque el acuerdo en inglés no le dice nada sobre el portugués.
Equidad: puntuar a las personas no es lo mismo que puntuar tickets
Una puntuación de QA no es solo un dato. Alimenta el coaching, los bonos y a veces las evaluaciones de desempeño. Eso eleva lo que está en juego tanto para los errores como para el sesgo, y es la parte que la mayoría de los equipos planifica menos.
Conozca los sesgos conocidos. La literatura sobre LLM como juez documenta el sesgo de posición, el sesgo de verbosidad (se favorecen las respuestas más largas) y el sesgo de autopreferencia (Zheng et al., 2023). En soporte, el sesgo de verbosidad tiene una traducción directa: un agente que escribe respuestas largas y pulidas puede superar en puntuación a otro que resuelve el problema en dos líneas precisas. Compruébelo verificando si la puntuación se correlaciona con la longitud del mensaje una vez controlado el resultado.
Revise las diferencias entre grupos. Compare las puntuaciones por antigüedad, turno, idioma, región y tipo de contacto. Algunas brechas son reales. Otras muestran que la rúbrica penaliza una redacción de hablantes no nativos o una cola más difícil: si los agentes de disputas de facturación puntúan menos que los de restablecimiento de contraseñas, es posible que el modelo esté calificando la dificultad, no la calidad. Normalice por tema antes de comparar personas.
Sea transparente con los agentes. Publique la rúbrica. Deje que los agentes vean los criterios exactos, sus propias puntuaciones y el pasaje citado que motivó cada juicio. La gente acepta una puntuación baja cuando puede ver la razón. Se resiste a un número que aparece sin explicación.
Construya una vía de apelación. Cualquier agente debería poder disputar una puntuación y lograr que una persona la revise dentro de un plazo definido. Siga la tasa de revocación. Una tasa alta de revocación en un criterio significa que ese criterio no está listo para automatizarse. Devuelva los casos revocados a su gold set.
Mantenga a una persona en la decisión. Incluso los proveedores lo dicen. La documentación de Zendesk afirma que sus evaluaciones automáticas son solo orientativas y deben complementar, no reemplazar, las evaluaciones de desempeño humanas (Zendesk). Use la puntuación de la IA para decidir qué conversaciones lee una persona, y use el criterio de la persona para decidir cualquier cosa que afecte al salario o al empleo.
Conozca la dirección regulatoria. En la UE, los sistemas de IA destinados a supervisar y evaluar el desempeño y el comportamiento de los trabajadores aparecen en el Anexo III de la lista de alto riesgo del AI Act (EU AI Act, Annex III), y el artículo 14 exige que las personas que supervisan esos sistemas sean conscientes de la tendencia a confiar en exceso en su resultado, conocida como sesgo de automatización (EU AI Act, Article 14). Consulte con asesoría legal para su jurisdicción y tenga presente que los comités de empresa y las leyes de supervisión de empleados en algunos países añaden sus propios requisitos.
Implementar el QA con IA, paso a paso
- Defina el propósito. El coaching, el cumplimiento y la experiencia del cliente necesitan rúbricas distintas. Empiece por una.
- Escriba la rúbrica con los agentes, no solo con los managers: de cuatro a ocho criterios observables, con «no se puede saber» permitido.
- Calibre antes del lanzamiento. Construya el gold set y compruebe el kappa por criterio, como se explicó arriba.
- Ejecute en modo sombra durante unas semanas junto a su QA actual, sin mostrar las puntuaciones a los agentes, o etiquételas como «beta, no se usan en las evaluaciones».
- Escriba cómo pueden usarse las puntuaciones. Temas de coaching y qué tickets revisar, sí. Bonos y medidas disciplinarias, todavía no, hasta ganarse la confianza.
- Enrute, no solo reporte. Las puntuaciones bajas, las alertas de cumplimiento y las disputas van a una cola humana. Las conversaciones destacadas van al flujo de coaching como ejemplos.
- Cierre el ciclo con los agentes. Muestre los resultados con evidencia citada y un botón de apelación desde el primer día.
- Conéctelo con el resto del stack. Los hallazgos de QA muestran dónde fallan las sugerencias en tiempo real o los artículos de conocimiento. Para medir en cambio un bot de cara al cliente, vea la tasa de resolución de la IA.
- Revise cada trimestre: vuelva a ejecutar el gold set, compruebe el kappa y las brechas de puntuación entre grupos, y retire los criterios que no se sostengan.
Si todavía está decidiendo qué se queda en manos humanas, automatizar o asistir plantea esa decisión, y cómo la IA cambia los roles del equipo de soporte cubre qué sucede con los analistas de QA: por lo general pasan de puntuar tickets a ser responsables de la rúbrica, el gold set y la calibración.
Errores comunes
Confundir la cobertura con la precisión. «Todas las conversaciones puntuadas» no dice nada sobre si las puntuaciones son correctas. Pida cifras de acuerdo con revisores humanos sobre sus propias conversaciones.
Puntuar lo fácil, no lo que importa. Un equipo con 98% en saludos y 60% en resolución correcta tiene un problema de medición, no un éxito de calidad.
Omitir «no se puede saber». Sin esa opción, el modelo inventa respuestas cuando a la transcripción le falta contexto, como el estado de una cuenta que nunca vio.
Clasificar a las personas por puntuaciones brutas. Los agentes de las colas difíciles salen perjudicados. Compare dentro de cada tema y trate las brechas como preguntas por investigar.
Calibrar una sola vez. El acuerdo se deteriora a medida que cambian los productos y las políticas. Programe la recalibración.
Enseñar a los agentes la puntuación, no la habilidad. Si una frase de empatía sube la puntuación, obtendrá frases de empatía. Mantenga la revisión humana en la mezcla.
Culpar a los agentes por las lagunas de conocimiento. Muchas puntuaciones bajas de precisión se deben a artículos de ayuda desactualizados. Corrija la fuente antes de hacer coaching a la persona.
Preguntas frecuentes sobre el QA con IA para soporte
¿Qué es el aseguramiento de calidad con IA para el soporte al cliente?
Es el uso de un modelo de lenguaje para puntuar cada conversación que atienden sus agentes humanos según una rúbrica escrita, en lugar de revisar manualmente una pequeña muestra. Las puntuaciones aparecen por agente, equipo y tema, y las conversaciones de baja puntuación o riesgosas se enrutan a un revisor humano.
¿Puede el QA con IA reemplazar a los revisores de QA humanos?
No del todo. La IA es buena en cobertura y comprobaciones mecánicas, mientras que las personas son mejores en matices, contexto y excepciones de política. La documentación de Zendesk dice que sus evaluaciones automáticas deben complementar, no reemplazar, las evaluaciones de desempeño humanas. La mayoría de los equipos orienta a sus revisores hacia la calibración, las disputas y los criterios más difíciles.
¿Cómo compruebo que las puntuaciones de la IA coinciden con las de mis revisores humanos?
Construya un gold set de 100 a 200 conversaciones puntuadas por dos o más revisores, ejecute la IA sobre el mismo conjunto y compare cada criterio con el kappa de Cohen en lugar del porcentaje bruto de acuerdo. Mida también el acuerdo entre revisores, ya que ese es el techo realista para la IA.
¿Qué es una buena puntuación de kappa para la calibración de QA?
En la interpretación de McHugh, de 0,60 a 0,79 es moderado, de 0,80 a 0,90 es fuerte y por encima de 0,90 es casi perfecto. Para los criterios que afectan a las evaluaciones de los agentes, apunte a un acuerdo fuerte. Para los criterios que solo ayudan a elegir qué tickets leer, un acuerdo moderado puede ser aceptable.
¿Cómo mantengo el QA con IA justo con los agentes?
Publique la rúbrica, muestre a los agentes la evidencia citada detrás de cada puntuación, compare a las personas dentro del mismo tema o cola, compruebe sesgos como favorecer las respuestas más largas y dé a cada agente una forma de apelar. Mantenga a una persona en cualquier decisión que afecte al salario o al empleo.
¿Se debe informar a los agentes de que una IA puntúa sus conversaciones?
Sí. La transparencia es justa y también práctica, ya que los agentes que entienden la rúbrica mejoran más rápido y disputan menos. Según dónde opere, las normas de supervisión de empleados y de IA, como el tratamiento de los sistemas de evaluación de trabajadores como de alto riesgo en el EU AI Act, también pueden exigir divulgación, así que consulte con asesoría legal.

Customer Success Operations Manager
On this page
- Datos clave
- Cómo funciona el QA con IA
- QA manual frente a QA con IA
- Ejemplos reales por función
- Diseñar la rúbrica
- Calibración: hacer creíble la puntuación
- Paso 1: construya un conjunto de referencia (gold set)
- Paso 2: ejecute la IA sobre el mismo conjunto
- Paso 3: mida el acuerdo como corresponde
- Paso 4: corrija las diferencias y vuelva a probar
- Paso 5: siga calibrando
- Equidad: puntuar a las personas no es lo mismo que puntuar tickets
- Implementar el QA con IA, paso a paso
- Errores comunes