Jaminan Kualiti AI untuk Sokongan: Menskor Setiap Perbualan
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Jaminan kualiti AI (QA AI) untuk sokongan ialah amalan menggunakan model bahasa untuk menskor setiap perbualan pelanggan yang dikendalikan ejen manusia berdasarkan rubrik bertulis, dan bukannya meminta penyemak menggred sampel kecil yang dipilih sendiri. Model membaca transkrip, menjawab soalan rubrik (Adakah ejen mengenal pasti isu sebenar? Adakah penyelesaiannya betul? Adakah nadanya sesuai?) dan menghasilkan skor yang boleh anda pecahkan mengikut ejen, pasukan, topik atau minggu.
Tarikannya ialah liputan. Program QA manual hanya dapat membaca seberapa banyak tiket yang dibenarkan oleh jam kerja penyemaknya, jadi kebanyakan perbualan, termasuk sebahagian yang paling teruk, tidak pernah disemak. AI boleh membaca kesemuanya. Tetapi membaca segala-galanya tidak sama dengan membacanya dengan betul, dan skor yang tidak dipercayai ejen lebih buruk daripada tiada skor. Jadi panduan ini merangkumi tiga perkara: cara QA AI berfungsi, cara menentukurnya berbanding penyemak manusia, dan cara memastikannya adil. Ia sebahagian daripada koleksi AI for Customer Service, jadi gambaran keseluruhan AI dalam perkhidmatan pelanggan ialah titik permulaan yang baik jika anda mahukan konteks yang lebih luas.
Fakta Utama
- Produk QA Zendesk mengiklankan "100% coverage with AutoQA" dan menjemput pasukan berhenti memilih tiket secara manual serta menganalisis setiap interaksi (Zendesk). Itu dakwaan vendor tentang liputan, bukan tentang ketepatan.
- Dokumentasi tetapan Zendesk sendiri menyatakan bahawa penilaian automatiknya hanya untuk panduan, tidak patut digunakan untuk keputusan prestasi, dan patut melengkapi, bukan menggantikan, semakan prestasi oleh manusia (Zendesk).
- Kappa Cohen mengukur persetujuan melebihi kebetulan. Dalam tafsiran McHugh yang meluas dirujuk, 0.60 hingga 0.79 ialah persetujuan sederhana, 0.80 hingga 0.90 ialah kuat, dan melebihi 0.90 hampir sempurna (McHugh, Biochemia Medica, 2012).
- Penyelidikan tentang hakim LLM mendapati model yang kuat boleh mencapai persetujuan melebihi 80% dengan keutamaan manusia, kadar yang sama apabila manusia bersetuju sesama mereka, tetapi turut mendokumenkan bias kedudukan, bias kepanjangan dan bias peningkatan diri (Zheng et al., 2023).
- Di bawah EU AI Act, sistem AI yang digunakan untuk memantau dan menilai prestasi serta tingkah laku pekerja disenaraikan sebagai berisiko tinggi dalam Annex III, perkara 4(b) (EU AI Act, Annex III).
Cara QA AI Berfungsi
QA tradisional ialah gelung dengan kesesakan di tengahnya. Seorang penganalisis QA memilih tiket, membuka setiap satu, menskornya berdasarkan scorecard, menulis komen, dan menghantar maklum balas kepada ejen. Oleh sebab masa penganalisis itu tetap, sampel kekal kecil, dan pensampelan jarang sekali rawak. Orang cenderung menyemak tiket yang dieskalasi, mendapat CSAT buruk, atau kebetulan pendek.
QA AI mengekalkan scorecard dan menggantikan langkah pembacaan oleh penganalisis. Saluran prosesnya seperti berikut:
- Ingest. Perbualan daripada sembang, e-mel, transkrip suara dan tiket mengalir masuk bersama metadata: saluran, topik, ejen, peringkat pelanggan, hasil.
- Analyze. Satu model membaca setiap perbualan dan menjawab setiap soalan rubrik, lazimnya dengan justifikasi ringkas yang dipetik daripada transkrip.
- Score. Jawapan digabungkan menjadi skor perbualan, kemudian menjadi paparan mengikut ejen, pasukan dan topik.
- Route. Perbualan berskor rendah atau berisiko tinggi dihantar kepada penyemak manusia. Yang cemerlang dihantar ke perpustakaan bimbingan.
Langkah terakhir itulah sebabnya ini tergolong dalam corak pemarkahan-dan-penghalaan dalam ACE Framework: model bukan sekadar menggred, ia memutuskan perbualan mana yang patut dilihat oleh seseorang. Jika dilakukan dengan baik, penyemak manusia anda menghabiskan jam mereka pada 5% yang memerlukan pertimbangan dan bukan pada 95% yang tidak.
Pemarkahan automatik Zendesk QA datang dengan kategori lalai seperti Greeting, Empathy, Spelling and grammar, Closing, Solution offered, Tone, Readability dan Comprehension. Sesetengahnya semakan ya/tidak yang mudah, Tone ialah skor berpemberat, dan Readability ialah skala tiga mata yang tetap (Zendesk). "Adakah ejen menyapa pelanggan?" hampir bersifat mekanikal. "Adakah ejen memahami isu pelanggan?" memerlukan pertimbangan. Perbezaan itu menentukan selebihnya artikel ini.
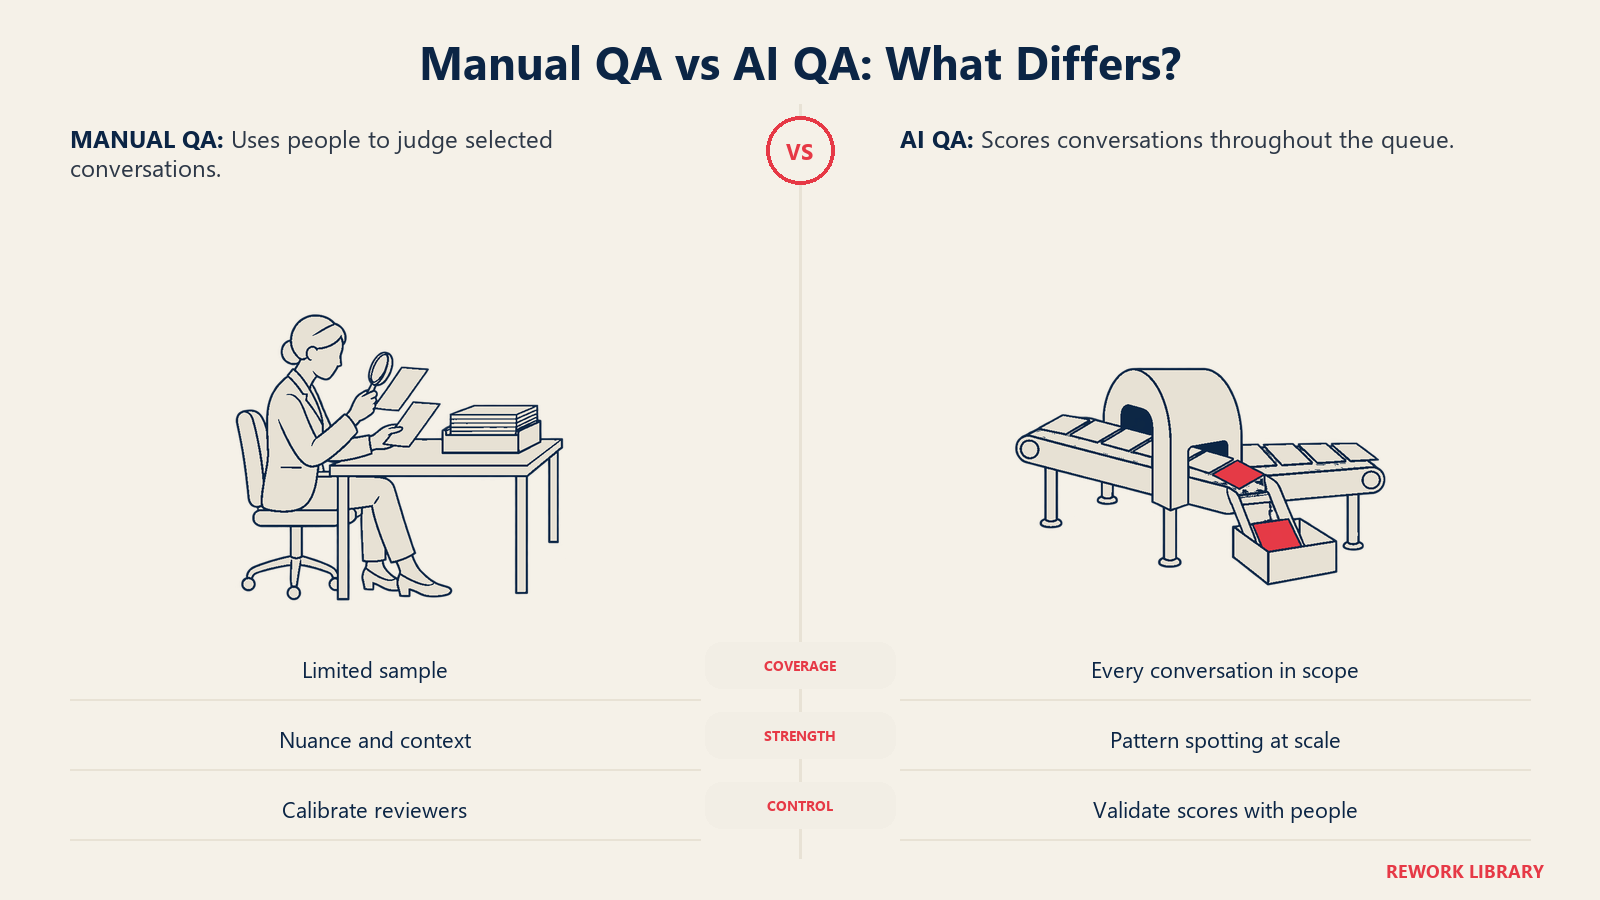
QA Manual berbanding QA AI
| Dimensi | QA manual | QA AI |
|---|---|---|
| Liputan | Satu sampel, dipilih oleh seseorang | Setiap perbualan dalam skop |
| Konsistensi | Berbeza mengikut penyemak dan suasana hati | Gesaan yang sama, rubrik yang sama setiap kali (walaupun jawapannya tidak selalu sama) |
| Paling baik dalam | Nuansa, konteks, pengecualian dasar, empati | Mengesan corak, semakan mekanikal, mencari data terpencil |
| Lemah dalam | Skala, kelajuan, mengesan masalah yang jarang berlaku | Konteks yang tidak dapat dilihatnya, sindiran, dasar yang tidak bertulis |
| Kegagalan tipikal | Bias pensampelan, hanyutan penyemak | Skor salah yang yakin, bias terhadap gaya berbanding isi |
Kesimpulan yang jujur: tiada satu pun menggantikan yang lain. AI memberi anda keluasan, manusia memberi anda ground truth (data rujukan), dan proses penentukuran yang diterangkan di bawah ialah yang menghubungkan kedua-duanya.
Contoh Sebenar Mengikut Fungsi
Rubrik berubah mengikut tempat perbualan berlaku. Beberapa kes konkrit:
Sokongan pelanggan peringkat 1. Seorang pelanggan menulis tentang caj berganda. Rubrik menyemak bahawa ejen mengesahkan identiti, menemui duplikasi itu, menerangkan garis masa bayaran balik, dan tidak menjanjikan sesuatu yang dilarang oleh dasar. AI pandai dalam semakan terakhir: ia boleh menandakan setiap perbualan di mana ejen menggunakan frasa seperti "dijamin" atau memetik tempoh bayaran balik yang tidak sepadan dengan dasar semasa.
Pengebilan dan kutipan. Pematuhan paling penting. Rubrik mungkin mewajibkan pendedahan pada permulaan dan melarang ugutan tertentu, dan QA AI boleh menyemak setiap perbualan untuk kedua-duanya, sedangkan sampel manual hanya akan menangkapnya secara kebetulan.
Sokongan teknikal. Diagnosis lebih sukar digred secara automatik. Ia selalunya lebih baik berfungsi sebagai "tandakan untuk semakan jika pelanggan kembali dalam tempoh seminggu tentang isu yang sama" daripada gred mutlak.
Meja bantuan IT dalaman. "Pelanggan" ialah seorang pekerja, dan rubrik bergantung pada kualiti penyelesaian serta sama ada ejen menunjukkan artikel yang betul, yang turut mendedahkan jurang dalam data sokongan anda.
Mereka Bentuk Rubrik
Model hanya sebaik soalan yang anda tanyakan kepadanya. Kebanyakan program QA AI yang gagal, gagal pada rubrik, bukan pada model.
Scorecard yang berfungsi mempunyai empat hingga lapan kriteria, setiap satu ditulis sebagai soalan yang boleh diperhatikan dan dijawab, bukannya sifat yang kabur. Bandingkan "Adakah ejen berempati?" dengan "Adakah ejen mengakui masalah yang dinyatakan pelanggan sebelum beralih kepada penyelesaian?" Yang kedua boleh disemak daripada transkrip, dan dua penyemak jauh lebih berkemungkinan bersetuju mengenainya.
| Kriteria | Pengucapan lemah | Pengucapan kukuh | Jenis |
|---|---|---|---|
| Pemahaman | "Memahami pelanggan" | "Menyatakan semula atau mengesahkan masalah sebenar pelanggan sebelum mencadangkan pembetulan" | Ya / Tidak |
| Ketepatan | "Memberi jawapan yang baik" | "Penyelesaian atau dasar yang dinyatakan sepadan dengan artikel pangkalan pengetahuan semasa" | Ya / Tidak / Tidak dapat dipastikan |
| Proses | "Mengikuti prosedur" | "Mengesahkan identiti sebelum berkongsi butiran akaun" | Ya / Tidak / Tidak diperlukan |
| Nada | "Profesional" | "Tiada bahasa yang meremehkan atau menyalahkan pelanggan" | Ya / Tidak |
| Penutup | "Menamatkan dengan baik" | "Menyatakan langkah seterusnya dan siapa pemiliknya, atau mengesahkan tiada lagi yang diperlukan" | Ya / Tidak |
Dua pilihan reka bentuk memberi pulangan. Pertama, sentiasa benarkan "tidak dapat dipastikan" atau "tidak berkenaan." Model yang dipaksa memilih ya atau tidak akan meneka, dan tekaan pada konteks yang tiada ialah punca skor yang tidak adil. Kedua, berikan pemberat kepada kriteria mengikut apa yang benar-benar dirasai pelanggan. Penyelesaian yang betul patut lebih berat daripada kesilapan ejaan.
Penentukuran: Menjadikan Skor Boleh Dipercayai
Penentukuran ialah langkah yang memisahkan dashboard yang dipertikaikan orang daripada yang digunakan mereka. Ideanya mudah: minta manusia dan AI menskor perbualan yang sama, kemudian ukur seberapa kerap mereka bersetuju dan baiki jurang itu.
Langkah 1: Bina set emas
Pilih 100 hingga 200 perbualan yang merangkumi saluran, topik dan tahap kesukaran anda. Sertakan beberapa yang mudah, beberapa yang kabur, dan beberapa yang anda sudah tahu berjalan buruk. Minta sekurang-kurangnya dua penyemak berpengalaman menskor setiap satu secara bebas, kemudian bermesyuarat untuk menyelesaikan percanggahan. Hasilnya ialah "set emas" dengan jawapan yang dipersetujui, dan percanggahan yang anda lalui sepanjang proses itu bernilai dengan sendirinya kerana ia menunjukkan di mana rubrik anda kabur.
Langkah 2: Jalankan AI pada set yang sama
Skor set emas itu dengan model. Bandingkan kriteria demi kriteria, bukan sekadar skor keseluruhan. Skor keseluruhan boleh kelihatan baik sementara satu kriteria, katakan "Ketepatan", senyap-senyap salah separuh daripada masa.
Langkah 3: Ukur persetujuan dengan betul
Peratusan persetujuan mentah mengelirukan, kerana dua penilai yang kebanyakan masanya sama-sama berkata "lulus" akan kerap bersetuju secara kebetulan. Gunakan kappa Cohen, yang mendiskaun persetujuan secara kebetulan. Berikut satu andaian untuk menunjukkan mengapa ia penting:
| AI kata lulus | AI kata gagal | Jumlah | |
|---|---|---|---|
| Penyemak kata lulus | 70 | 10 | 80 |
| Penyemak kata gagal | 10 | 10 | 20 |
| Jumlah | 80 | 20 | 100 |
Kedua-duanya bersetuju pada 80 daripada 100 perbualan, jadi persetujuan mentah ialah 80%. Tetapi jika kedua-dua penilai meluluskan kira-kira 80% perbualan, mereka akan bersetuju kira-kira 68% daripada masa secara kebetulan semata-mata. Kappa ialah (0.80 tolak 0.68) dibahagi (1 tolak 0.68), iaitu kira-kira 0.38. Pada skala McHugh itu ialah persetujuan yang lemah (McHugh, 2012), walaupun tajuk utamanya mengatakan 80%. Kebanyakan "persetujuan" AI hanyalah kedua-duanya berkata lulus.
Kira kappa bagi setiap kriteria, dan juga bagi penyemak manusia sesama mereka. Nombor kedua itu ialah siling anda. Jika dua penyemak terbaik anda hanya mencapai 0.65 sesama mereka, mengharapkan AI mencapai 0.9 tidak realistik, dan pembetulan sebenar ialah rubrik yang lebih jelas. Penyelidikan hakim LLM menunjukkan arah yang sama: model yang kuat boleh menyamai kadar persetujuan sesama manusia, yang merupakan sasaran yang berguna, bukan sasaran ajaib (Zheng et al., 2023).
Langkah 4: Baiki jurang, kemudian uji semula
Di mana persetujuan rendah, anda mempunyai tiga tuas: tulis semula kriteria supaya lebih konkrit, tambah contoh bekerja (transkrip "baik" dan "buruk") pada gesaan, atau keluarkan kriteria itu daripada pemarkahan automatik dan kekalkan sebagai kerja manusia sahaja. Sesetengah kriteria, seperti empati sebenar, mungkin tidak akan mencapai persetujuan yang boleh diterima. Skor apa yang AI skor dengan boleh dipercayai dan serahkan selebihnya kepada manusia.
Langkah 5: Teruskan penentukuran
Kekalkan sesi tetap mingguan atau bulanan: seorang penyemak menggred sampel rawak yang baharu tanpa mengetahui skor AI, dan anda menjejaki kappa dari semasa ke semasa. Nombor yang menurun ialah amaran awal bahawa sesuatu telah berubah, seperti barisan produk baharu, kemas kini dasar, atau bahasa baharu. Jika anda menjalankan sokongan berbilang bahasa, tentukur bagi setiap bahasa, kerana persetujuan dalam bahasa Inggeris tidak memberitahu apa-apa tentang bahasa Portugis.
Keadilan: Menskor Manusia Berbeza daripada Menskor Tiket
Skor QA bukan sekadar data. Ia menyumbang kepada bimbingan, bonus dan kadangkala semakan prestasi. Itu meningkatkan taruhan bagi ralat dan bias, dan ia ialah bahagian yang paling kurang dirancang oleh kebanyakan pasukan.
Kenali bias yang diketahui. Kepustakaan LLM-sebagai-hakim mendokumenkan bias kedudukan, bias kepanjangan (jawapan yang lebih panjang diutamakan) dan bias peningkatan diri (Zheng et al., 2023). Dalam sokongan, bias kepanjangan mempunyai terjemahan langsung: ejen yang menulis balasan panjang dan digilap boleh mengatasi skor ejen yang menyelesaikan masalah dalam dua baris yang tajam. Uji dengan menyemak sama ada skor berkorelasi dengan panjang mesej selepas anda mengawal hasil.
Semak perbezaan peringkat kumpulan. Bandingkan skor mengikut tempoh perkhidmatan, syif, bahasa, rantau dan jenis hubungan. Sesetengah jurang adalah nyata. Yang lain menunjukkan rubrik menghukum frasa penutur bukan asli atau barisan gilir yang lebih sukar: jika ejen pertikaian pengebilan menskor lebih rendah daripada ejen tetapan semula kata laluan, model mungkin sedang menggred kesukaran, bukan kualiti. Normalkan mengikut topik sebelum membandingkan manusia.
Telus dengan ejen. Terbitkan rubrik. Biarkan ejen melihat kriteria yang tepat, skor mereka sendiri, dan petikan yang mencetuskan setiap penilaian. Orang menerima skor rendah jika mereka dapat melihat sebabnya. Mereka menentang nombor yang muncul tanpa penjelasan.
Bina laluan rayuan. Mana-mana ejen patut dapat mempertikaikan skor dan meminta manusia melihatnya dalam tempoh yang ditetapkan. Jejaki kadar pembatalan. Kadar pembatalan yang tinggi pada satu kriteria bermakna kriteria itu belum bersedia untuk automasi. Masukkan semula kes yang dibatalkan ke dalam set emas anda.
Pastikan manusia terlibat dalam keputusan. Malah vendor sendiri berkata begitu. Dokumentasi Zendesk menyatakan bahawa penilaian automatiknya hanya untuk panduan dan patut melengkapi, bukan menggantikan, semakan prestasi oleh manusia (Zendesk). Gunakan skor AI untuk memutuskan perbualan mana yang dibaca oleh seseorang, dan gunakan pertimbangan orang itu untuk memutuskan apa-apa yang menjejaskan gaji atau pekerjaan.
Ketahui arah peraturan. Di EU, sistem AI yang bertujuan memantau dan menilai prestasi serta tingkah laku pekerja muncul dalam Annex III senarai berisiko tinggi AI Act (EU AI Act, Annex III), dan Article 14 mewajibkan orang yang menyelia sistem sedemikian kekal sedar tentang kecenderungan terlalu bergantung pada outputnya, yang dikenali sebagai bias automasi (EU AI Act, Article 14). Rujuk penasihat undang-undang untuk bidang kuasa anda, dan ingat bahawa majlis pekerja serta undang-undang pemantauan pekerja di sesetengah negara menambah keperluan mereka sendiri.
Melaksanakan QA AI, Langkah demi Langkah
- Tentukan tujuan. Bimbingan, pematuhan dan pengalaman pelanggan memerlukan rubrik yang berbeza. Mulakan dengan satu.
- Tulis rubrik bersama ejen, bukan hanya pengurus: empat hingga lapan kriteria yang boleh diperhatikan, dengan "tidak dapat dipastikan" dibenarkan.
- Tentukur sebelum pelancaran. Bina set emas dan semak kappa bagi setiap kriteria, seperti di atas.
- Jalankan dalam mod bayang selama beberapa minggu bersama QA semasa anda, tanpa menunjukkan skor kepada ejen, atau labelkan "beta, tidak digunakan dalam semakan".
- Tuliskan cara skor boleh digunakan. Topik bimbingan dan tiket mana yang perlu disemak, ya. Bonus dan tindakan disiplin, belum sehingga kepercayaan terbina.
- Halakan, jangan sekadar laporkan. Skor rendah, bendera pematuhan dan pertikaian pergi ke barisan gilir manusia. Perbualan yang menonjol pergi ke aliran kerja bimbingan sebagai contoh.
- Tutup gelung bersama ejen. Tunjukkan keputusan dengan bukti yang dipetik dan butang rayuan sejak hari pertama.
- Sambungkan ke tindanan anda. Penemuan QA menunjukkan di mana cadangan masa nyata atau artikel pengetahuan gagal. Untuk mengukur bot yang berhadapan dengan pelanggan, lihat kadar penyelesaian AI.
- Semak setiap suku tahun: jalankan semula set emas, semak kappa dan jurang skor antara kumpulan, gugurkan kriteria yang tidak bertahan.
Jika anda masih memutuskan apa yang kekal sebagai kerja manusia, automasikan atau bantu merangka keputusan itu, dan cara AI mengubah peranan pasukan sokongan membincangkan apa yang berlaku kepada penganalisis QA: mereka biasanya beralih daripada menskor tiket kepada memiliki rubrik, set emas dan penentukuran.
Kesilapan Lazim
Mempercayai liputan sebagai ketepatan. "Setiap perbualan diskor" tidak memberitahu apa-apa tentang sama ada skor itu betul. Minta angka persetujuan berbanding penyemak manusia pada perbualan anda sendiri.
Menskor apa yang mudah, bukan apa yang penting. Pasukan yang menskor 98% pada ucapan salam dan 60% pada penyelesaian yang betul mempunyai masalah pengukuran, bukan kejayaan kualiti.
Melangkau "tidak dapat dipastikan". Tanpanya, model mereka jawapan apabila transkrip tiada konteks, seperti keadaan akaun yang tidak pernah dilihatnya.
Meranking manusia berdasarkan skor mentah. Ejen pada barisan gilir yang sukar dihukum. Bandingkan dalam topik yang sama dan anggap jurang sebagai soalan untuk disiasat.
Penentukuran sekali sahaja. Persetujuan merosot apabila produk dan dasar berubah. Jadualkan penentukuran semula.
Mengajar ejen skor, bukan kemahiran. Jika frasa empati menaikkan skor, anda akan mendapat frasa empati. Kekalkan semakan manusia dalam gabungan itu.
Menyalahkan ejen atas jurang pengetahuan. Banyak skor ketepatan yang rendah berpunca daripada artikel bantuan yang ketinggalan zaman. Baiki sumbernya sebelum membimbing orangnya.
Soalan Lazim tentang Jaminan Kualiti AI untuk Sokongan
Apakah jaminan kualiti AI untuk sokongan pelanggan?
Ia ialah penggunaan model bahasa untuk menskor setiap perbualan yang dikendalikan ejen manusia anda berdasarkan rubrik bertulis, dan bukannya menyemak sampel kecil secara manual. Skor dipaparkan mengikut ejen, pasukan dan topik, dan perbualan berskor rendah atau berisiko dihantar kepada penyemak manusia.
Bolehkah QA AI menggantikan penyemak QA manusia?
Tidak sepenuhnya. AI baik dalam liputan dan semakan mekanikal, manakala manusia lebih baik dalam nuansa, konteks dan pengecualian dasar. Dokumentasi Zendesk menyatakan bahawa penilaian automatiknya patut melengkapi, bukan menggantikan, semakan prestasi oleh manusia. Kebanyakan pasukan mengalihkan penyemak mereka ke arah penentukuran, pertikaian dan kriteria yang lebih sukar.
Bagaimana saya menyemak bahawa skor AI sepadan dengan penyemak manusia saya?
Bina set emas yang terdiri daripada 100 hingga 200 perbualan yang diskor oleh dua atau lebih penyemak, jalankan AI pada set yang sama, dan bandingkan setiap kriteria menggunakan kappa Cohen dan bukannya peratusan persetujuan mentah. Ukur juga persetujuan antara penyemak, kerana itulah siling realistik bagi AI.
Apakah skor kappa yang baik untuk penentukuran QA?
Dalam tafsiran McHugh, 0.60 hingga 0.79 ialah sederhana, 0.80 hingga 0.90 ialah kuat dan melebihi 0.90 hampir sempurna. Bagi kriteria yang menjejaskan semakan ejen, sasarkan persetujuan yang kuat. Bagi kriteria yang hanya membantu anda memilih tiket untuk dibaca, persetujuan sederhana boleh diterima.
Bagaimana saya memastikan QA AI adil kepada ejen?
Terbitkan rubrik, tunjukkan kepada ejen bukti yang dipetik di sebalik setiap skor, bandingkan manusia dalam topik atau barisan gilir yang sama, uji bias seperti mengutamakan balasan yang lebih panjang, dan beri setiap ejen cara untuk merayu. Pastikan manusia terlibat dalam apa-apa keputusan yang menjejaskan gaji atau pekerjaan.
Perlukah ejen diberitahu bahawa AI menskor perbualan mereka?
Ya. Ketelusan adil dan juga praktikal, kerana ejen yang memahami rubrik bertambah baik dengan lebih pantas dan kurang mempertikaikan. Bergantung pada tempat anda beroperasi, peraturan pemantauan pekerja dan AI, seperti layanan EU AI Act terhadap sistem penilaian pekerja sebagai berisiko tinggi, mungkin juga mewajibkan pendedahan, jadi rujuk penasihat undang-undang.

Customer Success Operations Manager
On this page
- Fakta Utama
- Cara QA AI Berfungsi
- QA Manual berbanding QA AI
- Contoh Sebenar Mengikut Fungsi
- Mereka Bentuk Rubrik
- Penentukuran: Menjadikan Skor Boleh Dipercayai
- Langkah 1: Bina set emas
- Langkah 2: Jalankan AI pada set yang sama
- Langkah 3: Ukur persetujuan dengan betul
- Langkah 4: Baiki jurang, kemudian uji semula
- Langkah 5: Teruskan penentukuran
- Keadilan: Menskor Manusia Berbeza daripada Menskor Tiket
- Melaksanakan QA AI, Langkah demi Langkah
- Kesilapan Lazim