Bahasa Indonesia
AI Quality Assurance untuk Dukungan: Menilai Setiap Percakapan
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI quality assurance (AI QA) untuk dukungan adalah praktik menggunakan model bahasa untuk menilai setiap percakapan pelanggan yang ditangani agen manusia berdasarkan rubrik tertulis, alih-alih meminta peninjau menilai sampel kecil yang dipilih secara manual. Model membaca transkrip, menjawab pertanyaan dalam rubrik (Apakah agen mengenali masalah yang sebenarnya? Apakah solusinya benar? Apakah nadanya sesuai?) dan menghasilkan skor yang dapat Anda iris menurut agen, tim, topik, atau minggu.
Daya tariknya adalah cakupan. Program QA manual hanya dapat membaca tiket sebanyak jam kerja para peninjaunya, sehingga sebagian besar percakapan, termasuk beberapa yang terburuk, tidak pernah dilihat. AI bisa membaca semuanya. Tetapi membaca semuanya tidak sama dengan membacanya dengan benar, dan skor yang tidak dipercaya agen lebih buruk daripada tanpa skor. Karena itu panduan ini membahas tiga hal: cara kerja AI QA, cara mengkalibrasinya terhadap peninjau manusia, dan cara menjaganya tetap adil. Panduan ini bagian dari koleksi AI for Customer Service, jadi gambaran umum AI dalam layanan pelanggan adalah titik awal yang baik jika Anda menginginkan konteks yang lebih luas.
Fakta Utama
- Produk QA milik Zendesk mengiklankan "cakupan 100% dengan AutoQA" dan mengajak tim berhenti memilih tiket secara manual serta menganalisis setiap interaksi (Zendesk). Itu klaim vendor tentang cakupan, bukan tentang akurasi.
- Dokumentasi pengaturan Zendesk sendiri menyatakan bahwa evaluasi otomatisnya hanya untuk panduan, tidak boleh dipakai untuk keputusan kinerja, dan harus melengkapi, bukan menggantikan, tinjauan kinerja oleh manusia (Zendesk).
- Cohen's kappa mengukur kesepakatan di luar kebetulan. Dalam interpretasi McHugh yang banyak dikutip, 0,60 hingga 0,79 berarti kesepakatan sedang, 0,80 hingga 0,90 kuat, dan di atas 0,90 hampir sempurna (McHugh, Biochemia Medica, 2012).
- Riset tentang LLM judge menemukan bahwa model yang kuat dapat mencapai kesepakatan lebih dari 80% dengan preferensi manusia, tingkat yang sama dengan kesepakatan antarmanusia, tetapi juga mendokumentasikan bias posisi, bias kepanjangan, dan bias menguntungkan diri sendiri (Zheng et al., 2023).
- Di bawah EU AI Act, sistem AI yang digunakan untuk memantau dan mengevaluasi kinerja serta perilaku pekerja tercantum sebagai berisiko tinggi dalam Lampiran III, butir 4(b) (EU AI Act, Annex III).
Cara Kerja AI QA
QA tradisional adalah putaran dengan hambatan utama di tengahnya. Seorang analis QA memilih tiket, membuka satu per satu, menilainya berdasarkan scorecard, menulis komentar, dan mengirim umpan balik kepada agen. Karena waktu analis terbatas, sampelnya tetap kecil, dan pengambilan sampel jarang acak. Orang cenderung meninjau tiket yang dieskalasi, mendapat CSAT buruk, atau kebetulan pendek.
AI QA mempertahankan scorecard dan menggantikan langkah membaca oleh analis. Alurnya seperti ini:
- Ingest. Percakapan dari chat, email, transkrip suara, dan tiket mengalir masuk bersama metadata: kanal, topik, agen, tingkat pelanggan, hasil.
- Analyze. Model membaca setiap percakapan dan menjawab setiap pertanyaan rubrik, biasanya dengan justifikasi singkat yang dikutip dari transkrip.
- Score. Jawaban digabungkan menjadi skor percakapan, lalu menjadi tampilan per agen, tim, dan topik.
- Route. Percakapan berskor rendah atau berisiko tinggi diteruskan ke peninjau manusia. Yang luar biasa diteruskan ke pustaka coaching.
Langkah terakhir itulah alasan mengapa ini termasuk pola scoring-and-routing dalam ACE Framework: model tidak hanya menilai, tetapi memutuskan percakapan mana yang perlu dilihat manusia. Jika dilakukan dengan baik, peninjau manusia Anda menghabiskan jamnya untuk 5% yang membutuhkan penilaian, bukan 95% yang tidak.
Autoscoring pada Zendesk QA dilengkapi kategori bawaan seperti Greeting, Empathy, Spelling and grammar, Closing, Solution offered, Tone, Readability, dan Comprehension. Sebagian berupa pemeriksaan ya/tidak sederhana, Tone adalah skor berbobot, dan Readability adalah skala tiga poin yang tetap (Zendesk). "Apakah agen menyapa pelanggan?" nyaris mekanis. "Apakah agen memahami masalah pelanggan?" memerlukan penilaian. Perbedaan itulah yang menggerakkan sisa artikel ini.
QA Manual vs. AI QA
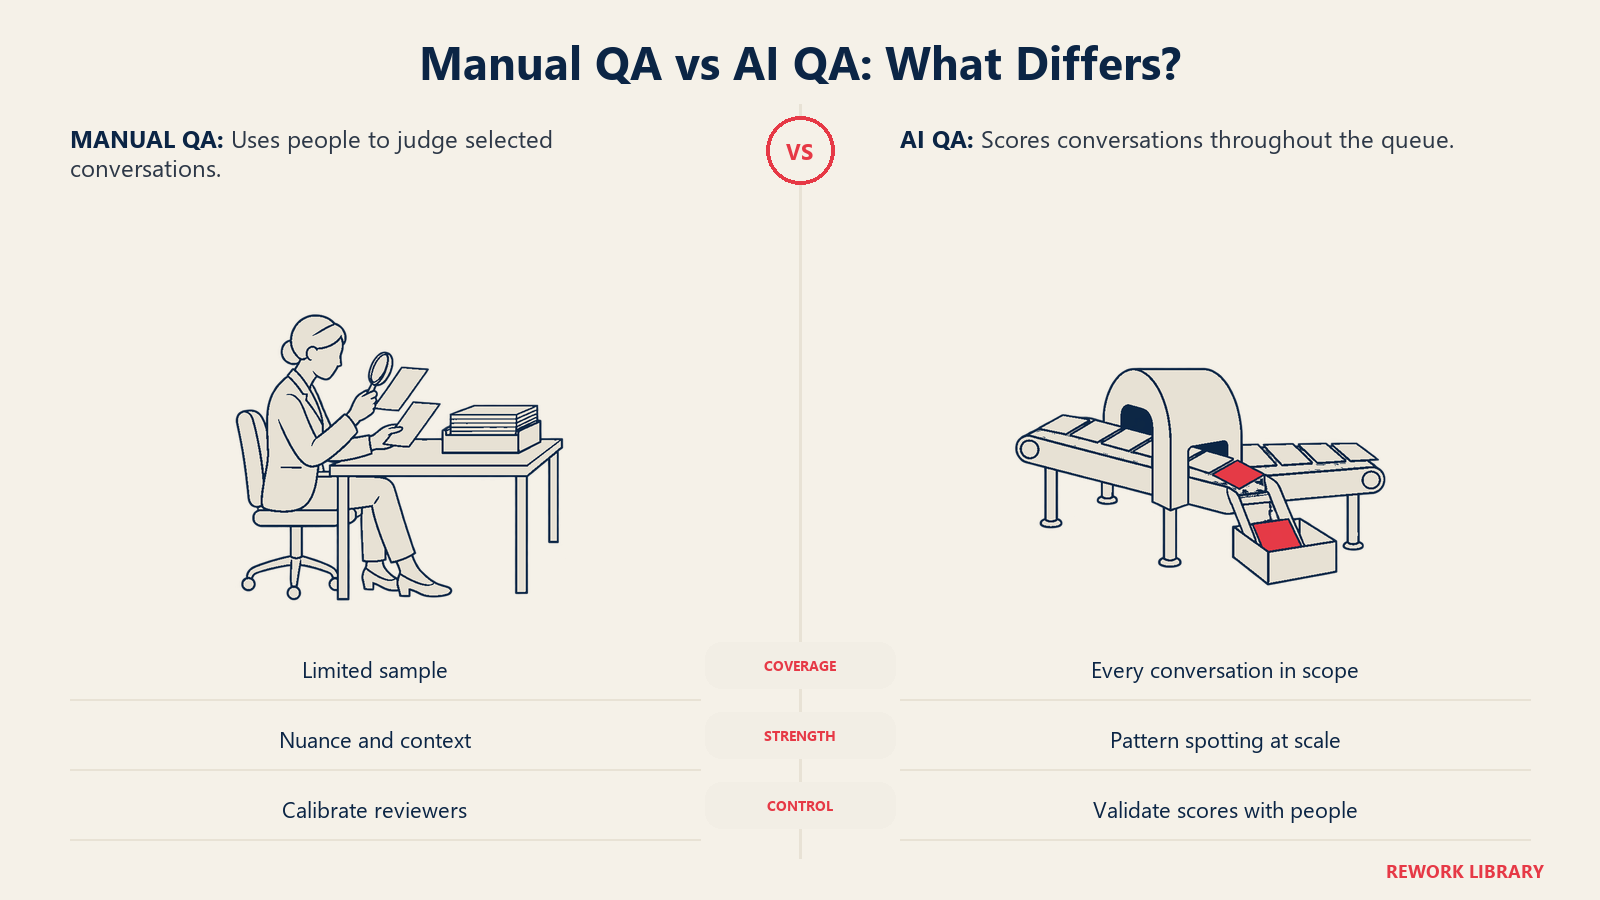
| Dimensi | QA manual | AI QA |
|---|---|---|
| Cakupan | Sampel, dipilih oleh seseorang | Setiap percakapan dalam lingkup |
| Konsistensi | Bervariasi menurut peninjau dan suasana hati | Prompt dan rubrik yang sama setiap kali (meski jawabannya tidak selalu sama) |
| Paling unggul dalam | Nuansa, konteks, pengecualian kebijakan, empati | Mengenali pola, pemeriksaan mekanis, menemukan pencilan |
| Lemah dalam | Skala, kecepatan, menemukan masalah langka | Konteks yang tidak bisa dilihatnya, sarkasme, kebijakan tidak tertulis |
| Kegagalan khas | Bias sampling, peninjau yang bergeser | Skor salah yang diberikan dengan percaya diri, bias pada gaya ketimbang substansi |
Kesimpulan jujurnya: keduanya tidak saling menggantikan. AI memberi Anda keluasan, manusia memberi Anda ground truth (data acuan), dan proses kalibrasi yang dijelaskan di bawah inilah yang menghubungkan keduanya.
Contoh Nyata menurut Fungsi
Rubrik berubah menurut tempat percakapan berlangsung. Beberapa kasus konkret:
Dukungan pelanggan tier 1. Seorang pelanggan menulis tentang tagihan ganda. Rubrik memeriksa bahwa agen memverifikasi identitas, menemukan duplikat, menjelaskan jadwal pengembalian dana, dan tidak menjanjikan sesuatu yang dilarang kebijakan. AI andal pada pemeriksaan terakhir: ia dapat menandai setiap percakapan ketika agen memakai frasa seperti "dijamin" atau menyebut jangka waktu pengembalian dana yang tidak sesuai dengan kebijakan terkini.
Penagihan dan penagihan piutang. Kepatuhan paling penting. Rubrik mungkin mewajibkan pengungkapan di awal dan melarang ancaman tertentu, dan AI QA dapat memeriksa setiap percakapan untuk keduanya, sedangkan sampel manual hanya akan menangkapnya secara kebetulan.
Dukungan teknis. Diagnosis lebih sulit dinilai secara otomatis. Sering kali lebih baik dirumuskan sebagai "tandai untuk ditinjau jika pelanggan kembali dalam seminggu dengan masalah yang sama" daripada sebagai nilai mutlak.
Help desk IT internal. "Pelanggan"-nya adalah karyawan, dan rubrik bertumpu pada kualitas penyelesaian serta apakah agen menunjuk artikel yang tepat, yang juga membuka celah pada data dukungan Anda.
Merancang Rubrik
Model hanya sebaik pertanyaan yang Anda ajukan. Sebagian besar program AI QA yang gagal, gagal pada rubriknya, bukan pada modelnya.
Scorecard yang layak pakai memiliki empat hingga delapan kriteria, masing-masing ditulis sebagai pertanyaan yang dapat diamati dan dijawab, bukan sifat yang samar. Bandingkan "Apakah agen berempati?" dengan "Apakah agen mengakui masalah yang disampaikan pelanggan sebelum beralih ke solusi?" Yang kedua dapat diperiksa dari transkrip, dan dua peninjau jauh lebih mungkin sepakat tentangnya.
| Kriteria | Rumusan lemah | Rumusan kuat | Tipe |
|---|---|---|---|
| Pemahaman | "Memahami pelanggan" | "Menyatakan ulang atau mengonfirmasi masalah sebenarnya dari pelanggan sebelum mengusulkan perbaikan" | Ya / Tidak |
| Akurasi | "Memberi jawaban yang bagus" | "Solusi atau kebijakan yang disebutkan sesuai dengan artikel basis pengetahuan terkini" | Ya / Tidak / Tidak bisa dinilai |
| Proses | "Mengikuti prosedur" | "Memverifikasi identitas sebelum membagikan detail akun" | Ya / Tidak / Tidak diperlukan |
| Nada | "Profesional" | "Tidak ada bahasa yang meremehkan atau menyalahkan pelanggan" | Ya / Tidak |
| Penutupan | "Menutup dengan baik" | "Menyebutkan langkah berikutnya dan siapa pemiliknya, atau mengonfirmasi bahwa tidak ada yang perlu dilakukan lagi" | Ya / Tidak |
Dua pilihan desain membuahkan hasil. Pertama, selalu izinkan "tidak bisa dinilai" atau "tidak berlaku". Model yang dipaksa memilih ya atau tidak akan menebak, dan tebakan atas konteks yang hilang adalah sumber skor yang tidak adil. Kedua, beri bobot kriteria menurut apa yang benar-benar dirasakan pelanggan. Penyelesaian yang benar harus lebih berbobot daripada salah ketik.
Kalibrasi: Membuat Skor Dapat Dipercaya
Kalibrasi adalah langkah yang membedakan dashboard yang diperdebatkan orang dari dashboard yang mereka gunakan. Idenya sederhana: minta manusia dan AI menilai percakapan yang sama, lalu ukur seberapa sering mereka sepakat dan perbaiki celahnya.
Langkah 1: Bangun gold set
Pilih 100 hingga 200 percakapan yang mencakup kanal, topik, dan tingkat kesulitan Anda. Sertakan beberapa yang mudah, beberapa yang ambigu, dan beberapa yang sudah Anda ketahui berjalan buruk. Minta sedikitnya dua peninjau berpengalaman menilai masing-masing secara independen, lalu bertemu untuk menyelesaikan perbedaan. Hasilnya adalah "gold set (set acuan)" dengan jawaban yang disepakati, dan perbedaan pendapat yang muncul sepanjang prosesnya berharga dengan sendirinya karena menunjukkan di mana rubrik Anda samar.
Langkah 2: Jalankan AI pada set yang sama
Nilai gold set dengan model. Bandingkan kriteria demi kriteria, bukan hanya skor totalnya. Total bisa tampak baik sementara satu kriteria, misalnya "Akurasi", diam-diam salah separuh waktu.
Langkah 3: Ukur kesepakatan dengan benar
Persentase kesepakatan mentah menyesatkan, karena dua penilai yang sama-sama sering mengatakan "lulus" akan sering sepakat hanya karena kebetulan. Gunakan Cohen's kappa, yang mengurangi kesepakatan karena kebetulan. Berikut hipotesis untuk menunjukkan mengapa ini penting:
| AI bilang lulus | AI bilang gagal | Total | |
|---|---|---|---|
| Peninjau bilang lulus | 70 | 10 | 80 |
| Peninjau bilang gagal | 10 | 10 | 20 |
| Total | 80 | 20 | 100 |
Keduanya sepakat pada 80 dari 100 percakapan, jadi kesepakatan mentahnya 80%. Tetapi jika kedua penilai meluluskan sekitar 80% percakapan, mereka akan sepakat sekitar 68% dari waktu hanya karena kebetulan. Kappa adalah (0,80 dikurangi 0,68) dibagi (1 dikurangi 0,68), yaitu sekitar 0,38. Pada skala McHugh itu kesepakatan lemah (McHugh, 2012), meski judulnya menyebut 80%. Sebagian besar "kesepakatan" AI hanyalah karena keduanya sama-sama mengatakan lulus.
Hitung kappa untuk setiap kriteria, dan juga untuk para peninjau manusia terhadap satu sama lain. Angka kedua itu adalah batas atas Anda. Jika dua peninjau terbaik Anda hanya mencapai 0,65 satu sama lain, berharap AI mencapai 0,9 tidak realistis, dan perbaikan sebenarnya adalah rubrik yang lebih jelas. Riset LLM judge mengarah ke hal yang sama: model yang kuat dapat menyamai tingkat kesepakatan antarmanusia, yang merupakan target yang berguna, bukan target ajaib (Zheng et al., 2023).
Langkah 4: Perbaiki celahnya, lalu uji ulang
Di mana kesepakatan rendah, Anda punya tiga tuas: tulis ulang kriteria agar lebih konkret, tambahkan contoh kerja (transkrip "baik" dan "buruk") ke dalam prompt, atau keluarkan kriteria itu dari penilaian otomatis dan jadikan khusus manusia. Beberapa kriteria, seperti empati sejati, mungkin tidak akan pernah mencapai kesepakatan yang dapat diterima. Nilai apa yang dinilai AI dengan andal dan serahkan sisanya kepada manusia.
Langkah 5: Terus kalibrasi
Pertahankan sesi tetap mingguan atau bulanan: seorang peninjau menilai sampel acak baru tanpa melihat skor AI, dan Anda melacak kappa dari waktu ke waktu. Angka yang menurun adalah peringatan dini bahwa ada yang berubah, seperti lini produk baru, pembaruan kebijakan, atau bahasa baru. Jika Anda menjalankan dukungan multibahasa, kalibrasi per bahasa, karena kesepakatan dalam bahasa Inggris tidak memberi tahu apa pun tentang bahasa Portugis.
Keadilan: Menilai Orang Berbeda dari Menilai Tiket
Skor QA bukan sekadar data. Skor itu menjadi masukan bagi coaching, bonus, dan kadang tinjauan kinerja. Itu menaikkan taruhan bagi kesalahan dan bias, dan inilah bagian yang paling kurang direncanakan oleh sebagian besar tim.
Kenali bias yang sudah diketahui. Literatur LLM-as-judge mendokumentasikan bias posisi, bias kepanjangan (jawaban yang lebih panjang lebih disukai), dan bias menguntungkan diri sendiri (Zheng et al., 2023). Dalam dukungan, bias kepanjangan punya padanan langsung: agen yang menulis balasan panjang dan rapi bisa mengungguli agen yang menyelesaikan masalah dalam dua baris ringkas. Ujilah dengan memeriksa apakah skor berkorelasi dengan panjang pesan setelah Anda mengendalikan hasilnya.
Periksa perbedaan tingkat kelompok. Bandingkan skor menurut masa kerja, shift, bahasa, wilayah, dan jenis kontak. Sebagian kesenjangan itu nyata. Yang lain menunjukkan rubrik yang menghukum frasa non-penutur asli atau antrean yang lebih sulit: jika agen sengketa penagihan berskor lebih rendah daripada agen reset kata sandi, model mungkin menilai kesulitan, bukan kualitas. Normalkan menurut topik sebelum membandingkan orang.
Bersikap transparan kepada agen. Publikasikan rubriknya. Biarkan agen melihat kriteria persisnya, skor mereka sendiri, dan kutipan yang memicu setiap penilaian. Orang menerima skor rendah yang alasannya bisa mereka lihat. Mereka menolak angka yang muncul tanpa penjelasan.
Bangun jalur banding. Setiap agen harus dapat menggugat skor dan mendapat tinjauan manusia dalam waktu yang ditetapkan. Lacak tingkat pembatalan. Tingkat pembatalan yang tinggi pada satu kriteria berarti kriteria itu belum siap diotomatisasi. Masukkan kembali kasus yang dibatalkan ke gold set Anda.
Pertahankan manusia dalam keputusan. Bahkan vendor menyatakannya. Dokumentasi Zendesk menyatakan bahwa evaluasi otomatisnya hanya untuk panduan dan harus melengkapi, bukan menggantikan, tinjauan kinerja oleh manusia (Zendesk). Gunakan skor AI untuk memutuskan percakapan mana yang dibaca manusia, dan gunakan penilaian manusia untuk memutuskan apa pun yang memengaruhi gaji atau pekerjaan.
Kenali arah regulasi. Di Uni Eropa, sistem AI yang dimaksudkan untuk memantau dan mengevaluasi kinerja serta perilaku pekerja tercantum dalam Lampiran III daftar berisiko tinggi AI Act (EU AI Act, Annex III), dan Pasal 14 mensyaratkan bahwa orang yang mengawasi sistem semacam itu tetap menyadari kecenderungan terlalu mengandalkan keluarannya, yang dikenal sebagai automation bias (EU AI Act, Article 14). Konsultasikan dengan penasihat hukum untuk yurisdiksi Anda, dan ingat bahwa dewan pekerja dan undang-undang pemantauan karyawan di beberapa negara menambahkan persyaratannya sendiri.
Menerapkan AI QA, Langkah demi Langkah
- Tentukan tujuannya. Coaching, kepatuhan, dan pengalaman pelanggan membutuhkan rubrik yang berbeda. Mulailah dengan satu.
- Tulis rubrik bersama agen, bukan hanya manajer: empat hingga delapan kriteria yang dapat diamati, dengan "tidak bisa dinilai" diperbolehkan.
- Kalibrasi sebelum peluncuran. Bangun gold set dan periksa kappa per kriteria, seperti di atas.
- Jalankan dalam shadow mode selama beberapa minggu berdampingan dengan QA Anda saat ini, tanpa menunjukkan skor kepada agen, atau beri label "beta, tidak dipakai dalam tinjauan".
- Tuliskan bagaimana skor boleh dipakai. Topik coaching dan tiket mana yang ditinjau, ya. Bonus dan tindakan disiplin, belum sampai kepercayaan terbangun.
- Arahkan, jangan hanya melaporkan. Skor rendah, tanda kepatuhan, dan gugatan masuk ke antrean manusia. Percakapan yang menonjol masuk ke alur coaching sebagai contoh.
- Tutup putaran bersama agen. Tampilkan hasil dengan bukti kutipan dan tombol banding sejak hari pertama.
- Hubungkan dengan stack Anda. Temuan QA menunjukkan di mana saran real-time atau artikel pengetahuan gagal. Untuk mengukur bot yang berhadapan dengan pelanggan, lihat tingkat penyelesaian AI.
- Tinjau setiap kuartal: jalankan ulang gold set, periksa kappa dan kesenjangan skor antarkelompok, pensiunkan kriteria yang tidak bertahan.
Jika Anda masih menentukan apa yang tetap dipegang manusia, otomatisasi atau bantu membingkai keputusan itu, dan bagaimana AI mengubah peran tim dukungan membahas nasib analis QA: mereka biasanya beralih dari menilai tiket menjadi pemilik rubrik, gold set, dan kalibrasi.
Kesalahan Umum
Memercayai cakupan sebagai akurasi. "Setiap percakapan dinilai" tidak mengatakan apa pun tentang apakah skornya benar. Mintalah angka kesepakatan terhadap peninjau manusia pada percakapan Anda sendiri.
Menilai yang mudah, bukan yang penting. Tim yang mencetak 98% pada sapaan dan 60% pada penyelesaian yang benar memiliki masalah pengukuran, bukan keberhasilan kualitas.
Melewatkan "tidak bisa dinilai". Tanpa itu, model mengarang jawaban ketika transkrip tidak memiliki konteks, seperti status akun yang tidak pernah dilihatnya.
Meranking orang berdasarkan skor mentah. Agen di antrean sulit dihukum. Bandingkan dalam topik yang sama dan perlakukan kesenjangan sebagai pertanyaan untuk diselidiki.
Kalibrasi sekali saja. Kesepakatan menurun seiring produk dan kebijakan berubah. Jadwalkan kalibrasi ulang.
Mengajarkan skor kepada agen, bukan keterampilan. Jika frasa empati menaikkan skor, Anda akan mendapatkan frasa empati. Pertahankan tinjauan manusia dalam campuran.
Menyalahkan agen atas celah pengetahuan. Banyak skor akurasi rendah berasal dari artikel bantuan yang usang. Perbaiki sumbernya sebelum membimbing orangnya.
Pertanyaan yang Sering Diajukan tentang AI Quality Assurance untuk Dukungan
Apa itu AI quality assurance untuk dukungan pelanggan?
Itu adalah penggunaan model bahasa untuk menilai setiap percakapan yang ditangani agen manusia Anda berdasarkan rubrik tertulis, alih-alih meninjau sampel kecil secara manual. Skornya muncul menurut agen, tim, dan topik, dan percakapan berskor rendah atau berisiko diteruskan ke peninjau manusia.
Dapatkah AI QA menggantikan peninjau QA manusia?
Tidak sepenuhnya. AI unggul dalam cakupan dan pemeriksaan mekanis, sementara manusia lebih baik dalam nuansa, konteks, dan pengecualian kebijakan. Dokumentasi Zendesk menyatakan bahwa evaluasi otomatisnya harus melengkapi, bukan menggantikan, tinjauan kinerja oleh manusia. Sebagian besar tim menggeser peninjaunya ke kalibrasi, gugatan, dan kriteria yang lebih sulit.
Bagaimana cara memeriksa bahwa skor AI sesuai dengan peninjau manusia saya?
Bangun gold set berisi 100 hingga 200 percakapan yang dinilai oleh dua peninjau atau lebih, jalankan AI pada set yang sama, dan bandingkan setiap kriteria dengan Cohen's kappa, bukan persentase kesepakatan mentah. Ukur juga kesepakatan antarpeninjau, karena itulah batas atas yang realistis bagi AI.
Berapa skor kappa yang baik untuk kalibrasi QA?
Dalam interpretasi McHugh, 0,60 hingga 0,79 berarti sedang, 0,80 hingga 0,90 kuat, dan di atas 0,90 hampir sempurna. Untuk kriteria yang memengaruhi tinjauan agen, upayakan kesepakatan yang kuat. Untuk kriteria yang hanya membantu Anda memilih tiket yang dibaca, kesepakatan sedang bisa diterima.
Bagaimana menjaga AI QA tetap adil bagi agen?
Publikasikan rubrik, tunjukkan kepada agen bukti kutipan di balik setiap skor, bandingkan orang dalam topik atau antrean yang sama, uji bias seperti kecenderungan menyukai balasan yang lebih panjang, dan beri setiap agen cara untuk mengajukan banding. Pertahankan manusia dalam keputusan apa pun yang memengaruhi gaji atau pekerjaan.
Haruskah agen diberi tahu bahwa AI menilai percakapan mereka?
Ya. Transparansi itu adil sekaligus praktis, karena agen yang memahami rubrik berkembang lebih cepat dan lebih jarang menggugat. Bergantung pada tempat Anda beroperasi, aturan pemantauan karyawan dan AI, seperti perlakuan EU AI Act terhadap sistem evaluasi pekerja sebagai berisiko tinggi, mungkin juga mewajibkan pengungkapan, jadi konsultasikan dengan penasihat hukum.

Customer Success Operations Manager
On this page
- Fakta Utama
- Cara Kerja AI QA
- QA Manual vs. AI QA
- Contoh Nyata menurut Fungsi
- Merancang Rubrik
- Kalibrasi: Membuat Skor Dapat Dipercaya
- Langkah 1: Bangun gold set
- Langkah 2: Jalankan AI pada set yang sama
- Langkah 3: Ukur kesepakatan dengan benar
- Langkah 4: Perbaiki celahnya, lalu uji ulang
- Langkah 5: Terus kalibrasi
- Keadilan: Menilai Orang Berbeda dari Menilai Tiket
- Menerapkan AI QA, Langkah demi Langkah
- Kesalahan Umum