AI-Kennzahlen im Kundenservice: Containment, Lösung, CSAT und Kosten pro Kontakt
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI-Kennzahlen im Kundenservice sind die kleine Menge an Zahlen, die Ihnen sagt, ob Ihre AI Kundenprobleme löst, in welcher Qualität und zu welchen Kosten. Keine einzelne Zahl leistet das. Containment sagt Ihnen, dass ein Mensch draußen blieb. Die Lösung sagt Ihnen, dass das Problem verschwunden ist. CSAT sagt Ihnen, wie sich der Kunde gefühlt hat. Die Kosten pro Kontakt sagen Ihnen, was es gekostet hat. Jede kann gesund aussehen, während eine andere unbemerkt versagt. Die nützliche Einheit ist daher eine Scorecard, in der jede Kennzahl einen Partner hat, der ihren blinden Fleck abfängt.
Dieser Leitfaden gibt Ihnen diese Scorecard: elf Kennzahlen, je eine Formel, ein durchgerechnetes Beispiel mit hypothetischen Zahlen, die Fallstricke und eine Tabellenvorlage, die Sie in Ihr Reporting übernehmen können. Wenn Sie die ausführliche Version brauchen, wie sich Containment, Deflection (Anfragenvermeidung) und Lösung unterscheiden, lesen Sie AI-Lösungsquote. Hier nutzen wir diese Definitionen und machen weiter. Für das Gesamtbild, wo AI im Support ihren Platz hat, beginnen Sie mit dem Überblick zu AI im Kundenservice.
Wichtige Fakten
- Eine gesunde AI-Scorecard hat elf Kennzahlen in vier Gruppen: Ergebnis (Containment, Lösung, Wiedereröffnungsquote), Erlebnis (CSAT, Aufwand, Übergabequalität), Effizienz (Kosten, Bearbeitungszeit) und Abdeckung (Eskalation, Wissenslücken).
- Jede Kennzahl braucht einen Partner. Containment wird mit der Lösung gepaart, CSAT mit einer menschlichen Baseline (Ausgangswert) und die Kosten pro Kontakt mit den Kosten pro gelöstem Anliegen.
- Die Kosten pro Kontakt verschieben sich, wenn Sie ändern, wie ein „Kontakt“ gezählt wird, auch wenn sich real nichts verändert hat. Definieren Sie ihn als Kundenanliegen und halten Sie ihn fest (Gladly).
- In einer großen Studie mit Kundensupport-Mitarbeitenden erhöhte AI-Unterstützung die gelösten Fälle pro Stunde im Durchschnitt um 14%, mit einem Zugewinn von 34% bei Berufseinsteigern und gering qualifizierten Beschäftigten (NBER).
- Die eigene Anleitung von Zendesk zur durchschnittlichen Bearbeitungszeit warnt, dass eine niedrige Zahl keine gute Leistung bedeutet, und rät, sie neben CSAT, Erstlösungsquote und Kundenaufwand zu lesen (Zendesk).
- Berichten Sie jede Kennzahl mit dem danebengeschriebenen Nenner. Den Nenner zu ändern ist der einfachste Weg, Fortschritt herbeizurechnen.
Die Scorecard auf einen Blick
Vor den Details hier die ganze Menge. Betrachten Sie die Spalte „Gepaart mit“ als die Regel, die die Kennzahl ehrlich hält.
| Gruppe | Kennzahl | Formel | Gepaart mit |
|---|---|---|---|
| Ergebnis | Containment-Rate | Konversationen ohne menschliche Beteiligung ÷ AI-Konversationen | Lösungsquote |
| Ergebnis | Verifizierte Lösungsquote | Gelöste und nicht wiederholte Konversationen ÷ AI-Konversationen | Wiedereröffnungsquote, Stichprobenprüfung |
| Ergebnis | Wiedereröffnungs- und Wiederkontaktquote | Gelöste Konversationen mit anschließendem erneutem Kontakt zum selben Anliegen ÷ gelöste Konversationen | Lösungsquote |
| Erlebnis | CSAT, AI vs. Mensch | Zufriedene Antworten ÷ alle Antworten, getrennt nach Bearbeiter | Antwortquote |
| Erlebnis | Kundenaufwand | Summe der Aufwandsbewertungen ÷ Umfrageantworten | CSAT |
| Erlebnis | Übergabequalität | Übergaben, bei denen die Mitarbeitenden nicht erneut fragen mussten ÷ Übergaben | Eskalationsrate |
| Effizienz | Kosten pro Kontakt | Gesamte Supportkosten ÷ Kontakte | Kosten pro gelöstem Anliegen |
| Effizienz | Kosten pro gelöstem Anliegen | Gesamte Supportkosten ÷ gelöste Anliegen | Kosten pro Kontakt |
| Effizienz | Wirkung auf die Bearbeitungszeit der Mitarbeitenden | Durchschnittliche Bearbeitungszeit mit AI-Unterstützung vs. ohne | CSAT, Wiedereröffnungsquote |
| Abdeckung | Eskalationsrate | An Menschen übergebene Konversationen ÷ AI-Konversationen | Containment |
| Abdeckung | Wissenslückenquote | Fragen, die die AI aus ihren Quellen nicht beantworten konnte ÷ gestellte Fragen | Lösung nach Thema |
Die Liste ist lang, doch die meisten Teams prüfen fünf oder sechs davon wöchentlich und den Rest monatlich. Die folgenden Abschnitte gehen Gruppe für Gruppe vor.
Ergebniskennzahlen: Ist das Problem verschwunden?
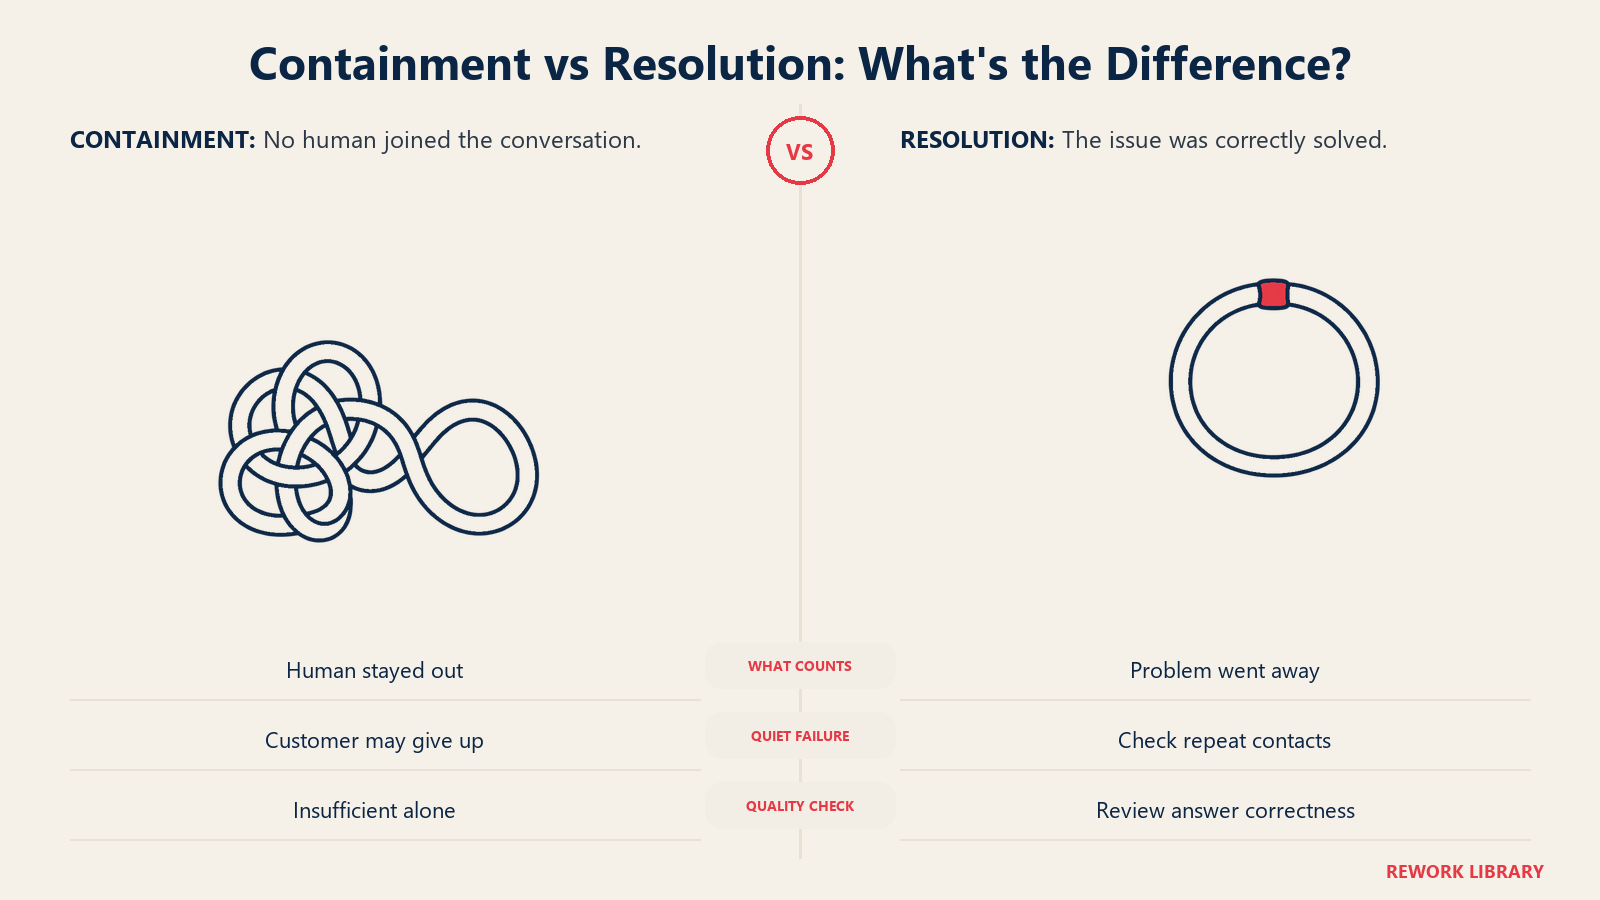
Die Containment-Rate ist der Anteil der AI-Konversationen, die nie einen Menschen erreichten.
Containment = Konversationen ohne menschliche Beteiligung ÷ alle AI-Konversationen
Sie ist die am leichtesten zu berechnende und am leichtesten zu missdeutende Kennzahl. Ein Kunde, der aufgibt, ist „contained“. Ein Kunde, der eine falsche Antwort bekommt und das Fenster schließt, ist contained. Der Bericht des Consumer Financial Protection Bureau zu Bank-Chatbots beschreibt Kunden, die in „Endlosschleifen ohne Ausweg“ aus sich wiederholenden, nutzlosen Antworten ohne Ausstieg zu einem Menschen festhängen, und verweist auf eine Umfrage, in der 78% der Verbraucher einen Menschen erreichen mussten, nachdem ein Chatbot ihre Bedürfnisse nicht erfüllt hatte (CFPB). Manche dieser Kunden stecken in der Containment-Zahl von jemandem als Erfolg.
Die verifizierte Lösungsquote ist Containment ohne die Fehlschläge.
Verifizierte Lösung = (contained Konversationen − Konversationen mit erneutem Kontakt zum selben Anliegen − von einem Prüfenden als falsch bewertete Konversationen) ÷ alle AI-Konversationen
Wie Sie „gelöst“ beurteilen, ist eine Designentscheidung. Intercom etwa definiert seine Lösungsquote als den Prozentsatz der Konversationen, die sein AI Agent ohne menschliche Beteiligung löst, und zählt eine Lösung, wenn der Kunde die Antwort bestätigt oder geht, ohne weitere Hilfe zu verlangen (Intercom). Das ist eine vernünftige Betriebsregel, sie zählt aber Schweigen als Erfolg. Führen Sie daher zusätzlich zu jeder Herstellerzahl Ihre eigene Prüfung auf Wiederkontakte durch.
Die Wiedereröffnungs- oder Wiederkontaktquote fängt die stillen Fehlschläge ab.
Wiedereröffnungsquote = gelöste Konversationen mit erneutem Kontakt zum selben Anliegen innerhalb Ihres Zeitfensters ÷ gelöste Konversationen
In einem Ticketsystem ist eine Wiedereröffnung ein natives Ereignis. Zendesk definiert wiedereröffnete Tickets als solche, die nach der Lösung erneut geöffnet wurden (Zendesk). Mit AI öffnet der Kunde oft gar nichts wieder. Er startet einen neuen Chat, schreibt eine E-Mail oder ruft an. Gleichen Sie daher nach Kunde und Thema über Kanäle hinweg ab, nicht nach Ticket-ID, und wählen Sie ein Zeitfenster, das zum Anliegen passt: einige Tage für ein Passwort-Reset, einige Wochen für einen Abrechnungsstreit.
Ein durchgerechnetes Beispiel (hypothetisch)
Angenommen, in einem Monat beginnen 10.000 Konversationen mit Ihrer AI.
- 6.000 sind contained und 4.000 werden an einen Menschen übergeben (Containment 60%, Eskalation 40%).
- Von den 6.000 contained Konversationen melden sich 900 Kunden innerhalb von sieben Tagen über einen anderen Kanal zum selben Anliegen zurück.
- Die verifizierte Lösung beträgt (6.000 − 900) ÷ 10.000 = 51%.
Die Schlagzeile sagt 60%. Die belastbare Zahl ist 51%. Beide stimmen, aber nur eine gehört in einen Budgetantrag. Ergänzen Sie eine wöchentliche menschliche Prüfung einer Zufallsstichprobe, und Sie drücken sie womöglich weiter, was eine nützliche Information darüber ist, wie optimistisch die eigene Zählung Ihres Tools ist.
Erlebniskennzahlen: Wie hat es sich angefühlt?
CSAT, getrennt nach AI und Mensch. Die Standardberechnung lautet zufriedene Antworten geteilt durch alle Antworten, mal 100. Die meisten Teams zählen die beiden obersten Stufen einer Fünferskala oder die „guten“ Stimmen einer binären. Der Fehler ist, einen einzigen vermischten CSAT zu veröffentlichen. Berichten Sie den Wert für AI-bearbeitete und für menschlich bearbeitete Konversationen getrennt und zeigen Sie jeweils die Antwortquote daneben, denn Kunden, die gerade eine schlechte Bot-Antwort bekamen, füllen seltener eine Umfrage aus als Kunden, die mit einem Menschen sprachen. Ein hoher AI-CSAT bei 4% Antwortquote sagt etwas über die 4%.
Wenn Sie die Zufriedenheit sehen wollen, bevor die Umfrage eintrifft, behandelt CSAT mit AI vorhersagen, wie man sie aus Signalen der Konversation modelliert. Betrachten Sie einen prognostizierten Wert als Anlass hinzusehen, nicht als Ersatz fürs Fragen.
Kundenaufwand. Der Customer Effort Score misst den Aufwand, den ein Kunde betreiben muss, um zu bekommen, was er braucht. Bei einer Standardskala schreibt Zendesk die Formel als Summe der CES-Bewertungen geteilt durch die Zahl der Umfrageantworten und merkt an, dass ein hoher Wert geringen Aufwand anzeigt (Zendesk). Skalen laufen bei den Anbietern in beide Richtungen, halten Sie daher fest, welches Ende „leicht“ bedeutet, bevor Sie zwei Berichte vergleichen. Der Aufwand ist die Kennzahl, die den langen, höflichen Bot entlarvt, der zwar technisch antwortet und dafür neun Nachrichten braucht.
Übergabequalität. Wenn die AI übergibt: Musste der Mensch von vorn beginnen?
Übergabequalität = Übergaben, bei denen die Mitarbeitenden die Zusammenfassung der Konversation hatten, den Kunden identifizierten und die Frage nicht erneut stellten ÷ alle Übergaben
Das messen Sie durch Stichproben von Übergaben, nicht über ein Dashboard. Lesen Sie zwanzig pro Woche und markieren Sie jede mit Ja oder Nein. Das Muster, das Sie suchen, ist der Kunde, der einem Bot sein Problem erklärt und es dann noch einmal einer Person erklärt. Diese Wiederholung untergräbt das Vertrauen schneller als eine falsche Antwort. AI Agent Assist ist die Fähigkeit, die eine saubere Übergabe möglich macht, indem sie den Thread für die Mitarbeitenden zusammenfasst.
Effizienzkennzahlen: Was hat es gekostet und was hat es freigesetzt?
Die Kosten pro Kontakt sind die einfachste Effizienzzahl.
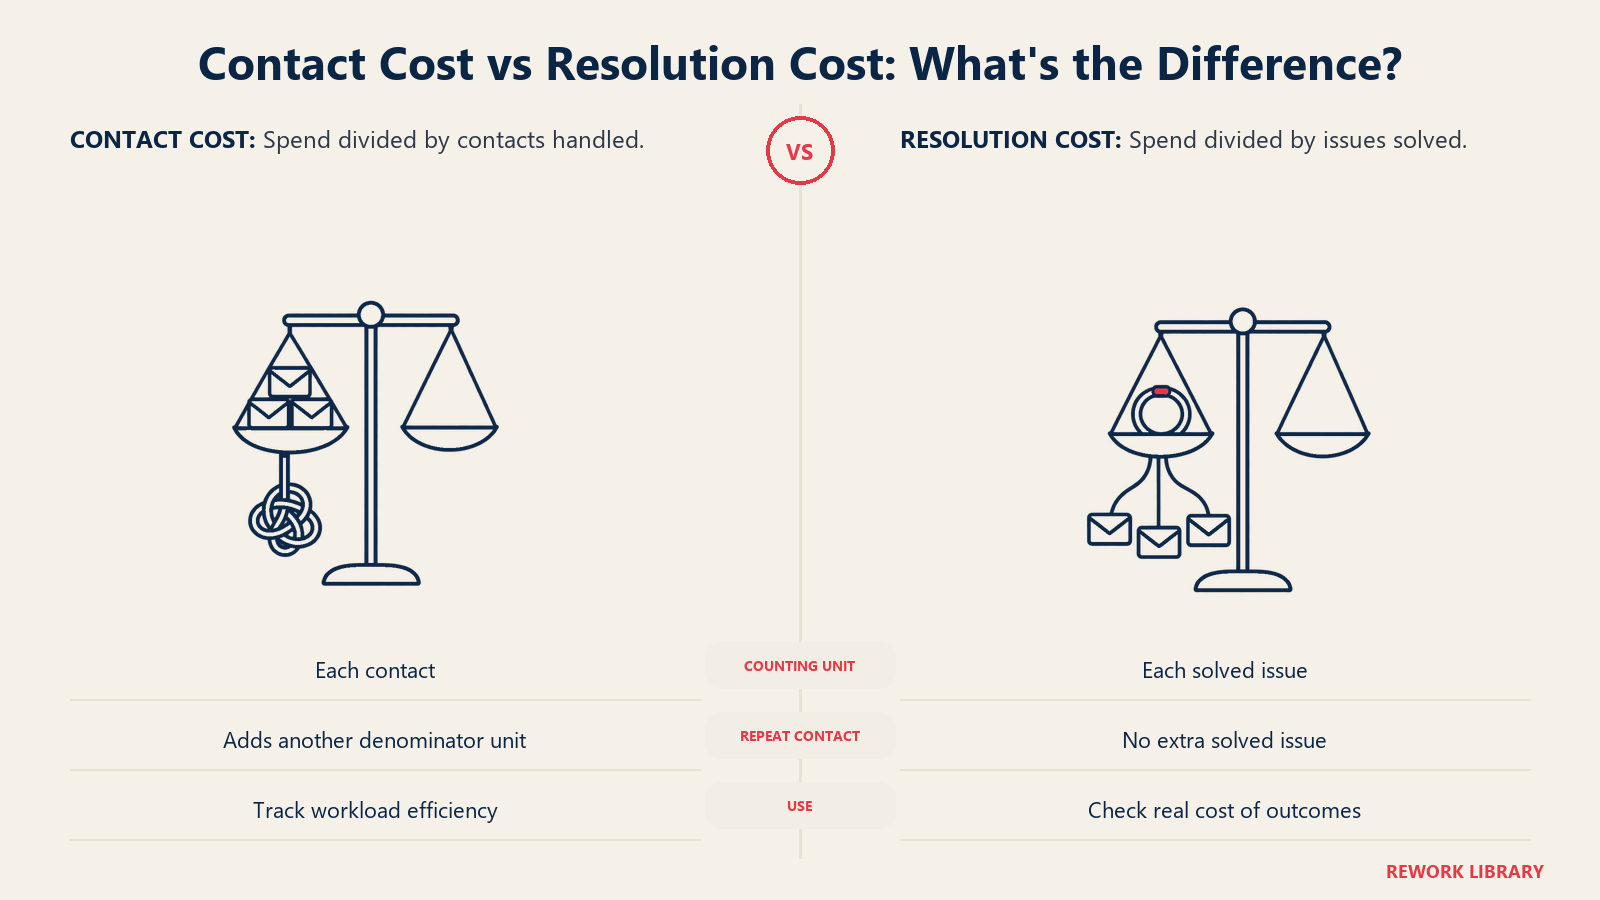
Kosten pro Kontakt = gesamte Betriebskosten des Supports im Zeitraum ÷ alle im Zeitraum bearbeiteten Kontakte
Das Rechenbeispiel von Gladly ist ein Team, das in einem Monat $100.000 ausgibt und 10.000 Kontakte bearbeitet, also $10,00 pro Kontakt. Dieselbe Seite macht den entscheidenden Punkt: Ticketbasierte Systeme zählen jedes neue Ticket, konversationsbasierte Systeme zählen den ganzen Thread als einen, und jede Berührung zu zählen senkt die berichteten Kosten, ohne das Kundenerlebnis zu verändern. Der Rat lautet, einen Kontakt als Kundenanliegen zu definieren und diese Definition festzuhalten (Gladly).
Die Kosten pro gelöstem Anliegen sind die härtere, ehrlichere Version, denn eine Zerstückelung der Arbeit kann sie nicht senken.
Kosten pro gelöstem Anliegen = gesamte Betriebskosten des Supports ÷ tatsächlich gelöste Anliegen (durch AI oder durch einen Menschen)
Führen Sie das hypothetische Beispiel von oben fort, mit angenommenen Gesamtkosten des Supports von $120.000 im Monat. Die 900 Wiederkontakte sind echte Kontakte, also gibt es insgesamt 10.900, was Kosten pro Kontakt von rund $11,01 ergibt. Menschen lösen 3.600 der 4.000 eskalierten Anliegen und alle 900 Wiederkontakt-Anliegen, die gelösten Anliegen summieren sich also auf 5.100 + 3.600 + 900 = 9.600. Die Kosten pro gelöstem Anliegen betragen $120.000 ÷ 9.600 = $12,50. Die zweite Zahl ist höher, weil sie einen Wiederkontakt nicht wie ein Schnäppchen aussehen lässt. Verfolgen Sie beide. Laufen sie auseinander, erzeugt Ihre AI zusätzliche Kontakte.
Zu den Kosteneingaben selbst, etwa was in den Zähler gehört und wie Plattformgebühren der AI einzuordnen sind, siehe die Kosten von AI im Kundenservice.
Wirkung auf die Bearbeitungszeit der Mitarbeitenden. Die durchschnittliche Bearbeitungszeit wird üblicherweise als Gesprächszeit plus Haltezeit plus Nacharbeit geteilt durch die Zahl der bearbeiteten Kontakte geschrieben (Zendesk). Mit AI im Spiel ändern sich zwei Dinge. Erstens nimmt die AI die einfachen Kontakte auf, sodass die verbleibende Warteschlange der Menschen schwieriger wird und ihre durchschnittliche Bearbeitungszeit steigen kann, auch wenn das System funktioniert. Zweitens sollten Assist-Tools die Zeit pro Kontakt verkürzen. Messen Sie beides: die Bearbeitungszeit nach Kontaktgrund vor und nach dem Einsatz sowie die gelösten Anliegen pro Mitarbeiterstunde.
Externe Evidenz für den Assist-Effekt gibt es. Eine Studie mit Kundensupport-Mitarbeitenden, die einen generativen AI-Assistenten nutzten, fand einen durchschnittlichen Anstieg der gelösten Fälle pro Stunde um 14%, eine Verbesserung um 34% bei Berufseinsteigern und gering qualifizierten Beschäftigten und minimale Wirkung bei erfahrenen Beschäftigten (NBER). Das sind die Ergebnisse dieser Studie, kein Ziel für Ihr Team, aber sie zeigen, warum Sie die Bearbeitungszeit nach Erfahrungsstufe lesen sollten: Der Gewinn verteilt sich nicht gleichmäßig. Auch die Anleitung von Zendesk zu dieser Kennzahl warnt, dass eine niedrige Bearbeitungszeit keine gute Leistung bedeutet, weil der Druck, Kontakte zu verkürzen, der Qualität schaden kann. Lesen Sie sie daher neben CSAT und Aufwand (Zendesk).
Abdeckungskennzahlen: Wo hört die AI auf?
Eskalationsrate.
Eskalationsrate = an Menschen übergebene Konversationen ÷ AI-Konversationen
Es gibt keine ideale Zahl. Eine Rate nahe null kann bedeuten, dass die AI exzellent ist oder dass sie den Ausgang versteckt. Teilen Sie Eskalationen in zwei Arten. Geplante Übergaben geschehen, weil Sie eine Regel konfiguriert haben, etwa dass jede Erstattung über einem bestimmten Betrag an eine Person geht. Fehler-Eskalationen geschehen, weil der Kunde einen Menschen verlangte, Frust zeigte oder auf etwas stieß, das die AI nicht bewältigen konnte. Die Dokumentation von Intercom zieht eine ähnliche Linie zwischen einer Übergabe, die ein konfigurierter Ablauf auslöst, und einer Eskalation, die nach dem Standardverhalten oder Workspace-Regeln eintritt, etwa wenn ein Kunde nach einer Person verlangt (Intercom). Ihr Ziel ist nicht, Eskalation zu minimieren. Es ist, Fehler-Eskalationen seltener und geplante Übergaben reibungsloser zu machen. Das ist die Entscheidung im Kern von Automatisieren oder Unterstützen.
Wissenslückenquote.
Wissenslückenquote = Fragen, die die AI aus ihren Quellen nicht sicher beantworten konnte ÷ gestellte Fragen
Die Dokumentation von HelpCrunch etwa definiert eine unbeantwortete Frage als jede Anfrage, die der AI Agent anhand der angebundenen Datenquellen nicht sicher beantworten konnte, und nutzt den Bericht, um blinde Flecken zu finden (HelpCrunch). Welches Tool Sie auch nutzen, die Praxis ist dieselbe: Ordnen Sie Lücken nach Volumen und schreiben oder korrigieren Sie jede Woche den Artikel hinter der größten. Die Lösungsquote ist oft ein verkapptes Inhaltsproblem. Eine aufgeräumte, aktuelle Quelle ist mehr wert als ein besseres Modell, weshalb die Vorbereitung der Support-Daten für AI vor den meisten Feinabstimmungen steht.
Praxisbeispiele nach Funktion
Dieselbe Scorecard liest sich je nach Warteschlange anders.
Kundensupport, Tier 1. Passwort-Resets und Bestellabfragen sollten eine hohe verifizierte Lösung und geringen Aufwand zeigen. Tun sie das nicht, liegt das Problem in der Integration, nicht in der Intelligenz.
Abrechnung und Finanzbetrieb. Das Containment kann großartig aussehen, während die Wiedereröffnungsquote steigt, weil die AI die Rechnung erklärt, das Konto aber nicht sehen kann. Beobachten Sie hier die Wiedereröffnungsquote und die Kosten pro gelöstem Anliegen, nicht das Containment.
IT-Helpdesk. Beschäftigte wiederholen Fragen, wenn sich Schritte ändern. Verfolgen Sie Wiederkontakte pro Person und die Wissenslückenquote, denn veraltete Artikel sind die übliche Ursache.
E-Commerce. „Wo ist meine Bestellung?“ ist eine Abfrage und wird sauber gelöst. Das Risiko ist das verspätete Paket: Die AI meldet „unterwegs“, und der Kunde ruft am nächsten Tag an. Die Wiedereröffnungsquote nach Kontaktgrund macht es sichtbar.
Onboarding und Customer Success. Schweigen ist hier gefährlich. Einem neuen Kunden, der fragt, wie er Kontakte importiert, und nie antwortet, wurde nicht geholfen. Koppeln Sie die Lösung mit einem Aktivierungssignal aus dem Produkt.
So bauen Sie die Scorecard Schritt für Schritt
- Definieren Sie Kontakt und Lösung schriftlich. Je ein Satz. Kontakt = ein Kundenanliegen, kein Systemereignis. Lösung = richtige Antwort oder erledigte Aufgabe, keine menschliche Antwort, kein Wiederkontakt innerhalb des Zeitfensters.
- Wählen Sie die Nenner. Entscheiden Sie, ob Sie durch alle AI-Konversationen, versuchte Konversationen oder Konversationen im Geltungsbereich teilen. Setzen Sie die Wahl als Fußnote unter jeden Bericht.
- Versehen Sie jede Konversation mit einem Kontaktgrund. Ohne Themen-Tags können Sie nicht segmentieren, und ein Gesamtdurchschnitt verbirgt die Themen, bei denen die AI versagt.
- Richten Sie die Prüfung auf Wiederkontakte ein. Gleichen Sie Kunden-ID und Thema über Chat, E-Mail und Telefon ab. Das ist die einzelne Ergänzung mit dem höchsten Wert.
- Richten Sie die Stichprobenprüfung ein. Ein Prüfender liest jede Woche eine Zufallsmenge „gelöster“ Konversationen und bewertet sie als richtig, teilweise richtig oder falsch. Geben Sie die falschen an Ihren Prozess der Qualitätssicherung (QA) weiter.
- Teilen Sie CSAT und Aufwand nach Bearbeiter. Nur AI, nur Mensch und AI-dann-Mensch sind drei verschiedene Populationen.
- Berechnen Sie die Kosten auf beide Arten. Kosten pro Kontakt und Kosten pro gelöstem Anliegen, jeden Monat nebeneinander.
- Setzen Sie Schwellenwerte pro Thema, nicht global. Ein pauschales Ziel drängt die AI in Themen, die sie nicht anfassen sollte, etwa Erstattungen, Recht und Sicherheit.
- Prüfen Sie die Definitionen vierteljährlich. Neue Kanäle, neue Tool-Aktionen und Regeländerungen der Anbieter verschieben, was zählt.
Zur Reihenfolge beim Rollout, einschließlich der Frage, welche Kennzahlen Sie vor dem Start als Baseline erfassen, siehe AI im Kundenservice einführen.
Eine Scorecard-Vorlage zum Kopieren
Tragen Sie in die Spalten Ziel und Verantwortlicher Ihre eigenen Zahlen ein. Die Spalte „Warnsignal“ ist das Muster, das Ihnen zeigt, dass die Kennzahl manipuliert oder missdeutet wird.
| Kennzahl | Rhythmus | Verantwortlicher | Ziel (Ihres) | Warnsignal |
|---|---|---|---|---|
| Containment-Rate | Wöchentlich | Support Operations | Pro Thema festlegen | Steigt, während CSAT fällt |
| Verifizierte Lösungsquote | Wöchentlich | Support Operations | Pro Thema festlegen | Abstand zum Containment wächst |
| Wiedereröffnungs- und Wiederkontaktquote | Wöchentlich | Support Operations | Unter Ihrer Baseline | Derselbe Kunde, neuer Kanal |
| CSAT (AI) vs. CSAT (Mensch) | Wöchentlich | Support-Leitung | AI im Rahmen des menschlichen Werts | Niedrige Antwortquote bei AI |
| Kundenaufwand | Monatlich | Support-Leitung | Pro Thema | Hohe Nachrichtenzahl pro Lösung |
| Übergabequalität | Wöchentliche Stichprobe | QA | Die meisten Übergaben sauber | Kunden müssen sich wiederholen |
| Kosten pro Kontakt | Monatlich | Finanzen + Support | Trend, kein Versprechen | Sinken ohne Änderung der Lösung |
| Kosten pro gelöstem Anliegen | Monatlich | Finanzen + Support | Trend, kein Versprechen | Weicht nach oben von den Kosten pro Kontakt ab |
| Bearbeitungszeit nach Grund | Monatlich | Support-Leitung | Pro Grund | Sinkt, während die Wiedereröffnungsquote steigt |
| Eskalationsrate (geplant vs. Fehler) | Wöchentlich | Support Operations | Anteil der Fehler sinkt | Nahe null ohne sichtbaren Ausgang |
| Wissenslückenquote | Wöchentlich | Wissensverantwortlicher | Sinkend | Größte Lücke einen Monat unverändert |
Fallstricke, die Sie vermeiden sollten
Containment allein feiern. Sie ist die Kennzahl, die am ehesten gut aussieht, während Kunden leiden. Zeigen Sie sie nie ohne die verifizierte Lösung daneben.
AI- und menschlichen CSAT vermischen. Die Mischung verbirgt die Seite, die Schwierigkeiten hat. Trennen Sie ihn.
Den Nenner driften lassen. Der Wechsel von „allen Konversationen“ zu „Konversationen im Geltungsbereich“ in einem späteren Quartal hebt jede Rate ohne echte Verbesserung.
Die Bearbeitungszeit um ihrer selbst willen optimieren. Wenn die AI die leichte Arbeit übernimmt, werden die verbleibenden menschlichen Kontakte länger. Beurteilen Sie das Team nach Lösung und Zufriedenheit je Kontaktgrund.
Kontakte statt Anliegen zählen. Die Kosten pro Kontakt belohnen es, ein Problem in mehrere Berührungen zu zerlegen. Nutzen Sie die Kosten pro gelöstem Anliegen als Gegenprobe.
Dem Hersteller-Dashboard als ganzer Wahrheit vertrauen. Plattformen definieren Lösung unterschiedlich, vergleichen Sie also Ihren eigenen Trend unter einer festen Definition. Führen Sie eine manuelle Stichprobe, denn ein Modell, das ein Modell bewertet, kann dessen blinde Flecken teilen.
Das Risiko ignorieren. Kennzahlen beschreiben Qualität, nicht Schaden. Eine falsche Erstattungszusage kann jedes Dashboard passieren. Lesen Sie die Risiken von AI im Kundenservice neben der Scorecard und ergänzen Sie eine Zählung markierter Vorfälle.
Häufig gestellte Fragen zu AI-Kennzahlen im Kundenservice
Welche AI-Kennzahlen im Kundenservice sind am wichtigsten?
Beginnen Sie mit fünf: Containment, verifizierte Lösung, Wiedereröffnungs- oder Wiederkontaktquote, CSAT getrennt nach AI und Mensch sowie Kosten pro gelöstem Anliegen. Zusammen zeigen sie, ob die AI einen Menschen vermieden, das Problem gelöst, danach Bestand hatte, den Kunden zufriedenstellte und weniger kostete als die Alternative.
Wie berechne ich die Containment-Rate?
Teilen Sie die Zahl der AI-Konversationen, die nie einen Menschen einbezogen, durch die Gesamtzahl der AI-Konversationen. Ziehen Sie dann die Konversationen mit erneutem Kontakt zum selben Anliegen ab, um die verifizierte Lösungsquote zu erhalten. Containment allein sagt nicht, ob dem Kunden geholfen wurde.
Was ist der Unterschied zwischen Kosten pro Kontakt und Kosten pro Lösung?
Die Kosten pro Kontakt teilen die gesamten Supportkosten durch die bearbeiteten Kontakte, daher senkt es sie, ein Anliegen in mehrere Berührungen zu zerlegen. Die Kosten pro gelöstem Anliegen teilen durch tatsächlich gelöste Anliegen und lassen sich so nicht senken. Verfolgen Sie beide und gehen Sie der Sache nach, wenn sie auseinanderlaufen.
Sollten AI- und menschlicher CSAT getrennt berichtet werden?
Ja. Es sind unterschiedliche Populationen mit unterschiedlichem Antwortverhalten, und ein vermischter Wert verbirgt die schwächere Seite. Zeigen Sie neben jedem Wert die Antwortquote, denn ein hoher Wert bei sehr wenigen Antworten sagt wenig über die Kunden, die geschwiegen haben.
Wie oft sollte ich diese Kennzahlen prüfen?
Prüfen Sie Ergebnis- und Abdeckungskennzahlen wöchentlich, da sie sich am schnellsten ändern und Inhaltskorrekturen antreiben. Prüfen Sie Kosten, Aufwand und Bearbeitungszeit monatlich. Überprüfen Sie Ihre Definitionen vierteljährlich oder immer dann, wenn Sie einen Kanal hinzufügen, der AI neue Aktionen erlauben oder Einstellungen beim Anbieter ändern.
Was ist die Wissenslückenquote?
Sie ist der Anteil der Kundenfragen, die die AI aus ihren angebundenen Quellen nicht sicher beantworten konnte. Ordnen Sie die unbeantworteten Fragen nach Volumen und beheben Sie jede Woche die größte Lücke, indem Sie den zugrunde liegenden Artikel schreiben oder aktualisieren. Eine sinkende Lückenquote ist das früheste Zeichen, dass sich die Lösung bei diesem Thema bald verbessert.

Customer Success Operations Manager
On this page
- Wichtige Fakten
- Die Scorecard auf einen Blick
- Ergebniskennzahlen: Ist das Problem verschwunden?
- Ein durchgerechnetes Beispiel (hypothetisch)
- Erlebniskennzahlen: Wie hat es sich angefühlt?
- Effizienzkennzahlen: Was hat es gekostet und was hat es freigesetzt?
- Abdeckungskennzahlen: Wo hört die AI auf?
- Praxisbeispiele nach Funktion
- So bauen Sie die Scorecard Schritt für Schritt
- Eine Scorecard-Vorlage zum Kopieren
- Fallstricke, die Sie vermeiden sollten