AIカスタマーサービスの指標:コンテインメント、解決、CSAT、問い合わせあたりのコスト
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AIカスタマーサービスの指標とは、AIが顧客の問題を解決できているか、どの品質で、どのコストで解決しているかを示す、少数の数値のことです。 1つの数値でそれが分かることはありません。コンテインメントは、人が介入しなかったことを示します。解決は、問題が解消したことを示します。CSATは、顧客がどう感じたかを示します。問い合わせあたりのコストは、何を要したかを示します。どれか1つが健全に見えていても、別の指標が静かに悪化していることがあります。そのため、すべての指標にその死角を補うパートナーがいるスコアカードが、役に立つ単位になります。
このガイドでは、そのスコアカードを紹介します。11の指標、それぞれの計算式、仮の数値を使った具体的な計算例、落とし穴、そしてレポートに貼り付けられるテンプレートの表です。コンテインメント、デフレクション、解決の違いを詳しく知りたい方は、AIの解決率をお読みください。ここではそれらの定義を使い、先に進みます。サポートのどこにAIが適合するかという広い全体像については、まずカスタマーサービスにおけるAIの概要をご覧ください。
重要なポイント
- 健全なAIスコアカードには、4つのグループに分かれた11の指標があります。成果(コンテインメント、解決、再オープン率)、体験(CSAT、手間、引き継ぎの質)、効率(コスト、対応時間)、カバレッジ(エスカレーション、ナレッジのギャップ)です。
- すべての指標にパートナーが必要です。コンテインメントは解決と、CSATは人間のベースラインと、問い合わせあたりのコストは解決した問題あたりのコストと組み合わせます。
- 「問い合わせ」の数え方を変えると、実際には何も変わっていなくても、問い合わせあたりのコストは動きます。顧客の問題1件として定義し、固定してください(Gladly)。
- カスタマーサポート担当者を対象とした大規模な調査では、AIによる支援で1時間あたりの解決件数が平均14%向上し、新人や低スキルの担当者では34%向上しました(NBER)。
- Zendesk自身の平均対応時間に関するガイダンスは、数値が低いことが良いパフォーマンスを意味するわけではないと警告しており、CSAT、初回解決率、顧客の手間と並べて読むよう勧めています(Zendesk)。
- 各指標は、分母を横に書いて報告してください。分母を変えることは、成果をつくり出す最も簡単な方法です。
スコアカードの全体像
詳細に入る前に、全体を示します。「組み合わせる指標」の列は、その指標を正直に保つためのルールとして扱ってください。
| グループ | 指標 | 計算式 | 組み合わせる指標 |
|---|---|---|---|
| 成果 | コンテインメント率 | 人が関与しなかった会話 ÷ AIの会話 | 解決率 |
| 成果 | 検証済み解決率 | 解決され、繰り返されなかった会話 ÷ AIの会話 | 再オープン率、サンプルレビュー |
| 成果 | 再オープン率 / 再問い合わせ率 | 解決済みの会話のうち、同じ問題で再問い合わせがあったもの ÷ 解決済みの会話 | 解決率 |
| 体験 | CSAT(AIと人間の比較) | 満足の回答 ÷ 全回答(対応者別に分割) | 回答率 |
| 体験 | 顧客の手間 | 手間の評価の合計 ÷ アンケート回答数 | CSAT |
| 体験 | 引き継ぎの質 | 担当者が再度質問しなかった引き継ぎ ÷ 引き継ぎ件数 | エスカレーション率 |
| 効率 | 問い合わせあたりのコスト | サポートコストの合計 ÷ 問い合わせ件数 | 解決した問題あたりのコスト |
| 効率 | 解決した問題あたりのコスト | サポートコストの合計 ÷ 解決した問題の件数 | 問い合わせあたりのコスト |
| 効率 | 担当者の対応時間への影響 | AIアシストありとなしでの平均対応時間 | CSAT、再オープン率 |
| カバレッジ | エスカレーション率 | 人に引き継がれた会話 ÷ AIの会話 | コンテインメント |
| カバレッジ | ナレッジギャップ率 | AIがソースから答えられなかった質問 ÷ 尋ねられた質問 | トピック別の解決 |
一覧は長いですが、ほとんどのチームは、このうち5〜6個を毎週、残りを毎月確認しています。以下では、グループごとに見ていきます。
成果の指標:問題は解消したか
コンテインメント率は、人にまったく届かなかったAIの会話の割合です。
コンテインメント = 人が関与しなかった会話 ÷ AIの会話の合計
最も計算しやすく、最も読み違えやすい指標です。あきらめた顧客は、コンテインされたことになります。誤った回答を受け取ってウィンドウを閉じた顧客も、コンテインされたことになります。米国消費者金融保護局の銀行チャットボットに関するレポートは、人間への出口がないまま、繰り返される役に立たない応答の「doom loop」(抜け出せない堂々巡り)に陥った顧客を取り上げており、チャットボットがニーズを満たせなかったあとで人につながる必要があった消費者が78%に上るという調査を引用しています(CFPB)。そうした顧客の一部は、誰かのコンテインメントの数字の中に、成功として含まれています。
検証済み解決率は、失敗を取り除いたコンテインメントです。
検証済み解決 = (コンテインされた会話 − 同じ問題で再問い合わせがあった会話 − レビュアーが誤りと評価した会話)÷ AIの会話の合計
「解決」をどう判断するかは、設計上の選択です。たとえばIntercomは、解決率を、AIエージェントが人の関与なしに解決した会話の割合と定義し、顧客が回答を確認した場合、またはそれ以上の支援を求めずに離れた場合を解決として数えます(Intercom)。これは妥当な運用ルールですが、沈黙を成功として数えるため、ベンダーの数値の上に、ご自身の再問い合わせチェックを重ねてください。
再オープン率または再問い合わせ率は、静かな失敗を捉えます。
再オープン率 = 解決済みの会話のうち、設定した期間内に同じ問題で再問い合わせがあったもの ÷ 解決済みの会話
チケット管理ツールでは、再オープンは標準のイベントです。Zendeskは、再オープンされたチケットを、解決後に再び開かれたものと定義しています(Zendesk)。AIの場合、顧客は何も再オープンしないことが多く、新しいチャットを開き、メールを送り、あるいは電話をかけてきます。そのため、チケットIDではなく、チャネルをまたいで顧客とトピックで照合し、問題に合った期間を選んでください。パスワードのリセットなら数日、請求に関する争いなら数週間です。
具体的な計算例(仮の数値)
ある月に、AIとの会話が10,000件始まったとします。
- 6,000件がコンテインされ、4,000件が人に引き継がれます(コンテインメント60%、エスカレーション40%)。
- コンテインされた6,000件のうち、900人の顧客が7日以内に別のチャネルから同じ問題で戻ってきます。
- 検証済み解決は(6,000 − 900)÷ 10,000 = 51%です。
見出しの数字は60%ですが、説明がつく数字は51%です。どちらも事実ですが、予算の根拠に使うべきなのは一方だけです。毎週、無作為のサンプルを人がレビューすれば、さらに下がるかもしれません。それは、ツール自身の集計がどれだけ楽観的かについての有益な情報です。
体験の指標:どう感じられたか
CSAT(AIと人間で分割)。 標準的な計算は、満足の回答を全回答で割り、100を掛けるものです。多くのチームは、5段階評価の上位2つ、または2択評価の「良い」の票を数えます。間違いは、AIと人間を混ぜた1つのCSATを公表することです。AIが対応した会話と人間が対応した会話のスコアを別々に報告し、それぞれの横に回答率を示してください。ボットの悪い回答を受けたばかりの顧客は、人と話した顧客よりもアンケートに答えにくいからです。回答率4%でAIのCSATが高くても、分かるのはその4%のことだけです。
アンケートが届く前に満足度を知りたい場合は、会話のシグナルからモデル化する方法をAIによるCSATの予測で解説しています。予測されたスコアは、見直すきっかけとして扱い、尋ねることの代わりにはしないでください。
顧客の手間。 Customer Effort Scoreは、顧客が必要なものを得るためにかかる手間を測ります。標準的な尺度では、ZendeskはCESの評価の合計をアンケート回答数で割る式を示しており、スコアが高いことは手間が少ないことを示すと述べています(Zendesk)。尺度の向きはベンダーによって逆のこともあるため、2つのレポートを比較する前に、どちらの端が「楽」なのかを書き留めてください。手間は、形式上は答えているものの、答えるのに9通のメッセージを要する、長くて丁寧なボットを明らかにする指標です。
引き継ぎの質。 AIが引き継いだとき、人はやり直す必要がありましたか。
引き継ぎの質 = 担当者が会話の要約を持ち、顧客を特定でき、質問を繰り返さなかった引き継ぎ ÷ 引き継ぎの合計
これはダッシュボードからではなく、引き継ぎをサンプリングして測定します。毎週20件を読み、それぞれに「はい」か「いいえ」を付けてください。探しているのは、ボットに問題を説明し、さらに人にも同じ説明をする顧客というパターンです。その繰り返しは、誤答よりも早く信頼を損ないます。AIのエージェントアシストは、スレッドを担当者向けに要約することで、きれいな引き継ぎを可能にする機能です。
効率の指標:何にコストがかかり、何が空いたか
問い合わせあたりのコストは、最も単純な効率の数値です。
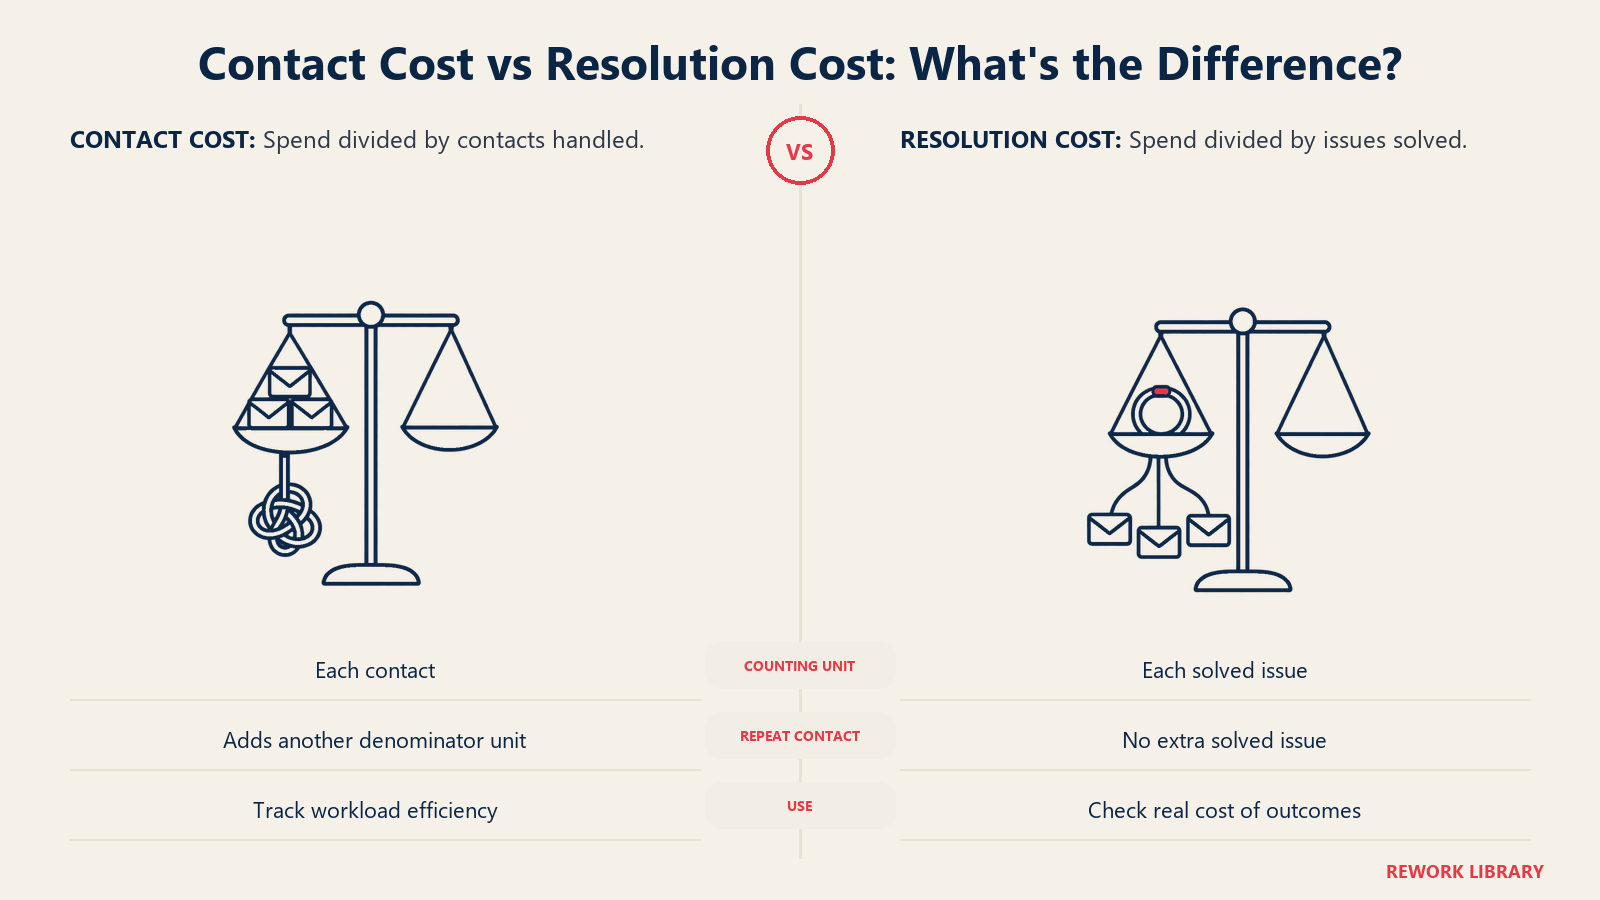
問い合わせあたりのコスト = 期間中のサポート運営コストの合計 ÷ 期間中に対応した問い合わせの合計
Gladlyの具体例は、月に100,000ドルを費やして10,000件の問い合わせに対応するチームで、問い合わせ1件あたり10.00ドルというものです。同じページが、重要な点を指摘しています。チケットベースのシステムは新しいチケットをすべて数えますが、会話ベースのシステムはスレッド全体を1件と数えます。接点をすべて数えると、顧客体験は変わらないのに、報告されるコストは下がります。助言は、問い合わせを顧客の問題1件として定義し、その定義を固定することです(Gladly)。
解決した問題あたりのコストは、より厳しく、より正直な版です。作業を細かく分けても下がらないからです。
解決した問題あたりのコスト = サポート運営コストの合計 ÷ 実際に解決した問題(AIまたは人間による)
先ほどの仮の例を続けます。その月のサポートコストの合計を120,000ドルと仮定します。900件の再問い合わせも実際の問い合わせなので、合計で10,900件となり、問い合わせあたりのコストは約11.01ドルです。エスカレーションされた4,000件のうち3,600件と、再問い合わせの900件すべてを人が解決するため、解決した問題は5,100 + 3,600 + 900 = 9,600件になります。解決した問題あたりのコストは120,000ドル ÷ 9,600 = 12.50ドルです。後者のほうが高いのは、再問い合わせがお得に見えることを許さないからです。両方を追跡してください。両者が乖離するときは、AIが余分な問い合わせを生み出しています。
コストの入力値、たとえば何を分子に含めるか、AIプラットフォームの利用料をどう位置づけるかについては、AIカスタマーサービスのコストをご覧ください。
担当者の対応時間への影響。 平均対応時間は通常、通話時間と保留時間とフォローアップ作業を足し、対応した問い合わせの件数で割ったものとして表されます(Zendesk)。AIが加わると、2つのことが変わります。1つ目は、AIが単純な問い合わせを吸収するため、人間に残るキューはより難しくなり、システムが機能していても平均対応時間が延びうることです。2つ目は、アシストツールが1件ごとの所要時間を短縮するはずだということです。両方を測定してください。問い合わせ理由別の対応時間を導入の前後で比較することと、担当者の1時間あたりの解決件数です。
アシストの効果についての外部のエビデンスもあります。生成AIアシスタントを使うカスタマーサポート担当者の調査では、1時間あたりの解決件数が平均14%増え、新人や低スキルの担当者では34%向上し、経験豊富な担当者への影響はわずかでした(NBER)。これはその調査の結果であり、皆さんのチームの目標ではありませんが、対応時間を経験レベル別に読むべき理由を示しています。効果は均等には現れないからです。この指標に関するZendeskのガイダンスも、担当者に問い合わせを短くするよう迫ると品質が損なわれうるため、対応時間が低いことが良いパフォーマンスを意味するわけではないと注意を促しており、CSATや手間と並べて読むよう勧めています(Zendesk)。
カバレッジの指標:AIはどこで止まるか
エスカレーション率。
エスカレーション率 = 人に引き継がれた会話 ÷ AIの会話
理想的な数値というものはありません。ゼロに近い率は、AIが優秀であることを意味する場合もあれば、出口を隠していることを意味する場合もあります。エスカレーションを2種類に分けてください。設計された引き継ぎは、設定したルールによって起こります。たとえば、一定額を超える返金はすべて人に回す、といったものです。失敗によるエスカレーションは、顧客が人を求めた、苛立ちを示した、あるいはAIが対応できないものに当たったために起こります。Intercomのドキュメントも、設定された手順によって引き起こされる引き継ぎと、顧客が人を求めるなど、デフォルトの動作やワークスペースのルールのもとで発生するエスカレーションとの間に、同様の線を引いています(Intercom)。目標は、エスカレーションを最小化することではなく、失敗によるエスカレーションを減らし、設計された引き継ぎをよりスムーズにすることです。これは、自動化か支援かの判断の核心です。
ナレッジギャップ率。
ナレッジギャップ率 = AIがソースから自信を持って答えられなかった質問 ÷ 尋ねられた質問
たとえばHelpCrunchのドキュメントは、未解決の質問を、接続されたデータソースに基づいてAIエージェントが自信を持って答えられなかったあらゆる問い合わせと定義し、そのレポートを使って死角を見つけるとしています(HelpCrunch)。どのツールを使う場合でも、やることは同じです。ギャップを件数順に並べ、毎週、最大のギャップの背後にある記事を書くか直します。解決率は、多くの場合、コンテンツの問題が姿を変えたものです。整理された最新のソースは、より良いモデルよりも価値があります。これが、サポートデータの準備が多くのチューニングより先に来る理由です。
職種別の実例
同じスコアカードでも、キューによって読み方が変わります。
カスタマーサポート(ティア1)。 パスワードのリセットや注文の照会は、検証済み解決率が高く、手間が少ないはずです。そうでなければ、問題は知能ではなく連携にあります。
請求・経理オペレーション。 コンテインメントは優秀に見えても、再オープン率は上昇していることがあります。AIは請求書を説明できても、アカウントを見られないためです。ここでは、コンテインメントではなく、再オープン率と解決した問題あたりのコストを見てください。
ITヘルプデスク。 手順が変わると、従業員は同じ質問を繰り返します。古い記事が通常の原因なので、1人あたりの再問い合わせとナレッジギャップ率を追跡してください。
Eコマース。 「注文はどこですか」は照会であり、きれいに解決します。リスクは遅延した荷物です。AIが「配送中」と伝え、顧客は翌日に電話をかけてきます。問い合わせ理由別の再オープン率がそれを示します。
オンボーディングとカスタマーサクセス。 ここでは沈黙が危険です。連絡先のインポート方法を尋ねて、そのまま返信しない新規顧客は、助けられたわけではありません。解決を、プロダクトからのアクティベーションのシグナルと組み合わせてください。
スコアカードを段階的に構築する方法
- 問い合わせと解決を文書で定義する。 それぞれ一文で定義します。問い合わせ = システム上のイベントではなく、顧客の問題。解決 = 正しい回答または完了したタスクで、人の返信がなく、期間内に再問い合わせがないこと。
- 分母を選ぶ。 AIの会話すべてで割るのか、試行された会話で割るのか、対象範囲内の会話で割るのかを決めます。その選択を、すべてのレポートの脚注に入れてください。
- すべての会話に問い合わせ理由のタグを付ける。 トピックのタグがなければ、セグメント化できず、全体の平均は、AIが失敗しているトピックを隠してしまいます。
- 再問い合わせのチェックを組み込む。 チャット、メール、電話をまたいで、顧客IDとトピックを照合します。これが、最も価値の高い唯一の追加です。
- サンプルレビューを設ける。 レビュアーが毎週、「解決済み」の会話から無作為のセットを読み、正しい、一部正しい、誤りのいずれかで評価します。誤りは品質保証のプロセスに回してください。
- CSATと手間を対応者別に分割する。 AIのみ、人間のみ、AIの後に人間という3つは、それぞれ別の母集団です。
- コストを両方の方法で計算する。 問い合わせあたりのコストと解決した問題あたりのコストを、毎月並べて計算します。
- しきい値は全体ではなくトピックごとに設定する。 一律の目標は、返金、法務、安全といった、AIが触れるべきでない領域にAIを押し込みます。
- 定義を四半期ごとに見直す。 新しいチャネル、新しいツールのアクション、ベンダーのルール変更は、すべて何が数えられるかを動かします。
展開の順序、たとえば導入前にどの指標のベースラインを取るべきかについては、カスタマーサービスへのAI導入をご覧ください。
そのまま使えるスコアカードのテンプレート
目標と担当者の列には、ご自身の数値を入れてください。「危険信号」の列は、その指標が操作されている、または読み違えられていることを示すパターンです。
| 指標 | 頻度 | 担当者 | 目標(各社で設定) | 危険信号 |
|---|---|---|---|---|
| コンテインメント率 | 毎週 | サポートオペレーション | トピックごとに設定 | CSATが下がる中で上昇している |
| 検証済み解決率 | 毎週 | サポートオペレーション | トピックごとに設定 | コンテインメントとの差が広がっている |
| 再オープン率 / 再問い合わせ率 | 毎週 | サポートオペレーション | ベースラインを下回る | 同じ顧客が別のチャネルから来ている |
| CSAT(AI)とCSAT(人間) | 毎週 | サポートリーダー | AIが人間の範囲内 | AIの回答率が低い |
| 顧客の手間 | 毎月 | サポートリーダー | トピックごと | 解決までのメッセージ数が多い |
| 引き継ぎの質 | 毎週(サンプル) | QA | ほとんどの引き継ぎがスムーズ | 顧客が同じ説明を繰り返している |
| 問い合わせあたりのコスト | 毎月 | 経理 + サポート | 約束ではなく傾向 | 解決に変化がないまま下がる |
| 解決した問題あたりのコスト | 毎月 | 経理 + サポート | 約束ではなく傾向 | 問い合わせあたりのコストから上方向に乖離する |
| 理由別の対応時間 | 毎月 | サポートリーダー | 理由ごと | 再オープン率が上がる中で短縮している |
| エスカレーション率(設計と失敗) | 毎週 | サポートオペレーション | 失敗の割合が低下している | 出口が見えないままゼロに近い |
| ナレッジギャップ率 | 毎週 | ナレッジの担当者 | 低下している | 最大のギャップが1か月変わらない |
避けるべき落とし穴
コンテインメントだけを称賛する。 顧客が苦しんでいる間も良く見えやすい指標です。検証済み解決を横に並べずに見せてはいけません。
AIと人間のCSATを混ぜる。 混ぜると、苦戦している側が見えなくなります。分割してください。
分母がずれていく。 後の四半期に「すべての会話」から「対象範囲内の会話」に変えると、実際の改善がないまま、あらゆる率が上がります。
対応時間そのものを最適化する。 AIが簡単な仕事を引き受けると、残る人間の問い合わせは長くなります。チームは、問い合わせ理由別の解決と満足度で評価してください。
問題ではなく問い合わせを数える。 問い合わせあたりのコストは、1つの問題を複数の接点に分けることに報酬を与えます。チェックには、解決した問題あたりのコストを使ってください。
ベンダーのダッシュボードをすべての真実と信じる。 プラットフォームごとに解決の定義が異なるため、1つの固定した定義のもとでご自身の傾向を比較してください。モデルがモデルを評価すると、死角を共有しうるので、手作業のサンプルを維持してください。
リスクを無視する。 指標が表すのは品質であり、害ではありません。誤った返金の約束は、あらゆるダッシュボードを通過しうるのです。スコアカードと並べてAIカスタマーサービスのリスクを読み、フラグが立ったインシデントの件数を加えてください。
AIカスタマーサービスの指標に関するよくある質問
AIカスタマーサービスで最も重要な指標は何ですか?
5つから始めてください。コンテインメント、検証済み解決、再オープン率または再問い合わせ率、AIと人間で分割したCSAT、そして解決した問題あたりのコストです。これらを合わせると、AIが人の介入を避けたか、問題を解決したか、その後も持ちこたえたか、顧客を満足させたか、代替手段より低コストだったかが分かります。
コンテインメント率はどう計算しますか?
人がまったく関与しなかったAIの会話の数を、AIの会話の総数で割ります。次に、同じ問題で再問い合わせがあった会話を差し引くと、検証済み解決率になります。コンテインメントだけでは、顧客が助けられたかどうかは分かりません。
問い合わせあたりのコストと解決あたりのコストの違いは何ですか?
問い合わせあたりのコストは、サポートコストの合計を対応した問い合わせで割るため、1つの問題を複数の接点に分けると下がります。解決した問題あたりのコストは、実際に解決した問題で割るため、そのような方法では下げられません。両方を追跡し、乖離したときは調べてください。
AIと人間のCSATは別々に報告すべきですか?
はい。両者は回答の傾向が異なる別の母集団であり、混ぜたスコアは弱い側を隠してしまいます。それぞれのスコアの横に回答率を示してください。回答が非常に少ない中での高いスコアは、沈黙した顧客についてほとんど何も語らないからです。
これらの指標はどのくらいの頻度でレビューすべきですか?
成果とカバレッジの指標は、最も早く変化し、コンテンツの修正につながるため、毎週レビューしてください。コスト、手間、対応時間は毎月レビューします。定義は四半期ごとに、またはチャネルを追加したり、AIに新しいアクションを与えたり、ベンダーの設定を変更したりするたびに見直してください。
ナレッジギャップ率とは何ですか?
AIが接続されたソースから自信を持って答えられなかった顧客の質問の割合です。答えられなかった質問を件数順に並べ、毎週、最大のギャップを、元になる記事を書くか更新することで埋めてください。ギャップ率の低下は、そのトピックの解決が改善に向かう最も早いサインです。

Customer Success Operations Manager