Metrik Perkhidmatan Pelanggan AI: Pembendungan, Penyelesaian, CSAT dan Kos Setiap Hubungan
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Metrik perkhidmatan pelanggan AI ialah set kecil nombor yang memberitahu anda sama ada AI anda menyelesaikan masalah pelanggan, pada kualiti apa dan dengan kos berapa. Tiada satu nombor pun yang mampu berbuat demikian. Pembendungan memberitahu anda bahawa manusia tidak terlibat. Penyelesaian memberitahu anda bahawa masalah itu hilang. CSAT memberitahu anda bagaimana perasaan pelanggan. Kos setiap hubungan memberitahu anda apa yang diperlukan. Setiap satu boleh kelihatan sihat sementara yang lain gagal secara senyap, jadi unit yang berguna ialah kad skor di mana setiap metrik mempunyai pasangan yang menangkap titik butanya.
Panduan ini memberikan anda kad skor itu: sebelas metrik, formula bagi setiap satu, contoh kerja dengan nombor hipotetikal, perangkapnya, dan jadual templat yang boleh anda tampal ke dalam pelaporan anda. Jika anda memerlukan versi panjang tentang perbezaan antara pembendungan, deflection dan penyelesaian, baca kadar penyelesaian AI. Di sini kita menggunakan takrifan tersebut dan terus bergerak. Untuk gambaran yang lebih luas tentang di mana AI sesuai dalam sokongan, mulakan dengan gambaran keseluruhan AI dalam perkhidmatan pelanggan.
Fakta Utama
- Kad skor AI yang sihat mempunyai sebelas metrik dalam empat kumpulan: hasil (pembendungan, penyelesaian, kadar buka semula), pengalaman (CSAT, usaha, kualiti pemindahan), kecekapan (kos, masa pengendalian) dan liputan (eskalasi, jurang pengetahuan).
- Setiap metrik memerlukan pasangan. Pembendungan berpasangan dengan penyelesaian, CSAT berpasangan dengan garis dasar manusia, dan kos setiap hubungan berpasangan dengan kos setiap isu yang diselesaikan.
- Kos setiap hubungan berubah apabila anda mengubah cara "hubungan" dikira, walaupun tiada apa yang benar-benar berubah. Takrifkannya sebagai isu pelanggan dan kekalkannya tetap (Gladly).
- Dalam kajian besar terhadap ejen sokongan pelanggan, bantuan AI meningkatkan isu yang diselesaikan sejam sebanyak 14% secara purata, dengan peningkatan 34% bagi pekerja baharu dan berkemahiran rendah (NBER).
- Panduan Zendesk sendiri tentang purata masa pengendalian memberi amaran bahawa nombor yang rendah tidak bermakna prestasi yang baik, dan menyatakan supaya membacanya bersama CSAT, penyelesaian pada hubungan pertama dan usaha pelanggan (Zendesk).
- Laporkan setiap metrik dengan penyebutnya ditulis di sebelahnya. Mengubah penyebut ialah cara paling mudah untuk mencipta kemajuan palsu.
Kad Skor Sepintas Lalu
Sebelum butirannya, inilah keseluruhan set. Anggaplah lajur "berpasangan dengan" sebagai peraturan yang memastikan metrik itu jujur.
| Kumpulan | Metrik | Formula | Berpasangan dengan |
|---|---|---|---|
| Hasil | Kadar pembendungan | Perbualan tanpa penglibatan manusia ÷ perbualan AI | Kadar penyelesaian |
| Hasil | Kadar penyelesaian yang disahkan | Perbualan yang diselesaikan dan tidak berulang ÷ perbualan AI | Kadar buka semula, semakan sampel |
| Hasil | Kadar buka semula / hubungan berulang | Perbualan yang diselesaikan dan diikuti hubungan berulang tentang isu yang sama ÷ perbualan yang diselesaikan | Kadar penyelesaian |
| Pengalaman | CSAT, AI berbanding manusia | Respons yang berpuas hati ÷ jumlah respons, dipecahkan mengikut siapa yang mengendalikannya | Kadar respons |
| Pengalaman | Usaha pelanggan | Jumlah penilaian usaha ÷ respons tinjauan | CSAT |
| Pengalaman | Kualiti pemindahan | Penyerahan di mana ejen tidak bertanya semula ÷ penyerahan | Kadar eskalasi |
| Kecekapan | Kos setiap hubungan | Jumlah kos sokongan ÷ hubungan | Kos setiap isu yang diselesaikan |
| Kecekapan | Kos setiap isu yang diselesaikan | Jumlah kos sokongan ÷ isu yang diselesaikan | Kos setiap hubungan |
| Kecekapan | Kesan masa pengendalian ejen | Purata masa pengendalian dengan bantuan AI berbanding tanpa | CSAT, kadar buka semula |
| Liputan | Kadar eskalasi | Perbualan yang diserahkan kepada manusia ÷ perbualan AI | Pembendungan |
| Liputan | Kadar jurang pengetahuan | Soalan yang tidak dapat dijawab oleh AI daripada sumbernya ÷ soalan yang ditanya | Penyelesaian mengikut topik |
Senarainya panjang, tetapi kebanyakan pasukan menyemak lima atau enam daripadanya setiap minggu dan selebihnya setiap bulan. Bahagian di bawah menerangkan kumpulan demi kumpulan.
Metrik Hasil: Adakah Masalah Itu Hilang?
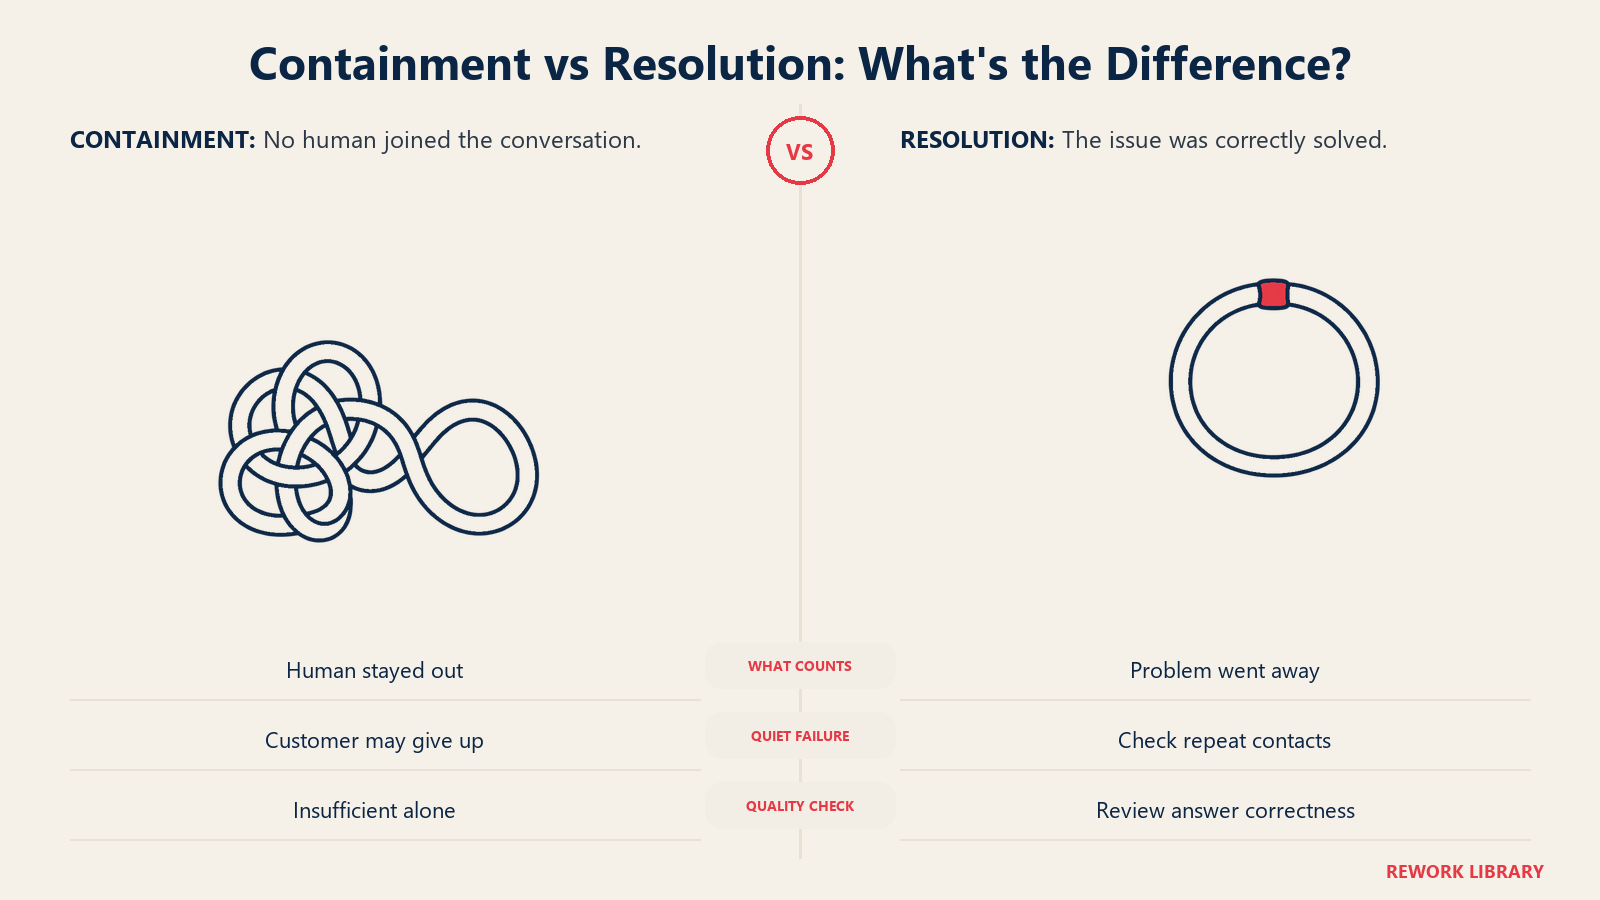
Kadar pembendungan ialah bahagian perbualan AI yang tidak pernah sampai kepada manusia.
Pembendungan = perbualan tanpa penglibatan manusia ÷ jumlah perbualan AI
Ia metrik yang paling mudah dikira dan paling mudah disalah baca. Pelanggan yang berputus asa dibendung. Pelanggan yang mendapat jawapan salah dan menutup tetingkap dibendung. Laporan Consumer Financial Protection Bureau tentang chatbot bank menerangkan pelanggan yang terperangkap dalam "kitaran tanpa jalan keluar" respons berulang yang tidak membantu tanpa jalan keluar kepada manusia, dan memetik tinjauan di mana 78% pengguna perlu berhubung dengan manusia selepas chatbot gagal memenuhi keperluan mereka (CFPB). Sebahagian daripada pelanggan itu berada dalam nombor pembendungan seseorang sebagai kejayaan.
Kadar penyelesaian yang disahkan ialah pembendungan dengan kegagalan disingkirkan.
Penyelesaian yang disahkan = (perbualan yang dibendung − perbualan yang diikuti hubungan berulang tentang isu yang sama − perbualan yang dinilai salah oleh penyemak) ÷ jumlah perbualan AI
Cara anda menilai "diselesaikan" ialah pilihan reka bentuk. Intercom, sebagai contoh, mentakrifkan kadar penyelesaiannya sebagai peratusan perbualan yang diselesaikan oleh ejen AI-nya tanpa penglibatan manusia, dan mengira penyelesaian apabila pelanggan mengesahkan jawapan atau pergi tanpa meminta bantuan lanjut (Intercom). Itu peraturan operasi yang munasabah, tetapi ia mengira kesenyapan sebagai kejayaan, jadi jalankan semakan hubungan berulang anda sendiri di atas apa-apa angka vendor.
Kadar buka semula atau hubungan berulang menangkap kegagalan senyap.
Kadar buka semula = perbualan yang diselesaikan dan diikuti hubungan berulang tentang isu yang sama dalam tetingkap anda ÷ perbualan yang diselesaikan
Dalam alat tiket, buka semula ialah peristiwa asli. Zendesk mentakrifkan tiket yang dibuka semula sebagai tiket yang dibuka semula selepas diselesaikan (Zendesk). Dengan AI, pelanggan selalunya tidak membuka semula apa-apa. Mereka membuka sembang baharu, menghantar e-mel atau menelefon anda. Maka padankan mengikut pelanggan dan topik merentas saluran, bukan mengikut ID tiket, dan pilih tetingkap yang sesuai dengan isu itu: beberapa hari untuk tetapan semula kata laluan, beberapa minggu untuk pertikaian pengebilan.
Contoh kerja (hipotetikal)
Katakan 10,000 perbualan bermula dengan AI anda dalam sebulan.
- 6,000 dibendung dan 4,000 diserahkan kepada manusia (pembendungan 60%, eskalasi 40%).
- Daripada 6,000 yang dibendung, 900 pelanggan kembali melalui saluran lain dalam tempoh tujuh hari tentang isu yang sama.
- Penyelesaian yang disahkan ialah (6,000 − 900) ÷ 10,000 = 51%.
Tajuk utama mengatakan 60%. Nombor yang boleh dipertahankan ialah 51%. Kedua-duanya benar, tetapi hanya satu yang patut ada dalam kes bajet. Tambah semakan manusia mingguan terhadap sampel rawak dan anda mungkin mengurangkannya lagi, yang merupakan maklumat berguna tentang betapa optimistiknya kiraan alat anda sendiri.
Metrik Pengalaman: Bagaimana Rasanya?
CSAT, dipecahkan mengikut AI dan manusia. Pengiraan standard ialah respons yang berpuas hati dibahagi jumlah respons, didarab 100. Kebanyakan pasukan mengira dua kotak teratas pada skala lima mata, atau undi "baik" pada skala binari. Kesilapannya ialah menerbitkan satu CSAT gabungan. Laporkan skor bagi perbualan yang dikendalikan AI dan perbualan yang dikendalikan manusia secara berasingan, dan tunjukkan kadar respons di sebelah setiap satu, kerana pelanggan yang baru mendapat jawapan bot yang buruk kurang berkemungkinan mengisi tinjauan berbanding pelanggan yang bercakap dengan seorang manusia. CSAT AI yang tinggi pada kadar respons 4% memberitahu anda tentang 4% itu.
Jika anda ingin melihat kepuasan sebelum tinjauan tiba, meramal CSAT dengan AI membincangkan pemodelannya daripada isyarat perbualan. Anggaplah skor yang diramal sebagai dorongan untuk melihat, bukan pengganti bertanya.
Usaha pelanggan. Customer Effort Score mengukur usaha yang diperlukan oleh pelanggan untuk mendapatkan apa yang mereka perlukan. Pada skala standard, Zendesk menulis formulanya sebagai jumlah penilaian CES dibahagi bilangan respons tinjauan, dan menyatakan bahawa skor tinggi menunjukkan usaha yang rendah (Zendesk). Skala berjalan ke kedua-dua arah merentas vendor, jadi tuliskan hujung mana yang "mudah" sebelum anda membandingkan mana-mana dua laporan. Usaha ialah metrik yang mendedahkan bot yang panjang dan sopan yang secara teknikal menjawab dan mengambil sembilan mesej untuk berbuat demikian.
Kualiti pemindahan. Apabila AI menyerahkan, adakah manusia perlu bermula semula?
Kualiti pemindahan = penyerahan di mana ejen mempunyai ringkasan perbualan, mengenal pasti pelanggan dan tidak bertanya semula soalan itu ÷ jumlah penyerahan
Anda mengukur ini dengan mengambil sampel penyerahan, bukan daripada dashboard. Baca dua puluh seminggu dan tandakan setiap satu ya atau tidak. Corak yang anda buru ialah pelanggan yang menerangkan masalahnya kepada bot, kemudian menerangkannya sekali lagi kepada seorang manusia. Pengulangan itu menghakis kepercayaan lebih pantas daripada jawapan yang salah. AI agent assist ialah keupayaan yang membolehkan penyerahan yang bersih dengan meringkaskan utas untuk ejen.
Metrik Kecekapan: Berapa Kosnya dan Apa yang Dibebaskan?
Kos setiap hubungan ialah nombor kecekapan yang paling ringkas.
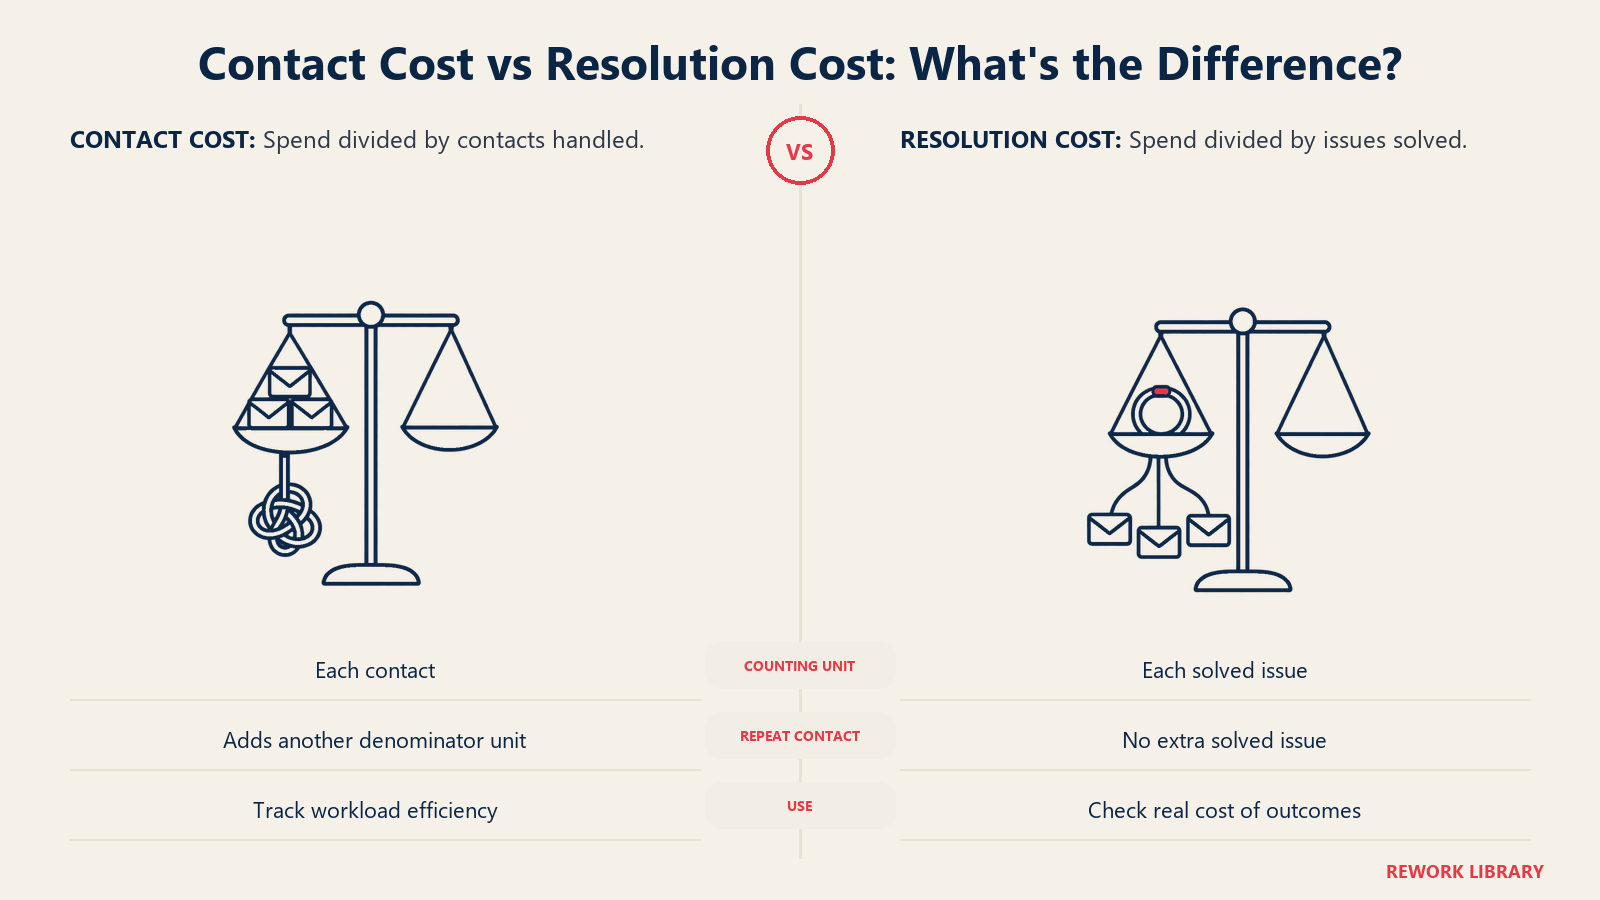
Kos setiap hubungan = jumlah kos operasi sokongan bagi tempoh itu ÷ jumlah hubungan yang dikendalikan dalam tempoh itu
Contoh kerja Gladly ialah pasukan yang membelanjakan $100,000 sebulan dan mengendalikan 10,000 hubungan, iaitu $10.00 setiap hubungan. Halaman yang sama menyatakan perkara yang penting: sistem berasaskan tiket mengira setiap tiket baharu manakala sistem berasaskan perbualan mengira seluruh utas sebagai satu, dan mengira setiap sentuhan merendahkan kos yang dilaporkan tanpa mengubah pengalaman pelanggan. Nasihatnya ialah mentakrifkan hubungan sebagai isu pelanggan dan mengekalkan takrifan itu tetap (Gladly).
Kos setiap isu yang diselesaikan ialah versi yang lebih sukar dan lebih jujur, kerana memecah-mecahkan kerja tidak dapat merendahkannya.
Kos setiap isu yang diselesaikan = jumlah kos operasi sokongan ÷ isu yang benar-benar diselesaikan (oleh AI atau oleh manusia)
Teruskan contoh hipotetikal tadi, dengan jumlah kos sokongan yang diandaikan $120,000 untuk bulan itu. 900 hubungan berulang ialah hubungan sebenar, jadi jumlahnya 10,900, menghasilkan kos setiap hubungan sekitar $11.01. Manusia menyelesaikan 3,600 daripada 4,000 isu yang dieskalasi dan kesemua 900 isu berulang, jadi isu yang diselesaikan berjumlah 5,100 + 3,600 + 900 = 9,600. Kos setiap isu yang diselesaikan ialah $120,000 ÷ 9,600 = $12.50. Nombor kedua lebih tinggi kerana ia tidak membiarkan hubungan berulang kelihatan seperti tawaran murah. Jejaki kedua-duanya. Apabila keduanya berbeza, AI anda sedang mencipta hubungan tambahan.
Untuk input kos itu sendiri, seperti apa yang termasuk dalam pengangka dan bagaimana yuran platform AI dimasukkan, lihat kos perkhidmatan pelanggan AI.
Kesan masa pengendalian ejen. Purata masa pengendalian lazimnya ditulis sebagai masa bercakap ditambah masa menunggu ditambah kerja susulan, dibahagi bilangan hubungan yang dikendalikan (Zendesk). Dengan AI dalam campuran, dua perkara berubah. Pertama, AI menyerap hubungan yang mudah, jadi barisan gilir manusia yang tinggal lebih sukar dan purata masa pengendalian mereka boleh meningkat walaupun sistem berfungsi. Kedua, alat bantuan patut memendekkan masa pada setiap hubungan. Ukur kedua-duanya: masa pengendalian mengikut sebab hubungan sebelum dan selepas, dan isu yang diselesaikan bagi setiap jam ejen.
Bukti luar untuk kesan bantuan wujud. Kajian terhadap ejen sokongan pelanggan yang menggunakan pembantu AI generatif mendapati peningkatan purata 14% dalam isu yang diselesaikan sejam, peningkatan 34% bagi pekerja baharu dan berkemahiran rendah, dan kesan minimum terhadap pekerja berpengalaman (NBER). Itu keputusan kajian tersebut, bukan sasaran untuk pasukan anda, tetapi ia menunjukkan mengapa anda patut membaca masa pengendalian mengikut tahap pengalaman: peningkatan tidak tersebar sama rata. Panduan Zendesk tentang metrik ini juga memberi amaran bahawa masa pengendalian yang rendah tidak bermakna prestasi yang baik, kerana mendesak ejen memendekkan hubungan boleh menjejaskan kualiti, jadi bacalah di sebelah CSAT dan usaha (Zendesk).
Metrik Liputan: Di Mana AI Berhenti?
Kadar eskalasi.
Kadar eskalasi = perbualan yang diserahkan kepada manusia ÷ perbualan AI
Tiada nombor yang ideal. Kadar yang hampir sifar boleh bermakna AI cemerlang atau ia menyembunyikan jalan keluar. Pecahkan eskalasi kepada dua jenis. Penyerahan yang direka berlaku kerana anda mengkonfigurasi peraturan, seperti setiap bayaran balik melebihi jumlah tertentu pergi kepada seorang manusia. Eskalasi kegagalan berlaku kerana pelanggan meminta manusia, menunjukkan kekecewaan atau menemui sesuatu yang tidak dapat dikendalikan oleh AI. Dokumentasi Intercom melukis garis yang serupa antara penyerahan yang dicetuskan oleh prosedur yang dikonfigurasi dengan eskalasi yang berlaku di bawah tingkah laku lalai atau peraturan ruang kerja, seperti pelanggan meminta seseorang (Intercom). Matlamat anda bukan meminimumkan eskalasi. Ia adalah menjadikan eskalasi kegagalan lebih jarang dan penyerahan yang direka lebih lancar. Inilah keputusan di tengah-tengah automasikan atau bantu.
Kadar jurang pengetahuan.
Kadar jurang pengetahuan = soalan yang tidak dapat dijawab oleh AI dengan yakin daripada sumbernya ÷ soalan yang ditanya
Dokumentasi HelpCrunch, sebagai contoh, mentakrifkan soalan yang tidak selesai sebagai sebarang pertanyaan yang tidak dapat dijawab dengan yakin oleh ejen AI berdasarkan sumber data yang disambungkan, dan menggunakan laporan itu untuk mencari titik buta (HelpCrunch). Apa pun alat yang anda gunakan, amalannya sama: susun jurang mengikut isi padu, dan tulis atau baiki artikel di sebalik yang terbesar setiap minggu. Kadar penyelesaian selalunya masalah kandungan yang menyamar. Sumber yang kemas dan terkini lebih bernilai daripada model yang lebih baik, itulah sebabnya menyediakan data sokongan untuk AI mendahului kebanyakan penalaan.
Contoh Sebenar Mengikut Fungsi
Kad skor yang sama dibaca secara berbeza bergantung pada barisan gilir.
Sokongan pelanggan, peringkat 1. Tetapan semula kata laluan dan carian pesanan patut menunjukkan penyelesaian yang disahkan yang tinggi dan usaha yang rendah. Jika tidak, masalahnya ialah integrasi, bukan kecerdasan.
Operasi pengebilan dan kewangan. Pembendungan boleh kelihatan hebat sementara kadar buka semula meningkat, kerana AI menerangkan invois tetapi tidak dapat melihat akaun. Perhatikan kadar buka semula dan kos setiap isu yang diselesaikan di sini, bukan pembendungan.
Meja bantuan IT. Pekerja mengulangi soalan apabila langkah berubah. Jejaki hubungan berulang bagi setiap orang dan kadar jurang pengetahuan, kerana artikel yang lapuk ialah punca yang biasa.
E-dagang. "Di mana pesanan saya?" ialah carian dan diselesaikan dengan bersih. Risikonya ialah bungkusan yang lewat: AI melaporkan "dalam perjalanan" dan pelanggan menelefon keesokan harinya. Kadar buka semula mengikut sebab hubungan menunjukkannya.
Onboarding dan kejayaan pelanggan. Kesenyapan berbahaya di sini. Pelanggan baharu yang bertanya cara mengimport kenalan dan tidak pernah membalas belum dibantu. Gandingkan penyelesaian dengan isyarat pengaktifan daripada produk.
Cara Membina Kad Skor Langkah demi Langkah
- Takrifkan hubungan dan penyelesaian secara bertulis. Satu ayat setiap satu. Hubungan = isu pelanggan, bukan peristiwa sistem. Penyelesaian = jawapan yang betul atau tugas yang selesai, tiada balasan manusia, tiada hubungan berulang dalam tetingkap.
- Pilih penyebut. Putuskan sama ada anda membahagi dengan semua perbualan AI, perbualan yang dicuba atau perbualan dalam skop. Letakkan pilihan itu dalam nota kaki pada setiap laporan.
- Tandakan setiap perbualan dengan sebab hubungan. Tanpa tanda topik, anda tidak dapat membahagikan, dan purata keseluruhan menyembunyikan topik di mana AI gagal.
- Sambungkan semakan hubungan berulang. Padankan ID pelanggan dan topik merentas sembang, e-mel dan telefon. Ini ialah tambahan bernilai tertinggi yang tunggal.
- Sediakan semakan sampel. Seorang penyemak membaca set rawak perbualan "diselesaikan" setiap minggu dan menilainya betul, sebahagiannya betul atau salah. Hantar yang salah ke proses jaminan kualiti anda.
- Pecahkan CSAT dan usaha mengikut pengendali. AI sahaja, manusia sahaja dan AI-kemudian-manusia ialah tiga populasi yang berbeza.
- Kira kos dengan kedua-dua cara. Kos setiap hubungan dan kos setiap isu yang diselesaikan, sebelah-menyebelah, setiap bulan.
- Tetapkan ambang bagi setiap topik, bukan secara global. Sasaran menyeluruh mendorong AI ke dalam subjek yang tidak patut disentuhnya, seperti bayaran balik, undang-undang dan keselamatan.
- Semak takrifan setiap suku tahun. Saluran baharu, tindakan alat baharu dan perubahan peraturan vendor semuanya mengubah apa yang dikira.
Untuk urutan pelancaran, termasuk metrik mana yang perlu ditetapkan garis dasarnya sebelum pelancaran, lihat melaksanakan AI dalam perkhidmatan pelanggan.
Templat Kad Skor yang Boleh Anda Salin
Isi lajur sasaran dan pemilik dengan nombor anda sendiri. Lajur "tanda amaran" ialah corak yang memberitahu anda bahawa metrik itu dimanipulasi atau disalah baca.
| Metrik | Kekerapan | Pemilik | Sasaran (anda) | Tanda amaran |
|---|---|---|---|---|
| Kadar pembendungan | Mingguan | Operasi sokongan | Tetapkan bagi setiap topik | Meningkat sementara CSAT menurun |
| Kadar penyelesaian yang disahkan | Mingguan | Operasi sokongan | Tetapkan bagi setiap topik | Jurang dengan pembendungan melebar |
| Kadar buka semula / hubungan berulang | Mingguan | Operasi sokongan | Di bawah garis dasar anda | Pelanggan sama, saluran baharu |
| CSAT (AI) berbanding CSAT (manusia) | Mingguan | Ketua sokongan | AI dalam lingkungan manusia | Kadar respons rendah pada AI |
| Usaha pelanggan | Bulanan | Ketua sokongan | Bagi setiap topik | Bilangan mesej tinggi bagi setiap penyelesaian |
| Kualiti pemindahan | Sampel mingguan | QA | Kebanyakan penyerahan bersih | Pelanggan mengulangi diri mereka |
| Kos setiap hubungan | Bulanan | Kewangan + sokongan | Aliran, bukan janji | Menurun tanpa perubahan penyelesaian |
| Kos setiap isu yang diselesaikan | Bulanan | Kewangan + sokongan | Aliran, bukan janji | Menyimpang ke atas daripada kos setiap hubungan |
| Masa pengendalian mengikut sebab | Bulanan | Ketua sokongan | Bagi setiap sebab | Menurun sementara kadar buka semula meningkat |
| Kadar eskalasi (direka berbanding kegagalan) | Mingguan | Operasi sokongan | Bahagian kegagalan menurun | Hampir sifar tanpa jalan keluar yang kelihatan |
| Kadar jurang pengetahuan | Mingguan | Pemilik pengetahuan | Menurun | Jurang teratas tidak berubah selama sebulan |
Perangkap yang Perlu Dielakkan
Meraikan pembendungan semata-mata. Ia metrik yang paling berkemungkinan kelihatan baik sementara pelanggan menderita. Jangan sekali-kali menunjukkannya tanpa penyelesaian yang disahkan di sebelahnya.
Menggabungkan CSAT AI dan manusia. Gabungan itu menyembunyikan pihak mana yang bergelut. Pecahkannya.
Membiarkan penyebut berubah. Beralih daripada "semua perbualan" kepada "perbualan dalam skop" pada suku tahun kemudian meningkatkan setiap kadar tanpa sebarang peningkatan sebenar.
Mengoptimumkan masa pengendalian demi dirinya sendiri. Apabila AI mengambil kerja yang mudah, hubungan manusia yang tinggal lebih panjang. Nilai pasukan berdasarkan penyelesaian dan kepuasan mengikut sebab hubungan.
Mengira hubungan, bukan isu. Kos setiap hubungan memberi ganjaran kepada pemecahan satu masalah kepada beberapa sentuhan. Gunakan kos setiap isu yang diselesaikan sebagai semakan.
Mempercayai dashboard vendor sebagai keseluruhan kebenaran. Platform mentakrifkan penyelesaian secara berbeza, jadi bandingkan aliran anda sendiri di bawah satu takrifan tetap. Kekalkan sampel manual, kerana model yang menilai model boleh berkongsi titik butanya.
Mengabaikan risiko. Metrik menggambarkan kualiti, bukan kemudaratan. Janji bayaran balik yang salah boleh lulus setiap dashboard. Baca risiko perkhidmatan pelanggan AI bersama kad skor dan tambah kiraan insiden yang ditandakan.
Soalan Lazim tentang Metrik Perkhidmatan Pelanggan AI
Apakah metrik perkhidmatan pelanggan AI yang paling penting?
Mulakan dengan lima: pembendungan, penyelesaian yang disahkan, kadar buka semula atau hubungan berulang, CSAT yang dipecahkan mengikut AI dan manusia, dan kos setiap isu yang diselesaikan. Bersama-sama ia menunjukkan sama ada AI mengelak manusia, menyelesaikan masalah, bertahan selepas itu, memuaskan pelanggan dan berkos lebih rendah daripada alternatif.
Bagaimanakah saya mengira kadar pembendungan?
Bahagikan bilangan perbualan AI yang tidak pernah melibatkan manusia dengan jumlah perbualan AI. Kemudian tolak perbualan yang diikuti hubungan berulang tentang isu yang sama untuk mendapatkan kadar penyelesaian yang disahkan. Pembendungan sahaja tidak dapat memberitahu anda sama ada pelanggan dibantu.
Apakah perbezaan antara kos setiap hubungan dan kos setiap penyelesaian?
Kos setiap hubungan membahagi jumlah kos sokongan dengan hubungan yang dikendalikan, jadi memecahkan satu isu kepada beberapa sentuhan merendahkannya. Kos setiap isu yang diselesaikan membahagi dengan isu yang benar-benar diselesaikan, jadi ia tidak dapat direndahkan dengan cara itu. Jejaki kedua-duanya dan siasat apabila keduanya menyimpang.
Patutkah CSAT AI dan manusia dilaporkan secara berasingan?
Ya. Ia populasi yang berbeza dengan corak respons yang berbeza, dan skor gabungan menyembunyikan pihak yang lebih lemah. Tunjukkan kadar respons di sebelah setiap skor, kerana skor tinggi pada respons yang sangat sedikit tidak banyak menceritakan tentang pelanggan yang kekal senyap.
Berapa kerap saya patut menyemak metrik ini?
Semak metrik hasil dan liputan setiap minggu, kerana ia berubah paling cepat dan mendorong pembetulan kandungan. Semak kos, usaha dan masa pengendalian setiap bulan. Lawati semula takrifan anda setiap suku tahun, atau bila-bila masa anda menambah saluran, memberi AI tindakan baharu atau menukar tetapan vendor.
Apakah kadar jurang pengetahuan?
Ia ialah bahagian soalan pelanggan yang tidak dapat dijawab oleh AI dengan yakin daripada sumbernya yang disambungkan. Susun soalan yang tidak terjawab mengikut isi padu dan baiki jurang terbesar setiap minggu dengan menulis atau mengemas kini artikel yang mendasarinya. Kadar jurang yang menurun ialah tanda paling awal bahawa penyelesaian pada topik itu akan bertambah baik.

Customer Success Operations Manager
On this page
- Fakta Utama
- Kad Skor Sepintas Lalu
- Metrik Hasil: Adakah Masalah Itu Hilang?
- Contoh kerja (hipotetikal)
- Metrik Pengalaman: Bagaimana Rasanya?
- Metrik Kecekapan: Berapa Kosnya dan Apa yang Dibebaskan?
- Metrik Liputan: Di Mana AI Berhenti?
- Contoh Sebenar Mengikut Fungsi
- Cara Membina Kad Skor Langkah demi Langkah
- Templat Kad Skor yang Boleh Anda Salin
- Perangkap yang Perlu Dielakkan