Bahasa Indonesia
Metrik Layanan Pelanggan AI: Containment, Penyelesaian, CSAT, dan Biaya per Kontak
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Metrik layanan pelanggan AI adalah sekumpulan kecil angka yang memberi tahu Anda apakah AI Anda menyelesaikan masalah pelanggan, dengan kualitas apa, dan dengan biaya berapa. Tidak ada satu angka pun yang bisa melakukannya. Containment memberi tahu bahwa manusia tidak dilibatkan. Penyelesaian memberi tahu bahwa masalahnya hilang. CSAT memberi tahu bagaimana perasaan pelanggan. Biaya per kontak memberi tahu apa yang dibutuhkan. Masing-masing bisa terlihat sehat sementara yang lain diam-diam gagal, sehingga unit yang berguna adalah scorecard di mana setiap metrik punya pasangan yang menangkap titik butanya.
Panduan ini memberi Anda scorecard tersebut: sebelas metrik, rumus untuk masing-masing, contoh perhitungan dengan angka hipotetis, jebakannya, dan tabel template yang bisa Anda tempel ke pelaporan. Jika Anda membutuhkan versi panjang tentang perbedaan containment, deflection, dan penyelesaian, baca tingkat penyelesaian AI. Di sini kita memakai definisi itu dan melanjutkan. Untuk gambaran yang lebih luas tentang di mana AI cocok dalam dukungan, mulailah dari gambaran umum AI dalam layanan pelanggan.
Fakta Utama
- Scorecard AI yang sehat memiliki sebelas metrik dalam empat kelompok: hasil (containment, penyelesaian, tingkat pembukaan ulang), pengalaman (CSAT, upaya, kualitas transfer), efisiensi (biaya, waktu penanganan), dan cakupan (eskalasi, kesenjangan pengetahuan).
- Setiap metrik membutuhkan pasangan. Containment berpasangan dengan penyelesaian, CSAT berpasangan dengan baseline (garis dasar) manusia, dan biaya per kontak berpasangan dengan biaya per masalah yang terselesaikan.
- Biaya per kontak bergerak ketika Anda mengubah cara menghitung "kontak", bahkan jika tidak ada yang berubah secara nyata. Definisikan sebagai satu masalah pelanggan dan jangan ubah definisi itu (Gladly).
- Dalam studi besar terhadap agen dukungan pelanggan, bantuan AI menaikkan jumlah masalah yang diselesaikan per jam sebesar 14% rata-rata, dengan peningkatan 34% untuk pekerja pemula dan berketerampilan rendah (NBER).
- Panduan Zendesk sendiri tentang rata-rata waktu penanganan memperingatkan bahwa angka yang rendah tidak berarti kinerja yang baik, dan menyarankan untuk membacanya berdampingan dengan CSAT, penyelesaian pada kontak pertama, dan upaya pelanggan (Zendesk).
- Laporkan setiap metrik dengan penyebutnya tertulis di sampingnya. Mengubah penyebut adalah cara termudah untuk memproduksi kemajuan.
Scorecard Sekilas
Sebelum rinciannya, inilah seluruh set metrik. Anggaplah kolom "berpasangan dengan" sebagai aturan yang menjaga metrik tetap jujur.
| Kelompok | Metrik | Rumus | Berpasangan dengan |
|---|---|---|---|
| Hasil | Tingkat containment | Percakapan tanpa keterlibatan manusia ÷ percakapan AI | Tingkat penyelesaian |
| Hasil | Tingkat penyelesaian terverifikasi | Percakapan yang terselesaikan dan tidak terulang ÷ percakapan AI | Tingkat pembukaan ulang, tinjauan sampel |
| Hasil | Tingkat pembukaan ulang / kontak berulang | Percakapan terselesaikan yang diikuti kontak berulang untuk masalah yang sama ÷ percakapan terselesaikan | Tingkat penyelesaian |
| Pengalaman | CSAT, AI vs manusia | Respons yang puas ÷ total respons, dipisah menurut siapa yang menangani | Tingkat respons |
| Pengalaman | Upaya pelanggan | Jumlah peringkat upaya ÷ respons survei | CSAT |
| Pengalaman | Kualitas transfer | Handoff di mana agen tidak bertanya ulang ÷ handoff | Tingkat eskalasi |
| Efisiensi | Biaya per kontak | Total biaya dukungan ÷ kontak | Biaya per masalah terselesaikan |
| Efisiensi | Biaya per masalah terselesaikan | Total biaya dukungan ÷ masalah terselesaikan | Biaya per kontak |
| Efisiensi | Dampak pada waktu penanganan agen | Rata-rata waktu penanganan dengan bantuan AI vs tanpa | CSAT, tingkat pembukaan ulang |
| Cakupan | Tingkat eskalasi | Percakapan yang dialihkan ke manusia ÷ percakapan AI | Containment |
| Cakupan | Tingkat kesenjangan pengetahuan | Pertanyaan yang tidak bisa dijawab AI dari sumbernya ÷ pertanyaan yang diajukan | Penyelesaian per topik |
Daftarnya panjang, tetapi sebagian besar tim meninjau lima atau enam di antaranya setiap minggu dan sisanya setiap bulan. Bagian-bagian di bawah membahasnya kelompok demi kelompok.
Metrik Hasil: Apakah Masalahnya Hilang?
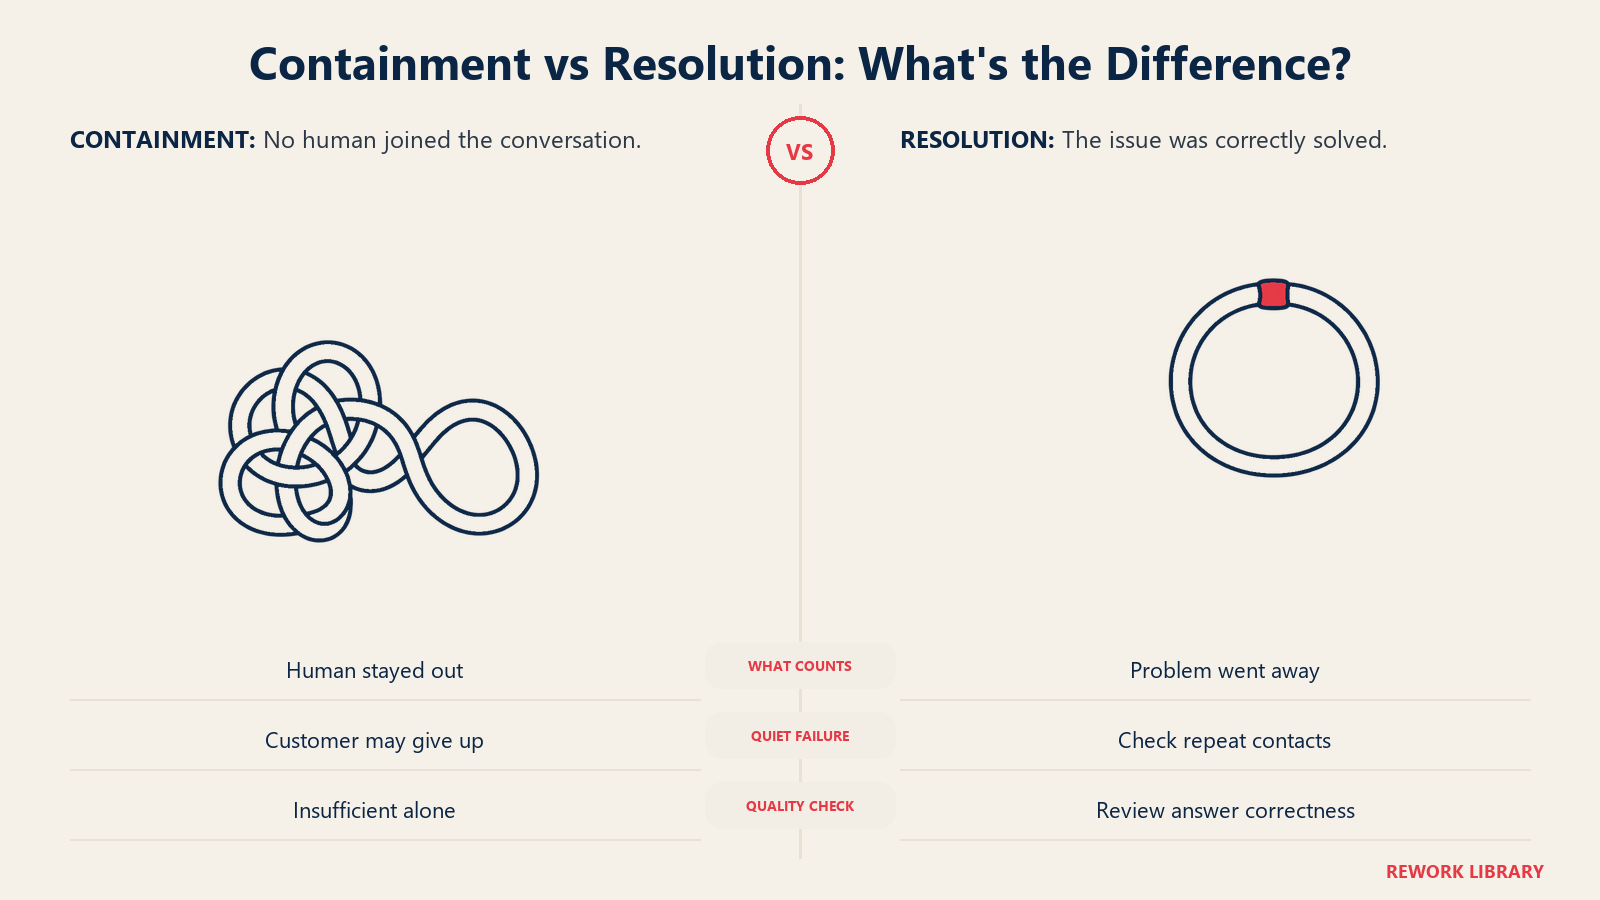
Tingkat containment adalah porsi percakapan AI yang tidak pernah sampai ke manusia.
Containment = percakapan tanpa keterlibatan manusia ÷ total percakapan AI
Ini metrik yang paling mudah dihitung dan paling mudah disalahartikan. Pelanggan yang menyerah dianggap contained. Pelanggan yang mendapat jawaban salah lalu menutup jendela dianggap contained. Laporan Consumer Financial Protection Bureau tentang chatbot bank menggambarkan pelanggan yang terjebak dalam "lingkaran tanpa jalan keluar" berisi respons berulang yang tidak membantu tanpa jalur keluar ke manusia, dan mengutip survei di mana 78% konsumen perlu terhubung dengan manusia setelah chatbot gagal memenuhi kebutuhan mereka (CFPB). Sebagian dari pelanggan itu masuk ke dalam angka containment seseorang sebagai keberhasilan.
Tingkat penyelesaian terverifikasi adalah containment dengan kegagalan yang dikeluarkan.
Penyelesaian terverifikasi = (percakapan contained − percakapan yang diikuti kontak berulang untuk masalah yang sama − percakapan yang dinilai salah oleh peninjau) ÷ total percakapan AI
Cara Anda menilai "terselesaikan" adalah pilihan desain. Intercom, misalnya, mendefinisikan tingkat penyelesaiannya sebagai persentase percakapan yang diselesaikan agen AI-nya tanpa keterlibatan manusia, dan menghitung penyelesaian ketika pelanggan mengonfirmasi jawabannya atau pergi tanpa meminta bantuan lagi (Intercom). Itu aturan operasional yang masuk akal, tetapi ia menghitung keheningan sebagai keberhasilan, jadi jalankan pemeriksaan kontak berulang Anda sendiri di atas angka vendor mana pun.
Tingkat pembukaan ulang atau kontak berulang menangkap kegagalan yang senyap.
Tingkat pembukaan ulang = percakapan terselesaikan yang diikuti kontak berulang untuk masalah yang sama dalam jendela waktu Anda ÷ percakapan terselesaikan
Dalam perangkat tiket, pembukaan ulang adalah peristiwa bawaan. Zendesk mendefinisikan tiket yang dibuka ulang sebagai tiket yang dibuka kembali setelah diselesaikan (Zendesk). Dengan AI, pelanggan sering tidak membuka ulang apa pun. Mereka membuka chat baru, mengirim email, atau menelepon Anda. Jadi cocokkan berdasarkan pelanggan dan topik lintas kanal, bukan berdasarkan ID tiket, dan pilih jendela waktu yang sesuai dengan masalahnya: beberapa hari untuk reset kata sandi, beberapa minggu untuk sengketa penagihan.
Contoh perhitungan (hipotetis)
Misalkan 10.000 percakapan dimulai dengan AI Anda dalam sebulan.
- 6.000 contained dan 4.000 diserahkan ke manusia (containment 60%, eskalasi 40%).
- Dari 6.000 yang contained, 900 pelanggan kembali lewat kanal lain dalam tujuh hari tentang masalah yang sama.
- Penyelesaian terverifikasi adalah (6.000 − 900) ÷ 10.000 = 51%.
Judul laporan mengatakan 60%. Angka yang dapat dipertanggungjawabkan adalah 51%. Keduanya benar, tetapi hanya satu yang layak masuk ke kasus anggaran. Tambahkan tinjauan manusia mingguan atas sampel acak dan angkanya mungkin turun lagi, yang merupakan informasi berguna tentang seberapa optimistis hitungan alat Anda sendiri.
Metrik Pengalaman: Bagaimana Rasanya?
CSAT, dipisah menurut AI dan manusia. Perhitungan standarnya adalah respons yang puas dibagi total respons, dikalikan 100. Sebagian besar tim menghitung dua kotak teratas pada skala lima poin, atau suara "baik" pada skala biner. Kesalahannya adalah menerbitkan satu CSAT gabungan. Laporkan skor untuk percakapan yang ditangani AI dan yang ditangani manusia secara terpisah, dan tampilkan tingkat respons di samping masing-masing, karena pelanggan yang baru mendapat jawaban bot yang buruk lebih kecil kemungkinannya mengisi survei dibandingkan pelanggan yang berbicara dengan manusia. CSAT AI yang tinggi pada tingkat respons 4% hanya bercerita tentang 4% itu.
Jika Anda ingin melihat kepuasan sebelum survei tiba, memprediksi CSAT dengan AI membahas pemodelannya dari sinyal percakapan. Anggaplah skor prediksi sebagai dorongan untuk memeriksa, bukan pengganti bertanya langsung.
Upaya pelanggan. Customer Effort Score mengukur seberapa besar upaya yang dibutuhkan pelanggan untuk mendapatkan apa yang mereka perlukan. Pada skala standar, Zendesk menuliskan rumusnya sebagai jumlah peringkat CES dibagi jumlah respons survei, dan mencatat bahwa skor tinggi menunjukkan upaya rendah (Zendesk). Skala berjalan ke dua arah di berbagai vendor, jadi tuliskan ujung mana yang berarti "mudah" sebelum Anda membandingkan dua laporan mana pun. Upaya adalah metrik yang membongkar bot yang panjang dan sopan yang secara teknis menjawab tetapi membutuhkan sembilan pesan untuk melakukannya.
Kualitas transfer. Ketika AI melakukan handoff, apakah manusia harus mulai dari awal?
Kualitas transfer = handoff di mana agen memiliki ringkasan percakapan, mengidentifikasi pelanggan, dan tidak bertanya ulang ÷ total handoff
Anda mengukurnya dengan mengambil sampel handoff, bukan dari Dashboard. Baca dua puluh per minggu dan tandai masing-masing ya atau tidak. Pola yang Anda buru adalah pelanggan yang menjelaskan masalahnya kepada bot, lalu menjelaskannya lagi kepada manusia. Pengulangan itu mengikis kepercayaan lebih cepat daripada jawaban yang salah. AI agent assist adalah kemampuan yang memungkinkan handoff yang bersih dengan meringkas utas bagi agen.
Metrik Efisiensi: Berapa Biayanya dan Apa yang Dibebaskan?
Biaya per kontak adalah angka efisiensi yang paling sederhana.
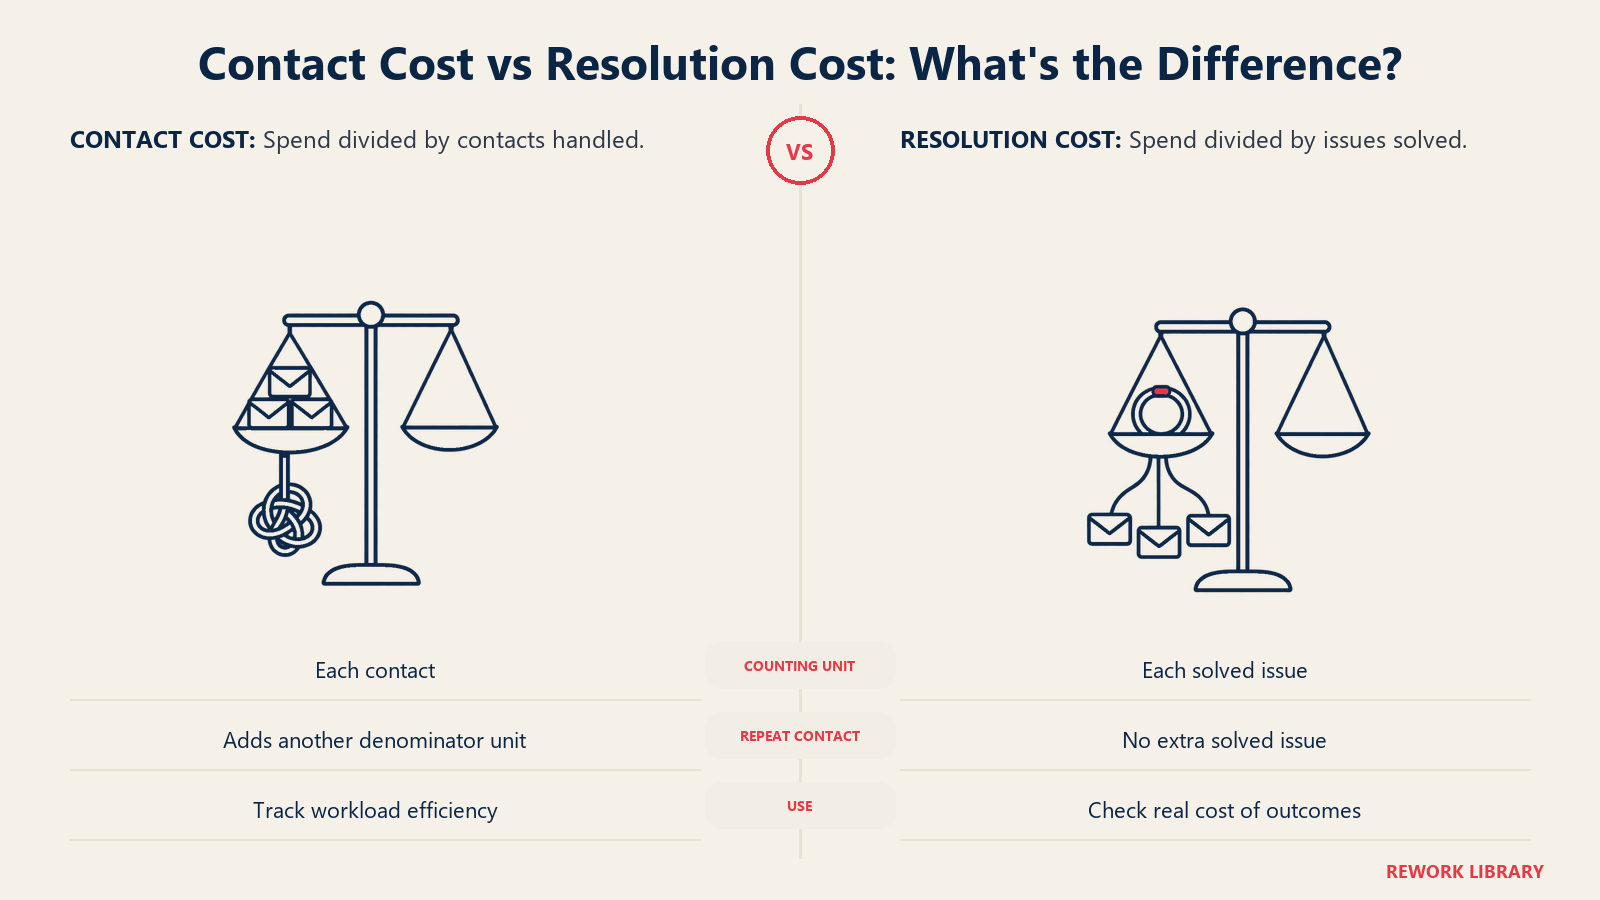
Biaya per kontak = total biaya operasional dukungan untuk periode tersebut ÷ total kontak yang ditangani pada periode tersebut
Contoh perhitungan Gladly adalah tim yang menghabiskan $100.000 dalam sebulan dan menangani 10.000 kontak, yaitu $10,00 per kontak. Halaman yang sama menyampaikan poin yang penting: sistem berbasis tiket menghitung setiap tiket baru sementara sistem berbasis percakapan menghitung seluruh utas sebagai satu, dan menghitung setiap sentuhan menurunkan biaya yang dilaporkan tanpa mengubah pengalaman pelanggan. Sarannya adalah mendefinisikan kontak sebagai satu masalah pelanggan dan menjaga definisi itu tetap (Gladly).
Biaya per masalah terselesaikan adalah versi yang lebih sulit dan lebih jujur, karena memecah-mecah pekerjaan tidak bisa menurunkannya.
Biaya per masalah terselesaikan = total biaya operasional dukungan ÷ masalah yang benar-benar terselesaikan (oleh AI atau manusia)
Lanjutkan skenario hipotetis tadi, dengan asumsi total biaya dukungan $120.000 untuk bulan itu. Ke-900 kontak berulang adalah kontak nyata, sehingga totalnya 10.900, menghasilkan biaya per kontak sekitar $11,01. Manusia menyelesaikan 3.600 dari 4.000 masalah yang dieskalasi dan seluruh 900 masalah berulang, sehingga masalah terselesaikan berjumlah 5.100 + 3.600 + 900 = 9.600. Biaya per masalah terselesaikan adalah $120.000 ÷ 9.600 = $12,50. Angka kedua lebih tinggi karena tidak membiarkan kontak berulang terlihat seperti tawaran murah. Lacak keduanya. Ketika keduanya menyimpang, AI Anda sedang menciptakan kontak tambahan.
Untuk masukan biayanya sendiri, seperti apa yang masuk ke pembilang dan bagaimana biaya platform AI dimasukkan, lihat biaya layanan pelanggan AI.
Dampak pada waktu penanganan agen. Rata-rata waktu penanganan biasanya ditulis sebagai waktu bicara ditambah waktu tunggu ditambah pekerjaan tindak lanjut, dibagi jumlah kontak yang ditangani (Zendesk). Dengan AI dalam campuran, dua hal berubah. Pertama, AI menyerap kontak sederhana, sehingga antrean tersisa bagi manusia lebih sulit dan rata-rata waktu penanganan mereka bisa naik meskipun sistemnya bekerja. Kedua, alat assist seharusnya mempersingkat waktu pada setiap kontak. Ukur keduanya: waktu penanganan menurut alasan kontak sebelum dan sesudah, serta masalah yang diselesaikan per jam agen.
Bukti dari luar untuk efek assist ada. Studi tentang agen dukungan pelanggan yang menggunakan asisten generative AI menemukan peningkatan rata-rata 14% dalam masalah yang diselesaikan per jam, peningkatan 34% untuk pekerja pemula dan berketerampilan rendah, serta dampak minimal pada pekerja berpengalaman (NBER). Itu hasil studi tersebut, bukan target untuk tim Anda, tetapi menunjukkan mengapa Anda harus membaca waktu penanganan menurut tingkat pengalaman: peningkatannya tidak merata. Panduan Zendesk tentang metrik ini juga memperingatkan bahwa waktu penanganan yang rendah tidak berarti kinerja yang baik, karena mendorong agen mempersingkat kontak dapat merugikan kualitas, jadi bacalah berdampingan dengan CSAT dan upaya (Zendesk).
Metrik Cakupan: Di Mana AI Berhenti?
Tingkat eskalasi.
Tingkat eskalasi = percakapan yang dialihkan ke manusia ÷ percakapan AI
Tidak ada angka ideal. Tingkat yang mendekati nol bisa berarti AI-nya luar biasa atau ia menyembunyikan jalan keluarnya. Pisahkan eskalasi menjadi dua jenis. Handoff terancang terjadi karena Anda mengonfigurasi aturan, seperti setiap pengembalian dana di atas jumlah tertentu diserahkan ke manusia. Eskalasi kegagalan terjadi karena pelanggan meminta manusia, menunjukkan frustrasi, atau menemui sesuatu yang tidak bisa ditangani AI. Dokumentasi Intercom menarik garis serupa antara handoff yang dipicu prosedur yang dikonfigurasi dan eskalasi yang terjadi di bawah perilaku default atau aturan workspace, seperti pelanggan meminta orang (Intercom). Tujuan Anda bukan meminimalkan eskalasi. Tujuannya adalah membuat eskalasi kegagalan lebih jarang dan handoff terancang lebih mulus. Ini adalah keputusan di inti otomatisasi atau bantu.
Tingkat kesenjangan pengetahuan.
Tingkat kesenjangan pengetahuan = pertanyaan yang tidak bisa dijawab AI dengan yakin dari sumbernya ÷ pertanyaan yang diajukan
Dokumentasi HelpCrunch, misalnya, mendefinisikan pertanyaan yang belum terjawab sebagai kueri apa pun yang tidak bisa dijawab agen AI dengan yakin berdasarkan sumber data yang terhubung, dan menggunakan laporan itu untuk menemukan titik buta (HelpCrunch). Alat apa pun yang Anda gunakan, praktiknya sama: urutkan kesenjangan menurut volume, dan tulis atau perbaiki artikel di balik yang terbesar setiap minggu. Tingkat penyelesaian sering kali adalah masalah konten yang menyamar. Sumber yang rapi dan terkini lebih berharga daripada model yang lebih baik, itulah sebabnya menyiapkan data dukungan untuk AI didahulukan sebelum sebagian besar penyetelan.
Contoh Nyata menurut Fungsi
Scorecard yang sama dibaca berbeda tergantung antreannya.
Dukungan pelanggan, tier 1. Reset kata sandi dan pencarian pesanan seharusnya menunjukkan penyelesaian terverifikasi yang tinggi dan upaya yang rendah. Jika tidak, masalahnya ada pada integrasi, bukan kecerdasan.
Penagihan dan operasi keuangan. Containment bisa terlihat luar biasa sementara tingkat pembukaan ulang naik, karena AI menjelaskan faktur tetapi tidak bisa melihat akunnya. Perhatikan tingkat pembukaan ulang dan biaya per masalah terselesaikan di sini, bukan containment.
Help desk TI. Karyawan mengulang pertanyaan ketika langkah-langkahnya berubah. Lacak kontak berulang per orang dan tingkat kesenjangan pengetahuan, karena artikel usang adalah penyebab yang lazim.
E-commerce. "Di mana pesanan saya?" adalah pencarian dan terselesaikan dengan bersih. Risikonya adalah paket yang terlambat: AI melaporkan "dalam perjalanan" dan pelanggan menelepon keesokan harinya. Tingkat pembukaan ulang menurut alasan kontak akan menunjukkannya.
Onboarding dan customer success. Keheningan berbahaya di sini. Pelanggan baru yang bertanya cara mengimpor kontak dan tidak pernah membalas belum tentu terbantu. Padukan penyelesaian dengan sinyal aktivasi dari produk.
Cara Membangun Scorecard Langkah demi Langkah
- Definisikan kontak dan penyelesaian secara tertulis. Satu kalimat untuk masing-masing. Kontak = satu masalah pelanggan, bukan peristiwa sistem. Penyelesaian = jawaban yang benar atau tugas yang selesai, tanpa balasan manusia, tanpa kontak berulang dalam jendela waktu.
- Pilih penyebutnya. Putuskan apakah Anda membagi dengan semua percakapan AI, percakapan yang dicoba, atau percakapan dalam cakupan. Tuliskan pilihannya di catatan kaki setiap laporan.
- Beri tag alasan kontak pada setiap percakapan. Tanpa tag topik, Anda tidak bisa membuat segmen, dan rata-rata keseluruhan menyembunyikan topik di mana AI gagal.
- Pasang pemeriksaan kontak berulang. Cocokkan ID pelanggan dan topik lintas chat, email, dan telepon. Ini adalah tambahan tunggal dengan nilai tertinggi.
- Siapkan tinjauan sampel. Seorang peninjau membaca set acak percakapan "terselesaikan" setiap minggu dan menilainya benar, sebagian benar, atau salah. Teruskan yang salah ke proses quality assurance Anda.
- Pisahkan CSAT dan upaya menurut penangan. Hanya-AI, hanya-manusia, dan AI-lalu-manusia adalah tiga populasi yang berbeda.
- Hitung biaya dengan dua cara. Biaya per kontak dan biaya per masalah terselesaikan, berdampingan, setiap bulan.
- Tetapkan ambang batas per topik, bukan secara global. Target menyeluruh mendorong AI ke subjek yang seharusnya tidak disentuhnya, seperti pengembalian dana, hukum, dan keselamatan.
- Tinjau definisi setiap kuartal. Kanal baru, tindakan alat baru, dan perubahan aturan vendor semuanya menggeser apa yang dihitung.
Untuk urutan peluncuran, termasuk metrik mana yang perlu dibuat baseline sebelum peluncuran, lihat menerapkan AI dalam layanan pelanggan.
Template Scorecard yang Bisa Anda Salin
Isi kolom target dan pemilik dengan angka Anda sendiri. Kolom "tanda bahaya" adalah pola yang memberi tahu Anda bahwa metrik sedang dimanipulasi atau disalahbaca.
| Metrik | Kadensi | Pemilik | Target (milik Anda) | Tanda bahaya |
|---|---|---|---|---|
| Tingkat containment | Mingguan | Support ops | Tetapkan per topik | Naik sementara CSAT turun |
| Tingkat penyelesaian terverifikasi | Mingguan | Support ops | Tetapkan per topik | Selisih dengan containment melebar |
| Tingkat pembukaan ulang / kontak berulang | Mingguan | Support ops | Di bawah baseline Anda | Pelanggan sama, kanal baru |
| CSAT (AI) vs CSAT (manusia) | Mingguan | Pemimpin dukungan | AI dalam kisaran manusia | Tingkat respons rendah pada AI |
| Upaya pelanggan | Bulanan | Pemimpin dukungan | Per topik | Jumlah pesan per penyelesaian tinggi |
| Kualitas transfer | Sampel mingguan | QA | Sebagian besar handoff bersih | Pelanggan mengulang cerita |
| Biaya per kontak | Bulanan | Keuangan + dukungan | Tren, bukan janji | Turun tanpa perubahan penyelesaian |
| Biaya per masalah terselesaikan | Bulanan | Keuangan + dukungan | Tren, bukan janji | Menyimpang naik dari biaya per kontak |
| Waktu penanganan menurut alasan | Bulanan | Pemimpin dukungan | Per alasan | Turun sementara tingkat pembukaan ulang naik |
| Tingkat eskalasi (terancang vs kegagalan) | Mingguan | Support ops | Porsi kegagalan menurun | Mendekati nol tanpa jalan keluar yang terlihat |
| Tingkat kesenjangan pengetahuan | Mingguan | Pemilik pengetahuan | Menurun | Kesenjangan teratas tidak berubah selama sebulan |
Kesalahan yang Perlu Dihindari
Merayakan containment saja. Ini metrik yang paling mungkin terlihat bagus sementara pelanggan menderita. Jangan pernah menampilkannya tanpa penyelesaian terverifikasi di sampingnya.
Menggabungkan CSAT AI dan manusia. Gabungan itu menyembunyikan sisi mana pun yang sedang kesulitan. Pisahkan.
Membiarkan penyebut bergeser. Beralih dari "semua percakapan" ke "percakapan dalam cakupan" pada kuartal berikutnya menaikkan setiap tingkat tanpa perbaikan nyata.
Mengoptimalkan waktu penanganan demi dirinya sendiri. Ketika AI mengambil pekerjaan mudah, kontak manusia yang tersisa lebih panjang. Nilai tim berdasarkan penyelesaian dan kepuasan menurut alasan kontak.
Menghitung kontak, bukan masalah. Biaya per kontak memberi imbalan pada pemecahan satu masalah menjadi beberapa sentuhan. Gunakan biaya per masalah terselesaikan sebagai pemeriksanya.
Memercayai Dashboard vendor sebagai seluruh kebenaran. Platform mendefinisikan penyelesaian secara berbeda, jadi bandingkan tren Anda sendiri di bawah satu definisi yang tetap. Pertahankan sampel manual, karena model yang menilai model bisa berbagi titik buta yang sama.
Mengabaikan risiko. Metrik menggambarkan kualitas, bukan kerugian. Janji pengembalian dana yang salah bisa lolos dari setiap Dashboard. Baca risiko layanan pelanggan AI bersama scorecard dan tambahkan hitungan insiden yang ditandai.
Pertanyaan yang Sering Diajukan tentang Metrik Layanan Pelanggan AI
Apa metrik layanan pelanggan AI yang paling penting?
Mulailah dengan lima: containment, penyelesaian terverifikasi, tingkat pembukaan ulang atau kontak berulang, CSAT yang dipisah menurut AI dan manusia, serta biaya per masalah terselesaikan. Bersama-sama, kelimanya menunjukkan apakah AI menghindari manusia, menyelesaikan masalah, bertahan sesudahnya, memuaskan pelanggan, dan lebih murah daripada alternatifnya.
Bagaimana cara menghitung tingkat containment?
Bagi jumlah percakapan AI yang tidak pernah melibatkan manusia dengan total percakapan AI. Lalu kurangi percakapan yang diikuti kontak berulang untuk masalah yang sama untuk mendapatkan tingkat penyelesaian terverifikasi. Containment saja tidak bisa memberi tahu apakah pelanggan terbantu.
Apa perbedaan antara biaya per kontak dan biaya per penyelesaian?
Biaya per kontak membagi total biaya dukungan dengan kontak yang ditangani, sehingga memecah satu masalah menjadi beberapa sentuhan menurunkannya. Biaya per masalah terselesaikan membagi dengan masalah yang benar-benar selesai, sehingga tidak bisa diturunkan dengan cara itu. Lacak keduanya dan selidiki ketika keduanya menjauh.
Haruskah CSAT AI dan manusia dilaporkan secara terpisah?
Ya. Keduanya adalah populasi yang berbeda dengan pola respons yang berbeda, dan skor gabungan menyembunyikan sisi yang lebih lemah. Tampilkan tingkat respons di samping setiap skor, karena skor tinggi dari sangat sedikit respons tidak banyak bercerita tentang pelanggan yang diam.
Seberapa sering saya harus meninjau metrik ini?
Tinjau metrik hasil dan cakupan setiap minggu, karena keduanya berubah paling cepat dan mendorong perbaikan konten. Tinjau biaya, upaya, dan waktu penanganan setiap bulan. Tinjau ulang definisi Anda setiap kuartal, atau setiap kali Anda menambah kanal, memberi AI tindakan baru, atau mengubah pengaturan vendor.
Apa itu tingkat kesenjangan pengetahuan?
Itu adalah porsi pertanyaan pelanggan yang tidak bisa dijawab AI dengan yakin dari sumber yang terhubung. Urutkan pertanyaan yang belum terjawab menurut volume dan perbaiki kesenjangan terbesar setiap minggu dengan menulis atau memperbarui artikel yang mendasarinya. Tingkat kesenjangan yang menurun adalah tanda paling awal bahwa penyelesaian pada topik itu akan segera membaik.

Customer Success Operations Manager
On this page
- Fakta Utama
- Scorecard Sekilas
- Metrik Hasil: Apakah Masalahnya Hilang?
- Contoh perhitungan (hipotetis)
- Metrik Pengalaman: Bagaimana Rasanya?
- Metrik Efisiensi: Berapa Biayanya dan Apa yang Dibebaskan?
- Metrik Cakupan: Di Mana AI Berhenti?
- Contoh Nyata menurut Fungsi
- Cara Membangun Scorecard Langkah demi Langkah
- Template Scorecard yang Bisa Anda Salin
- Kesalahan yang Perlu Dihindari