顧客インテント検出:AIが顧客の問い合わせ理由を理解する仕組み
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
顧客インテント検出とは、顧客のメッセージを、「注文はどこですか」「サブスクリプションを解約したい」「二重に請求されました」といった、連絡してきた理由に自動で分類することです。 出力は、通常は信頼度スコアを伴うラベルで、人が読む前に、チャット、メール、チケット、通話のトランスクリプトに付与されます。
そのラベルは小さなものですが、多くのことがそれにかかっています。チケットがどのキューに入るか、ボットが回答するか引き継ぐか、そして月次レポートが顧客の実際の問い合わせ内容として何を示すかを、ラベルが決めます。インテントの層が弱いと、請求の質問が技術サポートに送られ、最大の問い合わせ要因が「一般」というバケットの中に隠れてしまいます。優れたインテントの層があれば、初日から機能するルーティングと、計画の拠り所となる需要の地図が手に入ります。
このガイドでは、検出の仕組み、すべての土台となるインテントの一覧(分類体系)の作り方、そしてラベルの活用方法を解説します。まず全体像を知りたい方には、カスタマーサービスにおけるAIの概要も併せてお読みいただくのがおすすめです。
重要なポイント
- Dialogflow CXは、候補となる各インテントに0.0(まったく不確か)から1.0(完全に確か)のスコアを付け、分類のしきい値を超えた場合にのみ最上位のインテントを返し、そうでない場合はno-matchイベントを発生させます(Google Cloud)。
- Googleは、Dialogflow CXでインテントごとに、その複雑さに応じて最低10から20のトレーニングフレーズを用意することを推奨しています(Google Cloud)。
- Amazon Lex V2は、最も可能性の高いインテントに加えて最大4つの代替候補を返し、すべてのスコアがしきい値を下回った場合は
AMAZON.FallbackIntentにフォールバックします(AWS)。 - Lex自身が挙げる曖昧さの例では、スコアが0.75と0.72なら2つのインテントは接戦で判断がつかず、0.95と0.65なら最初のインテントがおそらく正しいとされています(AWS)。
- CLINC150ベンチマークは、10の領域にわたる150のインテントを対象としており、その作成者は、分類モデルは範囲内のインテントでは良好な結果を出すが、範囲外のクエリの識別には苦戦することを見出しました(Larsonら、arXiv)。
- Zendeskは、チケットのトピックと言語の予測に高、中、低の信頼度を表示し、担当者による修正はモデルの学習には使われないとしています(Zendesk)。
インテントとは実際に何か
インテントとは、メッセージの背後にある目的であり、その言葉ではありません。「荷物がまったく届きません」「私の荷物はどこ?」「追跡では配達済みなのに何も届いていません」は、3つの異なる文字列ですが、インテントは1つです。注文状況または配送トラブルです。
インテントと混同されやすいものが2つあります。
- トピックまたはカテゴリ。 「請求」はトピックです。「二重請求の返金を依頼する」はインテントです。トピックは一目で把握するレポートに向いており、インテントは具体的で、そのまま行動に結びつけられます。
- 感情。 顧客が怒っているかどうかは、なぜ連絡してきたかとは別のことです。どちらも必要になりますが、別々の項目です。激怒している顧客が配送について尋ねていても、それは配送のインテントです。
多くのプラットフォームは、複数のシグナルを同時に検出します。たとえばZendeskのインテリジェントトリアージは、チケットをトピック、感情、言語、エンティティで分類します。そのドキュメントには、これらの項目をワークフローで使うにはCopilotのアドオンが必要だと記されています(Zendesk)。Zendeskのヘルプセンターは、以前の設定で「インテント」と呼んでいたものを、現在は「トピック」と呼んでいます。
インテント検出の仕組み
大きく分けて2つの方法があり、実際のシステムの多くは両者を組み合わせています。
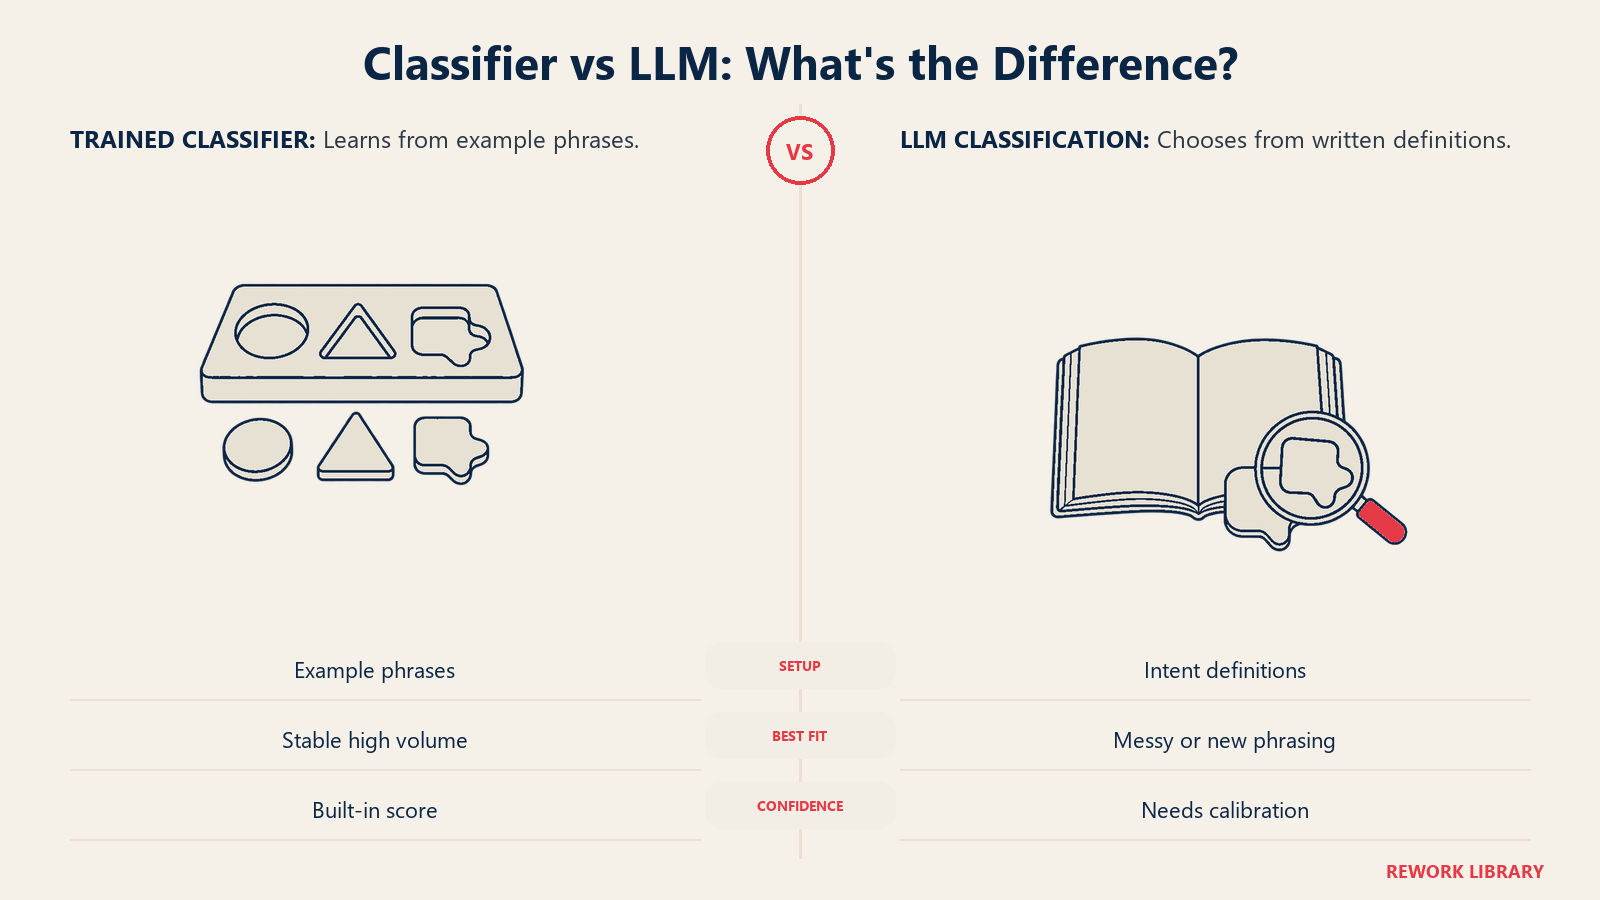
学習済みの分類モデル
インテントを定義し、それぞれに例文を与えると、プラットフォームが新しいメッセージをそれらと照合するモデルを学習します。Dialogflow CXもAmazon Lexもこの方式です。モデルはすべてのインテントにスコアを付け、最も高いものを選びます。
強みは、高速で、メッセージあたりのコストが低く、予測しやすく、しきい値を設定できるスコアが返ることです。弱みは、教えたインテントしか知らないことです。新しい話題のメッセージは、最も近いラベルに無理やり当てはめられるか、まったく一致しません。Googleのガイダンスでは、インテントごとに最低10から20のトレーニングフレーズから始めることを勧めています。また、既定の否定インテントに大量のフレーズ(例として10,000件を挙げています)を詰め込むと、通常のマッチングに悪影響が出ると警告しています(Google Cloud)。
LLMによる分類
ここでは、大規模言語モデルに、短い定義を付けたインテントの一覧を渡し、1つ(または「該当なし」)を選ぶよう指示します。構築すべき学習データがないため、定義を書き終えればすぐに新しいインテントを稼働させられます。従来型のNLUプラットフォームも同じ方向に進んでおり、学習済みのインテントモデルの上にLLMの層を追加しています。
強みは、雑然とした複数文のメッセージ、言語の混在、まったく新しい言い回しに対応できることです。弱みは、メッセージあたりのコストが高く、遅く、プロンプトやモデルが変わると挙動がずれることがあり、一覧に制約しなければ存在しないラベルを作り出すことがある点です。自己申告の信頼度をそのまま信じるのではなく、人手でラベル付けしたサンプルと照らして較正してください。
| 学習済みの分類モデル | LLMベース | |
|---|---|---|
| セットアップの手間 | インテントごとの例文 | インテントごとの文章による定義 |
| 新しい言い回しへの対応 | 学習フレーズに似ている場合のみ | 通常は良好 |
| 新しいインテントの立ち上げ | 例を集めて再学習する | 定義を編集する |
| 信頼度スコア | 組み込み済み | 較正が必要 |
| 時間経過での一貫性 | 再学習するまでは高い | モデルやプロンプトの変更で変わり得る |
| 適したケース | 件数が多く、安定したインテント | ロングテール、雑然とした入力、多言語の入力 |
よくある構成は、件数の大半を占める上位15から20のインテントを分類モデルが処理し、分類モデルが拒否したものをLLMが拾う、というものです。問い合わせが複数の言語で届く場合は、言語ごとの学習データがすぐに膨らむため、選ぶ前に多言語サポートに関する解説をお読みください。
信頼度のしきい値とフォールバック
どの方式でも、「確信が持てない」ときのルールが必要です。それは3つの要素で構成されます。
しきい値。 DialogflowもLexも、最小スコアを設定できます。Dialogflow CXでは、エージェント設定で指定した分類のしきい値を満たした場合にのみ最上位のインテントが返され、そうでなければno-matchイベントが発生します(Google Cloud)。Lex V2では、しきい値は0.00から1.00の間の数値で、言語ごとに設定します。それを下回るスコアはすべてフォールバックのインテントになります(AWS)。Lexは、そのスコアは絶対値ではなく比較のための値であり、サービスの改善に伴って変わる可能性があるとも注意しています。そのため、他社の0.7をそのまま使うのではなく、自社でテストしてください。
マージン。 上位2つのスコアの差は、最上位のスコアと同じくらい重要です。Lexのドキュメントは、0.75と0.72を本当の曖昧さの例として挙げています。よいパターンは、最上位のスコアがしきい値を下回る場合、または上位2つの差が小さい場合には、推測しないことです。確認の質問(「返金についてですか、それとも解約についてですか」)をするか、人に回します。
フォールバックの経路。 外れたときに何が起きるかを、事前に決めておきます。顧客の手間が少ない順に、選択肢は次のとおりです。
- 上位2つの推測を添えて一般のキューにメッセージを送り、担当者がヒントを持った状態で始められるようにする。
- 2つか3つのボタンを付けて、確認の質問を1つ行う。
- ここまでの会話とともに人に引き継ぐ。
調査も、これが重要である理由を裏づけています。CLINC150のデータセットが範囲外のクエリを含めて作られたのは、既知のインテントでは優秀に見える分類モデルでも、一覧にないことを尋ねられると苦戦するからでした(Larsonら、arXiv)。実際のトラフィックの大半は、まさにそのケースが起こるのを待っている状態です。
しきい値は用途ごとに設定します。ルーティングの判断(どのキューか)は、推測を誤っても再割り当てが1回で済むため、低めのしきい値を許容できます。アカウントの解約や返金の実行のような自動アクションには、はるかに高いしきい値か、確認のステップが必要です。そもそもどのタスクをAIに任せるかというより難しい問いについては、自動化か支援かをご覧ください。
インテント分類体系の構築
分類体系とはインテントの一覧のことで、モデルよりも重要です。優れたモデルでも、一覧が不明瞭では、誰にも使えない精密なラベルを出すだけです。
組織図ではなく、データから始める
直近のチケットやチャットを数百件取り出して読みます。現在どのチームが担当しているかではなく、顧客が何を望んだかでグループ分けします。データが乏しい、または一貫していない場合は、まずそれを直してください。クリーンアップについては、AIのためのサポートデータの準備で解説しています。
適切な粒度を選ぶ
粗すぎると、ラベルが行動を促せません(「請求」には、請求書、返金、支払いの失敗、税金の質問が含まれ、それぞれ異なる担当者が必要です)。細かすぎると、モデルがラベルを区別できず、担当者も覚えられず、レポートは各3件のチケットが並ぶ200行に分断されます。
使えるテストは、このインテントによって、次にすることが変わるかです。2つの候補のインテントが、同じ回答になり、同じチームにルーティングされ、1つの数字として報告されるのなら、統合します。扱いが異なるなら、分けておきます。
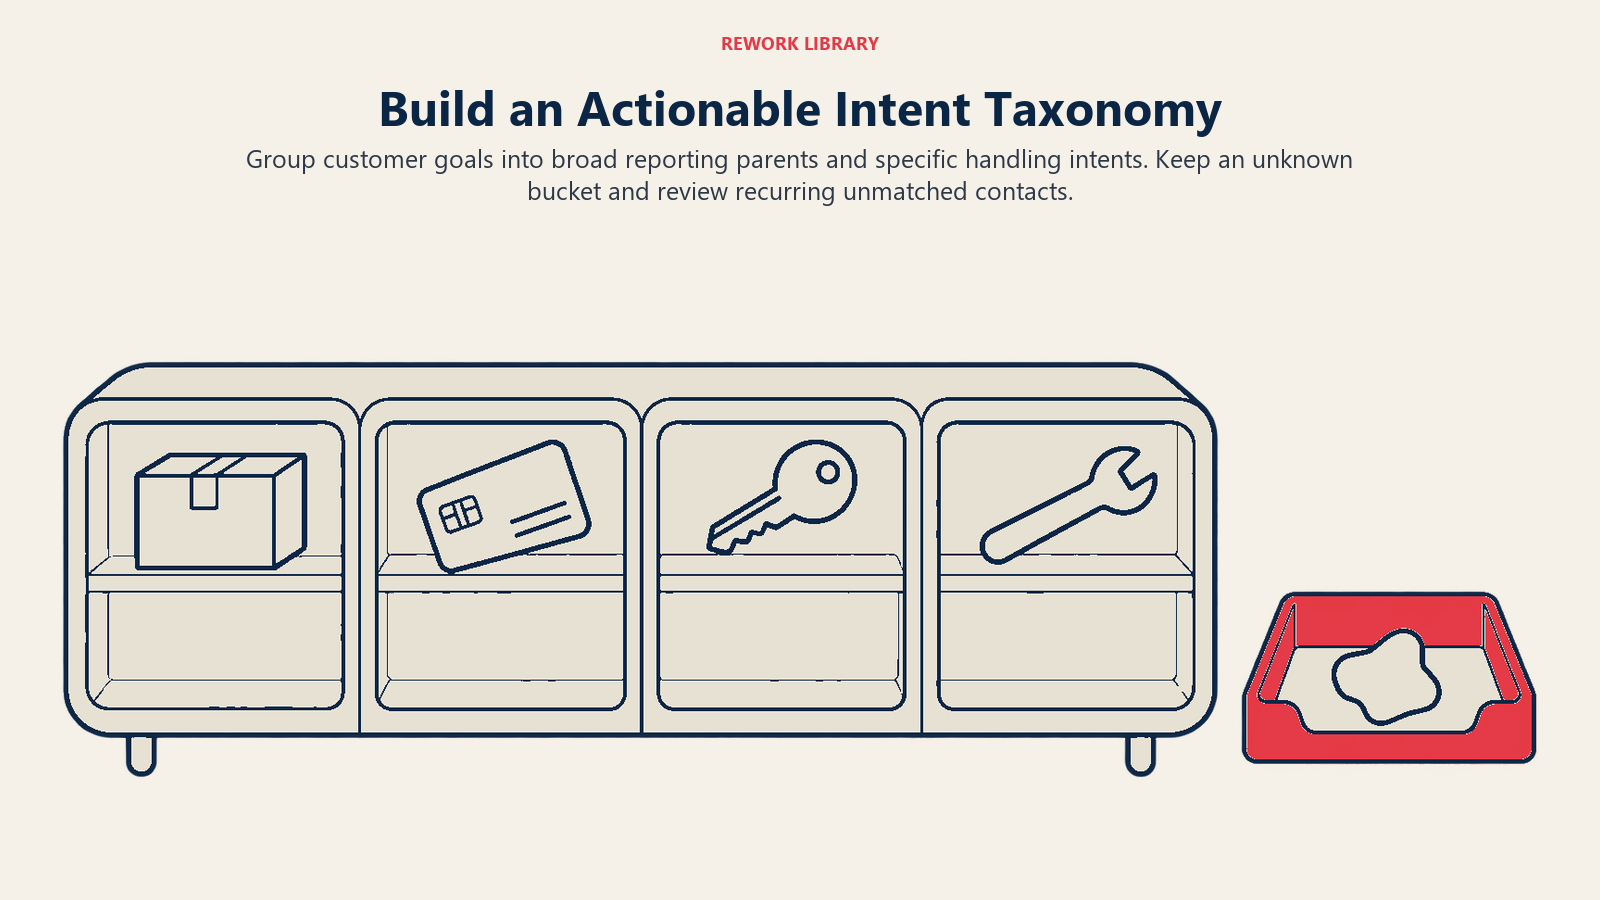
通常は2階層の構成がうまくいきます。経営層向けのレポート用にいくつかの親カテゴリを置き、ルーティングと自動化用に20から60程度の子インテントを置きます。この範囲は経験則であって標準ではありません。件数に応じて決めてください。月に2回しか現れないインテントのロングテールには、対応しようがありません。
インテントは顧客の目的として名付ける
動詞から始める一貫したパターンを使います。request_refund、change_billing_address、report_login_problemのようにします。社内のプロセスを表す名前(「tier2_escalation」)や、曖昧な名前(「other_issue」)は避けます。それぞれに1行の定義と、2つか3つの例文を書き、境界のケースも含めます(「顧客が二重請求に言及している場合は、request_refundではなくreport_billing_errorを使う」など)。
必ず「その他」のバケットを用意し、監視する
「その他」または「不明」のインテントは、失敗ではなく、変化を捉えるセンサーです。新機能、料金の変更、障害は、まずそこに現れます。有用に保つためのルールは2つあります。
- 上限を設ける。「その他」が件数の約10%を超えるなら、分類体系は古くなっています。この数値は業界のベンチマークではなく、目安となる目標です。
- サンプリングする。毎月50から100件の「その他」の問い合わせを読み、繰り返し現れるパターンを本物のインテントに昇格させます。
Dialogflowには、このループの組み込み版があります。インテントの提案機能がno-matchの発生を分析して、新しいインテントやトレーニングフレーズを推奨します。ただし、この機能は一部のリージョンに限られ、エージェント設定で有効にする必要があります(Google Cloud)。
見直しのサイクルを設定する
分類体系は、最初は毎月、落ち着いたら四半期ごとに、そして製品のリリースや料金の変更の後には必ず見直します。動きのないインテントは廃止し、広すぎるものは分割し、変更履歴を残します。そうすれば、「返金依頼」の減少が、単にラベル名が変わっただけということにはなりません。
| 親カテゴリ | 子インテントの例 | 一般的な対応 |
|---|---|---|
| 注文と配送 | track_order、report_missing_package、change_delivery_address |
ボットが照会し、その後に物流のキューへ |
| 請求 | request_refund、report_billing_error、update_payment_method |
請求のキュー、返金は承認が必要 |
| アカウントへのアクセス | reset_password、report_login_problem、delete_account |
リセットはボット、削除はセキュリティチーム |
| 製品のヘルプ | how_to_use_feature、report_bug、request_feature |
ヘルプセンター、サポート、またはプロダクトフィードバック |
| 解約とリテンション | cancel_subscription、downgrade_plan |
リテンション担当者。ボットのみは不可 |
| その他 | unknown、out_of_scope |
一般のキュー、毎月レビュー |
ルーティングとレポートへのインテントの活用
ルーティング
インテントは、ルールを動かして初めて役に立ちます。よくあるルールは次のとおりです。
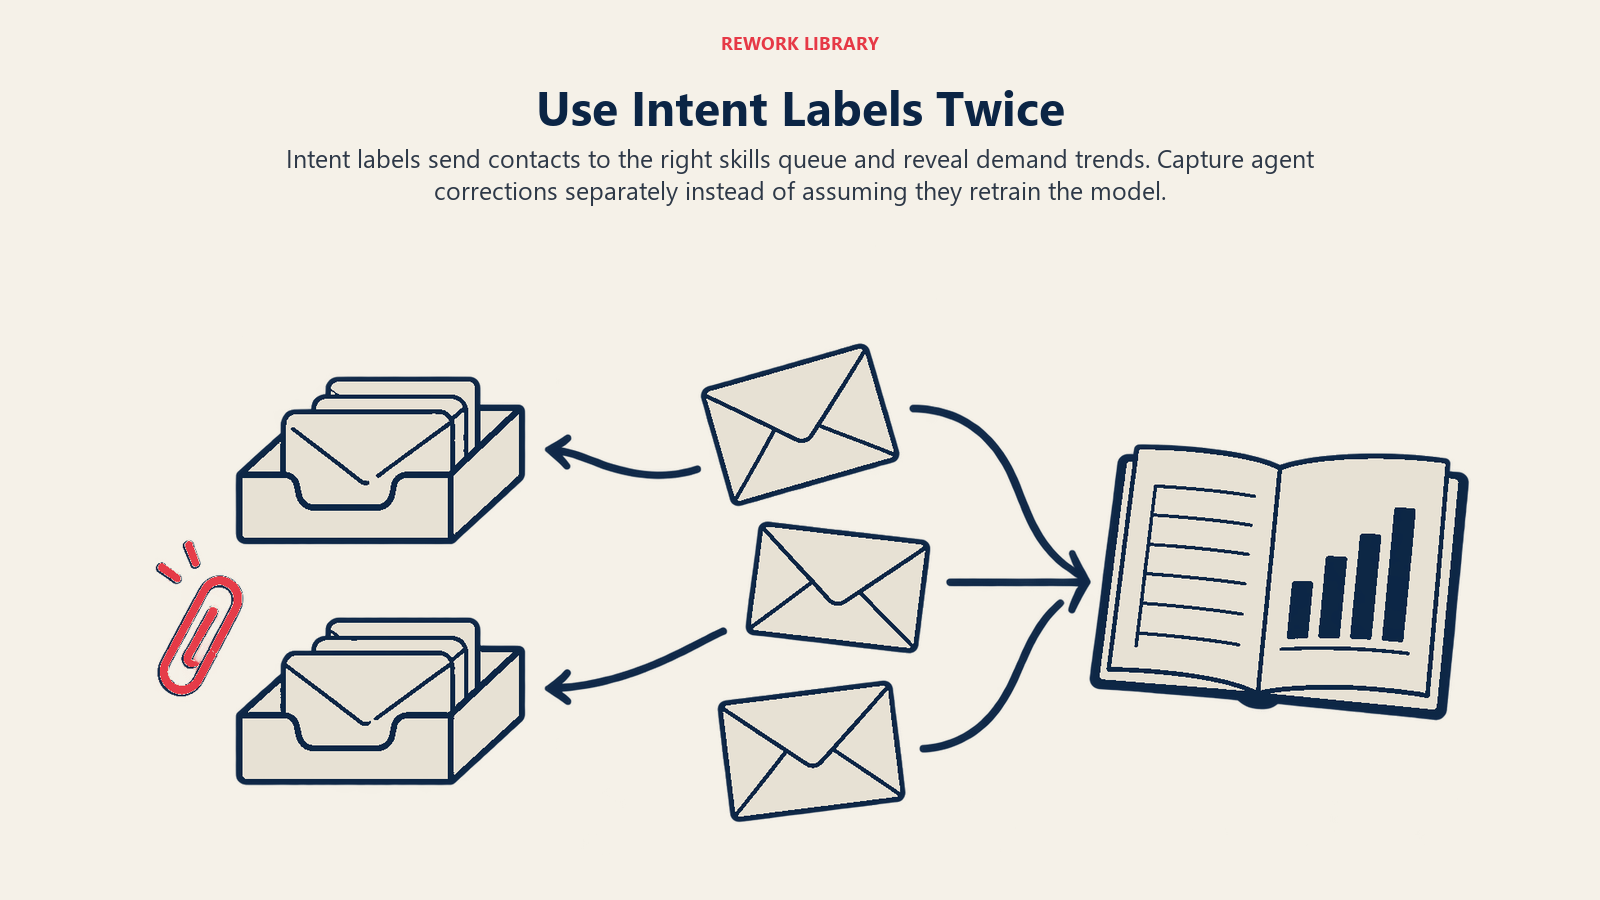
- スキルベースのルーティング。 請求のインテントは請求チームへ、技術的なインテントは技術チームへ送り、言語を第2のフィルターにします。
- ボットか人か。 注文の追跡のような、リスクが低く明確に定義されたインテントは自動化へ回します。解約、法的な脅し、セキュリティなどの機微なものは、常に人に回します。
- 優先度。 インテントに、感情と顧客のティアを組み合わせます。高額アカウントからの、ネガティブな感情を伴う「サブスクリプションの解約」リクエストは、キューの先頭に割り込みます。
- 担当者向けの事前入力ヘルプ。 検出されたインテントと、提案する記事やマクロを担当者の画面に表示します。これはAIエージェントアシストとうまく組み合わさります。
修正には人を関与させ続けてください。Zendeskでは、担当者がチケットのプロパティパネルで予測されたトピックを変更できますが、それではモデルは学習されないと明記されています(Zendesk)。つまり、再ラベル付けのために書き出せる項目など、活用できる場所に修正を記録する必要があります。そうしなければ、同じ誤りが繰り返されます。
レポート
すべての問い合わせにインテントが付くと、これまで手作業の監査が必要だった次のような問いに答えられるようになります。
- 顧客が連絡してくる理由の上位10は何で、どのように推移しているか。
- 解決率が最も低く、再問い合わせが最も多いインテントはどれか。インテントをAIの解決率の指標と組み合わせると、自動化が実際にどこで機能しているかが分かります。
- ヘルプセンターを改善すれば答えられるようになるインテントはどれか。AIヘルプセンター検索をご覧ください。
インテントの件数は、AIサポートの問い合わせ量の需要予測の自然な入力にもなります。問い合わせ理由別の予測は、合計1本の線よりも役立ちます。「パスワードのリセット」と「請求の紛争」は、異なる要因に反応し、必要な要員配置も異なるためです。
職種別の実例
カスタマーサポート。 あるソフトウェア企業は、受信するすべてのチケットにタグを付けています。「レポートをエクスポートするにはどうすればよいですか」はヘルプセンターの返信に回り、「エクスポートが壊れています」はバグフラグ付きで技術サポートに回ります。言葉は同じでも、インテントが違い、キューも違います。
財務と請求。 あるサブスクリプション事業では、report_billing_errorとrequest_refundを分けています。前者は調査できるキューに、後者は承認ルールが必要なキューに回ります。
ITヘルプデスク。 社内のサービスデスクは、request_access、report_outage、reset_passwordを検出します。パスワードのリセットはセルフサービスに、障害は当番のエンジニアに通知され、アクセスの依頼は承認フローを起動します。
営業の受信トレイ。 共有の受信トレイは、request_pricing、request_demo、support_question_from_customerに仕分けています。3つ目を営業のキューから外すことで、本物のリードへの応答時間が守られます。
ステップごとの実装手順
- サンプルを集めて読む。 すべてのチャネルから、直近の問い合わせを300から500件集めます。本当の理由を、顧客の言葉で書き留めます。
- 分類体系の案を作る。 親から先に、次に子を、動詞から始まる名前で作ります。定義、例文、「その他」のバケットを追加します。
- テストセットを人手でラベル付けする。 2人が独立に、200から300件のメッセージにラベルを付けます。2人の意見が分かれた箇所は、定義が不明確ということです。モデルに触れる前に直してください。
- 方式を選ぶ。 安定した件数の多いインテントには学習済みの分類モデル、ロングテールや多言語にはLLM、両方が必要ならハイブリッドを選びます。
- しきい値とフォールバックを設定する。 自動アクションには保守的に、ルーティングにはゆるめに始めます。フォールバックの経路は、ローンチ前に定義します。
- シャドーモードで稼働させる。 インテントを予測して担当者に表示しますが、まだそれに基づくルーティングは行いません。予測と、担当者が実際に行ったことを比較します。
- 成績のよいインテントからルーティングを有効にする。 インテントごとに精度は異なります。強いものから先にオンにします。
- ループを閉じる。 担当者の修正を記録し、「その他」を毎月サンプリングし、スケジュールに沿って再学習またはプロンプトの見直しを行います。
よくある落とし穴
チームを軸に分類体系を作る。 インテントが組織図をなぞっていると、組織再編でレポートが壊れます。顧客の目的に基づいて作ってください。
精度という1つの数字を追いかける。 全体の精度では、「注文の追跡」が98%正しく、「サブスクリプションの解約」が60%しか正しくないことが隠れてしまいます。インテントごとに測定し、件数と、誤りのコストで重み付けしてください。
範囲外の扱いがない。 CLINC150の作成者が見出したとおり、分類モデルは既知のインテントの範囲外のクエリに苦戦します(Larsonら、arXiv)。明示的なフォールバックがないと、一覧にないメッセージが誤ったラベルに無理やり当てはめられます。
最初のメッセージだけにラベルを付ける。 顧客は曖昧な形で始め、後から明確にすることがよくあります。最初のインテントと最終的なインテントの両方を保持してください。
インテントだけをシグナルにする。 感情、顧客のティア、チャネルと組み合わせてください。同じインテントでも、トライアルのユーザーとエンタープライズのアカウントとでは、異なる対応が求められます。
顧客インテント検出に関するよくある質問
顧客インテント検出とは何ですか?
顧客のメッセージを、返金依頼や配送トラブルなど、連絡してきた理由に自動で分類することです。結果は、多くの場合は信頼度スコアを伴うラベルで、ルーティング、自動化、レポートを動かします。
インテントとトピックの違いは何ですか?
トピックは「請求」のような広いカテゴリです。インテントは、「二重請求の返金を依頼する」のような具体的な目的です。トピックは経営層向けのダッシュボードに適しており、インテントは、誰がその問い合わせを担当し、次に何が起きるかを決められるほど具体的です。ベンダーによっては2つの言葉を同じ意味で使うため、自社のプラットフォームでの定義を確認してください。
信頼度のしきい値は、どの程度にすべきですか?
普遍的な数値はありません。Dialogflow CXやAmazon Lexのようなプラットフォームでは、自分で設定でき、Lexはそのスコアが絶対値ではなく比較のための値だと注意しています。人手でラベル付けしたサンプルでテストし、自動アクションにはルーティングよりも厳しいしきい値を設定してください。
インテントはいくつ用意すべきですか?
それぞれが次の行動を変えるのに十分な数で、かつ、モデルが区別でき、担当者が覚えられる程度の少なさです。多くのチームは、いくつかの親カテゴリと数十の子インテントに落ち着きますが、件数と製品の複雑さによって決まります。
分類モデルとLLMのどちらを使うべきですか?
分類モデルは、安価で高速で、組み込みのスコアがあるため、安定した件数の多いインテントに向いています。LLMは、雑然とした入力や多言語の入力、新しいインテントに、再学習なしで対応できます。多くのチームは両者を組み合わせ、上位のインテントには分類モデルを、一致しなかったものにはLLMを使っています。
「その他」のバケットはどう扱うべきですか?
センサーとして扱ってください。毎月サンプルを読み、繰り返し現れるパターンを新しいインテントに昇格させ、「その他」が増え続けるようなら、分類体系が古くなっているサインと受け止めます。目安となる目標は、件数の約10%未満に保つことです。

Customer Success Operations Manager