多言語カスタマーサポートのためのAI:リアルタイム翻訳とローカライズ
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
多言語カスタマーサポートのためのAIとは、機械翻訳と多言語対応の大規模言語モデルを使って、顧客のメッセージをある言語で読み、別の言語で返信する仕組みです。3言語を話せるチームが、30言語に対応できるようになります。 担う仕事は3つあります。担当者向けの受信メッセージの翻訳、顧客向けの返信の翻訳、そして顧客が自分で読むヘルプコンテンツのローカライズです。一方で、翻訳が正しいことまでは保証しません。そこは、マネージャーが設計で補う部分です。
このガイドは、AI翻訳をどこまで信頼するか、どの言語から開放するか、どこで人が出力を確認すべきかを判断するサポートリーダー向けです。幅広いカスタマーサービスにおけるAIの全体像の中にあり、ここで特に重要な2本の記事、サポートチャネル全体でAIがどう機能するかとAIのためのサポートデータの準備を前提にしています。
重要なポイント
- CSA Researchの2020年の消費者調査「Can't Read, Won't Buy」(29カ国の消費者8,709人、2020年7月公開)では、76%が、自国語で情報が提供されている製品を、同程度で提供されていない製品より選ぶと回答し、40%が、他言語のウェブサイトからは購入しないと回答しました(CSA Research)。
- 2024年の機械翻訳会議(Conference on Machine Translation)の一般タスクでは、11の言語ペアについて、8つの大規模言語モデルと4つのオンライン翻訳プロバイダーを含むシステムを比較し、108人の人間のアノテーターによる57,000件を超える評価が使われました(WMT24 findings)。
- 同じ研究では、テストした分野で英語からスペイン語への翻訳はほぼ完璧でしたが、音声は難しい分野だと指摘しており、機械翻訳はまだ解決していないという論文タイトルがそれをはっきり示しています(WMT24 findings)。
- ポストエディットの規格ISO 18587は、「フル」ポストエディットを人間による翻訳に匹敵する品質への道筋と位置づけており、委員会の要約は、資格のあるポストエディターだけが関わるべきだと強調しています(ATC ISO Committee)。
言語対応が売上と継続利用の問題である理由
言語の不足が最初に表面化するのは、多くの場合サポートです。マーケティングはホームページを4言語に翻訳しているかもしれません。しかし、読み慣れない言語で問い合わせなければならない顧客こそが、利用を続けるかどうかを決める人です。
CSA Researchのデータは購買に関するもので、サポートに関するものではないため、慎重に使ってください。言語の好みが購買の判断を左右することは示しています。2020年版では、回答者の76%が自国語で情報が提供されている製品を好み、40%は他言語のサイトからは購入しないと答えました(CSA Research)。ただし、これは表明された好みの調査で、対象は買い物行動です。母国語でのサポートが解約を減らす証拠として引用しないでください。裏付けられるのは、もっと限定的な点です。顧客に選択肢があるとき、言語は、その会社が自分のための会社かどうかを判断する材料の一部になります。自分の言語でのサポートは、その体験の一部です。
現実的な問題は要員配置です。すべての言語、すべてのシフトにネイティブの担当者を採用できるのは、最大規模の市場だけです。AI翻訳は、ロングテールを埋めます。週に2,000件ではなく、20件のチケットが届く言語です。
サポートの業務フローでAI翻訳はどう機能するか
ベンダーごとの呼び名の下には、実質的に4つの仕組みがあります。それぞれ失敗の仕方が違うので、名前を付けておくと役立ちます。
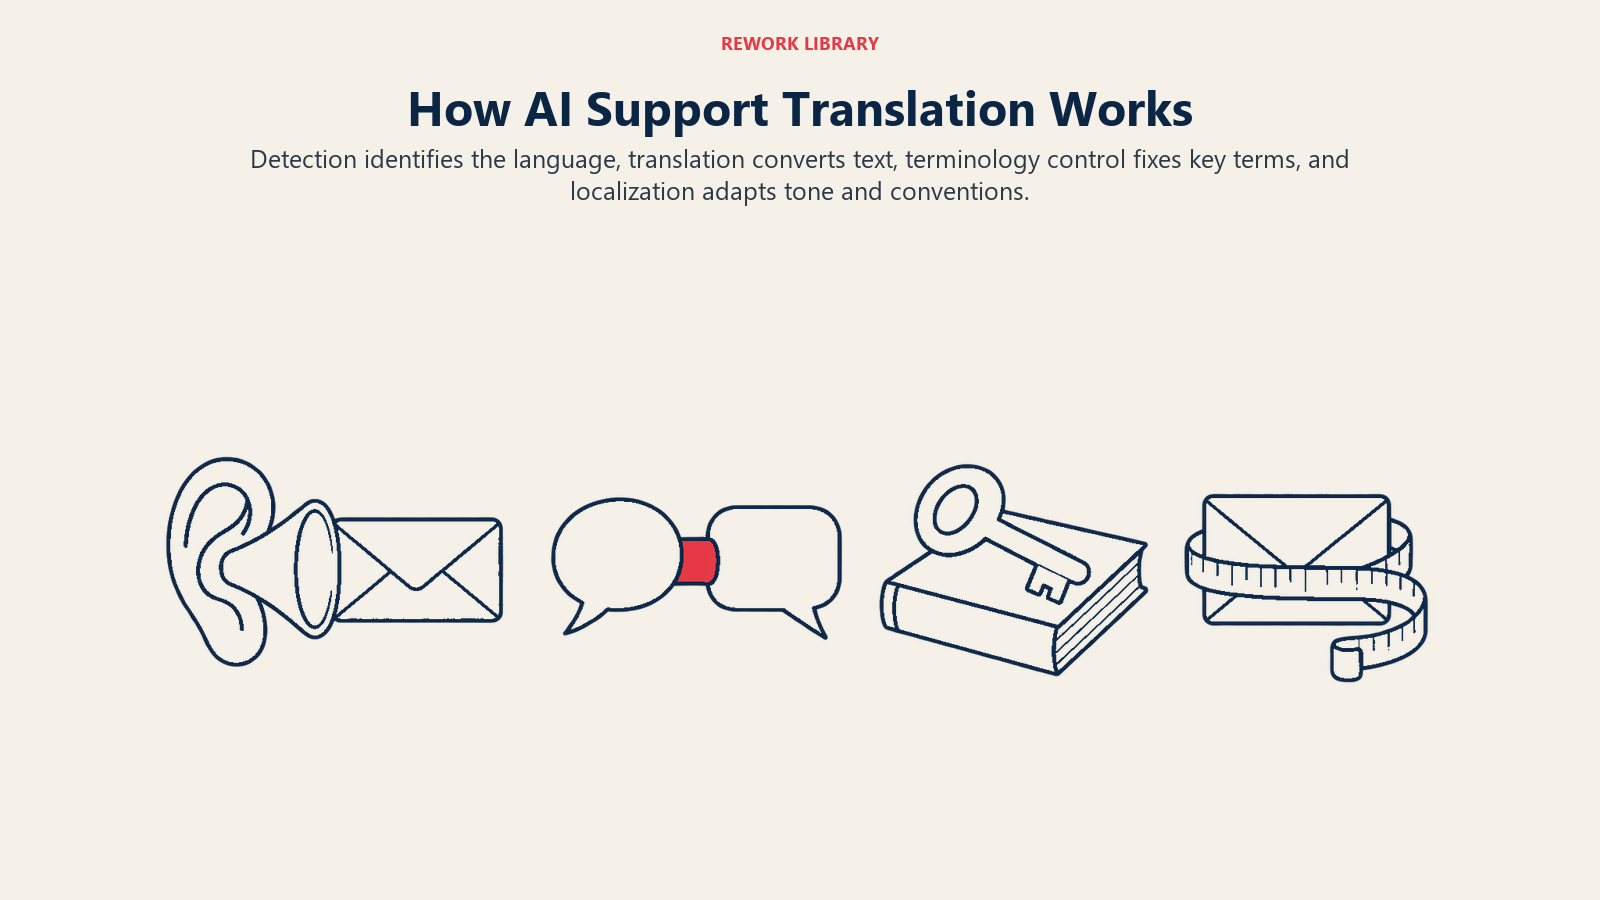
言語検出。 システムがメッセージの書かれた言語を特定します。元の言語を指定しなければ、翻訳サービスは通常これを自動で行います。GoogleのCloud Translationのドキュメントが、基本APIについてそう説明しています(Google Cloud)。簡単そうに聞こえますが、顧客が短いメッセージを書いたとき、2つの言語が混ざっているとき、製品コードを貼り付けたときは、そう簡単ではありません。
機械翻訳。 モデルがテキストを元の言語から対象の言語に変換します。従来のニューラル機械翻訳システムと、新しいLLM型の翻訳モデルの両方があります。たとえばGoogleのドキュメントは、標準のニューラルモデルがデフォルトで、別のLLM型翻訳モデルは選択して使うオプションだと説明しています(Google Cloud)。どちらを選ぶかはベンダー評価の問題であり、ブログ記事で決めることではありません。
用語の管理。 用語集で、製品名、プラン名、主要な用語を毎回どう翻訳するかをシステムに指示します。Googleの実装では、用語集のエントリが通常の翻訳より優先され、照合はデフォルトで大文字と小文字を区別し、用語は通常5語未満で、用語集にはバージョン管理がないため、元のファイルは自分で保管します(Google Cloud)。プラットフォームによって細部は異なりますが、原則は同じです。「Workspace」や「Sprint」がドイツ語で何になるかを決めるのはモデルではなく、あなたです。
ローカライズ。 言葉だけでは終わりません。日付、通貨、単位、丁寧な言い方とくだけた言い方、法的な言い回し、トーンは、市場ごとに異なります。文法的には完璧な返信でも、失礼に、くだけすぎに、あるいは法的に誤って聞こえることがあります。翻訳ツールだけでは多言語サポート機能にならないのは、ローカライズがあるからです。
ACE Frameworkの観点では、翻訳は主にIngest(メッセージを読む)、Analyze(言語とインテントを検出する)、Generate(返信を作成する)にあたります。翻訳した返信を、人が確認せずに顧客の目に触れさせることは、実質的にExecuteのステップです。会社の名前で言葉を送っているからです。
導入の3つの方法
多くのチームは、次の3つのパターンのどれかに落ち着きます。適切なパターンは、デモでの翻訳の出来ではなく、リスクで決まります。
| パターン | 仕組み | 向いているケース | 主なリスク |
|---|---|---|---|
| 受信翻訳のみ | 顧客は自分の言語で書き、担当者は翻訳を読んで、チームの言語で返信する | ネイティブ話者はいないが、英語で返信する方針があるチーム | 顧客が聞いてもらえていないと感じる、第二言語の返信を理解できない可能性がある |
| 下書きとレビュー | AIが担当者の返信を翻訳し、担当者かバイリンガルのレビュー担当者が送信前に確認する | B2Bやアカウント関連のサポートの大半 | レビューが確認せずに承認することになる |
| ガードレール付き自動翻訳 | 翻訳は双方向でリアルタイムに行われ、レビューはなく、承認済みのトピックに限定される | 注文状況や営業時間など、件数が多くリスクの低い質問 | リスクが低いと思っていたトピックでの誤訳 |
抜けている行に注目してください。「すべてを自動で翻訳する」という4行目はありません。それはパターンではなく、判断をしていないということです。自動化か支援かという問いは、サポートの他の部分と同じように翻訳にも当てはまります。
職種別の実例
同じ技術でも、使う人によって見え方が違います。
第一線の担当者。 クアラルンプールのサポート担当者に、ポルトガル語のチケットが届きます。ツールは原文と翻訳を並べて表示し、返信を下書きします。担当者はまず英語で編集し、送る内容を正確に理解します。その下書きは逆翻訳されて表示されます。逆翻訳が不自然に読めたら、彼女はそのまま信頼せず、文を簡単にします。
セルフサービスとヘルプセンター。 ある会社が、閲覧数の多い上位200件のヘルプ記事を機械翻訳で翻訳し、上位20件についてネイティブ話者にスポットチェックしてもらいます。検索結果とチャットボットは、翻訳済みの記事を使って、顧客の言語で回答します。1本の翻訳記事が数千人の読者に役立つため、最もレバレッジの大きい出発点です。顧客が記事を見つける方法を改善したい場合は、AIを活用したヘルプセンター検索の記事で検索の側面を扱っています。
音声とライブチャット。 チャットのリアルタイム翻訳は今では一般的で、音声翻訳も向上していますが、音声はより難しい分野です。WMT24の主催者は、音声を機械翻訳システムにとって難しい分野だと述べています(WMT24 findings)。ある言語の音声の件数が無視できない規模なら、単純な依頼を超える内容では、リアルタイム翻訳の層よりバイリンガルの担当者のほうが優れています。
法務、財務、コンプライアンス。 返金ポリシーをめぐる争い、データ削除のリクエスト、契約変更の通知は、その言語に対応できる資格のある人が担当します。ここでの言葉の誤りは、義務の内容を変えてしまいかねません。「確認なしのAIは使わない」という線を引くのに、最もわかりやすい場所です。
品質についてエビデンスが示すこと
品質は1つの数字ではありません。言語ペア、テキストの種類、内容のフォーマルさによって変わります。最も優れた公開エビデンスは、プロの人間の審査員を使ってシステムを比較する、年次の機械翻訳会議から得られます。
2024年版では、主催者は、研究用システムに加えて、8つの大規模言語モデルと4つのオンラインプロバイダーから、11の言語ペアにわたる翻訳を集め、108人のアノテーターが57,000件を超える評価を寄せました(WMT24 findings)。サポートマネージャーにとって重要な点が3つあります。
- 言語ペアによって性能は大きく異なります。 論文は、テストした分野で英語からスペイン語への出力がほぼ完璧だったと報告していますが、それでも論文のタイトルは、機械翻訳は解決していないと述べています。最も珍しい言語が、最も一般的な言語と同じ性能だとは考えないでください。
- 最終的な審判は人間による評価です。 著者らは、自動評価指標で最上位だったシステムが、人間による評価では全面的な勝者ではなかったことを確認し、翻訳品質の最終的な審判は人間による評価であるべきだと結論づけました(WMT24 findings)。あなたにとっては、ベンダーの品質スコアは出発点だということです。自社のチケットで、バイリンガルのレビュー担当者とともにテストしてください。
- テスト素材はサポートチケットではありませんでした。 分野はニュース、ソーシャルメディア、音声、文学、教育のテキストでした。これは研究の対象範囲についての観察であり、批判ではありません。サポートのメッセージは短く、感情的で、製品用語だらけで、しばしば綴りも乱れているため、結果はどちらの方向にも変わる可能性があります。
翻訳を安全に保つレビュールール
品質の限界は、リスクに応じてルールを設ければ管理できます。出発点として使える例を挙げます。
影響の大きさで段階分けする。 翻訳するコンテンツを3つのグループに分けます。低リスク(注文状況、営業時間、操作手順)は、スポットチェックのみで送信できます。中リスク(請求の説明、アカウントの変更、データ損失につながりうるトラブルシューティング)は、送信前にバイリンガルのレビュー担当者の確認が必要です。高リスク(法的条件、一定額を超える返金、安全性、規制対象のトピック)は、返信を自分で書くか全面的に編集する、資格のある人が必要です。
ポストエディットの区別を借りる。 翻訳業界には、機械翻訳の出力をレビューするための規格ISO 18587があります。軽いポストエディットとフルポストエディットを区別し、フルポストエディットは人間による翻訳に匹敵する品質を達成するものと説明しており、顧客が必要とする内容に応じてレベルを適用します(ATC ISO Committee)。この考え方を借りるのに、認証は必要ありません。担当者が翻訳された受信チケットにざっと目を通すといった社内利用であれば、さっと読むだけで十分です。重大なトピックの顧客向けテキストには、その言語の資格を持つ人による、徹底した対応が必要です。
数字、名前、否定表現は必ず確認する。 実害を生む誤りは、ぎこちない文法であることはまれです。金額の誤り、入れ替わった日付、抜け落ちた「ない」、英語のままにすべきだったのに翻訳されてしまった製品名です。短いチェックリストを作って、レビュー担当者の目の前に置いてください。
原文を見える状態に保つ。 翻訳されたすべての会話には、顧客の元のメッセージと自社の元の返信を保存し、紛争やQAレビューのときに、実際に何が伝えられたかを確認できるようにします。誤訳は、他のAIのハルシネーションと同じように扱ってください。流暢で、自信に満ちていて、ときどき間違っています。
逃げ道を用意する。 人間、または別の言語に切り替えられる目に見える選択肢を提供します。これは、AIサービスに対する顧客の期待のテーマにそのままつながります。人は、逃げ道があれば自動化を受け入れます。
多言語AIサポートを段階的に導入する方法
- データから言語の構成を把握する。 過去6か月のチケットを言語別に集計します。顧客がその言語で書いているのに、現在は英語で返信している言語も含めてください。それが需要の曲線です。
- 件数とリスクで、最初の2、3言語を選ぶ。 件数が多く、リスクの低いトピックから始めます。8言語を一度に開放しないでください。
- 会話より先にヘルプセンターを翻訳する。 レビュー済みの1本の記事が、数千人の顧客に役立ちます。閲覧数とチケットのデフレクション(問い合わせ削減)の上位の記事から始めます。
- 用語集を作る。 製品名、プラン名、機能名、翻訳したくない言い回しを一覧にします。対象言語の用語は、ネイティブ話者に承認してもらいます。元のファイルは、自分でバージョン管理してください。
- 言語ごとにスタイルシートを書く。 丁寧な言い方とくだけた言い方、挨拶のスタイル、顧客の呼び方、単位と日付の形式を定めます。2ページあれば十分です。
- トピックごとに導入パターンを選ぶ。 上の表を使います。それぞれの問い合わせ理由を、受信のみ、下書きとレビュー、ガードレール付き自動翻訳のいずれかに割り当てます。
- レビュー担当者を確保する。 バイリンガルの担当者、現地のパートナー、または待機している翻訳ベンダーです。レビューを何時間以内に行うかを決めてください。レビューが遅ければ、リアルタイムサポートの意味が失われます。
- ベースラインを取ってパイロットを行う。 パイロット言語のCSAT、初回応答時間、再オープン率、エスカレーション率を、開始前の同じ指標と比較します。
- 失敗を毎週レビューする。 顧客が「わかりません」と返信した、または人間を求めた会話のトランスクリプトを読みます。用語集、スタイルシート、トピックのルールを直してから、拡大します。
元の素材の品質は、翻訳と同じくらい重要です。乱雑なマクロや古い記事は、乱雑で古い回答として、十数の言語に翻訳されてしまいます。展開の前にAIのためのサポートデータの準備が来るのは、そのためです。
避けるべき落とし穴
翻訳を立ち上げ時のチェック項目として扱う。 ウィジェットがその言語に翻訳できるからといって、その言語を「サポートしている」と言うのは、その顧客にきちんと対応しているということではありません。言語ごとに成果を測定してください。
担当者が読めない言語で返信させる。 担当者が理解できない翻訳済みの返信を送ってしまうと、誤りに気づけず、追加の質問にも答えられません。逆翻訳かレビュー担当者を使ってください。
英語のままにすべきものを翻訳する。 製品名、エラーコード、APIの用語、ボタンのラベルは、顧客が自社のインターフェースで目にするものと一致している必要があることが多いです。用語集でほとんど解決できます。
方言や言葉遣いの違いを無視する。 メキシコ、スペイン、アルゼンチンのスペイン語は、語彙もトーンも異なります。ブラジルとポルトガルのポルトガル語も同様です。顧客が実際に使っている変種を選んでください。
データとプライバシーの確認を省く。 顧客のメッセージをサードパーティの翻訳サービスに送ると、個人データが移動します。どこで処理され、何が保持されるのか、自社の契約と現地のルールがそれを許しているかを確認してください。
測定すべき指標
- 品質: レビュー担当者が編集した翻訳済み返信の割合、レビューで見つかった誤りの種類(数字、用語、トーン、抜け)。
- 成果: CSAT、初回解決率、再オープン率を、言語別、および翻訳された会話とネイティブの会話別に分けて見ます。
- スピード: 言語ごとの初回応答時間とレビューの所要時間。
- カバレッジ: 顧客自身の言語で回答した件数の割合と、各言語で利用できるヘルプ記事の割合。
- コントロール: バイリンガルの担当者へのエスカレーション率と、言語の切り替えや人間との会話を求めるリクエストの件数。
次に読む記事
小さく始めましょう。最大の非英語の言語を1つ選び、上位のヘルプ記事を翻訳し、リスクの低い1つのトピックのチケットで、下書きとレビューを試します。1か月間、ベースラインと比較して測定します。そのうえで、言語を追加するか、そのトピックのレビューを緩めるかを決めます。どこまでを機械に任せるか迷っているなら、自動化か支援かのガイドが判断の枠組みを示します。カスタマーサービスにおけるAIの総論記事では、翻訳が他の仕事の中でどこに位置づくかがわかります。レビューの人的な側面については、誤った一語にコストが生じる場面では常にヒューマン・イン・ザ・ループを維持してください。

Customer Success Operations Manager