サポートの問い合わせ量と要員配置のためのAI需要予測
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
サポートの問い合わせ量の予測とは、各時間帯(通常は30分または1時間ごと)にどれだけの顧客からの問い合わせが届くかを予測し、その予測を、サービスレベルの目標を達成するために必要なシフト上の担当者数に変換する取り組みです。 これは2つの仕事が組み合わさったものです。需要の予測と、需要を人員に変える要員配置の計算です。AIが主に改善するのは、前者です。後者は今も古典的な待ち行列の計算であり、予測が外れたときには容赦がありません。
マネージャーが見落としがちなのは、この部分です。5%低すぎる予測は、5%のサービス上の問題を生むのではなく、待ち行列が暴走する事態を生みかねません。このガイドでは、要員配置の計算の仕組み(Erlang Cとその限界)、予測精度を正直に測る方法、機械学習が単純なベースラインに勝つ場面、そしてAIのデフレクション(問い合わせ削減)が、問い合わせ量と残る問い合わせの構成の両方をどう変えるかを扱います。AI for Customer Serviceコレクションの一部なので、全体像はカスタマーサービスにおけるAIの概要から始めてください。
重要なポイント
- Erlang Cモデルは、ポアソン到着、指数分布のサービス時間、各時間帯内で一定の到着率を前提とし、ブロッキング、放棄、再試行は無視します(Gans, Koole and Mandelbaum)。
- 同じ論文の例では、稼働率95%を想定して計画したセンターで、到着率が5%高くなると、稼働率は99.75%まで上昇し、待ち時間が急増するか、放棄が計画を大きく上回ります(Gans, Koole and Mandelbaum)。
- コンタクトセンターのシュリンケージは、通常、スケジュールされた時間の25%〜40%の範囲で、平均はおよそ30〜35%です(NICE)。
- 予測の教科書の指針:より凝った手法を検討する価値が出る前に、季節ナイーブ法のような単純なベンチマークを上回るべきです(Hyndman and Athanasopoulos, FPP3)。
- 統計的手法と機械学習手法を大規模に比較した研究では、機械学習手法は、両方の精度指標と検証したすべての予測期間で劣り、はるかに多くの計算を必要としました(Makridakis et al., PLOS ONE)。
予測から人員数へ:Erlang Cの役割
Erlang Cは、コンタクトセンターの要員配置の主力です。到着率、平均対応時間、目標を与えると、その時間帯に必要な担当者数が得られます。Gans、Koole、Mandelbaumによる分野のレビューは、一般的な実務をこう説明しています。30分ごとの時間帯にそれぞれErlang Cモデルを実行し、各時間帯を定常状態として扱い、予測した到着率とサービス時間から、その期間の目標となる配置水準を求めます。こうした時間帯ごとの数値が、スケジューリングモデルに入力されます(Gans, Koole and Mandelbaum)。
主に4つの用語が役割を担います。
- トラフィック(アーランで表示) は仕事量です。時間帯内の問い合わせ数に平均対応時間を掛け、時間帯の長さで割ったものです。30分(1,800秒)の時間帯に、1件300秒の問い合わせが120件なら、120 × 300 / 1,800 = 20アーランです。わかりやすく言えば、ペースを保つだけで20人の担当者が必要です。
- サービスレベル は、しきい値内に応答できた問い合わせの割合です。たとえば、20秒以内に80%などです。
- 稼働率(オキュパンシー) は、担当者の時間のうち、問い合わせの対応に使われた割合です。20アーランを25人の担当者で処理するなら、稼働率は20 / 25 = 80%です。
- シュリンケージ は、休憩、研修、会議、欠勤などで、担当者が対応できない有給時間の割合です。NICEは、これを非生産的な活動で失われた時間を、スケジュールされた総時間で割ったものと定義し、内部(計画的)と外部(計画外)のシュリンケージに分けています(NICE)。
具体的な計算例
あるキューで30分間に120件の問い合わせが見込まれ、平均対応時間が300秒で、80%を20秒以内に応答したいとします。標準的なErlang Cの式を使うと、数値は次のようになります。
| キューの担当者数 | 稼働率 | サービスレベル(20秒以内に応答) | 平均応答速度 |
|---|---|---|---|
| 22 | 91% | 50.3% | 85秒 |
| 23 | 87% | 66.0% | 42秒 |
| 24 | 83% | 77.2% | 22秒 |
| 25 | 80% | 85.0% | 13秒 |
| 26 | 77% | 90.4% | 7秒 |
24人では目標に届かず、25人で達成できます。ここでシュリンケージを加えます。シュリンケージが30%なら、生産的な担当者25人は25 / (1 - 0.30) = 35.7となるため、その30分には36人をスケジュールすることになります。
そして、同じ例で予測のリスクを見てみましょう。問い合わせ量が計画より5%多く(120件ではなく126件)なり、25人を配置していた場合、サービスレベルは85.0%から約76.5%に下がります。問い合わせ量の5%の外れで、目標を下回りました。24人なら、同じ5%の外れで、サービスレベルは約65%まで下がります。曲線は急で、これはまさにGansの論文が警告していることです。性能は到着率の凸関数であるため、不確実な予測のもとでの実際の性能は、通常、計画と同じではなく、計画より悪くなります(Gans, Koole and Mandelbaum)。
Erlang Cが成り立たない場面
Erlang Cはモデルであり、そのモデルには既知の限界があります。手元に置いておくべきは、レビュー自身が挙げているリストです。時間帯内で一定の到着率、ポアソン到着、指数分布のサービス時間、そして無視されるブロッキング、放棄、再試行です(Gans, Koole and Mandelbaum)。実際には、次のような意味になります。
- 放棄がない。 Erlang Cは、すべての顧客が、必要なだけ待つかのように扱います。実際の顧客は、電話を切ったり、チャットを閉じたりします。同じレビューは、放棄がなければ、到着率が処理能力を上回ると待ち行列が際限なく伸びる一方で、放棄を含むモデルは安定を保ち、処理能力と放棄や遅延のトレードオフを検討できると指摘しています。
- 到着率が既知。 予測を真実として扱います。論文が述べるように、到着率は過去のデータから予測されるもので、確実にはわからず、それを無視するのは危険になりえます。
- 一度に1件の問い合わせ。 古典的な式は、電話のような、1件ずつ対応するチャネルに当てはまります。チャットやメッセージングの担当者は複数の会話を同時に扱い、メールは非同期なので、チームは通常、同時対応数の係数で調整するか、別のモデルを使います。上の表は、音声の場合として扱ってください。
- 同一の担当者。 新人とベテランでは、対応の速さが違い、対応時間はトピックの構成によっても変わります。
こうした点があっても、Erlang Cが役に立たなくなるわけではありません。バッファとフィードバックのループを必要とする、良い最初の見積もりになるということです。多くのチームは、Erlangの数値の上に安全マージンを加えており、優れた予測の取り組みは、そのマージンが吸収しなければならない不確実性を縮めることに重点を置いています。
予測精度の測り方
どの予測手法を比べるにしても、その前に物差しを合意しておきます。HyndmanとAthanasopoulosは、Forecasting: Principles and Practiceで標準的な指標を定義しています(FPP3)。
| 指標 | 内容 | 向いているケース | 注意点 |
|---|---|---|---|
| MAE | 絶対誤差の平均(問い合わせ件数で表示) | オペレーションのリーダーに説明しやすい | 規模に依存するため、小さなキューと大きなキューを比較できない |
| RMSE | 二乗平均誤差の平方根 | 大きな外れに重いペナルティを与える | これも規模に依存し、解釈しにくい |
| MAPE | 絶対パーセント誤差の平均 | 規模の異なるキュー同士の比較 | 実績がゼロのときは定義されず、ゼロに近い夜間の30分枠などでは極端な値になる。負の誤差を、正の誤差より重く扱う |
| MASE | ナイーブなベンチマークに対して調整した誤差 | どの手法でも、ベースラインとの比較を1つの数値で示せる | アナリスト以外にはなじみが薄い |
実務上の帰結が2つあります。1つ目は、MAPEが、サポートチームに頻繁にある時間帯、つまり問い合わせが数件しかない静かな夜間の枠でおかしな挙動を示すことです。MAPEは日次または時間単位の合計で報告し、30分単位ではMAEかMASEを使ってください。2つ目は、FPP3がMASEを、1未満の値が訓練データでベンチマークを上回っていることを意味するように定義しており、季節性のある系列では、そのベンチマークは季節ナイーブ法であることです(FPP3)。これこそ、WFMのリードに示すべき数値です。「先週のパターンを繰り返すより良いか」ということです。
誤差だけでなく、バイアスも測定してください。ある日は8%高く、次の日は8%低い予測は、常に8%高い予測と同じMAEになりますが、後者は体系的な過剰配置の問題です。符号付きの誤差も追跡してください。
機械学習が単純なベースラインに勝つとき
ベースラインから始めます。FPP3の季節ナイーブ法は、各予測を同じ季節の最後の観測値に設定します(今週の火曜10時は、先週の火曜10時と同じ)。本の立場は、そうした手法はベンチマークとして機能し、それを上回れない新しい手法は検討に値しない、というものです(FPP3)。安定したキューで週ごとのリズムが強いなら、季節ナイーブ法か古典的な統計モデルが、勝つのが難しいことがよくあります。統計的手法と機械学習手法の大規模な研究では、機械学習手法は、あらゆる予測期間で精度に劣り、しかもはるかに多くの計算を必要としていました(Makridakis et al., PLOS ONE)。「AI搭載の予測」をうたうベンダーの主張は、この結果を踏まえて受け止めてください。
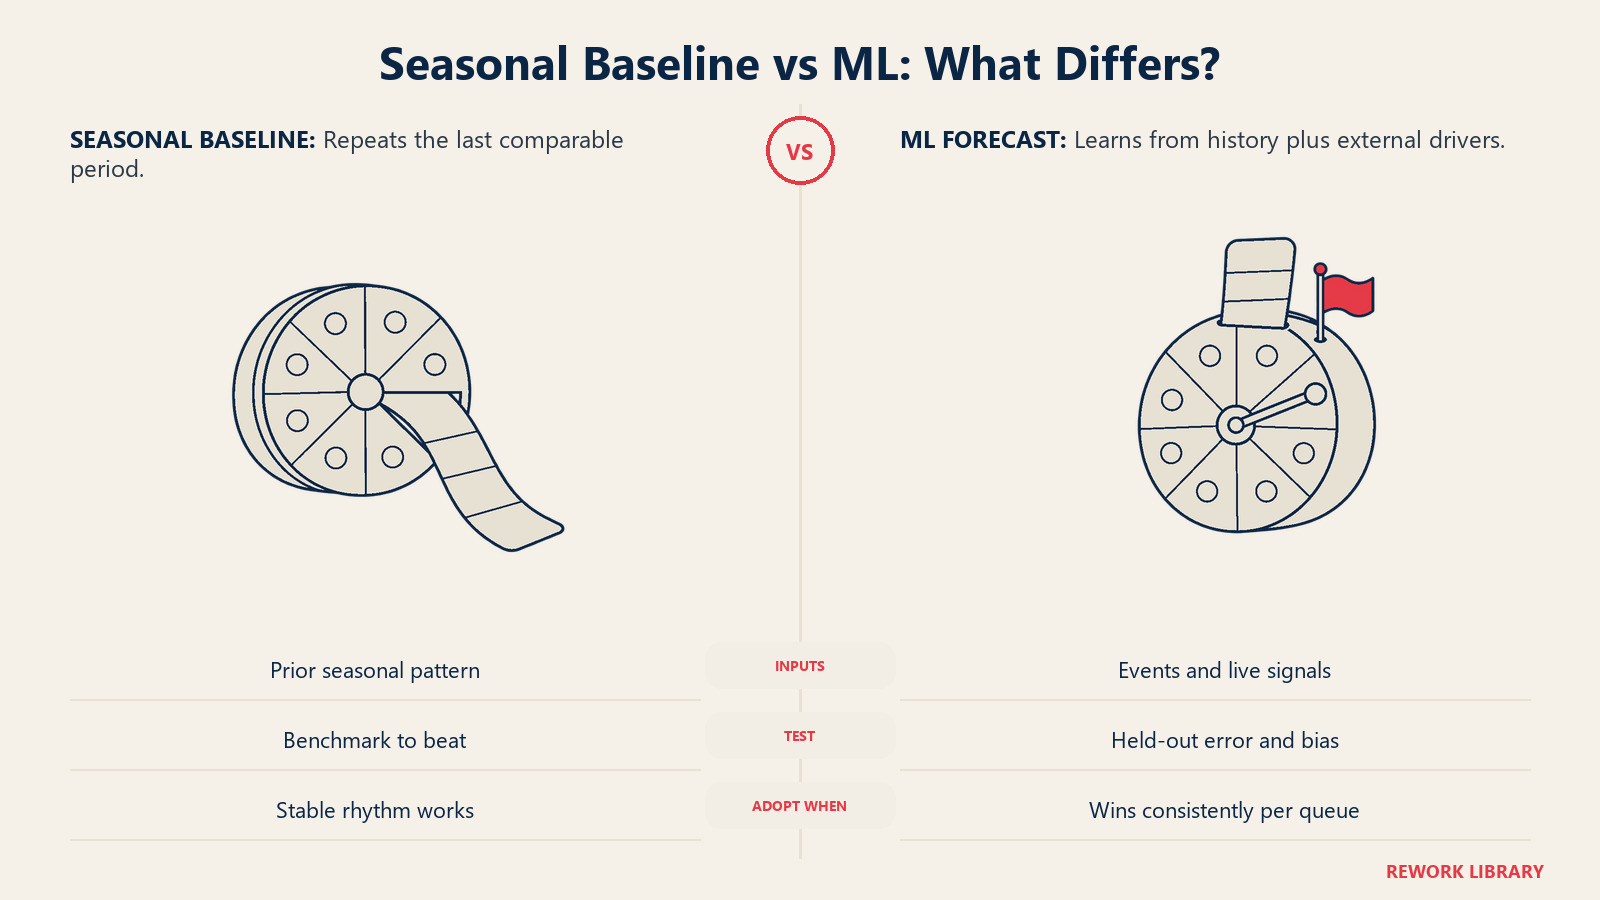
では、MLが役に立つのはどこでしょうか。履歴だけでは足りず、外部のシグナルが変動を説明する場面です。
- 既知の要因。 製品リリース、請求の実行、マーケティング配信、障害、価格変更は、先週のパターンでは予測できない問い合わせ量を生みます。MLモデルは、これらを入力として取り込めます(計画されたイベントのカレンダー、障害フラグ、請求書を発行したばかりの顧客数など)。
- 多数のキューを同時に扱う。 言語、ティア、チャネルごとに予測するなら、系列全体で共通のパターンを学習するモデルが、それぞれの履歴が乏しい小さな系列に役立ちます。
- 日中の補正。 今日の最初の数時間を観察し、残りを再予測するモデルは、急増を早く捉えられます。これは異常検知のパターンです。ライブのストリームを取り込み、ベースラインと比較し、外れ値にフラグを立て、プランナーに通知します。
- 問い合わせ理由。 インテント検出がすべての問い合わせに理由のタグを付けるなら、「請求書への異議」と「パスワードリセット」を別々に予測でき、合計1つよりはるかに役立ちます。
判断の堅実な方法は次のとおりです。少なくとも数週間分の検証用データで、ベースラインとMLモデルを並べて実行し、MASEで比較して、平均ではなく、一貫して勝つ場面にだけMLを採用します。通常の週には勝つのに、重要な週(ローンチや障害)に負けるモデルは、役に立っていません。
AIデフレクションが問い合わせ量と構成をどう変えるか
AIエージェントが受信トラフィックの一部を解決するようになると、履歴は将来を表さなくなります。変わることが2つあります。
問い合わせ量は減りますが、1対1ではありません。 AIが一部の会話を処理すれば、人間のキューに届く問い合わせは減ります。ただし、それは解決をどう数えるかによります。コンテインメントされたことは、解決されたこととは違います。助けを得られなかった顧客は、別のチャネルから戻ってきて、再問い合わせになることがよくあります。
構成が難しくなります。 簡単な問い合わせが最初に消えます。パスワードリセット、注文状況、簡単な使い方の質問などです。残るのは、より長く、複雑で、感情的な問い合わせなので、平均対応時間は伸びます。先ほどの計算例に戻って、AIが問い合わせ量の30%を取り除き(120件が84件になる)、残る問い合わせの対応に30%長くかかる(300秒ではなく390秒)と仮定します。仕事量は84 × 390 / 1,800 = 18.2アーランで、80/20の目標には23人の担当者が必要です。25人より2人少なく、問い合わせが30%減って、担当者は8%減ることになります。シュリンケージ30%を加えると、スケジュールする人数は36人ではなく約33人です。
要点は、問い合わせ量と対応時間を、問い合わせ理由ごとに別々に予測することです。AIエージェントを導入、または変更した後は、再学習するかベースラインを引き直してください。導入前の履歴は、もう別のシステムのものだからです。そして、AIエージェントアシストのようなツールで、残った問い合わせの対応時間が短くなる場合、その効果は問い合わせ量ではなくAHTに現れるため、それを独立した入力として追跡し続けてください。
段階的な構築方法
- きれいな履歴を取得する。 時間帯、チャネル、問い合わせ理由ごとの問い合わせ件数を、少なくとも1年分と、対応時間を取得します。障害、ローンチ、祝日に印を付けて、モデルが学習できるようにします。クリーニング作業は、AIのためのサポートデータの準備で扱っています。
- 予測の粒度を決める。 月次の採用判断なら日次の合計、スケジューリングなら1時間または30分単位です。両方に同じモデルを使わないでください。
- ベースラインを設定する。 各キューに季節ナイーブ法を適用し、MAEとMASEを記録します。それが超えるべき数値です。
- 要因を加える。 計画されたイベント、請求のカレンダー、障害フラグを導入します。より重いMLモデルの前に、外生変数を持つ統計モデルを試してください。
- バックテストする。 検証用の期間の週で手法を比較し、少なくとも1つのローンチまたは障害の週を含めます。全体ではなく、キューごとに選びます。
- 要員配置に変換する。 時間帯ごとにErlang C(放棄や複数同時対応を扱う必要があるならシミュレーションツール)を実行し、(1 - シュリンケージ)で割って、スケジュールする人員数を求めます。
- バッファと日中のループを加える。 ピーク時はErlangの数値よりやや多めに配置し、実績が予測を大きく上回ったときにプランナーへアラートを出して、人員を動かす、残業を依頼する、非同期チャネルに作業を移すといった対応ができるようにします。
- 毎月見直す。 キューごとにMASE、バイアス、サービスレベルの達成率を追跡します。AIエージェントの対象範囲が変わるたびに、ベースラインを引き直します。
避けるべき落とし穴
MAPEだけを使う。 バイアスを隠し、問い合わせの少ない時間帯では破綻します。MAE、MASE、符号付き誤差と組み合わせてください。
問い合わせの合計だけを予測する。 平坦な合計は、構成の変化を隠します。問い合わせ理由とチャネルごとに予測してください。
Erlangの数値を正確なものと信じる。 実際のキューが破る前提の上に立つ見積もりです。バッファを持ち、放棄を監視してください。
日次の平均に合わせて配置する。 サービスレベルは、ピークの時間帯で決まります。時間帯ごとに計画してください。
シュリンケージの変動を無視する。 研修の週、インフルエンザの季節、新人の立ち上がり期間で、シュリンケージは変わります。モデルの中の固定30%は、推測です。
ベースラインを飛ばす。 AIの予測が季節ナイーブ法に勝つことを示せないなら、複雑さにお金を払っているだけです。AIデフレクションを前提に人員計画を削る前に、自動化か支援かの判断を使って、AIデフレクションが適用される範囲を絞り込んでください。
AIによるサポート問い合わせ量の予測に関するよくある質問
カスタマーサポートにおけるErlang Cとは何ですか?
問い合わせ量と平均対応時間から、サービスレベルを達成するために、ある時間帯に必要な担当者数を見積もる待ち行列の式です。ポアソン到着と指数分布のサービス時間を前提とし、放棄と再試行は無視するため、その答えはバッファを加えた出発点として扱ってください。
サポートの問い合わせ量の予測は、どのくらい正確である必要がありますか?
どれだけ処理能力ぎりぎりで運用しているかによるため、万能の数値はありません。稼働率が100%に近いほど、小さな外れが大きく響きます。広く引用されているレビューでは、稼働率95%を想定したセンターに5%多く問い合わせが来ると、稼働率は99.75%になります。キューごとに自社の誤差とバイアスを測定し、そこから目標を設定してください。
シュリンケージとは何で、要員配置でなぜ重要ですか?
休憩、研修、会議、欠勤のために、担当者が問い合わせに対応できない有給時間の割合です。NICEは、コンタクトセンターのシュリンケージの一般的な水準を25%〜40%としています。Erlang Cが出す生産的な担当者数を(1 - シュリンケージ)で割ると、実際にスケジュールすべき人員数が得られます。
サポートの問い合わせ量の予測では、機械学習は単純な手法より優れていますか?
自動的にそうなるわけではありません。予測の指針は、新しい手法を季節ナイーブ法のような単純なベンチマークと比較すべきだとしており、大規模な比較研究では、機械学習手法は精度で劣り、はるかに多くの計算を必要としました。MLが役立ちやすいのは、外部の要因(ローンチ、請求の実行、障害)が変動を説明する場合なので、キューごとにベースラインと比べてテストしてください。
どの予測精度の指標を使うべきですか?
複数を使ってください。MAEは説明しやすく、MASEはナイーブなベンチマークに勝ったか(1未満なら勝っている)を示し、MAPEは規模の異なるキューの比較に便利ですが、ゼロに近い時間帯では破綻します。符号付き誤差も追跡し、一貫して過大か過小かを確認してください。
AIデフレクションは、要員配置の予測をどう変えますか?
問い合わせ量は減りますが、簡単なものがなくなるため、残る問い合わせの対応時間は通常、長くなります。問い合わせ量と対応時間を、問い合わせ理由ごとに別々に予測し、AIエージェントの対象範囲が変わったらベースラインを引き直してください。

Customer Success Operations Manager