Intent-Erkennung im Kundenservice: Wie die AI versteht, warum Kunden Sie kontaktieren
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Die Erkennung des Intents (Anliegens) eines Kunden ist die automatische Zuordnung einer Kundennachricht zu dem Grund, aus dem er Sie kontaktiert, etwa „Wo ist meine Bestellung?“, „Kündigen Sie mein Abonnement“ oder „Mir wurde doppelt etwas berechnet“. Das Ergebnis ist ein Label, meist mit einem Konfidenzwert, das einem Chat, einer E-Mail, einem Ticket oder einem Anruftranskript zugewiesen wird, bevor ein Mensch es liest.
Dieses Label ist klein, aber vieles hängt daran. Es entscheidet, in welcher Queue ein Ticket landet, ob ein Bot antworten oder übergeben soll und was Ihr Monatsbericht darüber aussagt, wonach Kunden tatsächlich fragen. Eine schwache Intent-Ebene schickt Abrechnungsfragen an den technischen Support und versteckt Ihren wichtigsten Kontaktgrund in einem Sammelbehälter namens „Allgemein“. Eine gute liefert Ihnen ein Routing, das vom ersten Tag an funktioniert, und eine Landkarte der Nachfrage, an der Sie planen können.
Dieser Leitfaden behandelt, wie die Erkennung funktioniert, wie Sie die Intent-Liste (die Taxonomie) aufbauen, von der alles abhängt, und wie Sie die Labels einsetzen. Wenn Sie zuerst das größere Bild wollen, ist der Überblick zu AI im Kundenservice eine gute Ergänzung.
Wichtige Fakten
- Dialogflow CX bewertet jeden Kandidaten-Intent von 0,0 (völlig unsicher) bis 1,0 (völlig sicher), gibt den besten Intent nur zurück, wenn er den Klassifikationsschwellenwert überschreitet, und löst andernfalls ein No-Match-Ereignis aus (Google Cloud).
- Google empfiehlt in Dialogflow CX mindestens 10 bis 20 Trainingsphrasen pro Intent, je nach Komplexität des Intents (Google Cloud).
- Amazon Lex V2 gibt den wahrscheinlichsten Intent plus bis zu 4 Alternativen zurück und fällt auf
AMAZON.FallbackIntentzurück, wenn alle Werte unter Ihrem Schwellenwert liegen (AWS). - Das eigene Beispiel von Lex für Mehrdeutigkeit: Werte von 0,75 und 0,72 bedeuten, dass zwei Intents zu nah beieinanderliegen, um sie zu unterscheiden, während 0,95 gegenüber 0,65 bedeutet, dass der erste wahrscheinlich richtig ist (AWS).
- Der CLINC150-Benchmark umfasst 150 Intents in 10 Domänen, und seine Autoren stellten fest, dass Klassifikatoren bei Intents im Geltungsbereich gut abschneiden, aber Mühe haben, Anfragen außerhalb des Geltungsbereichs zu erkennen (Larson et al., arXiv).
- Zendesk zeigt bei den Vorhersagen zu Thema und Sprache eines Tickets die Konfidenz Hoch, Mittel oder Niedrig an und gibt an, dass Korrekturen der Mitarbeitenden das Modell nicht trainieren (Zendesk).
Was ein Intent tatsächlich ist
Ein Intent ist das Ziel hinter einer Nachricht, nicht ihr Wortlaut. „Mein Paket ist nie angekommen“, „Wo ist mein Zeug?“ und „Laut Tracking zugestellt, aber ich habe nichts“ sind drei verschiedene Zeichenketten und ein Intent: Bestellstatus oder Lieferproblem.
Zwei Dinge werden damit verwechselt:
- Thema oder Kategorie. „Abrechnung“ ist ein Thema. „Rückerstattung für eine doppelte Abbuchung verlangen“ ist ein Intent. Themen eignen sich gut für das Reporting auf einen Blick; Intents sind konkret genug, um darauf zu reagieren.
- Sentiment. Ob der Kunde verärgert ist, ist unabhängig davon, warum er geschrieben hat. Sie werden beides wollen, aber es sind verschiedene Felder. Ein wütender Kunde, der nach der Lieferung fragt, hat trotzdem einen Liefer-Intent.
Viele Plattformen erkennen mehrere Signale gleichzeitig. Die Intelligent Triage von Zendesk klassifiziert Tickets zum Beispiel nach Thema, Sentiment, Sprache und Entitäten, und ihre Dokumentation vermerkt, dass die Nutzung dieser Felder in Workflows das Copilot-Add-on voraussetzt (Zendesk). Das Hilfecenter von Zendesk sagt inzwischen „Thema“, wo ältere Setups „Intent“ sagen.
So funktioniert die Intent-Erkennung
Es gibt zwei grundsätzliche Ansätze, und die meisten realen Systeme nutzen eine Mischung.
Trainierte Klassifikatoren
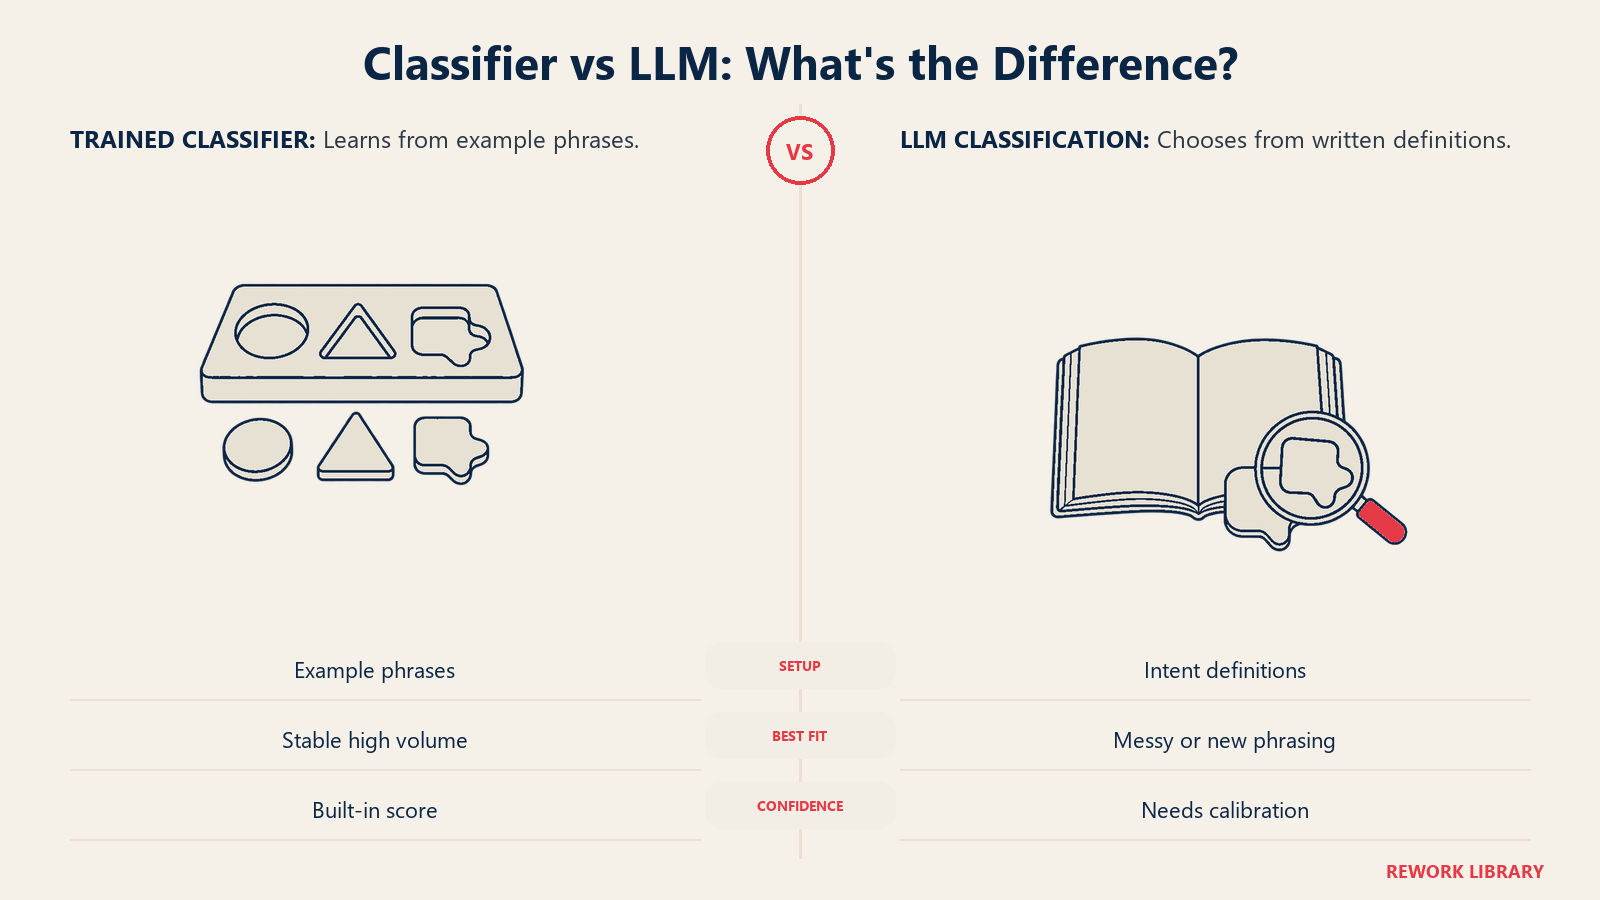
Sie definieren die Intents, geben jedem Beispielphrasen, und die Plattform trainiert ein Modell, das neue Nachrichten mit ihnen abgleicht. Dialogflow CX und Amazon Lex arbeiten beide so. Das Modell bewertet jeden Intent und wählt den höchsten.
Stärken: Es ist schnell, günstig pro Nachricht, vorhersehbar und liefert einen Wert, den Sie mit einem Schwellenwert versehen können. Schwächen: Es kennt nur die Intents, die Sie ihm beigebracht haben. Eine Nachricht zu etwas Neuem wird in das nächstliegende Label gepresst oder findet gar keine Übereinstimmung. Googles Empfehlung lautet, mit mindestens 10 bis 20 Trainingsphrasen pro Intent zu beginnen, und es warnt, dass das Befüllen des standardmäßigen negativen Intents mit riesigen Phrasenmengen (als Beispiel nennt es 10.000) die normale Zuordnung beeinträchtigen würde (Google Cloud).
LLM-basierte Klassifikation
Hier geben Sie einem großen Sprachmodell die Liste der Intents mit kurzen Definitionen und bitten es, einen auszuwählen (oder „keinen“). Es gibt keinen Trainingsdatensatz aufzubauen, ein neuer Intent kann also live gehen, sobald Sie seine Definition geschrieben haben. Die klassischen NLU-Plattformen bewegen sich in dieselbe Richtung und ergänzen ihre trainierten Intent-Modelle um LLM-Schichten.
Stärken: Es bewältigt unordentliche, mehrsätzige Nachrichten, gemischte Sprachen und ganz neue Formulierungen. Schwächen: Es kostet pro Nachricht mehr, ist langsamer, kann driften, wenn sich Prompts oder Modelle ändern, und kann ein Label erfinden, sofern Sie es nicht auf Ihre Liste beschränken. Kalibrieren Sie die von ihm angegebene Konfidenz an einer von Hand gelabelten Stichprobe, statt ihr zu vertrauen.
| Trainierter Klassifikator | LLM-basiert | |
|---|---|---|
| Einrichtungsaufwand | Beispielphrasen pro Intent | Geschriebene Definitionen pro Intent |
| Umgang mit neuen Formulierungen | Nur bei Ähnlichkeit zu den Trainingsphrasen | Meist gut |
| Durchlaufzeit für einen neuen Intent | Beispiele sammeln, neu trainieren | Die Definition bearbeiten |
| Konfidenzwert | Eingebaut | Braucht Kalibrierung |
| Konsistenz über die Zeit | Hoch bis zum nächsten Training | Kann sich mit Modell- oder Prompt-Änderungen verschieben |
| Am besten für | Stabile Intents mit hohem Volumen | Long Tail (seltene Anliegen), unordentliche oder mehrsprachige Eingaben |
Eine verbreitete Aufteilung: Ein Klassifikator bearbeitet die 15 bis 20 wichtigsten Intents, die den Großteil des Volumens ausmachen, und ein LLM fängt auf, was der Klassifikator ablehnt. Wenn Ihre Kontakte in mehreren Sprachen eintreffen, lesen Sie vor der Wahl die Hinweise zum mehrsprachigen Support, denn die Trainingsdaten je Sprache summieren sich schnell.
Konfidenz-Schwellenwerte und Fallback
Jeder Ansatz braucht eine Regel für „Ich bin nicht sicher“. Sie besteht aus drei Teilen.
Ein Schwellenwert. Dialogflow und Lex erlauben beide, einen Mindestwert festzulegen. In Dialogflow CX wird der beste Intent nur zurückgegeben, wenn er den in den Agent-Einstellungen festgelegten Klassifikationsschwellenwert erreicht; andernfalls wird ein No-Match-Ereignis ausgelöst (Google Cloud). In Lex V2 ist der Schwellenwert eine Zahl zwischen 0,00 und 1,00, je Sprache festgelegt, und jeder Wert darunter erzeugt den Fallback-Intent (AWS). Lex warnt außerdem, dass seine Werte vergleichende und keine absoluten Größen sind und sich mit der Verbesserung des Dienstes ändern können. Übernehmen Sie also nicht das 0,7 eines anderen; testen Sie Ihr eigenes.
Ein Abstand. Die Lücke zwischen den beiden besten Werten zählt so viel wie der beste Wert. Die Dokumentation von Lex nennt als Beispiel 0,75 gegenüber 0,72 als echte Mehrdeutigkeit. Ein gutes Muster: Liegt der beste Wert unter Ihrem Schwellenwert oder liegen die beiden besten innerhalb eines kleinen Abstands, raten Sie nicht. Stellen Sie eine Rückfrage („Geht es um eine Rückerstattung oder eine Kündigung?“) oder routen Sie an eine Person.
Ein Fallback-Pfad. Legen Sie vorab fest, was bei einem Fehlschlag geschieht. Die Optionen, vom geringsten bis zum größten Aufwand für den Kunden:
- Die Nachricht mit den beiden besten Vermutungen an eine allgemeine Queue schicken, damit die Mitarbeitenden mit einem Hinweis beginnen.
- Eine Rückfrage mit zwei oder drei Schaltflächen stellen.
- Mit der bisherigen Konversation an einen Menschen übergeben.
Die Forschung belegt, warum das wichtig ist. Der Datensatz CLINC150 wurde gerade deshalb mit Anfragen außerhalb des Geltungsbereichs gebaut, weil Klassifikatoren, die bei bekannten Intents gut aussehen, Mühe haben, wenn jemand etwas außerhalb der Liste fragt (Larson et al., arXiv). Ihr realer Traffic besteht größtenteils aus diesem Fall, der nur darauf wartet einzutreten.
Legen Sie Schwellenwerte je Verwendung fest. Eine Routing-Entscheidung (welche Queue) verträgt einen niedrigeren Schwellenwert, weil eine falsche Vermutung eine Neuzuweisung kostet. Eine automatisierte Aktion, etwa ein Konto kündigen oder eine Rückerstattung auslösen, braucht einen deutlich höheren oder einen Bestätigungsschritt. Zur schwierigeren Frage, welche Aufgaben Sie überhaupt an die AI übergeben, siehe Automatisieren oder unterstützen.
Eine Intent-Taxonomie aufbauen
Die Taxonomie ist die Liste der Intents, und sie zählt mehr als das Modell. Ein großartiges Modell auf einer unklaren Liste liefert präzise Labels, die niemand nutzen kann.
Beginnen Sie bei den Daten, nicht beim Organigramm
Ziehen Sie einige hundert aktuelle Tickets oder Chats und lesen Sie sie. Gruppieren Sie danach, was der Kunde wollte, nicht danach, welches Team es derzeit bearbeitet. Wenn die Daten dünn oder uneinheitlich sind, beheben Sie das zuerst: Support-Daten für AI vorbereiten behandelt die Bereinigung.
Wählen Sie die richtige Granularität
Zu grob, und das Label kann keine Aktion auslösen („Abrechnung“ umfasst Rechnungen, Rückerstattungen, fehlgeschlagene Zahlungen und Steuerfragen, die unterschiedliche Personen brauchen). Zu fein, und das Modell kann die Labels nicht auseinanderhalten, die Mitarbeitenden können sie sich nicht merken, und Berichte zerfallen in 200 Zeilen mit je 3 Tickets.
Ein brauchbarer Test: Ändert dieser Intent, was wir als Nächstes tun? Wenn zwei Kandidaten-Intents dieselbe Antwort bekommen, an dasselbe Team gehen und als eine Zahl berichtet werden, führen Sie sie zusammen. Wenn sie unterschiedlich behandelt würden, halten Sie sie getrennt.
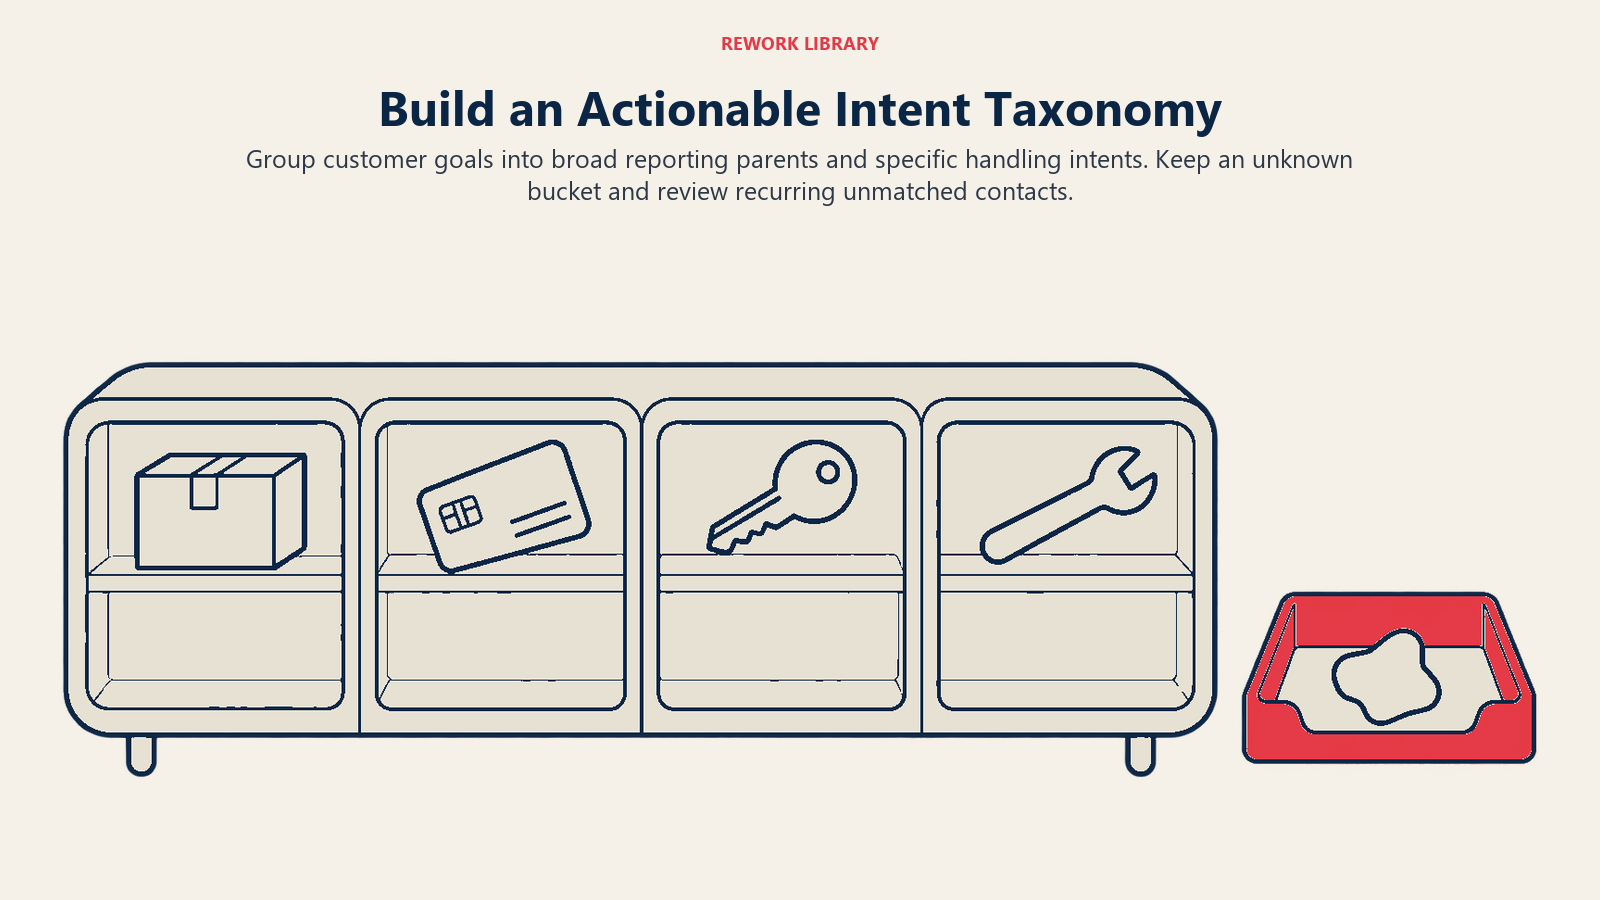
Eine zweistufige Struktur funktioniert meist: eine Handvoll übergeordneter Kategorien für das Executive-Reporting und etwa 20 bis 60 untergeordnete Intents für Routing und Automatisierung. Dieser Bereich ist eine Faustregel, kein Standard; lassen Sie Ihr Volumen entscheiden. Auf einen Long Tail von Intents, die zweimal im Monat auftreten, können Sie nicht reagieren.
Benennen Sie Intents als Kundenziele
Verwenden Sie ein einheitliches Muster mit dem Verb zuerst: request_refund, change_billing_address, report_login_problem. Vermeiden Sie Namen, die Ihren internen Prozess beschreiben („tier2_escalation“) oder vage sind („other_issue“). Schreiben Sie für jeden eine einzeilige Definition und zwei oder drei Beispielnachrichten, einschließlich der Grenzfälle („Wenn der Kunde eine doppelte Abbuchung erwähnt, verwenden Sie report_billing_error, nicht request_refund“).
Nehmen Sie immer einen Sammelbehälter „other“ auf und beobachten Sie ihn
Ein Intent „other“ oder „unknown“ ist kein Versagen; er ist Ihr Sensor für Veränderung. Neue Produktfunktionen, eine Preisänderung oder ein Ausfall zeigen sich dort zuerst. Zwei Regeln halten ihn nützlich:
- Begrenzen Sie ihn. Wenn „other“ etwa 10 Prozent des Volumens übersteigt, ist Ihre Taxonomie veraltet. Diese Zahl ist ein Arbeitsziel, kein Branchen-Benchmark.
- Ziehen Sie Stichproben. Lesen Sie jeden Monat 50 bis 100 „other“-Kontakte und heben Sie jedes Muster, das wiederholt auftaucht, in einen echten Intent.
Dialogflow hat eine eingebaute Version dieser Schleife: Seine Intent-Vorschläge analysieren No-Match-Fälle und empfehlen neue Intents oder Trainingsphrasen, wobei die Funktion auf bestimmte Regionen beschränkt ist und in den Agent-Einstellungen aktiviert werden muss (Google Cloud).
Legen Sie einen Überprüfungsrhythmus fest
Überprüfen Sie die Taxonomie anfangs monatlich, dann vierteljährlich, sobald sie sich eingependelt hat, und immer nach einem Produktstart oder einer Preisänderung. Streichen Sie ruhige Intents, teilen Sie breite auf und führen Sie ein Änderungsprotokoll, damit ein Rückgang bei „Rückerstattungsanfragen“ nicht bloß ein umbenanntes Label ist.
| Übergeordnete Kategorie | Beispiele für untergeordnete Intents | Typische Bearbeitung |
|---|---|---|
| Bestellungen und Lieferung | track_order, report_missing_package, change_delivery_address |
Bot-Abfrage, dann Logistik-Queue |
| Abrechnung | request_refund, report_billing_error, update_payment_method |
Abrechnungs-Queue, Rückerstattungen brauchen Freigabe |
| Kontozugriff | reset_password, report_login_problem, delete_account |
Bot für Rücksetzungen, Sicherheitsteam für Löschungen |
| Produkthilfe | how_to_use_feature, report_bug, request_feature |
Hilfecenter, Support oder Produkt-Feedback |
| Kündigung und Kundenbindung | cancel_subscription, downgrade_plan |
Spezialist für Kundenbindung, nie nur Bot |
| Sonstiges | unknown, out_of_scope |
Allgemeine Queue, monatlich geprüft |
Intents für Routing und Reporting nutzen
Routing
Ein Intent wird nützlich, wenn er eine Regel steuert. Die gängigen:
- Skill-basiertes Routing. Abrechnungs-Intents gehen an das Abrechnungsteam, technische Intents an das technische Team, mit der Sprache als zweitem Filter.
- Bot oder Mensch. Risikoarme, klar definierte Intents wie die Sendungsverfolgung gehen an die Automatisierung. Sensible, etwa Kündigung, rechtliche Drohungen oder Sicherheit, gehen immer an eine Person.
- Priorität. Kombinieren Sie den Intent mit Sentiment und Kundenstufe. Eine Anfrage „Abonnement kündigen“ von einem wertvollen Account mit negativem Sentiment rückt in der Queue nach vorn.
- Vorausgefüllte Hilfe für Mitarbeitende. Zeigen Sie den erkannten Intent und einen vorgeschlagenen Artikel oder ein Makro (gespeicherte Antwort) in der Ansicht der Mitarbeitenden. Das passt natürlich zu AI Agent Assist (Assistenz für Mitarbeitende).
Halten Sie bei Korrekturen Menschen in der Schleife. Zendesk lässt Mitarbeitende das vorhergesagte Thema im Eigenschaftenbereich des Tickets ändern, vermerkt aber, dass dies das Modell nicht trainiert (Zendesk). Das heißt, Korrekturen müssen irgendwo erfasst werden, wo Sie sie nutzen können, etwa in einem Feld, das Sie für das Neu-Labeln exportieren, sonst wiederholen sich dieselben Fehler.
Reporting
Sobald jeder Kontakt einen Intent hat, können Sie Fragen beantworten, für die früher ein manuelles Audit nötig war:
- Was sind die zehn häufigsten Gründe, aus denen Kunden uns kontaktieren, und wie entwickeln sie sich?
- Welche Intents haben die niedrigste Lösungsquote und die meisten wiederholten Kontakte? Kombinieren Sie den Intent mit den Messgrößen aus AI-Lösungsquote, um zu sehen, wo die Automatisierung tatsächlich funktioniert.
- Welche Intents könnte ein besseres Hilfecenter beantworten? Siehe AI-Suche im Hilfecenter.
Intent-Zählungen sind außerdem der natürliche Input für die AI-Volumenprognose im Support: Eine Prognose nach Kontaktgrund ist nützlicher als eine einzige Gesamtlinie, denn „Passwort-Rücksetzung“ und „Abrechnungsstreit“ reagieren auf unterschiedliche Treiber und brauchen unterschiedliche Personalplanung.
Praxisbeispiele nach Funktion
Kundensupport. Ein Softwareunternehmen taggt jedes eingehende Ticket. „Wie exportiere ich einen Bericht?“ geht an eine Antwort aus dem Hilfecenter; „Der Export ist kaputt“ geht mit einer Bug-Markierung an den technischen Support. Gleiche Worte, verschiedene Intents, andere Queue.
Finanzen und Abrechnung. Ein Abonnementgeschäft trennt report_billing_error von request_refund. Der erste geht an eine Queue, die untersuchen kann; der zweite braucht Freigaberegeln.
IT-Helpdesk. Ein interner Service Desk erkennt request_access, report_outage und reset_password. Passwort-Rücksetzungen gehen in den Self-Service, Ausfälle alarmieren den Engineer in Rufbereitschaft, und Zugriffsanfragen lösen einen Freigabe-Workflow aus.
Vertriebs-Postfach. Ein gemeinsames Postfach sortiert request_pricing, request_demo und support_question_from_customer. Den dritten aus der Vertriebs-Queue zu nehmen, schützt die Antwortzeit für echte Leads.
Umsetzung Schritt für Schritt
- Sammeln und lesen Sie eine Stichprobe. 300 bis 500 aktuelle Kontakte aus allen Kanälen. Halten Sie die tatsächlichen Gründe fest, in den Worten des Kunden.
- Entwerfen Sie die Taxonomie. Zuerst die übergeordneten, dann die untergeordneten Intents, mit Verb-zuerst-Namen. Ergänzen Sie Definitionen, Beispiele und einen Sammelbehälter „other“.
- Labeln Sie einen Testdatensatz von Hand. Lassen Sie zwei Personen 200 bis 300 Nachrichten unabhängig voneinander labeln. Wo sie sich uneinig sind, sind die Definitionen unklar; beheben Sie das, bevor Sie ein Modell anfassen.
- Wählen Sie die Methode. Trainierter Klassifikator für stabile Intents mit hohem Volumen; LLM für den Long Tail oder mehrsprachige Eingaben; ein Hybrid, wenn Sie beides brauchen.
- Legen Sie Schwellenwerte und Fallbacks fest. Beginnen Sie bei automatisierten Aktionen konservativ, beim Routing lockerer. Definieren Sie den Fallback-Pfad vor dem Start.
- Laufen Sie im Shadow-Modus. Sagen Sie Intents voraus und zeigen Sie sie den Mitarbeitenden an, routen Sie aber noch nicht danach. Vergleichen Sie die Vorhersagen damit, was die Mitarbeitenden tatsächlich getan haben.
- Schalten Sie das Routing für die Intents ein, die gut abschneiden. Die Genauigkeit variiert je Intent; schalten Sie zuerst die starken ein.
- Schließen Sie die Schleife. Erfassen Sie Korrekturen der Mitarbeitenden, ziehen Sie monatlich Stichproben aus „other“ und trainieren Sie neu oder passen Sie die Prompts nach Plan an.
Häufige Fallstricke
Die Taxonomie um Teams herum bauen. Wenn die Intents Ihr Organigramm spiegeln, zerstört eine Reorganisation Ihr Reporting. Stützen Sie sie auf Kundenziele.
Einer einzigen Genauigkeitszahl hinterherjagen. Die Gesamtgenauigkeit verbirgt, dass „track order“ zu 98 Prozent richtig ist und „cancel subscription“ zu 60 Prozent. Messen Sie je Intent und gewichten Sie nach Volumen und nach den Kosten eines Fehlers.
Keine Behandlung für Anfragen außerhalb des Geltungsbereichs. Wie die Autoren von CLINC150 feststellten, haben Klassifikatoren Mühe mit Anfragen außerhalb ihrer bekannten Intents (Larson et al., arXiv). Ohne expliziten Fallback werden Nachrichten, die nicht auf der Liste stehen, in das falsche Label gepresst.
Nur die erste Nachricht labeln. Kunden beginnen oft vage und präzisieren später. Behalten Sie sowohl den ersten als auch den letzten Intent.
Den Intent als einziges Signal nutzen. Kombinieren Sie ihn mit Sentiment, Kundenstufe und Kanal. Derselbe Intent verdient bei einem Testnutzer und einem Enterprise-Account eine unterschiedliche Behandlung.
Häufig gestellte Fragen zur Intent-Erkennung im Kundenservice
Was ist Intent-Erkennung im Kundenservice?
Es ist die automatische Zuordnung einer Kundennachricht zu dem Grund, aus dem der Kunde Sie kontaktiert, etwa eine Rückerstattungsanfrage oder ein Lieferproblem. Das Ergebnis ist ein Label, oft mit einem Konfidenzwert, das Routing, Automatisierung und Reporting steuert.
Was ist der Unterschied zwischen Intent und Thema?
Ein Thema ist eine breite Kategorie wie „Abrechnung“. Ein Intent ist das konkrete Ziel, etwa „Rückerstattung für eine doppelte Abbuchung verlangen“. Themen eignen sich für Executive-Dashboards; Intents sind konkret genug, um zu entscheiden, wer den Kontakt bearbeitet und was als Nächstes geschieht. Manche Anbieter verwenden die beiden Wörter austauschbar, prüfen Sie daher, wie Ihre Plattform sie definiert.
Welchen Konfidenz-Schwellenwert sollte ich verwenden?
Eine allgemeingültige Zahl gibt es nicht. Plattformen wie Dialogflow CX und Amazon Lex lassen Sie einen eigenen festlegen, und Lex vermerkt, dass seine Werte vergleichend und nicht absolut sind. Testen Sie an einer von Hand gelabelten Stichprobe und legen Sie für automatisierte Aktionen einen strengeren Schwellenwert fest als für das Routing.
Wie viele Intents sollte ich haben?
So viele, dass jeder verändert, was Sie als Nächstes tun, und so wenige, dass das Modell sie unterscheiden und die Mitarbeitenden sie sich merken können. Viele Teams landen bei einigen übergeordneten Kategorien und einigen Dutzend untergeordneten Intents, aber Ihr Volumen und die Komplexität Ihres Produkts entscheiden.
Sollte ich einen Klassifikator oder ein LLM nutzen?
Klassifikatoren sind günstiger, schneller und liefern einen eingebauten Wert, was zu stabilen Intents mit hohem Volumen passt. LLMs bewältigen unordentliche oder mehrsprachige Eingaben und neue Intents ohne erneutes Training. Viele Teams kombinieren sie: einen Klassifikator für die wichtigsten Intents und ein LLM für das, was er nicht zuordnen kann.
Was sollte ich mit dem Sammelbehälter „other“ tun?
Behandeln Sie ihn als Sensor. Lesen Sie jeden Monat eine Stichprobe, heben Sie wiederkehrende Muster in neue Intents und werten Sie es als Zeichen für eine veraltete Taxonomie, wenn „other“ weiter wächst. Ein Arbeitsziel ist, ihn unter etwa 10 Prozent des Volumens zu halten.

Customer Success Operations Manager
On this page
- Wichtige Fakten
- Was ein Intent tatsächlich ist
- So funktioniert die Intent-Erkennung
- Trainierte Klassifikatoren
- LLM-basierte Klassifikation
- Konfidenz-Schwellenwerte und Fallback
- Eine Intent-Taxonomie aufbauen
- Beginnen Sie bei den Daten, nicht beim Organigramm
- Wählen Sie die richtige Granularität
- Benennen Sie Intents als Kundenziele
- Nehmen Sie immer einen Sammelbehälter „other“ auf und beobachten Sie ihn
- Legen Sie einen Überprüfungsrhythmus fest
- Intents für Routing und Reporting nutzen
- Routing
- Reporting
- Praxisbeispiele nach Funktion
- Umsetzung Schritt für Schritt
- Häufige Fallstricke