Datenschutz bei Kundendaten im AI-Support: PII, Schwärzung und Aufbewahrung
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Datenschutz bei Kundendaten im AI-Support ist die Gesamtheit der Kontrollen, die entscheidet, welche personenbezogenen Daten ein AI-System sieht, wie lange sie jemand aufbewahrt, wohin sie gelangen und wer sie lesen darf. In der Praxis bedeutet das sechs Dinge: personenbezogene Daten schwärzen, bevor sie ein Modell oder ein Log erreichen, eine Aufbewahrungsfrist festlegen und durchsetzen, Zahlungskartendaten ganz aus Chats heraushalten, die Datenbedingungen des Anbieters lesen, den Speicherort wählen und begrenzen, wer Transkripte öffnen darf.
Im Support geht beim Datenschutz leise etwas schief. Kunden fügen Kontonummern und medizinische Details in ein Chatfenster ein, weil Sie gefragt haben, wie Sie helfen können, und mit einer AI-Schicht kann jede Nachricht in einem Prompt, einem Log des Anbieters, einem QA-Datensatz und einem Zusammenfassungsfeld landen. Dieser Leitfaden richtet sich an Support-Verantwortliche, die „Wohin gehen die Daten?“ beantworten müssen, ohne Jura studiert zu haben. Er ist keine Rechtsberatung, lassen Sie also von einer Datenschutzberatung bestätigen, was in Ihren Regionen gilt. Er baut auf Support-Daten für AI vorbereiten auf, das die Bereinigung der Daten behandelt. Hier liegt der Schwerpunkt auf ihrem Schutz.
Wichtige Fakten
- Artikel 5 Absatz 1 Buchstabe c der GDPR verlangt, dass personenbezogene Daten „dem Zweck angemessen und erheblich sowie auf das für die Zwecke der Verarbeitung notwendige Maß beschränkt“ sind, und Buchstabe e besagt, dass sie nur so lange in identifizierbarer Form gespeichert werden dürfen, wie es „für die Zwecke, für die sie verarbeitet werden, erforderlich ist“ (GDPR, EUR-Lex).
- PCI DSS erlaubt nicht, Kartenprüfnummern nach der Autorisierung einer Transaktion zu speichern, auch nicht verschlüsselt und auch nicht, wenn der Kunde zustimmt (PCI SSC FAQ 1280).
- Nach Artikel 28 Absatz 3 der GDPR darf ein Auftragsverarbeiter nur auf dokumentierte Weisung des Verantwortlichen handeln und muss nach Wahl des Verantwortlichen die personenbezogenen Daten löschen oder zurückgeben, wenn die Leistung endet (GDPR, EUR-Lex).
- OpenAI gibt an, dass an seine API gesendete Daten nicht zum Training seiner Modelle verwendet werden, sofern der Kunde nicht zustimmt, und dass Logs zur Missbrauchsüberwachung standardmäßig bis zu 30 Tage aufbewahrt werden (OpenAI).
- Die Open-Source-Bibliothek Presidio von Microsoft warnt, dass die automatische Erkennung keine Garantie bietet, alle sensiblen Informationen zu finden (Presidio).
- Die FTC erklärt, es könne unlauter oder irreführend sein, Bedingungen stillschweigend umzuschreiben, um AI-Training mit Daten zu erlauben, die unter früheren Zusagen erhoben wurden (FTC).
Wo Kundendaten in einem AI-Support-Stack landen
Bevor Sie Kontrollen wählen, erfassen Sie die Orte, an denen Daten tatsächlich liegen. Ein typisches AI-Support-Setup hat mehr Kopien, als man erwartet.
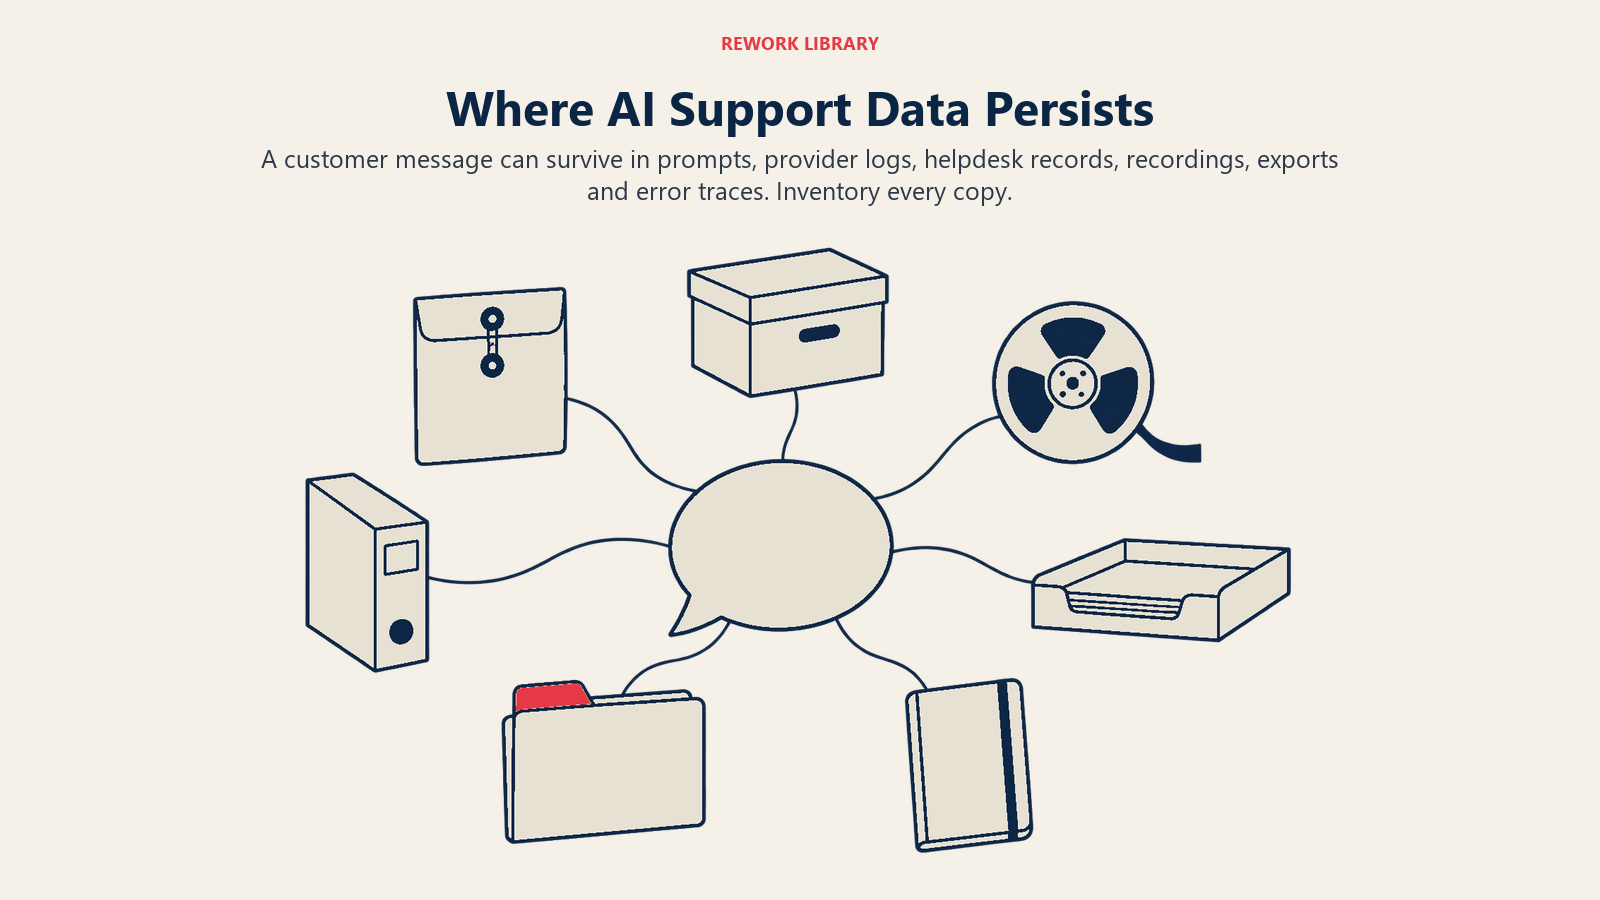
| Ort | Was dort liegt | Wer ihn meist vergisst |
|---|---|---|
| Laufende Konversation | Alles, was der Kunde eintippt, auch Dinge, nach denen Sie nie gefragt haben | Niemand, es ist der offensichtliche Ort |
| An das Modell gesendeter Prompt | Die Kundennachricht plus alle Kontofelder, die Sie als Kontext ergänzen | Teams, die den gesamten Kundendatensatz weitergeben |
| Logs des Modellanbieters | Prompts und Ausgaben, aufbewahrt zur Überwachung oder Fehlersuche | Jeder, der die Aufbewahrungsbedingungen des Anbieters nicht gelesen hat |
| Helpdesk-Transkript und Ticket | Volltext, Anhänge, von der AI geschriebene Zusammenfassungen | Admins, die die Aufbewahrungsfrist einmal festgelegt und nie wieder angesehen haben |
| Anrufaufzeichnungen und Sprachtranskripte | Gesprochene Kartennummern, Namen, Adressen | Teams, die nach dem Chat-Rollout Voice-AI ergänzt haben |
| Analytics, QA- und Trainingsdatensätze | Exportierte Stichproben für die Qualitätsprüfung oder das Tuning | Wer auch immer die Tabelle gebaut hat |
| Anwendungslogs und Fehlerprotokolle | Rohdaten, wenn etwas fehlschlägt | Meist die Engineers |
Wenn eine Datenschutzanfrage oder ein Audit auf Ihrem Tisch landet, müssen Sie für Ihr eigenes Setup jede Zeile benennen können.
Beispiele nach Kanal
Das Risiko sieht in jedem Kanal anders aus, weshalb AI über Support-Kanäle hinweg einen eigenen Datenschutzdurchgang verdient.
Chat. Wer nach einer fehlgeschlagenen Zahlung fragt, fügt oft die vollständige Kartennummer ein. Maskieren Sie Ziffernfolgen, die wie Kartennummern aussehen, bevor die Nachricht gespeichert oder an ein Modell gesendet wird.
E-Mail. Threads enthalten Signaturen, weitergeleiteten Verlauf und Anhänge wie gescannte Ausweise. Entfernen Sie zitierten Verlauf und Anhangstext, sofern die Aufgabe ihn nicht braucht.
Sprache. Gesprochene Daten lassen sich am schwersten bereinigen. PCI SSC geht darauf direkt ein: Kartenprüfnummern, die nach der Autorisierung in digitalen Audioaufzeichnungen erfasst werden, verstoßen gegen die Speicherregel, es sollte alles getan werden, um die Aufzeichnung der Daten zu verhindern, und wo sich die Aufzeichnung nicht verhindern lässt, sollten die Daten unmittelbar nach der Autorisierung sicher gelöscht werden (PCI SSC FAQ 1210).
Interner Agent Assist. Auch ein Tool, das nur Ihren eigenen Mitarbeitenden Antworten vorschlägt, sieht die gesamte Konversation. Agent Assist (Assistenz für Mitarbeitende) braucht dieselben Regeln zu Schwärzung und Aufbewahrung wie ein kundenorientierter Bot.
Die sechs Kontrollen
| Kontrolle | Was sie schützt | So setzen Sie sie um | Standard oder Gesetz |
|---|---|---|---|
| PII-Schwärzung | Namen, E-Mail-Adressen, Ausweisnummern, Kartennummern in Prompts, Transkripten und Logs | Vor dem Senden an das Modell und vor dem Schreiben von Logs erkennen und maskieren; eine Stichprobe auf Lücken prüfen | GDPR Art. 5 Abs. 1 Buchst. c, Datenminimierung; PCI DSS für Kartendaten |
| Aufbewahrung und Löschung | Alte Konversationen, die keinen Zweck mehr haben | Ein schriftlicher Zeitplan je Datentyp; automatisierte Löschung in Helpdesk, Logs und Exporten | GDPR Art. 5 Abs. 1 Buchst. e, Art. 17 |
| Umgang mit Zahlungskarten | Kartennummern und Prüfnummern | Nie im Chat nach Kartendaten fragen; an eine Zahlungsseite oder einen tokenisierten Ablauf übergeben; maskieren, falls eingetippt | PCI DSS; PCI SSC FAQs 1280, 1210, 1533 |
| Anbieterbedingungen und DPA | Daten in den Händen von Anbietern | Bestätigen: kein Training mit Ihren Daten, Aufbewahrungsfenster, Löschung bei Vertragsende, Unterauftragsverarbeiter | GDPR Art. 28 Abs. 3 |
| Datenresidenz | Wo Daten gespeichert und verarbeitet werden | Region in der Konfiguration des Anbieters wählen; Zugriffswege des Supports prüfen | GDPR Kapitel V (ab Art. 44) |
| Zugriffskontrolle | Wer Transkripte lesen darf | Rollenbasierter Zugriff, minimale Rechte, protokollierter Zugriff, schnelles Entfernen bei Ausscheidenden | GDPR Art. 32 (Sicherheit der Verarbeitung) |
Die folgenden Abschnitte behandeln jede Kontrolle in der Reihenfolge, in der Sie sie umsetzen würden.
Schwärzung: PII in Transkripten, Prompts und Logs
Artikel 5 Absatz 1 Buchstabe c der GDPR ist das Prinzip hinter der Schwärzung: Personenbezogene Daten sollen dem Zweck angemessen und erheblich sowie auf das für die Zwecke ihrer Verarbeitung notwendige Maß beschränkt sein (GDPR, EUR-Lex). Für einen AI-Assistenten wird daraus eine Gestaltungsregel. Senden Sie dem Modell das Minimum, das es für diese eine Konversation braucht. Eine Anfrage zur Passwort-Rücksetzung braucht den Kontostatus, nicht die Abrechnungshistorie. Mehr zur GDPR-Argumentation finden Sie unter Service mit AI personalisieren.
Die Schwärzung kann an drei Stellen erfolgen, und meist wollen Sie alle drei:
- Vor dem Modell. Erkennen Sie personenbezogene Daten in der eingehenden Nachricht und ersetzen Sie sie durch Platzhalter wie
[EMAIL]oder[CARD_NUMBER]. Das Modell kann dann trotzdem antworten „Ich habe das mit dieser E-Mail-Adresse verknüpfte Konto gefunden“, ohne je die echte Adresse zu halten. Wenn die endgültige Antwort den echten Wert braucht, kann Ihr System ihn nach der Antwort des Modells wieder einsetzen. - Vor der Speicherung. Wenden Sie dieselbe Maskierung an, bevor das Transkript in den Helpdesk, die Log-Pipeline oder eine Analytics-Tabelle geschrieben wird, damit der Rohwert nie an einem dauerhaften Ort landet.
- Vor der Weiterverwendung. Wenn Sie Konversationen für QA, Coaching oder Tuning exportieren, schwärzen Sie erneut. Das AI-Toolkit des ICO empfiehlt, wo möglich synthetische oder anonymisierte Informationen zum Trainieren eines Modells zu verwenden (ICO).
Ein Hinweis zu den Werkzeugen: Presidio, das Open-Source-Erkennungstoolkit von Microsoft, sagt, es gebe keine Garantie, dass es alle sensiblen Informationen findet, weil die Erkennung automatisiert ist (Presidio). Mustererkennung bewältigt Kartennummern und E-Mail-Adressen gut, Namen in Sätzen oder Krankheitsbeschreibungen dagegen schlecht. Prüfen Sie geschwärzte Transkripte wöchentlich stichprobenartig und suchen Sie nach Lücken.
Debug-Logs, Fehler-Tracker und Sitzungsaufzeichnungen von Chat-Widgets speichern ebenfalls Rohtext, prüfen Sie sie daher gesondert.
Aufbewahrung und Löschung
Artikel 5 Absatz 1 Buchstabe e der GDPR besagt, dass personenbezogene Daten nur so lange in identifizierbarer Form gespeichert werden dürfen, wie es für die Zwecke, für die sie verarbeitet wurden, erforderlich ist (GDPR, EUR-Lex). Die Erwägungsgründe ergänzen, dass Verantwortliche Fristen für die Löschung oder regelmäßige Überprüfung vorsehen sollten. Kunden haben außerdem, in der Formulierung von Artikel 17 Absatz 1, „das Recht, von dem Verantwortlichen zu verlangen, dass sie betreffende personenbezogene Daten unverzüglich gelöscht werden“, unter den Umständen, die der Artikel aufführt.
Für den Start brauchen Sie keine perfekte juristische Analyse. Sie brauchen einen Zeitplan, für den jemand verantwortlich ist:
- Legen Sie den Zweck jedes Datentyps fest. Transkripte, Aufzeichnungen, AI-Zusammenfassungen, QA-Stichproben und Anbieter-Logs existieren jeweils aus einem Grund. Schreiben Sie ihn neben die Aufbewahrungsfrist.
- Wählen Sie Fristen, die zum Grund passen. Gewährleistungs- und Abrechnungsstreitigkeiten können es rechtfertigen, ein Ticket lange aufzubewahren. Ein Chat, in dem jemand nach Öffnungszeiten gefragt hat, tut das nicht. Ihre Rechts- und Finanzteams setzen meist die äußeren Grenzen, da Aufbewahrungspflichten variieren.
- Löschen Sie auch die Nebenprodukte der AI. Zusammenfassungen, Sentiment-Werte, extrahierte Entitäten und Embeddings, die aus einer Konversation entstanden sind, sind abgeleitete Daten über dieselbe Person. Eine Löschung, die das Ticket entfernt, aber die AI-Zusammenfassung stehen lässt, hat nicht viel gelöscht.
- Automatisieren Sie es. Ein Zeitplan, der davon abhängt, dass sich jemand erinnert, wird scheitern. Nutzen Sie die Aufbewahrungseinstellungen im Helpdesk und die Lifecycle-Regeln für den Speicher in Ihrem Cloud-Konto.
- Halten Sie Ausnahmen schriftlich fest. Das AI-Toolkit des ICO verlangt einen dokumentierten Aufbewahrungsplan, die Löschung personenbezogener Informationen in AI-Systemen entsprechend diesem Plan und eine DPIA-Begründung für jede darüber hinausgehende Aufbewahrung (ICO).
Backups sind die übliche Falle. Legen Sie in Ihrer Richtlinie fest, wie lange gelöschte Daten dort überleben, und fragen Sie Anbieter dasselbe.
Zahlungskartendaten: aus Chat und AI-Logs heraushalten
Kartendaten sind der eine Bereich mit einer harten Branchenregel, und Support-Teams verletzen sie häufiger versehentlich als alle anderen. Die entscheidende Unterscheidung in PCI DSS verläuft zwischen der Kartennummer (PAN) und sensiblen Authentifizierungsdaten, etwa dem auf der Karte aufgedruckten Sicherheitscode.
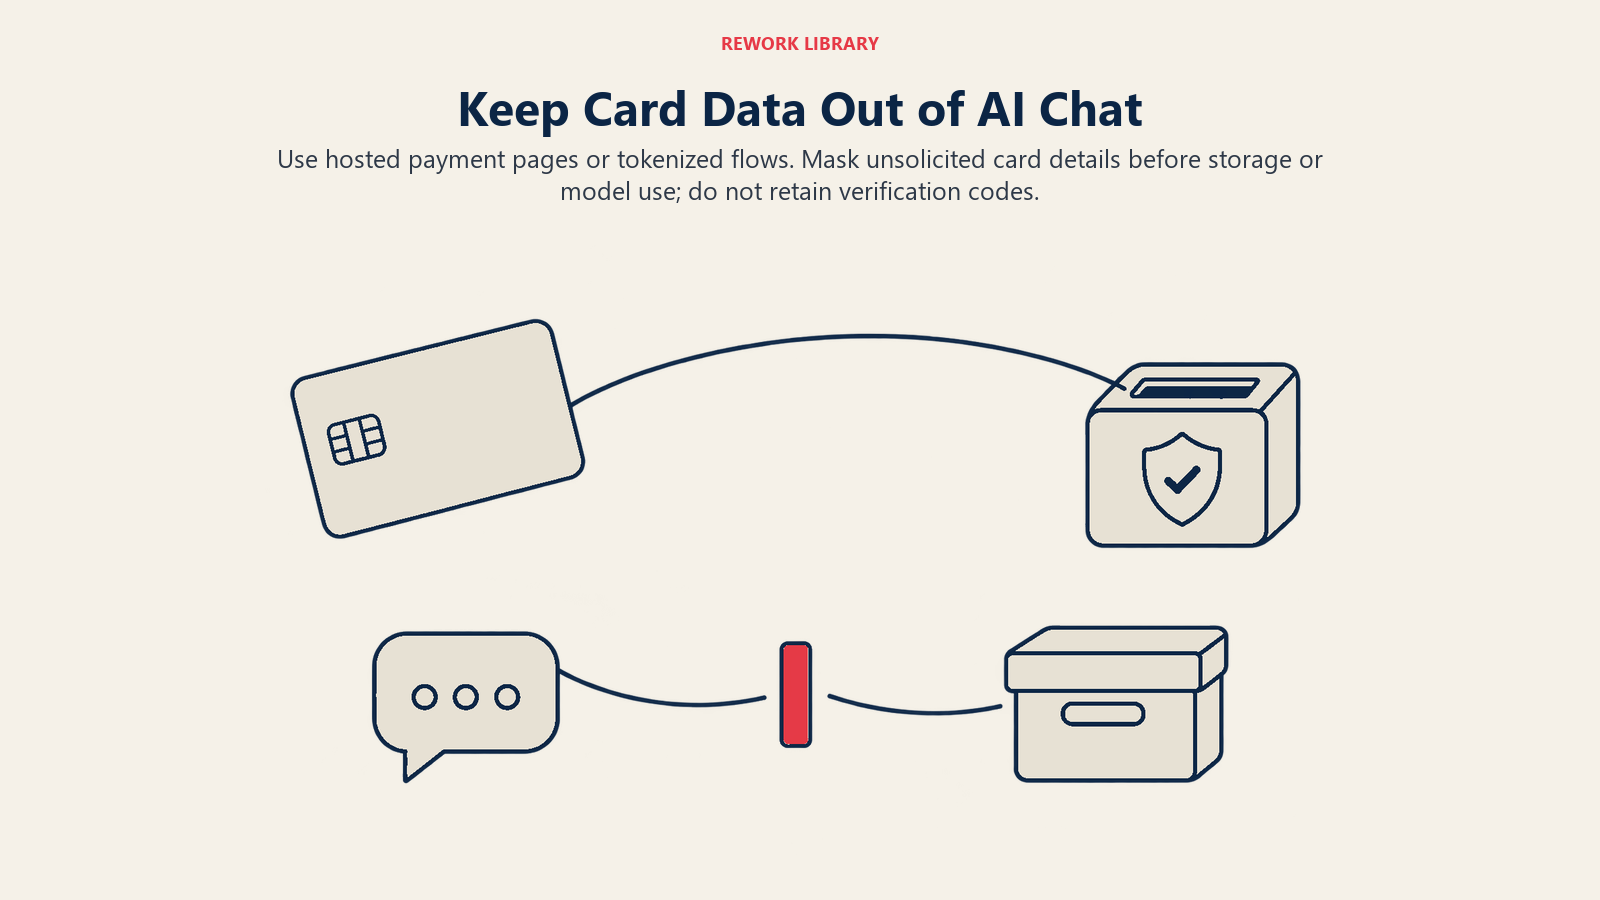
Zum Sicherheitscode ist die FAQ von PCI SSC deutlich: Es ist nicht erlaubt, Kartenprüfnummern nach der Autorisierung der Transaktion aufzubewahren, sie vor der Autorisierung zu erheben ist erlaubt, und die Zustimmung eines Kunden stellt keine Erlaubnis dar, sie zu speichern (PCI SSC FAQ 1280). Eine weitere FAQ ergänzt, dass sensible Authentifizierungsdaten nach der Autorisierung auch verschlüsselt nicht gespeichert werden dürfen und dass dies auch gilt, wenn keine PAN vorhanden ist (PCI SSC FAQ 1533).
Wenn ein Kunde Kartennummer und Code in einen Chat eintippt und die Plattform das Transkript speichert, liegt dieser Code nach der Zahlung in einer Datenbank und kann zudem in Prompts, Zusammenfassungen, QA-Exporte und Anbieter-Logs fließen. Die Hinweise von PCI SSC zu Sprachaufzeichnungen legen das nächstliegende erwartete Verhalten fest: die Aufzeichnung verhindern, wo es möglich ist, und unmittelbar nach der Autorisierung löschen, wo es sich nicht verhindern lässt (PCI SSC FAQ 1210).
Der praktische Ansatz ist die Verkleinerung des Geltungsbereichs, das heißt, die Dinge so einzurichten, dass Kartendaten Ihre Support-Systeme nie berühren:
- Fragen Sie in Chat, E-Mail oder bei einer AI nicht nach Kartendaten. Schicken Sie Kunden auf eine gehostete Zahlungsseite oder einen sicheren Link, den Ihr Zahlungsanbieter betreibt.
- Maskieren Sie alles, was wie eine Kartennummer aussieht, beim Eingang. Tun Sie das vor der Speicherung und vor dem Modell, und sagen Sie dem Kunden, dass Sie es getan haben.
- Verwenden Sie Tokens, wo die AI auf eine Zahlung verweisen muss. Die AI Principles von PCI SSC empfehlen, Zahlungstokens oder einmalig verwendbare PANs in Betracht zu ziehen, um Geltungsbereich und Auswirkungen eines AI-Systems zu begrenzen, und nennen als wichtigsten Schutz, die dem AI-System bereitgestellten sensiblen Daten von vornherein zu begrenzen (PCI SSC Blog).
- Halten Sie auch Zugangsdaten heraus. Dieselben Grundsätze besagen, dass API-Tokens, Benutzer-Zugangsdaten und kryptografische Schlüssel aus AI-Datensätzen herausgehalten werden sollten.
- Klären Sie den Geltungsbereich mit Ihrem Acquirer oder Assessor. Fragen Sie, wie Ihr Chat-, Sprach- und AI-Setup einzuordnen ist und welche Ihrer Systeme als Systeme gelten, die Kartendaten verarbeiten.
Anbieterbedingungen: Trainingsdaten, DPAs und Unterauftragsverarbeiter
Der AI-Anbieter ist meist ein Auftragsverarbeiter, der für Sie handelt. Artikel 28 Absatz 3 der GDPR besagt, dass die Verarbeitung durch einen Auftragsverarbeiter auf einem Vertrag beruht, nach dem der Auftragsverarbeiter „die personenbezogenen Daten nur auf dokumentierte Weisung des Verantwortlichen verarbeitet“ und nach Wahl des Verantwortlichen bei Ende der Leistung „alle personenbezogenen Daten an den Verantwortlichen zurückgibt oder löscht“ (GDPR, EUR-Lex). Dieser Vertrag ist der Auftragsverarbeitungsvertrag (DPA). Lassen Sie ihn unterschreiben, bevor Kundendaten fließen.
Zwei Punkte bringen Teams ins Straucheln.
Die Bedingungen unterscheiden sich je nach Produkt. Lesen Sie die Dokumentation jedes Anbieters für das genaue Produkt, das Sie kaufen. OpenAI zum Beispiel gibt an, dass API-Daten nur mit Ihrer Zustimmung zum Training seiner Modelle verwendet werden, dass Logs zur Missbrauchsüberwachung standardmäßig bis zu 30 Tage aufbewahrt werden und dass Zero Data Retention Inhalte aus diesen Logs ausschließt, aber eine vorherige Genehmigung braucht (OpenAI). Die in Ihren Helpdesk eingebaute AI, ein Chatbot-Anbieter und eine Sprachplattform haben jeweils eigene Bedingungen.
Die Bedingungen ändern sich. Die FTC hat gewarnt, es könne unlauter oder irreführend sein, wenn ein Unternehmen großzügigere Datenpraktiken einführt, etwa die Nutzung von Daten für AI-Training, und Kunden nur über eine heimliche, rückwirkende Änderung seiner Bedingungen informiert. Sie stellt außerdem fest, dass ein Unternehmen, das Daten unter einer Reihe von Datenschutzzusagen erhebt, diese nicht einseitig brechen darf (FTC). Das schützt Kunden, es sagt Ihnen aber auch, Anbieterbedingungen als lebendes Dokument zu behandeln. Tragen Sie den Ansprechpartner für Änderungsmitteilungen in den Kalender einer Person ein und prüfen Sie die Bedingungen bei der Verlängerung.
Checkliste mit Fragen an Anbieter
Fragen Sie jeden AI- und Support-Tool-Anbieter und lassen Sie sich die Antworten im Vertrag oder im DPA geben, nicht in einem Verkaufsgespräch:
- Werden unsere Daten genutzt, um Ihre Modelle oder die Dritter zu trainieren oder zu verbessern? Ist das standardmäßig aus oder nur per Opt-in?
- Wie lange bewahren Sie Prompts, Ausgaben und Logs auf, und können wir die Frist verkürzen oder keine Aufbewahrung festlegen?
- Was geschieht mit unseren Daten bei Vertragsende, und wie wird die Löschung bestätigt?
- Welche Unterauftragsverarbeiter berühren unsere Daten, in welchen Ländern, und wie werden wir bei Änderungen informiert?
- Können wir die Region für Speicherung und Verarbeitung wählen? Greift das Support-Personal aus anderen Regionen zu?
- Welche Protokollierung und Zugriffskontrollen gibt es auf Ihrer Seite für unsere Daten?
- Wie benachrichtigen Sie uns bei einer Datenpanne, und innerhalb welcher Frist?
- Maskiert oder schließt das Produkt Kartennummern aus, und wird die Sprachaufzeichnung anders behandelt?
Datenresidenz und grenzüberschreitende Übermittlungen
Kapitel V der GDPR, das mit Artikel 44 beginnt, regelt die Übermittlung personenbezogener Daten in Drittländer (GDPR, EUR-Lex). Für Support-Verantwortliche lautet die praktische Frage schlicht: In welchem Land werden die Daten unserer Kunden gespeichert, und welche Länder können sie lesen?
Viele AI-Anbieter bieten eine Regionseinstellung an. OpenAI dokumentiert die Datenresidenz als Option auf Projektebene, die Kundeninhalte im Ruhezustand für unterstützte Endpunkte in der gewählten Region speichert, wobei Systemdaten ausgenommen sind (OpenAI). „Im Ruhezustand“ ist enger als „verlässt die Region nie“, fragen Sie daher jeden Anbieter nach Backups, Logs und dem Zugriff des menschlichen Supports.
Zugriffskontrolle
Der häufigste Datenschutzvorfall im Support ist kein Angriff. Es ist jemand mit zu weitreichendem Zugriff, der liest, was er ohne Grund nicht hätte lesen sollen. Artikel 32 Absatz 1 Buchstabe a der GDPR nennt Pseudonymisierung und Verschlüsselung unter den zu erwägenden technischen Maßnahmen (GDPR, EUR-Lex). Ergänzen Sie die Grundlagen:
- Rollenbasierter Zugriff. Mitarbeitende sehen ihre eigenen Queues. QA-Prüfer sehen Stichproben. Nur eine kleine Gruppe sieht Rohexporte und AI-Logs.
- Minimale Rechte für die AI selbst. Die AI Principles von PCI SSC empfehlen, der AI nur den Zugriff zu geben, den sie braucht, mit eigenen widerrufbaren Zugangsdaten, und ihre Aktionen so zu protokollieren, dass sie sich auf eine verantwortliche Person zurückführen lassen (PCI SSC Blog). Ein Bot, der jeden Kundendatensatz lesen kann, weil es einfacher einzurichten war, wird früher oder später nach genau einem gefragt.
- Audit-Logs. Wissen Sie, wer wann welches Transkript geöffnet hat.
- Offboarding und Maskierung. Entziehen Sie den Zugriff am Tag des Ausscheidens und zeigen Sie standardmäßig nur die letzten Ziffern von Ausweis- oder Telefonnummern.
So setzen Sie das in acht Schritten um
- Erfassen Sie jeden Ort, an dem Kundendaten liegen, anhand der Tabelle weiter oben.
- Klassifizieren Sie jeden Datentyp: gewöhnliche personenbezogene Daten, sensible Daten, Zahlungsdaten, Zugangsdaten.
- Entfernen Sie Zahlungsdaten aus dem Support-Pfad mit einer gehosteten Zahlungsseite und Maskierung.
- Fügen Sie Schwärzung hinzu, vor dem Modell, vor der Speicherung und vor der Weiterverwendung, und prüfen Sie wöchentlich eine Stichprobe.
- Schreiben Sie den Aufbewahrungsplan mit einer verantwortlichen Person und automatisieren Sie die Löschung über Transkripte, Zusammenfassungen, Aufzeichnungen, Logs und Exporte hinweg.
- Unterschreiben Sie den DPA und arbeiten Sie die Anbieter-Checkliste ab.
- Legen Sie Region und Zugriff in jedem Tool fest und überprüfen Sie die Benutzerliste.
- Testen Sie es, indem Sie erfundene Karten- und Personendaten durch einen Chat schicken und dann versuchen, jede Kopie zu finden. Den größeren Rollout behandelt AI im Kundenservice einführen.
Fallstricke, die Sie vermeiden sollten
Nur die Eingabe des Modells schwärzen. Die Rohnachricht bleibt oft in Transkript, Logs und Exporten. Schwärzen Sie überall dort, wo sie festgehalten wird, und misstrauen Sie jedem einzelnen Kontrollkästchen „PII-Maskierung“, das Ihr Data Warehouse, Ihren Anrufrekorder und Ihre AI-Anbieter abdecken soll.
Verschlüsseln statt löschen. Beim Sicherheitscode sagt PCI SSC, dass das Speicherverbot auch bei Verschlüsselung gilt (PCI SSC FAQ 1280).
Einmalige Exporte ewig leben lassen. Eine Tabelle, die im März für eine QA-Prüfung erstellt wurde, liegt im Dezember immer noch auf einem gemeinsamen Laufwerk. Geben Sie Exporten ein Ablaufdatum.
Die Sicht des Kunden vergessen. Sagen Sie den Menschen, wenn sie mit einer AI sprechen und was mit ihren Nachrichten geschieht. Die Risiken von AI im Kundenservice behandeln die größeren Probleme, die Datenschutzpannen nähren.
Häufig gestellte Fragen zum Datenschutz bei Kundendaten im AI-Support
Was ist PII-Schwärzung im AI-Kundensupport?
Es ist das automatische Maskieren personenbezogener Daten, etwa Namen, E-Mail-Adressen und Kartennummern, bevor eine Nachricht ein Modell, ein Log oder ein gespeichertes Transkript erreicht. Erkennungstools übersehen Dinge, kombinieren Sie die Schwärzung daher mit Stichproben und der Regel, von vornherein weniger zu erheben.
Dürfen Kunden Kartennummern in einen AI-Chat eintippen?
Sie sollten den Ablauf so gestalten, dass sie es nicht tun. PCI DSS erlaubt nicht, Kartenprüfnummern nach der Autorisierung aufzubewahren, auch nicht verschlüsselt, ein Chat, der sie speichert, erzeugt also einen Verstoß. Schicken Sie Kunden auf eine gehostete Zahlungsseite und maskieren Sie kartenähnliche Nummern, falls doch eine eingetippt wird.
Wie lange sollten wir AI-Support-Transkripte aufbewahren?
Nur so lange, wie der Zweck es braucht. Artikel 5 Absatz 1 Buchstabe e der GDPR begrenzt die Speicherung identifizierbarer Daten auf das Erforderliche. Legen Sie daher je Datentyp eine Frist fest, lassen Sie Recht und Finanzen die äußeren Grenzen setzen und automatisieren Sie die Löschung von Transkripten, Zusammenfassungen und Logs gemeinsam.
Trainiert unser AI-Anbieter seine Modelle mit unseren Kundenkonversationen?
Das hängt vom Anbieter und von der Produktstufe ab, prüfen Sie daher den Vertrag und die Dokumentation des Anbieters. Einige Anbieter geben an, dass Geschäftskunden-API-Daten nicht zum Training verwendet werden, sofern Sie nicht zustimmen. Lassen Sie sich die Antwort in Ihrem DPA geben und achten Sie auf Änderungen der Bedingungen.
Wo sollten unsere Support-Daten gespeichert werden?
Dort, worauf Ihre rechtlichen Pflichten und die Erwartungen Ihrer Kunden hindeuten. Wählen Sie in den Einstellungen jedes Anbieters eine Region, wenn die Option besteht, und fragen Sie, was in dieser Region bleibt, einschließlich Logs, Backups und Zugriff des Support-Personals, denn „im Ruhezustand in einer Region gespeichert“ ist enger als „verlässt sie nie“.

Customer Success Operations Manager
On this page
- Wichtige Fakten
- Wo Kundendaten in einem AI-Support-Stack landen
- Beispiele nach Kanal
- Die sechs Kontrollen
- Schwärzung: PII in Transkripten, Prompts und Logs
- Aufbewahrung und Löschung
- Zahlungskartendaten: aus Chat und AI-Logs heraushalten
- Anbieterbedingungen: Trainingsdaten, DPAs und Unterauftragsverarbeiter
- Checkliste mit Fragen an Anbieter
- Datenresidenz und grenzüberschreitende Übermittlungen
- Zugriffskontrolle
- So setzen Sie das in acht Schritten um
- Fallstricke, die Sie vermeiden sollten