Privacidad de los datos del cliente en el soporte con IA: PII, redacción y retención
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
La privacidad de los datos del cliente en el soporte con IA es el conjunto de controles que decide qué datos personales ve un sistema de IA, cuánto tiempo los conserva alguien, adónde van y quién puede leerlos. En la práctica significa seis cosas: redactar los datos personales antes de que lleguen a un modelo o a un registro, fijar un período de retención y hacerlo cumplir, mantener los datos de tarjetas de pago fuera de los chats por completo, leer los términos de datos del proveedor, elegir dónde se almacenan los datos y limitar quién puede abrir las transcripciones.
El soporte es donde la privacidad falla en silencio. Los clientes pegan números de cuenta y datos médicos en un cuadro de chat porque usted les preguntó en qué podía ayudar, y con una capa de IA cada mensaje puede terminar en un prompt, en un registro del proveedor, en un conjunto de datos de QA y en un campo de resumen. Esta guía es para líderes de soporte que deben responder «¿adónde van los datos?» sin tener un título de abogado. No es asesoría legal, así que pida a un asesor de privacidad que confirme qué aplica en sus regiones. Se apoya en preparar los datos de soporte para la IA, que trata de depurar los datos. Aquí el foco es protegerlos.
Datos clave
- El artículo 5(1)(c) del GDPR exige que los datos personales sean «adecuados, pertinentes y limitados a lo necesario» para los fines del tratamiento, y el artículo 5(1)(e) establece que pueden conservarse de forma identificable «durante no más tiempo del necesario» (GDPR, EUR-Lex).
- PCI DSS no permite conservar los códigos de verificación de tarjeta una vez autorizada una transacción, ni siquiera cifrados y ni siquiera si el cliente lo acepta (PCI SSC FAQ 1280).
- Según el artículo 28(3) del GDPR, un encargado del tratamiento solo puede actuar siguiendo las instrucciones documentadas del responsable y, a elección de este, debe suprimir o devolver los datos personales cuando termina el servicio (GDPR, EUR-Lex).
- OpenAI afirma que los datos enviados a su API no se usan para entrenar sus modelos salvo que el cliente lo autorice, y que los registros de monitoreo de abusos se conservan hasta 30 días de forma predeterminada (OpenAI).
- La biblioteca de código abierto Presidio de Microsoft advierte que la detección automatizada no garantiza encontrar toda la información sensible (Presidio).
- La FTC dice que puede ser desleal o engañoso reescribir discretamente los términos para permitir el entrenamiento de IA con datos recopilados bajo promesas anteriores (FTC).
Dónde terminan los datos del cliente en un stack de soporte con IA
Antes de elegir controles, trace un mapa de los lugares donde realmente residen los datos. Una configuración típica de soporte con IA tiene más copias de las que la gente espera.
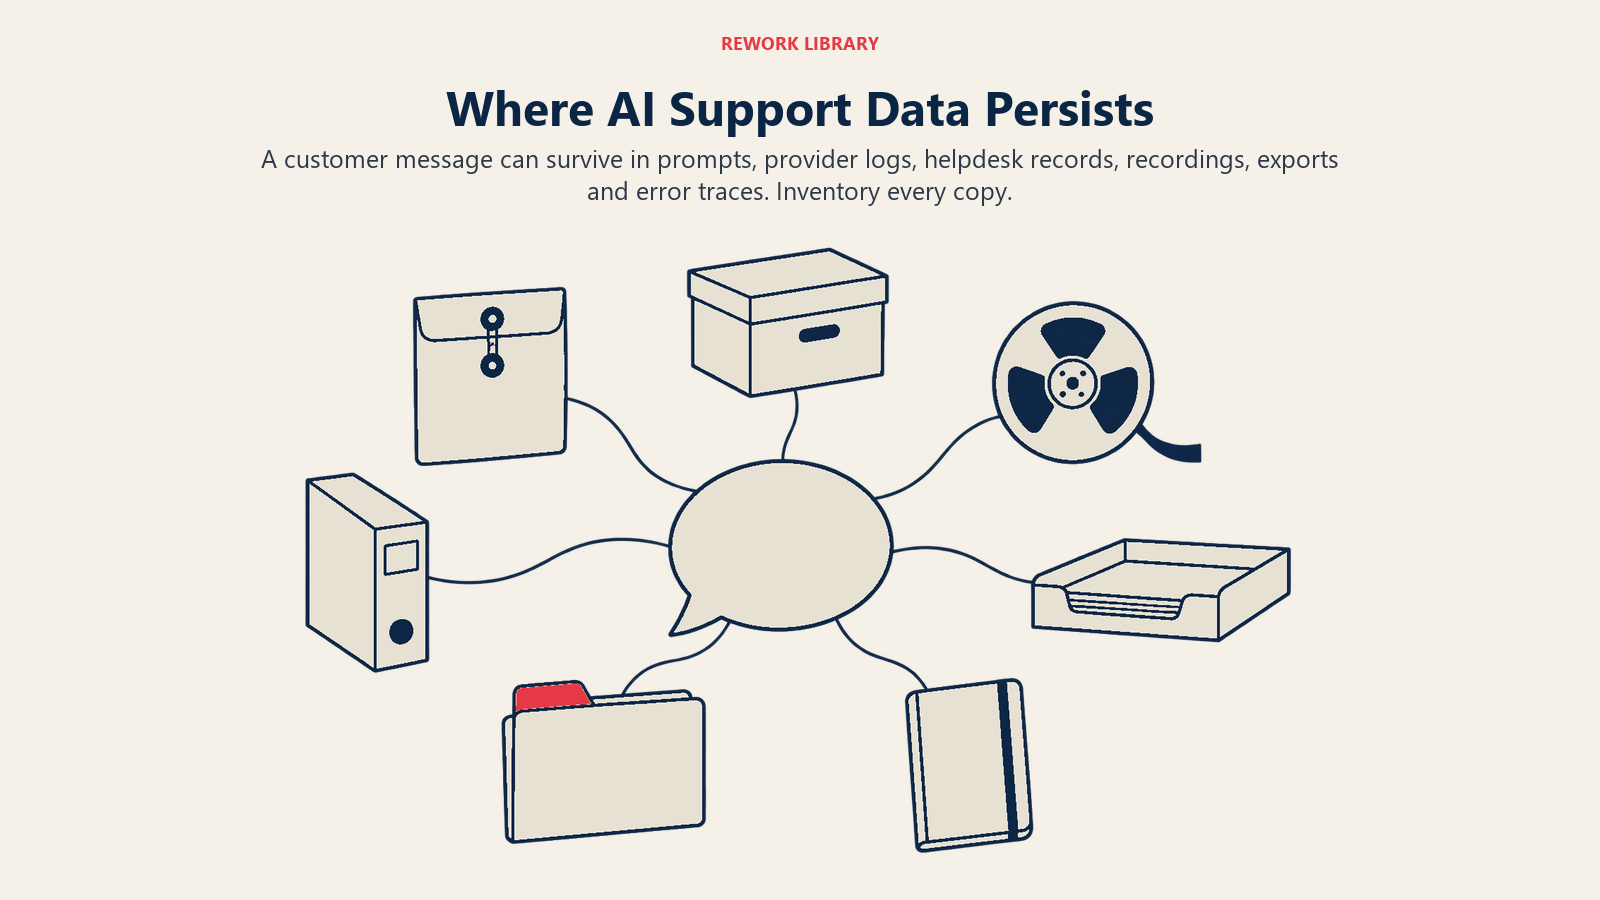
| Ubicación | Qué contiene | Quién suele olvidarla |
|---|---|---|
| Conversación en vivo | Todo lo que escribe el cliente, incluidas cosas que usted nunca pidió | Nadie, es la más obvia |
| Prompt enviado al modelo | El mensaje del cliente más los campos de cuenta que añada como contexto | Equipos que pasan el registro completo del cliente |
| Registros del proveedor del modelo | Prompts y salidas, conservados para monitoreo o depuración | Quien no ha leído los términos de retención del proveedor |
| Transcripción y ticket del helpdesk | Texto completo, archivos adjuntos, resúmenes redactados por la IA | Administradores que fijaron el período de retención una vez y nunca lo revisaron |
| Grabaciones de llamadas y transcripciones de voz | Números de tarjeta, nombres y direcciones dictados | Equipos que añadieron IA de voz después del despliegue del chat |
| Analítica, QA y conjuntos de entrenamiento | Muestras exportadas para revisión de calidad o ajuste | Quien armó la hoja de cálculo |
| Registros de aplicación y trazas de errores | Cargas útiles sin procesar cuando algo falla | Los ingenieros, por lo general |
Si una solicitud de privacidad o una auditoría llega a su escritorio, usted necesita poder enumerar cada fila de su propia configuración.
Ejemplos por canal
El riesgo se ve distinto en cada canal, y por eso la IA en los canales de soporte merece su propia revisión de privacidad.
Chat. Una persona que pregunta por un pago fallido suele pegar el número completo de la tarjeta. Enmascare las cadenas de dígitos que parezcan números de tarjeta antes de que el mensaje se almacene o se envíe a un modelo.
Correo. Los hilos incluyen firmas, historial reenviado y adjuntos como documentos de identidad escaneados. Elimine el historial citado y el texto de los adjuntos salvo que la tarea lo necesite.
Voz. Los datos hablados son los más difíciles de depurar. PCI SSC lo aborda directamente: los códigos de validación de tarjeta capturados en grabaciones de audio digital después de la autorización infringen la regla de almacenamiento, debe hacerse todo lo posible por evitar que se graben y, cuando no se pueda evitar la grabación, los datos deben eliminarse de forma segura inmediatamente después de la autorización (PCI SSC FAQ 1210).
Agent assist interno. Incluso una herramienta que solo sugiere respuestas a sus propios agentes ve la conversación completa. El agent assist necesita las mismas reglas de redacción y retención que un bot de cara al cliente.
Los seis controles
| Control | Qué protege | Cómo implementarlo | Norma o ley |
|---|---|---|---|
| Redacción de PII | Nombres, correos, identificaciones y números de tarjeta en prompts, transcripciones y registros | Detectar y enmascarar antes de enviar al modelo y antes de escribir registros; revisar una muestra para encontrar omisiones | GDPR art. 5(1)(c) minimización de datos; PCI DSS para datos de tarjetas |
| Retención y eliminación | Conversaciones antiguas que ya no tienen una finalidad | Un calendario escrito por tipo de dato; eliminación automatizada en el helpdesk, los registros y las exportaciones | GDPR art. 5(1)(e), art. 17 |
| Manejo de tarjetas de pago | Números de tarjeta y códigos de verificación | Nunca pedir datos de tarjeta en el chat; derivar a una página de pago o a un flujo tokenizado; enmascarar si se escriben | PCI DSS; PCI SSC FAQs 1280, 1210, 1533 |
| Términos del proveedor y DPA | Datos en manos de los proveedores | Confirmar que no se entrena con sus datos, la ventana de retención, la eliminación a la salida y los subencargados | GDPR art. 28(3) |
| Residencia de datos | Dónde se almacenan y procesan los datos | Elegir la región en la configuración del proveedor; revisar las vías de acceso del soporte | GDPR capítulo V (art. 44 y siguientes) |
| Control de acceso | Quién puede leer las transcripciones | Acceso basado en roles, mínimo privilegio, acceso registrado, baja rápida de quienes se van | GDPR art. 32 (seguridad del tratamiento) |
Las secciones siguientes tratan cada uno en el orden en que lo implementaría.
Redacción: PII en transcripciones, prompts y registros
El artículo 5(1)(c) del GDPR es el principio detrás de la redacción: los datos personales deben ser «adecuados, pertinentes y limitados a lo necesario» para los fines con los que se tratan (GDPR, EUR-Lex). Para un asistente de IA, eso se traduce en una regla de diseño. Envíe al modelo lo mínimo que necesita para esta conversación. Una solicitud de restablecimiento de contraseña necesita el estado de la cuenta, no el historial de facturación. Consulte personalizar el servicio con IA para más sobre el razonamiento del GDPR.
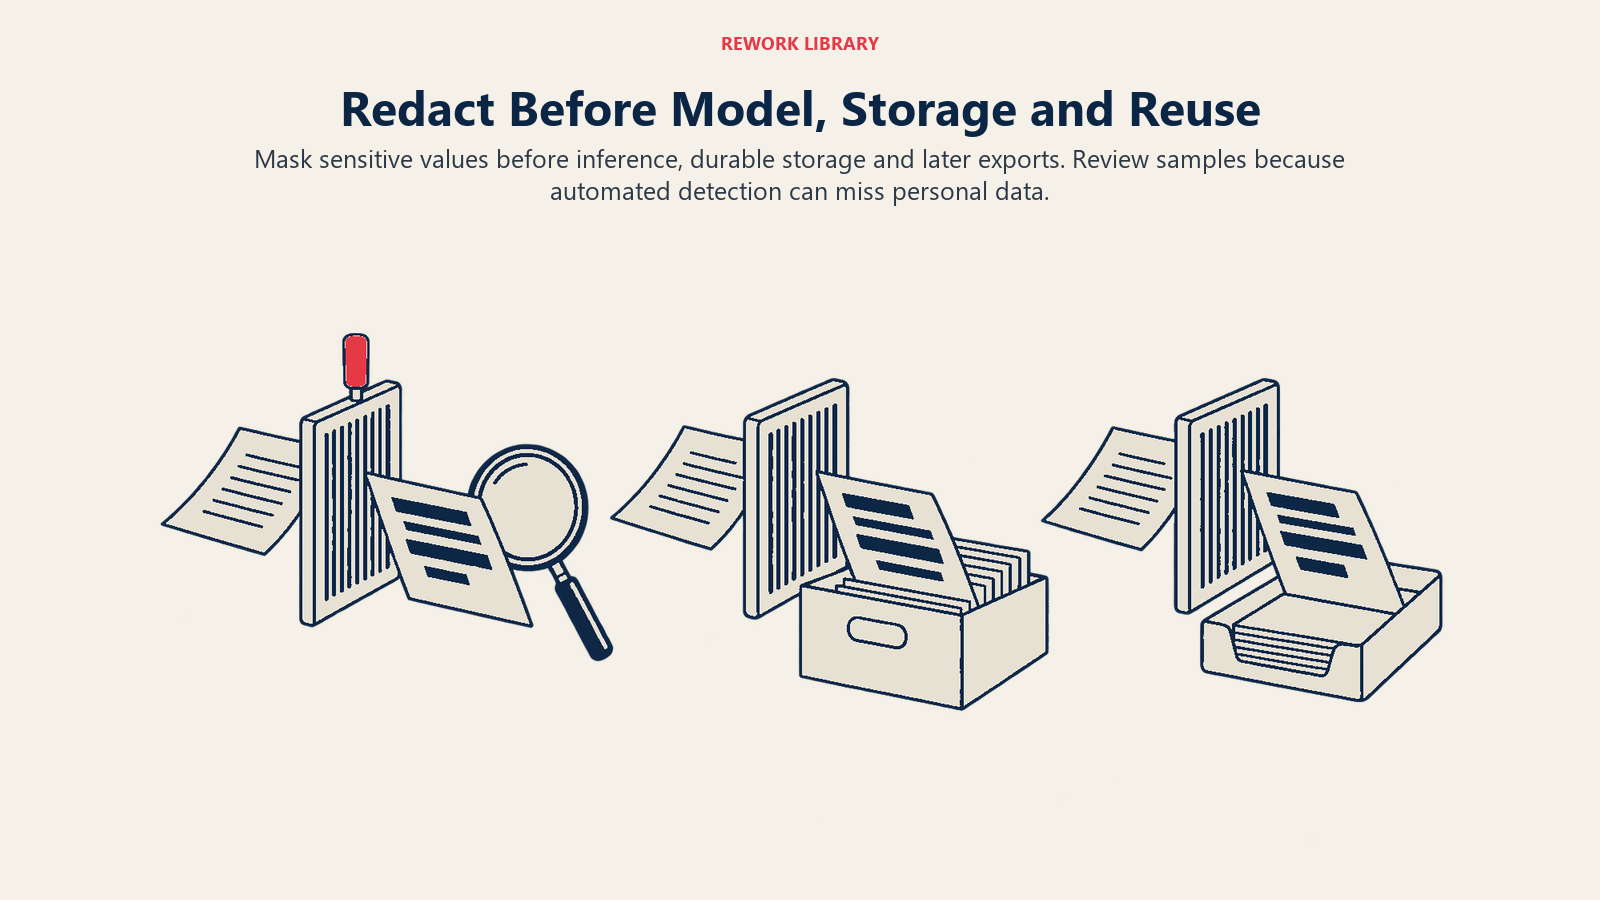
La redacción puede hacerse en tres puntos, y normalmente conviene hacerla en los tres:
- Antes del modelo. Detecte los datos personales en el mensaje entrante y sustitúyalos por marcadores como
[EMAIL]o[CARD_NUMBER]. El modelo aún puede responder «encontré la cuenta vinculada a ese correo» sin tener nunca la dirección real. Si la respuesta final necesita el valor real, su sistema puede reinsertarlo después de que el modelo responda. - Antes del almacenamiento. Aplique el mismo enmascaramiento antes de que la transcripción se escriba en el helpdesk, en el flujo de registros o en una tabla de analítica, para que el valor sin procesar nunca llegue a ningún lugar duradero.
- Antes de la reutilización. Cuando exporte conversaciones para QA, coaching o ajuste, redacte de nuevo. El toolkit de IA de la ICO sugiere usar información sintética o anonimizada para entrenar un modelo cuando sea posible (ICO).
Una advertencia sobre las herramientas: Presidio, el kit de detección de código abierto de Microsoft, dice que no hay garantía de que encuentre toda la información sensible porque la detección es automatizada (Presidio). La coincidencia de patrones maneja bien los números de tarjeta y los correos, y mal los nombres dentro de frases o las descripciones de enfermedades. Revise muestras de transcripciones redactadas cada semana y busque omisiones.
Los registros de depuración, los rastreadores de errores y las grabaciones de sesiones del widget de chat también conservan texto sin procesar, así que revíselos por separado.
Retención y eliminación
El artículo 5(1)(e) del GDPR establece que los datos personales pueden conservarse de forma identificable durante no más tiempo del necesario para los fines con los que se trataron (GDPR, EUR-Lex). Los considerandos añaden que los responsables deben fijar plazos para la supresión o la revisión periódica. Los clientes tienen además, en la redacción del artículo 17(1), «el derecho a obtener del responsable del tratamiento la supresión de los datos personales que le conciernan» en las circunstancias que enumera el artículo.
No necesita un análisis jurídico perfecto para empezar. Necesita un calendario que tenga un responsable:
- Decida la finalidad de cada tipo de dato. Las transcripciones, las grabaciones, los resúmenes de IA, las muestras de QA y los registros del proveedor existen cada uno por una razón. Anótela junto al período de retención.
- Fije períodos acordes con la razón. Las garantías y las disputas de facturación pueden justificar conservar un ticket durante mucho tiempo. Un chat en el que alguien preguntó por el horario de atención no. Sus equipos legal y de finanzas suelen fijar los límites externos, ya que las leyes de conservación de registros varían.
- Elimine también los subproductos de la IA. Los resúmenes, las puntuaciones de sentimiento, las entidades extraídas y los embeddings construidos a partir de una conversación son datos derivados sobre la misma persona. Una eliminación que borra el ticket pero deja el resumen de IA no ha eliminado gran cosa.
- Automatícelo. Un calendario que depende de que alguien se acuerde fallará. Use los ajustes de retención del helpdesk y las reglas de ciclo de vida del almacenamiento de su cuenta en la nube.
- Anote las excepciones. El toolkit de IA de la ICO pide un calendario de retención documentado, la eliminación de la información personal que contienen los sistemas de IA de acuerdo con él y una justificación mediante DPIA para cualquier retención que vaya más allá (ICO).
Las copias de seguridad son la trampa habitual. Indique en su política cuánto tiempo sobreviven allí los datos eliminados, y pregunte lo mismo a los proveedores.
Datos de tarjetas de pago: manténgalos fuera del chat y de los registros de la IA
Los datos de tarjetas son el único ámbito con una regla industrial estricta, y los equipos de soporte la infringen por accidente más que nadie. La distinción clave en PCI DSS es entre el número de tarjeta (PAN) y los datos sensibles de autenticación, como el código de seguridad impreso en la tarjeta.
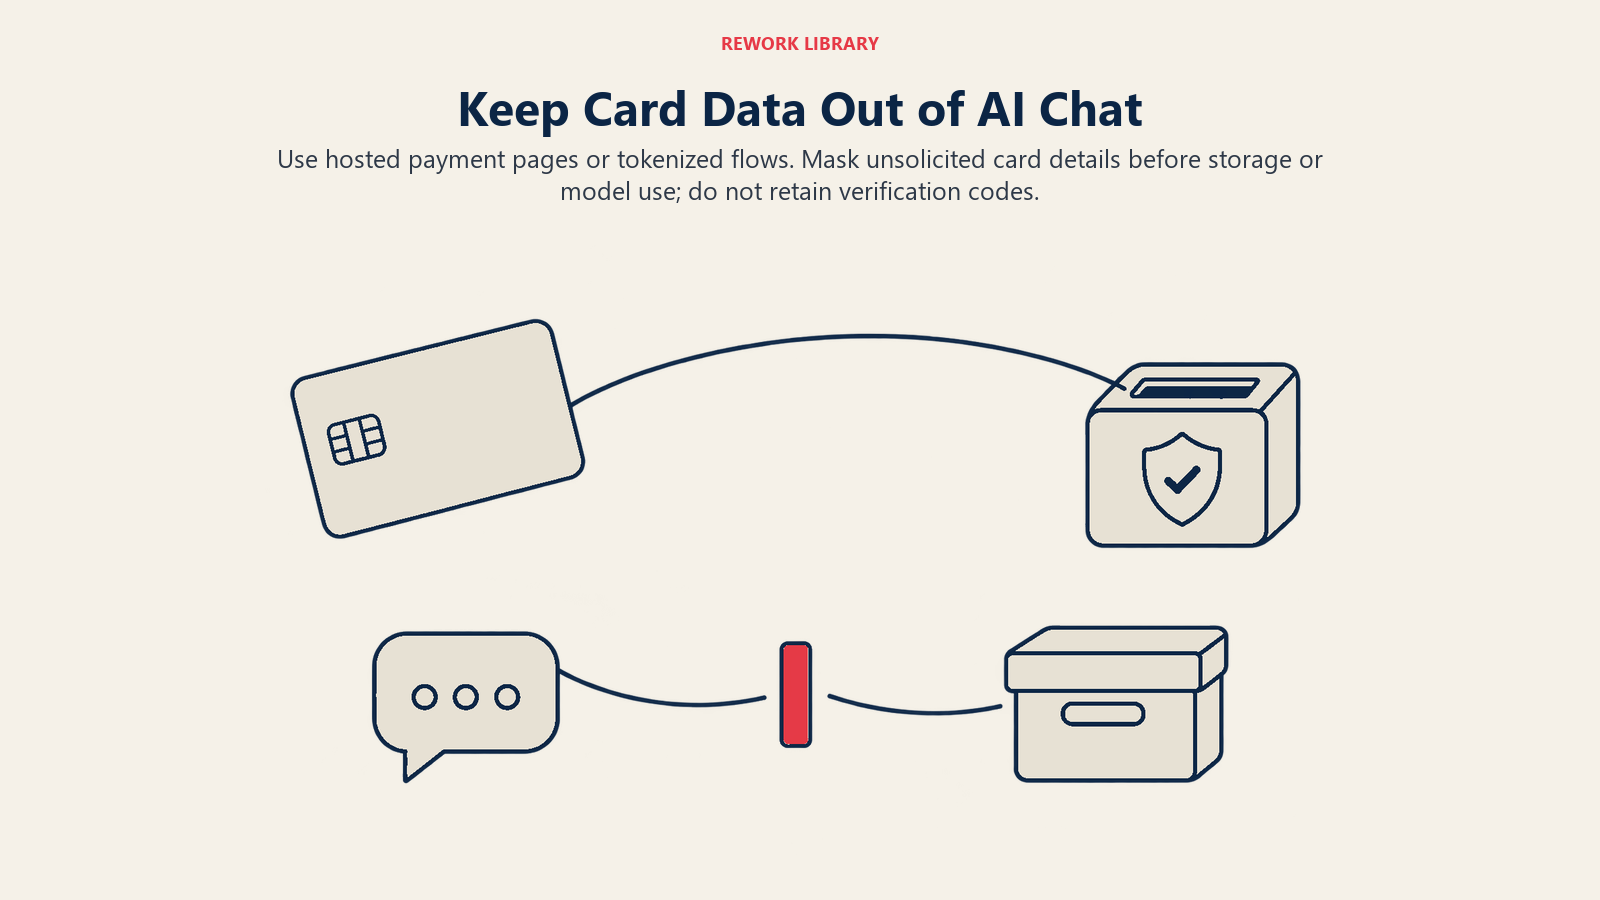
Sobre el código de seguridad, la FAQ de PCI SSC es tajante: no está permitido conservar los códigos de verificación de tarjeta una vez autorizada la transacción, se permite recopilarlos antes de la autorización, y la aprobación del cliente no constituye una autorización para almacenarlos (PCI SSC FAQ 1280). Otra FAQ añade que los datos sensibles de autenticación no deben almacenarse después de la autorización aunque estén cifrados, y que esto se aplica incluso cuando no hay PAN presente (PCI SSC FAQ 1533).
Si un cliente escribe un número de tarjeta y un código en un chat y la plataforma almacena la transcripción, ese código queda en una base de datos después del pago, y además puede pasar a prompts, resúmenes, exportaciones de QA y registros del proveedor. La guía de PCI SSC sobre grabaciones de voz fija el comportamiento esperado más cercano: evitar la grabación cuando sea posible y eliminar inmediatamente tras la autorización cuando no se pueda evitar (PCI SSC FAQ 1210).
El enfoque práctico es la reducción del alcance, que consiste en organizar las cosas para que los datos de tarjetas nunca toquen sus sistemas de soporte:
- No pida datos de tarjeta en el chat, por correo ni a una IA. Envíe a los clientes a una página de pago alojada o a un enlace seguro que administre su proveedor de pagos.
- Enmascare al llegar todo lo que parezca un número de tarjeta. Hágalo antes del almacenamiento y antes del modelo, e informe al cliente de que lo ha hecho.
- Use tokens cuando la IA necesite referirse a un pago. Los AI Principles de PCI SSC sugieren considerar tokens de pago o PAN de un solo uso para limitar el alcance y el impacto de un sistema de IA, y dicen que la principal salvaguarda es limitar desde el principio los datos sensibles que se entregan al sistema de IA (blog de PCI SSC).
- Mantenga también fuera las credenciales. Los mismos principios dicen que los tokens de API, las credenciales de usuario y las claves criptográficas deben mantenerse fuera de los conjuntos de datos de IA.
- Confirme el alcance con su adquirente o evaluador. Pregúnteles cómo encajan su chat, su voz y su configuración de IA, y cuáles de sus sistemas cuentan como manejadores de datos de tarjetas.
Términos del proveedor: datos de entrenamiento, DPA y subencargados
El proveedor de IA suele ser un encargado del tratamiento que actúa por cuenta suya. El artículo 28(3) del GDPR dice que el tratamiento por un encargado se rige por un contrato en virtud del cual el encargado «trata los datos personales únicamente siguiendo instrucciones documentadas del responsable» y, a elección de este, «suprime o devuelve todos los datos personales al responsable» cuando termina el servicio (GDPR, EUR-Lex). Ese contrato es el acuerdo de procesamiento de datos (DPA). Fírmelo antes de que fluya cualquier dato de clientes.
Dos puntos hacen tropezar a los equipos.
Los términos difieren según el producto. Lea la documentación de cada proveedor para el producto exacto que compra. OpenAI, por ejemplo, afirma que los datos de la API no se usan para entrenar sus modelos salvo que usted lo autorice, que los registros de monitoreo de abusos se conservan hasta 30 días de forma predeterminada y que Zero Data Retention excluye el contenido de esos registros pero requiere aprobación previa (OpenAI). La IA integrada de su helpdesk, un proveedor de chatbots y una plataforma de voz tienen cada uno sus propios términos.
Los términos cambian. La FTC ha advertido que puede ser desleal o engañoso que una empresa adopte prácticas de datos más permisivas, como usar datos para entrenar IA, y se lo comunique a los clientes solo mediante un cambio subrepticio y retroactivo de sus términos. También afirma que una empresa que recopila datos bajo un conjunto de compromisos de privacidad no puede incumplirlos unilateralmente (FTC). Eso protege a los clientes, pero también le indica que debe tratar los términos del proveedor como un documento vivo. Ponga en el calendario de alguien el contacto de avisos de cambios y revise los términos en cada renovación.
Lista de preguntas para el proveedor
Pregunte a cada proveedor de IA y de herramientas de soporte, y consiga las respuestas en el contrato o en el DPA, no en una llamada comercial:
- ¿Se usan nuestros datos para entrenar o mejorar sus modelos o los de un tercero? ¿Está desactivado por defecto o es opt-in?
- ¿Cuánto tiempo conservan los prompts, las salidas y los registros, y podemos acortarlo o fijar retención cero?
- ¿Qué ocurre con nuestros datos al terminar el contrato y cómo se confirma la eliminación?
- ¿Qué subencargados tocan nuestros datos, en qué países y cómo se nos informa cuando cambian?
- ¿Podemos elegir la región de almacenamiento y procesamiento? ¿El personal de soporte accede desde otras regiones?
- ¿Qué registros y controles de acceso existen de su lado para nuestros datos?
- ¿Cómo nos notificarán una brecha y en cuánto tiempo?
- ¿El producto enmascara o excluye los números de tarjeta y la grabación de voz se trata de otra manera?
Residencia de datos y transferencias transfronterizas
El capítulo V del GDPR, que se abre con el artículo 44, regula las transferencias de datos personales a terceros países (GDPR, EUR-Lex). Para los líderes de soporte la pregunta práctica es sencilla: ¿en qué país se almacenan los datos de nuestros clientes y qué países pueden leerlos?
Muchos proveedores de IA ofrecen un ajuste regional. OpenAI documenta la residencia de datos como una opción a nivel de proyecto que almacena el contenido del cliente en reposo en la región elegida para los endpoints compatibles, con exclusión de los datos del sistema (OpenAI). «En reposo» es más estrecho que «nunca sale de la región», así que pregunte a cada proveedor por las copias de seguridad, los registros y el acceso del personal de soporte.
Control de acceso
El incidente de privacidad más común en soporte no es un ataque. Es alguien con demasiado acceso que lee lo que no tenía motivo para leer. El artículo 32(1)(a) del GDPR menciona la seudonimización y el cifrado entre las medidas técnicas que conviene considerar (GDPR, EUR-Lex). Añada lo básico:
- Acceso basado en roles. Los agentes ven sus propias colas. Los revisores de QA ven muestras. Solo un grupo reducido ve las exportaciones sin procesar y los registros de la IA.
- Mínimo privilegio para la propia IA. Los AI Principles de PCI SSC recomiendan dar a la IA solo el acceso que necesita, con sus propias credenciales revocables, y registrar sus acciones para que puedan rastrearse hasta una persona responsable (blog de PCI SSC). Un bot que puede leer todos los registros de clientes porque era más fácil de configurar, tarde o temprano recibirá una pregunta sobre uno.
- Registros de auditoría. Sepa quién abrió qué transcripción y cuándo.
- Baja de personal y enmascaramiento. Retire el acceso el día en que alguien se va, y muestre por defecto solo los últimos dígitos de identificaciones o números de teléfono.
Cómo implementarlo en ocho pasos
- Haga un inventario de cada lugar donde residen los datos del cliente, usando la tabla del comienzo.
- Clasifique cada tipo de dato: datos personales ordinarios, datos sensibles, datos de pago, credenciales.
- Saque los datos de pago de la ruta de soporte con una página de pago alojada y enmascaramiento.
- Añada redacción antes del modelo, antes del almacenamiento y antes de la reutilización, y revise muestras cada semana.
- Escriba el calendario de retención con un responsable y automatice la eliminación en transcripciones, resúmenes, grabaciones, registros y exportaciones.
- Firme el DPA y recorra la lista de preguntas para el proveedor.
- Fije la región y el acceso en cada herramienta y revise la lista de usuarios.
- Pruébelo introduciendo datos falsos de tarjetas y datos personales en un chat y luego intentando encontrar cada copia. Consulte implementar la IA en el servicio al cliente para el despliegue más amplio.
Errores que conviene evitar
Redactar solo la entrada del modelo. El mensaje sin procesar suele quedar en la transcripción, los registros y las exportaciones. Redacte dondequiera que se escriba, y desconfíe de que una única casilla de «enmascaramiento de PII» cubra su almacén de datos, su grabador de llamadas y sus proveedores de IA.
Cifrar en lugar de eliminar. Para el código de seguridad, PCI SSC dice que la prohibición de almacenamiento se aplica aunque esté cifrado (PCI SSC FAQ 1280).
Dejar que las exportaciones puntuales vivan para siempre. Una hoja de cálculo creada para una revisión de QA en marzo sigue en una unidad compartida en diciembre. Ponga una fecha de caducidad a las exportaciones.
Olvidar el punto de vista del cliente. Dígale a la gente cuándo está hablando con una IA y qué ocurre con sus mensajes. Los riesgos de la IA en el servicio al cliente tratan los problemas más amplios que alimentan los fallos de privacidad.
Preguntas frecuentes sobre la privacidad de los datos del cliente en el soporte con IA
¿Qué es la redacción de PII en el soporte al cliente con IA?
Es el enmascaramiento automático de datos personales, como nombres, direcciones de correo y números de tarjeta, antes de que un mensaje llegue a un modelo, a un registro o a una transcripción almacenada. Las herramientas de detección pasan cosas por alto, así que combine la redacción con muestreo y con una regla para recopilar menos desde el principio.
¿Pueden los clientes escribir números de tarjeta en un chat con IA?
Debe diseñar el flujo para que no lo hagan. PCI DSS no permite conservar los códigos de verificación de tarjeta después de la autorización, ni siquiera cifrados, de modo que un chat que los almacena crea una infracción. Envíe a los clientes a una página de pago alojada y enmascare los números parecidos a una tarjeta si de todos modos escriben uno.
¿Cuánto tiempo debemos conservar las transcripciones del soporte con IA?
Solo el tiempo que necesite la finalidad. El artículo 5(1)(e) del GDPR limita la conservación de datos identificables a lo necesario, así que fije un período por tipo de dato, pida a legal y finanzas que fijen los límites externos y automatice la eliminación de transcripciones, resúmenes y registros en conjunto.
¿Nuestro proveedor de IA entrena sus modelos con las conversaciones de nuestros clientes?
Depende del proveedor y del nivel del producto, así que revise el contrato y la documentación del proveedor. Algunos proveedores afirman que los datos de la API empresarial no se usan para el entrenamiento salvo que usted lo autorice. Obtenga la respuesta en su DPA y esté atento a los cambios en los términos.
¿Dónde deben almacenarse nuestros datos de soporte?
Donde apunten sus obligaciones legales y las expectativas de sus clientes. Elija una región en los ajustes de cada proveedor cuando exista la opción, y pregunte qué permanece en esa región, incluidos los registros, las copias de seguridad y el acceso del personal de soporte, ya que «almacenado en reposo en una región» es más estrecho que «nunca sale de ella».

Customer Success Operations Manager
On this page
- Datos clave
- Dónde terminan los datos del cliente en un stack de soporte con IA
- Ejemplos por canal
- Los seis controles
- Redacción: PII en transcripciones, prompts y registros
- Retención y eliminación
- Datos de tarjetas de pago: manténgalos fuera del chat y de los registros de la IA
- Términos del proveedor: datos de entrenamiento, DPA y subencargados
- Lista de preguntas para el proveedor
- Residencia de datos y transferencias transfronterizas
- Control de acceso
- Cómo implementarlo en ocho pasos
- Errores que conviene evitar