Pronóstico con IA del volumen de soporte y la dotación de personal
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
El pronóstico del volumen de soporte es la práctica de predecir cuántos contactos de clientes llegarán en cada intervalo (normalmente de 30 minutos o una hora) y luego convertir esa predicción en el número de agentes que necesita en turno para cumplir un objetivo de nivel de servicio. Son dos tareas unidas: un pronóstico de la demanda y un cálculo de dotación que convierte la demanda en personas. La IA mejora sobre todo la primera. La segunda sigue siendo matemática clásica de colas, y no perdona cuando el pronóstico falla.
Esa es la parte que los líderes suelen pasar por alto. Un pronóstico que se queda 5% corto no produce un problema de servicio de 5%, puede producir una cola que se desborda. Esta guía cubre cómo funciona el cálculo de dotación (Erlang C y sus límites), cómo medir con honestidad la precisión del pronóstico, cuándo el machine learning supera a una línea base simple y cómo la deflexión con IA cambia tanto el volumen como la mezcla de lo que queda. Forma parte de la colección AI for Customer Service, así que la visión general de la IA en el servicio al cliente es el lugar para empezar si quiere el panorama más amplio.
Datos clave
- El modelo Erlang C supone llegadas de Poisson, tiempos de servicio exponenciales, una tasa de llegada constante dentro de cada intervalo y que se ignoran el bloqueo, el abandono y los reintentos (Gans, Koole y Mandelbaum).
- El ejemplo del mismo artículo: un centro planificado para una utilización de 95% cuya tasa de llegada resulta 5% mayor ve cómo la utilización sube a 99,75%, y los tiempos de espera se disparan o el abandono supera con creces lo planificado (Gans, Koole y Mandelbaum).
- El shrinkage de un contact center suele situarse entre 25% y 40% del tiempo programado, con promedios de alrededor de 30-35% (NICE).
- Orientación de los manuales de pronóstico: antes de plantearse un método más sofisticado, hay que superar referencias simples como el método ingenuo estacional (Hyndman y Athanasopoulos, FPP3).
- En una gran comparación de métodos estadísticos y de machine learning, los métodos de machine learning quedaron dominados en ambas medidas de precisión y en todos los horizontes de pronóstico examinados, y necesitaron mucho más cómputo (Makridakis et al., PLOS ONE).
Del pronóstico a la plantilla: qué hace Erlang C
Erlang C es la pieza fundamental de la dotación en los contact centers. Usted le da una tasa de llegada, un tiempo medio de gestión y un objetivo, y le dice cuántos agentes necesita en ese intervalo. La revisión del campo de Gans, Koole y Mandelbaum describe la práctica habitual: ejecutar el modelo Erlang C en cada intervalo de media hora, tratar cada uno como un estado estable y usar la tasa de llegada y el tiempo de servicio pronosticados para obtener un nivel de dotación objetivo para el período. Esas cifras por intervalo alimentan después el modelo de programación de turnos (Gans, Koole y Mandelbaum).
Cuatro términos hacen la mayor parte del trabajo:
- El tráfico (en Erlangs) es la carga de trabajo. Los contactos del intervalo por el tiempo medio de gestión, divididos entre la duración del intervalo. 120 contactos de 300 segundos cada uno en una media hora de 1800 segundos son 120 x 300 / 1800 = 20 Erlangs. En términos sencillos, necesita 20 agentes solo para mantener el ritmo.
- El nivel de servicio es la proporción de contactos atendidos dentro de un umbral, como 80% en 20 segundos.
- La ocupación es la proporción del tiempo del agente dedicada a atender contactos. Con 25 agentes que cargan 20 Erlangs, la ocupación es 20 / 25 = 80%.
- El shrinkage (la merma de tiempo disponible) es la proporción del tiempo pagado en que los agentes no están disponibles: descansos, capacitación, reuniones, ausencias. NICE lo define como las horas perdidas en actividades no productivas divididas entre el total de horas programadas, y lo divide en shrinkage interno (planificado) y externo (no planificado) (NICE).
Un ejemplo resuelto
Supongamos que una cola espera 120 contactos en media hora, con un tiempo medio de gestión de 300 segundos, y usted quiere 80% atendido en 20 segundos. Con las fórmulas estándar de Erlang C, las cifras salen así:
| Agentes en la cola | Ocupación | Nivel de servicio (atendido en 20 s) | Velocidad media de respuesta |
|---|---|---|---|
| 22 | 91% | 50,3% | 85 segundos |
| 23 | 87% | 66,0% | 42 segundos |
| 24 | 83% | 77,2% | 22 segundos |
| 25 | 80% | 85,0% | 13 segundos |
| 26 | 77% | 90,4% | 7 segundos |
Veinticuatro agentes no llegan al objetivo, veinticinco lo superan. Ahora añada el shrinkage. Con 30% de shrinkage, 25 agentes productivos significan 25 / (1 - 0,30) = 35,7, así que programaría 36 personas para esa media hora.
Y aquí está el riesgo del pronóstico en el mismo ejemplo. Si el volumen resulta 5% mayor de lo planificado (126 contactos en lugar de 120) y usted dotó 25 agentes, el nivel de servicio cae de 85,0% a cerca de 76,5%. Un error de 5% en el volumen lo dejó por debajo del objetivo. Con 24 agentes, el mismo error de 5% lleva el nivel de servicio a cerca de 65%. La curva es empinada, que es justo lo que advierte el artículo de Gans: como el rendimiento es una función convexa de la tasa de llegada, el rendimiento real bajo un pronóstico incierto será típicamente peor que el plan, no igual a él (Gans, Koole y Mandelbaum).
Dónde falla Erlang C
Erlang C es un modelo, y el modelo tiene límites conocidos. La propia lista de la revisión es la que conviene tener a mano: tasas constantes dentro de un intervalo, llegadas de Poisson, tiempos de servicio exponenciales y bloqueo, abandono y reintentos ignorados (Gans, Koole y Mandelbaum). En la práctica eso significa:
- Sin abandono. Erlang C finge que todos los clientes esperan todo lo que haga falta. Los clientes reales cuelgan o cierran el chat. La misma revisión señala que, sin abandono, una tasa de llegada superior a la capacidad hace que la cola crezca sin límite, mientras que los modelos que incluyen el abandono se mantienen estables y permiten intercambiar capacidad por abandono y demora.
- Tasas de llegada conocidas. Trata el pronóstico como la verdad. Como dice el artículo, la tasa de llegada se predice a partir de datos históricos y no se conoce con certeza, e ignorarlo puede ser arriesgado.
- Un contacto a la vez. La fórmula clásica encaja con canales de un solo contacto como el teléfono. Los agentes de chat y mensajería manejan varias conversaciones a la vez, y el correo es asíncrono, por lo que los equipos suelen ajustar con un factor de concurrencia o usar otros modelos. Tome la tabla anterior como el caso de voz.
- Agentes idénticos. El personal nuevo y los veteranos no atienden los contactos a la misma velocidad, y el tiempo de gestión cambia con la mezcla de temas.
Nada de esto hace inútil a Erlang C. Lo convierte en una buena primera estimación que necesita un margen y un ciclo de retroalimentación. Muchos equipos añaden un margen de seguridad por encima de la cifra de Erlang, y el mejor trabajo de pronóstico se centra en reducir la incertidumbre que ese margen tiene que cubrir.
Medir la precisión del pronóstico
Antes de comparar cualquier método de pronóstico, acuerde la vara de medir. Hyndman y Athanasopoulos definen las medidas estándar en Forecasting: Principles and Practice (FPP3):
| Medida | Qué es | Buena para | Cuidado con |
|---|---|---|---|
| MAE | Media de los errores absolutos, en contactos | Fácil de explicar a los líderes de operaciones | Depende de la escala, así que no se puede comparar una cola pequeña con una grande |
| RMSE | Raíz cuadrada del error cuadrático medio | Penalizar los grandes errores | También depende de la escala; más difícil de interpretar |
| MAPE | Error porcentual absoluto medio | Comparar colas de distinto tamaño | No está definido cuando el volumen real es cero y es extremo cerca de cero, como en las medias horas de la noche; penaliza más los errores negativos que los positivos |
| MASE | Error escalado frente a una referencia ingenua | Comparar cualquier método con la línea base en una sola cifra | Menos conocido para quienes no son analistas |
Dos consecuencias prácticas. Primero, el MAPE se comporta mal justo en los intervalos de los que los equipos de soporte tienen de sobra: franjas nocturnas tranquilas con un puñado de contactos. Informe el MAPE sobre totales diarios u horarios, y use MAE o MASE a nivel de media hora. Segundo, FPP3 define el MASE de modo que un valor inferior a 1 significa que usted supera a la referencia en los datos de entrenamiento, y para las series estacionales esa referencia es el método ingenuo estacional (FPP3). Esa es la cifra que hay que poner delante de su responsable de WFM: «¿somos mejores que repetir el patrón de la semana pasada?».
Mida también el sesgo, no solo el error. Un pronóstico que un día se pasa 8% y al siguiente se queda 8% corto tiene el mismo MAE que uno que siempre se pasa 8%, pero el segundo es un problema sistemático de sobredotación. Siga también el error con signo.
Cuándo el machine learning supera a una línea base simple
Empiece por la línea base. El método ingenuo estacional de FPP3 fija cada pronóstico en el último valor observado de la misma estación (este martes a las 10:00 se parece al martes pasado a las 10:00), y la postura del libro es que esos métodos sirven de referencia, y que un método nuevo que no los supere no merece consideración (FPP3). Para una cola estable con un fuerte ritmo semanal, un método ingenuo estacional o un modelo estadístico clásico suele ser difícil de superar. Un gran estudio de métodos estadísticos y de machine learning halló que los métodos de ML quedaron dominados en precisión en todos los horizontes, y necesitaron mucho más cómputo (Makridakis et al., PLOS ONE). Tome las afirmaciones de «pronóstico impulsado por IA» de los proveedores con ese resultado en mente.
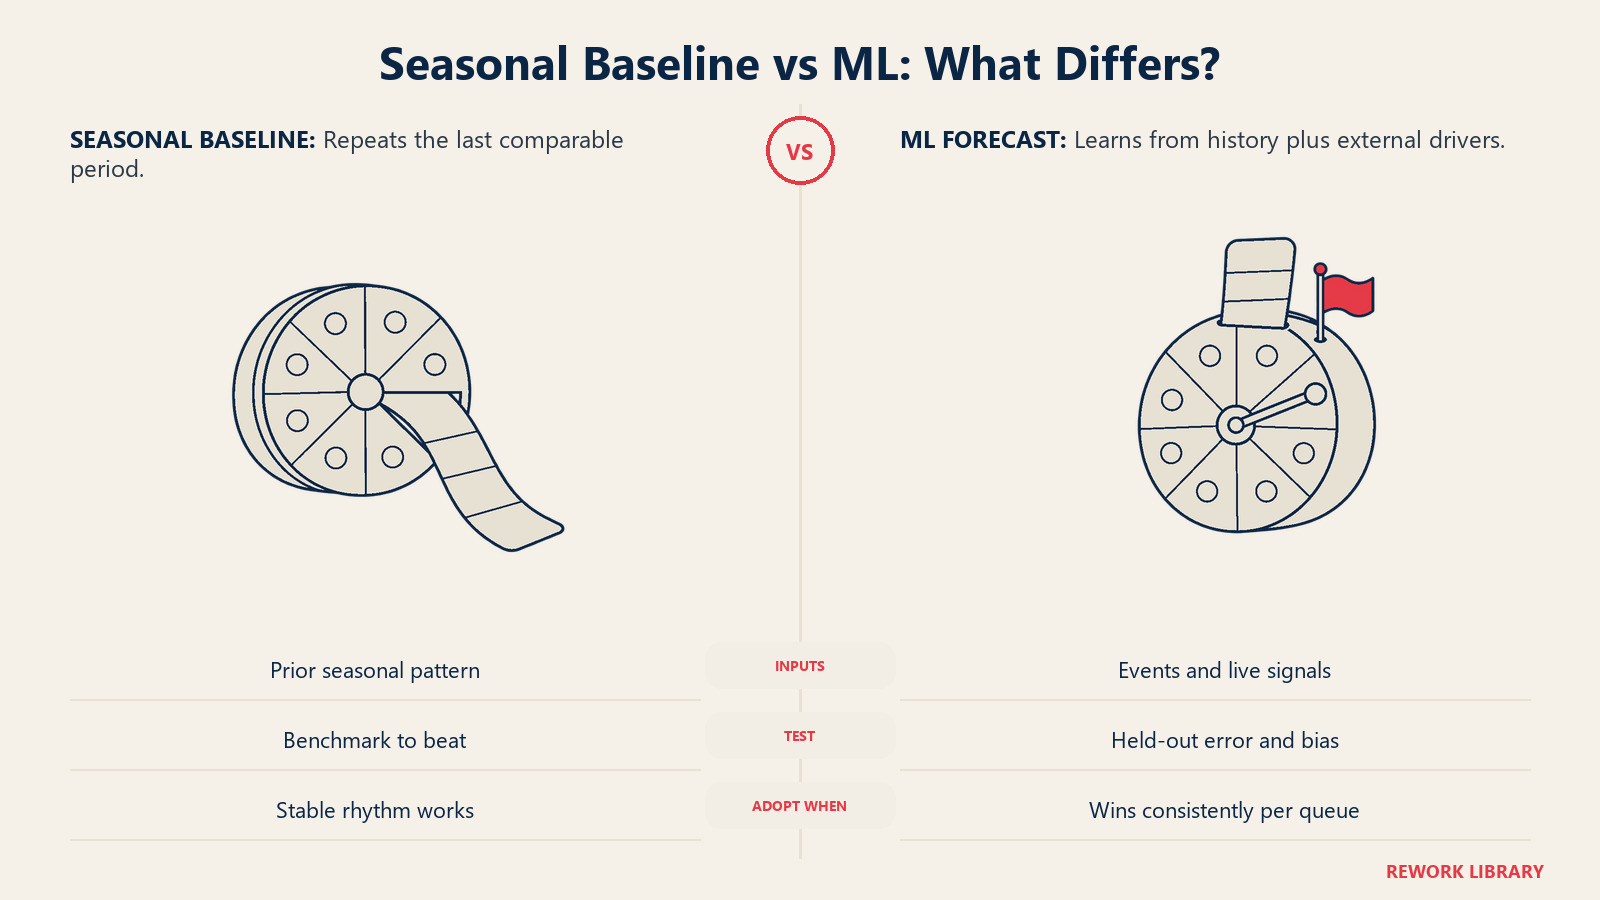
Entonces, ¿dónde se gana su lugar el ML? Donde el historial por sí solo no basta y las señales externas explican las oscilaciones:
- Factores conocidos. Los lanzamientos de producto, los ciclos de facturación, los envíos de marketing, las caídas y los cambios de precio crean un volumen que el patrón de la semana pasada no puede predecir. Los modelos de ML pueden tomarlos como entradas (un calendario de eventos planificados, un indicador de incidente, el número de clientes recién facturados).
- Muchas colas a la vez. Si pronostica por idioma, nivel y canal, un modelo que aprende patrones compartidos entre series puede ayudar con las series pequeñas, en las que cada una tiene poco historial.
- Corrección intradía. Un modelo que observa las primeras horas de hoy y vuelve a pronosticar el resto puede detectar un pico a tiempo. Es un patrón de detección de anomalías: ingerir un flujo en vivo, compararlo con una línea base, marcar el valor atípico y alertar a un planificador.
- Motivos de contacto. Si la detección de intención etiqueta cada contacto por motivo, puede pronosticar por separado «disputa de factura» y «restablecimiento de contraseña», lo que es mucho más útil que un solo total.
Una forma sensata de decidir: ejecute la línea base y el modelo de ML en paralelo sobre al menos unas semanas de datos reservados, compare con el MASE y adopte el ML solo donde gane de forma constante, no en promedio. Un modelo que gana en las semanas normales y pierde en las semanas que importan (lanzamientos, caídas) no está ayudando.
Cómo la deflexión con IA cambia el volumen y la mezcla
Cuando un agente de IA resuelve parte de su tráfico entrante, su historial deja de describir su futuro. Cambian dos cosas.
El volumen baja, pero no uno a uno. Si la IA atiende una parte de las conversaciones, la cola humana ve menos contactos. Pero eso depende de cómo cuente la resolución. Contenido no es lo mismo que resuelto, y los clientes a los que no se ayudó vuelven por otro canal, a menudo como contacto repetido.
La mezcla se vuelve más difícil. Los contactos fáciles se van primero: restablecimientos de contraseña, estado del pedido, preguntas sencillas de uso. Lo que queda es más largo, más complejo y más emocional, así que el tiempo medio de gestión sube. Retome el ejemplo resuelto y suponga que la IA elimina 30% del volumen (120 contactos pasan a 84) mientras que los contactos restantes tardan 30% más (390 segundos en lugar de 300). La carga de trabajo es 84 x 390 / 1800 = 18,2 Erlangs, y el objetivo 80/20 necesita 23 agentes. Son dos menos que 25, una reducción de 8% en agentes para una reducción de 30% en contactos. Con 30% de shrinkage son unos 33 programados en lugar de 36.
La conclusión: pronostique por separado el volumen y el tiempo de gestión, por motivo de contacto. Reentrene o restablezca la línea base después de cualquier lanzamiento o cambio del agente de IA, porque el historial previo al lanzamiento ya es de un sistema distinto. Y cuando los agentes reciben herramientas como el AI agent assist que acortan el tiempo de gestión de los contactos que quedan, eso se ve en el AHT, no en el volumen, así que siga midiéndolo como una entrada propia.
Cómo construirlo, paso a paso
- Extraiga un historial limpio. Al menos un año de recuentos de contactos por intervalo, canal y motivo de contacto, más los tiempos de gestión. Marque las caídas, los lanzamientos y los festivos para que el modelo pueda aprender de ellos. Preparar los datos de soporte para la IA cubre el trabajo de limpieza.
- Decida la granularidad del pronóstico. Totales diarios para la contratación mensual, por hora o por media hora para la programación. No use un solo modelo para ambos.
- Fije una línea base. Método ingenuo estacional en cada cola. Registre su MAE y su MASE. Esa es la cifra por superar.
- Añada factores. Incorpore eventos planificados, calendarios de facturación e indicadores de incidentes. Pruebe un modelo estadístico con regresores externos antes que un modelo de ML más pesado.
- Haga backtesting. Compare métodos sobre semanas reservadas, incluida al menos una semana de lanzamiento o caída. Elija por cola, no de forma global.
- Convierta a dotación. Ejecute Erlang C (o una herramienta de simulación si necesita abandono y manejo de varios contactos) por intervalo y luego divida entre (1 - shrinkage) para obtener la plantilla programada.
- Añada un margen y un ciclo intradía. Dote algo por encima de la cifra de Erlang en las horas pico y dé a los planificadores una alerta cuando el volumen real supere con claridad el pronóstico, para que puedan mover personas, ofrecer horas extra o trasladar trabajo a canales asíncronos.
- Revise cada mes. Siga el MASE, el sesgo y la tasa de cumplimiento del nivel de servicio por cola. Restablezca la línea base siempre que cambie el alcance del agente de IA.
Errores que conviene evitar
Usar solo el MAPE. Oculta el sesgo y falla en los intervalos de poco volumen. Combínelo con MAE, MASE y el error con signo.
Pronosticar solo el total de contactos. Un total plano oculta el cambio en la mezcla. Pronostique por motivo de contacto y canal.
Confiar en la cifra de Erlang como exacta. Es una estimación construida sobre supuestos que las colas reales incumplen. Mantenga un margen y vigile el abandono.
Dotar según el promedio diario. El nivel de servicio se gana o se pierde en los intervalos pico. Planifique intervalo por intervalo.
Ignorar la deriva del shrinkage. Las semanas de capacitación, la temporada de gripe y la puesta al día del personal nuevo cambian el shrinkage. Un 30% fijo en el modelo es una conjetura.
Saltarse la línea base. Si no puede demostrar que el pronóstico con IA supera al método ingenuo estacional, está pagando por complejidad. Use la decisión de automatizar o asistir para delimitar dónde se aplica la deflexión con IA antes de recortar los planes de plantilla en torno a ella.
Preguntas frecuentes sobre el pronóstico del volumen de soporte con IA
¿Qué es Erlang C en el soporte al cliente?
Erlang C es una fórmula de colas que estima cuántos agentes necesita en un intervalo para cumplir un nivel de servicio, dados el volumen de contactos y el tiempo medio de gestión. Supone llegadas de Poisson y tiempos de servicio exponenciales, e ignora el abandono y los reintentos, así que tome su resultado como punto de partida con un margen.
¿Qué tan preciso debe ser un pronóstico del volumen de soporte?
No hay una cifra universal, porque depende de lo cerca de la capacidad que opere. Cuanto más se acerque su ocupación a 100%, más daño hace un error pequeño: en una revisión muy citada, un centro planificado para una utilización de 95% que recibe 5% más de volumen termina en una utilización de 99,75%. Mida su propio error y sesgo por cola y fije objetivos a partir de ahí.
¿Qué es el shrinkage y por qué importa para la dotación?
El shrinkage es la proporción del tiempo pagado en que los agentes no están disponibles para atender contactos, por descansos, capacitación, reuniones y ausencias. NICE sitúa el shrinkage típico de un contact center entre 25% y 40%. Usted divide los agentes productivos que da Erlang C entre (1 menos el shrinkage) para obtener la plantilla que realmente necesita programar.
¿Es el machine learning mejor que los métodos simples para pronosticar el volumen de soporte?
No automáticamente. La orientación sobre pronóstico dice que los métodos nuevos deben compararse con referencias simples como el método ingenuo estacional, y un gran estudio comparativo halló que los métodos de machine learning quedaron dominados en precisión y necesitaron mucho más cómputo. El ML tiende a ayudar cuando los factores externos (lanzamientos, ciclos de facturación, incidentes) explican las oscilaciones, así que póngalo a prueba frente a la línea base cola por cola.
¿Qué medida de precisión del pronóstico debo usar?
Use más de una. El MAE es fácil de explicar, el MASE le dice si superó una referencia ingenua (por debajo de 1 significa que sí) y el MAPE es útil para comparar colas de distinto tamaño, pero falla en intervalos cercanos a cero. Siga también el error con signo, para ver si se pasa o se queda corto de forma constante.
¿Cómo cambia la deflexión con IA el pronóstico de dotación?
Reduce el volumen de contactos, pero por lo general aumenta el tiempo de gestión de los que quedan, porque los sencillos ya no están. Pronostique por separado el volumen y el tiempo de gestión por motivo de contacto, y restablezca la línea base tras cualquier cambio en el alcance del agente de IA.

Customer Success Operations Manager