Bahasa Indonesia
Peramalan AI untuk Volume dan Perencanaan Staf Dukungan
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Peramalan volume dukungan adalah praktik memprediksi berapa banyak kontak pelanggan yang akan masuk pada setiap interval (biasanya 30 menit atau satu jam), lalu mengubah prediksi itu menjadi jumlah agen yang Anda butuhkan dalam shift untuk mencapai target tingkat layanan. Ini dua pekerjaan yang direkatkan: ramalan permintaan, dan perhitungan staf yang mengubah permintaan menjadi orang. AI sebagian besar memperbaiki pekerjaan pertama. Yang kedua tetap matematika antrean klasik, dan tidak memaafkan ketika ramalannya meleset.
Itulah bagian yang cenderung terlewat oleh para manajer. Ramalan yang 5% terlalu rendah tidak menghasilkan masalah layanan 5%, melainkan bisa menghasilkan antrean yang lepas kendali. Panduan ini membahas cara kerja perhitungan staf (Erlang C dan batasannya), cara mengukur akurasi ramalan secara jujur, kapan machine learning mengungguli baseline sederhana, dan bagaimana deflection (pengalihan pertanyaan) oleh AI mengubah volume maupun komposisi sisanya. Panduan ini bagian dari koleksi AI for Customer Service, jadi gambaran umum AI dalam layanan pelanggan adalah tempat memulai untuk gambaran yang lebih luas.
Fakta Utama
- Model Erlang C mengasumsikan kedatangan Poisson, waktu layanan eksponensial, laju kedatangan konstan dalam setiap interval, dan bahwa pemblokiran, pembatalan antrean, dan percobaan ulang diabaikan (Gans, Koole dan Mandelbaum).
- Contoh dalam makalah yang sama: pusat kontak yang direncanakan untuk utilisasi 95% dan laju kedatangannya 5% lebih tinggi melihat utilisasi naik menjadi 99,75%, dan waktu tunggu meledak atau pembatalan antrean jauh melampaui rencana (Gans, Koole dan Mandelbaum).
- Shrinkage pusat kontak biasanya berkisar 25% hingga 40% dari waktu terjadwal, dengan rata-rata sekitar 30-35% (NICE).
- Panduan buku teks peramalan: tolok ukur sederhana seperti seasonal naive harus dikalahkan sebelum metode yang lebih canggih layak dipertimbangkan (Hyndman dan Athanasopoulos, FPP3).
- Dalam perbandingan besar antara metode statistik dan machine learning, metode machine learning kalah pada kedua ukuran akurasi dan semua horizon peramalan yang diperiksa, serta memerlukan komputasi jauh lebih banyak (Makridakis et al., PLOS ONE).
Dari Ramalan ke Jumlah Staf: Apa yang Dilakukan Erlang C
Erlang C adalah pekerja keras dalam perencanaan staf pusat kontak. Anda memberinya laju kedatangan, rata-rata waktu penanganan, dan target, lalu ia memberi tahu berapa agen yang Anda butuhkan pada interval itu. Tinjauan Gans, Koole dan Mandelbaum atas bidang ini menggambarkan praktik umum: jalankan model Erlang C pada setiap interval setengah jam, perlakukan masing-masing sebagai kondisi tunak, dan gunakan laju kedatangan serta waktu layanan hasil ramalan untuk mendapatkan target jumlah staf bagi periode tersebut. Angka per interval itu kemudian masuk ke model penjadwalan (Gans, Koole dan Mandelbaum).
Empat istilah mengerjakan sebagian besar tugasnya:
- Trafik (dalam Erlang) adalah beban kerja. Kontak dalam interval dikali rata-rata waktu penanganan, dibagi panjang interval. 120 kontak dengan 300 detik masing-masing dalam setengah jam 1.800 detik adalah 120 x 300 / 1.800 = 20 Erlang. Secara sederhana, Anda butuh 20 agen hanya untuk mengimbangi.
- Tingkat layanan adalah porsi kontak yang dijawab dalam ambang tertentu, misalnya 80% dalam 20 detik.
- Okupansi adalah porsi waktu agen yang dipakai untuk menangani kontak. Dengan 25 agen memikul 20 Erlang, okupansinya 20 / 25 = 80%.
- Shrinkage adalah porsi waktu berbayar ketika agen tidak tersedia: istirahat, pelatihan, rapat, ketidakhadiran. NICE mendefinisikannya sebagai jam yang hilang karena aktivitas tidak produktif dibagi total jam terjadwal, dan membaginya menjadi shrinkage internal (terencana) dan eksternal (tak terencana) (NICE).
Contoh perhitungan
Misalkan sebuah antrean memperkirakan 120 kontak dalam setengah jam, dengan rata-rata waktu penanganan 300 detik, dan Anda ingin 80% dijawab dalam 20 detik. Dengan rumus Erlang C standar, angkanya keluar seperti ini:
| Agen di antrean | Okupansi | Tingkat layanan (dijawab dalam 20 detik) | Rata-rata kecepatan menjawab |
|---|---|---|---|
| 22 | 91% | 50,3% | 85 detik |
| 23 | 87% | 66,0% | 42 detik |
| 24 | 83% | 77,2% | 22 detik |
| 25 | 80% | 85,0% | 13 detik |
| 26 | 77% | 90,4% | 7 detik |
Dua puluh empat agen tidak mencapai target, dua puluh lima melampauinya. Sekarang tambahkan shrinkage. Dengan shrinkage 30%, 25 agen produktif berarti 25 / (1 - 0,30) = 35,7, sehingga Anda akan menjadwalkan 36 orang untuk setengah jam itu.
Dan inilah risiko ramalan dalam contoh yang sama. Jika volume mendarat 5% lebih tinggi dari rencana (126 kontak, bukan 120) dan Anda menempatkan 25 agen, tingkat layanan turun dari 85,0% menjadi sekitar 76,5%. Meleset 5% pada volume membuat Anda di bawah target. Pada 24 agen, meleset 5% yang sama mendorong tingkat layanan menjadi sekitar 65%. Kurvanya curam, persis seperti yang diperingatkan makalah Gans: karena kinerja adalah fungsi konveks dari laju kedatangan, kinerja aktual di bawah ramalan yang tidak pasti biasanya lebih buruk daripada rencana, bukan sama dengannya (Gans, Koole dan Mandelbaum).
Di Mana Erlang C Gagal
Erlang C adalah model, dan model itu punya batas yang sudah diketahui. Daftar dari tinjauan itu sendiri yang perlu disimpan: laju konstan dalam interval, kedatangan Poisson, waktu layanan eksponensial, serta pemblokiran, pembatalan antrean, dan percobaan ulang yang diabaikan (Gans, Koole dan Mandelbaum). Dalam praktik, artinya:
- Tanpa pembatalan antrean. Erlang C berpura-pura setiap pelanggan menunggu selama yang dibutuhkan. Pelanggan nyata menutup telepon atau menutup chat. Tinjauan yang sama mencatat bahwa tanpa pembatalan antrean, laju kedatangan di atas kapasitas membuat antrean tumbuh tanpa batas, sedangkan model yang memasukkan pembatalan antrean tetap stabil dan memungkinkan Anda menukar kapasitas dengan pembatalan dan penundaan.
- Laju kedatangan yang diketahui. Ia memperlakukan ramalan sebagai kebenaran. Seperti diungkapkan makalah itu, laju kedatangan diprediksi dari data historis dan tidak diketahui dengan pasti, dan mengabaikannya bisa berisiko.
- Satu kontak dalam satu waktu. Rumus klasik cocok untuk kanal berkontak tunggal seperti telepon. Agen chat dan pesan menangani beberapa percakapan sekaligus, dan email bersifat asinkron, sehingga tim biasanya menyesuaikan dengan faktor konkurensi atau memakai model lain. Anggap tabel di atas sebagai kasus suara.
- Agen yang identik. Karyawan baru dan veteran tidak menangani kontak dengan kecepatan yang sama, dan waktu penanganan bergeser menurut komposisi topik.
Semua ini tidak membuat Erlang C tak berguna. Ini menjadikannya perkiraan awal yang baik yang memerlukan penyangga dan putaran umpan balik. Banyak tim menambahkan margin pengaman di atas angka Erlang, dan pekerjaan peramalan terbaik berfokus mengecilkan ketidakpastian yang harus ditutup margin itu.
Mengukur Akurasi Ramalan
Sebelum membandingkan metode ramalan apa pun, sepakati ukurannya. Hyndman dan Athanasopoulos mendefinisikan ukuran standar dalam Forecasting: Principles and Practice (FPP3):
| Ukuran | Apa itu | Bagus untuk | Waspadai |
|---|---|---|---|
| MAE | Rata-rata galat absolut, dalam jumlah kontak | Mudah dijelaskan kepada pemimpin operasi | Bergantung pada skala, sehingga antrean kecil tidak bisa dibandingkan dengan yang besar |
| RMSE | Akar dari rata-rata galat kuadrat | Menghukum meleset yang besar | Juga bergantung pada skala; lebih sulit ditafsirkan |
| MAPE | Rata-rata galat persentase absolut | Membandingkan antrean berukuran berbeda | Tidak terdefinisi ketika volume aktual nol dan ekstrem di dekat nol, seperti setengah jam di malam hari; menghukum galat negatif lebih berat daripada galat positif |
| MASE | Galat yang diskalakan terhadap tolok ukur naif | Membandingkan metode apa pun dengan baseline dalam satu angka | Kurang dikenal oleh non-analis |
Dua konsekuensi praktis. Pertama, MAPE berperilaku buruk pada interval yang justru banyak dimiliki tim dukungan: slot malam yang sepi dengan segelintir kontak. Laporkan MAPE pada total harian atau per jam, dan gunakan MAE atau MASE pada tingkat setengah jam. Kedua, FPP3 mendefinisikan MASE sehingga nilai di bawah 1 berarti Anda mengalahkan tolok ukur pada data latih, dan untuk deret musiman tolok ukur itu adalah metode seasonal naive (FPP3). Itulah angka yang disodorkan kepada pemimpin WFM Anda: "apakah kita lebih baik daripada pola minggu lalu yang diulang?"
Ukur juga bias, bukan hanya galat. Ramalan yang 8% terlalu tinggi satu hari dan 8% terlalu rendah hari berikutnya memiliki MAE yang sama dengan yang selalu 8% terlalu tinggi, tetapi yang kedua adalah masalah kelebihan staf yang sistematis. Lacak juga galat bertanda.
Kapan Machine Learning Mengalahkan Baseline Sederhana
Mulailah dengan baseline. Metode seasonal naive dari FPP3 menetapkan setiap ramalan sebagai nilai terakhir yang teramati dari musim yang sama (Selasa ini pukul 10:00 tampak seperti Selasa lalu pukul 10:00), dan pendirian buku itu adalah bahwa metode semacam itu berfungsi sebagai tolok ukur, dan metode baru yang tidak bisa mengalahkannya tidak layak dipertimbangkan (FPP3). Untuk antrean stabil dengan ritme mingguan yang kuat, seasonal naive atau model statistik klasik sering sulit dikalahkan. Studi besar atas metode statistik dan machine learning menemukan metode ML kalah dalam akurasi di berbagai horizon, sambil memerlukan komputasi jauh lebih banyak (Makridakis et al., PLOS ONE). Perlakukan klaim vendor tentang "peramalan bertenaga AI" dengan hasil itu dalam benak.
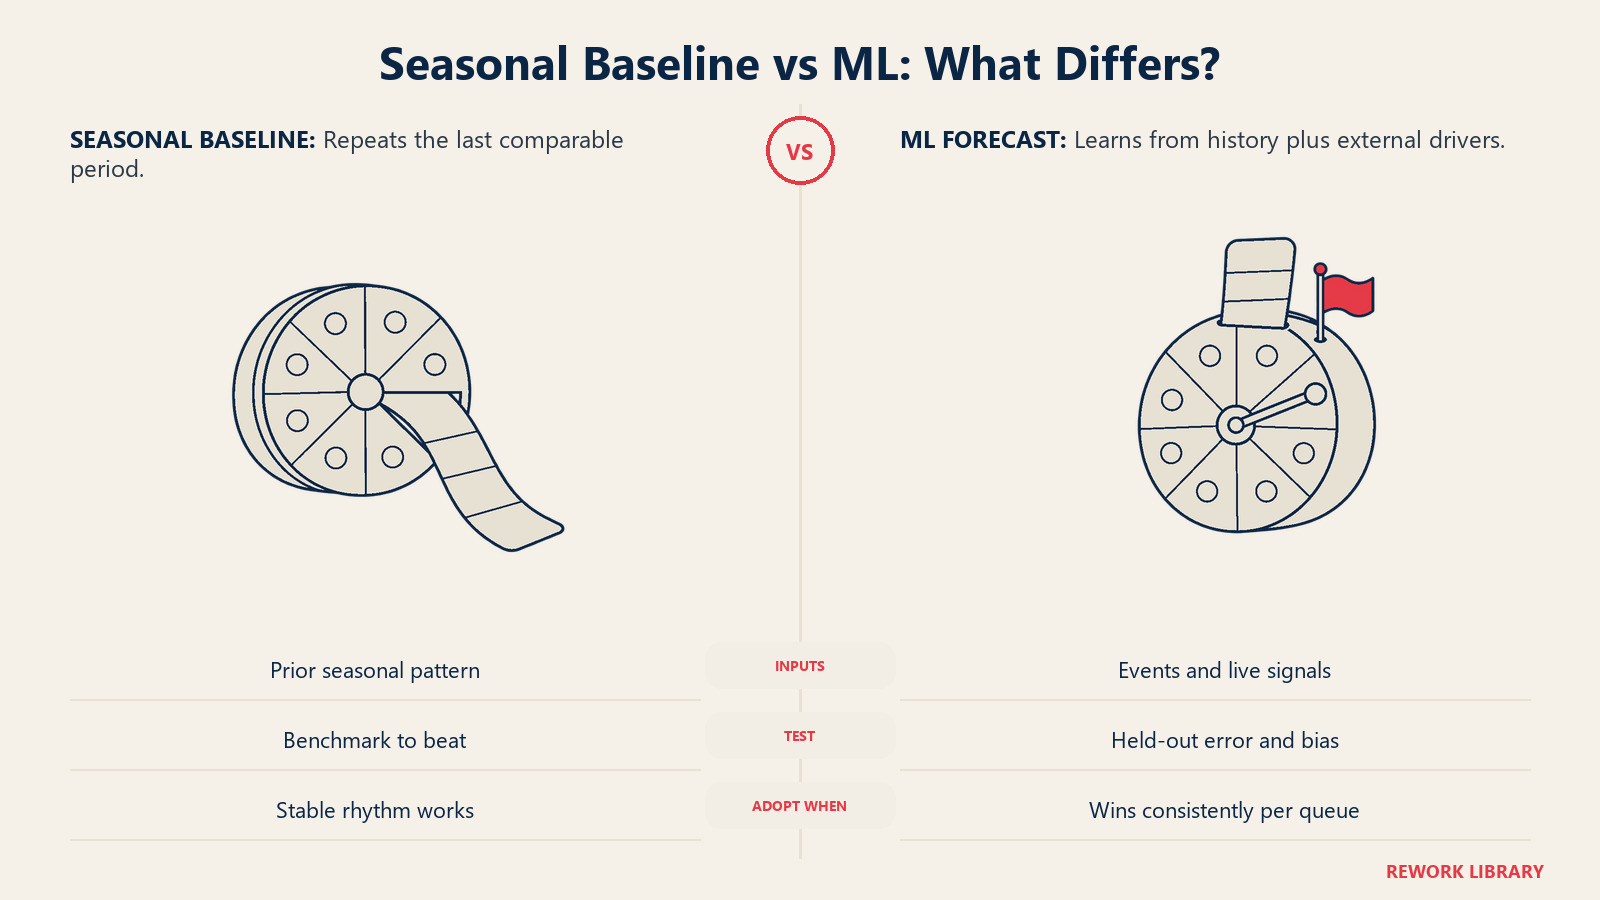
Jadi di mana ML layak dipakai? Di tempat riwayat saja tidak cukup, dan sinyal dari luar menjelaskan ayunannya:
- Pemicu yang diketahui. Rilis produk, proses penagihan, kiriman pemasaran, gangguan, dan perubahan harga menciptakan volume yang tak bisa diprediksi pola minggu lalu. Model ML dapat menerimanya sebagai masukan (kalender peristiwa terencana, penanda insiden, jumlah pelanggan yang baru ditagih).
- Banyak antrean sekaligus. Jika Anda meramal menurut bahasa, tier, dan kanal, model yang mempelajari pola bersama lintas deret dapat membantu deret yang tipis, tempat setiap deret hanya punya sedikit riwayat.
- Koreksi intrahari. Model yang memantau beberapa jam pertama hari ini dan meramal ulang sisanya dapat menangkap lonjakan lebih awal. Ini pola deteksi anomali: serap aliran langsung, bandingkan dengan baseline, tandai pencilan, dan beri tahu perencana.
- Alasan kontak. Jika deteksi intent menandai setiap kontak menurut alasannya, Anda bisa meramal "sengketa faktur" dan "reset kata sandi" secara terpisah, yang jauh lebih berguna daripada satu total.
Cara yang masuk akal untuk memutuskan: jalankan baseline dan model ML berdampingan pada setidaknya beberapa minggu data uji yang disisihkan, bandingkan dengan MASE, dan adopsi ML hanya di tempat ia menang secara konsisten, bukan rata-rata. Model yang menang pada minggu biasa dan kalah pada minggu yang penting (peluncuran, gangguan) tidak membantu.
Bagaimana Deflection AI Mengubah Volume dan Komposisi
Begitu agen AI menyelesaikan sebagian lalu lintas masuk Anda, riwayat Anda berhenti menggambarkan masa depan Anda. Dua hal berubah.
Volume turun, tetapi tidak satu banding satu. Jika AI menangani sebagian percakapan, antrean manusia melihat lebih sedikit kontak. Tetapi itu bergantung pada cara Anda menghitung penyelesaian. Tertampung tidak sama dengan terselesaikan, dan pelanggan yang tidak terbantu kembali lewat kanal lain, sering sebagai kontak berulang.
Komposisinya jadi lebih sulit. Kontak yang mudah pergi lebih dulu: reset kata sandi, status pesanan, pertanyaan cara-pakai sederhana. Yang tersisa lebih panjang, lebih kompleks, dan lebih emosional, sehingga rata-rata waktu penanganan naik. Ambil lagi contoh perhitungan tadi dan misalkan AI menghapus 30% volume (120 kontak menjadi 84) sementara kontak yang tersisa memakan waktu 30% lebih lama (390 detik, bukan 300). Beban kerjanya 84 x 390 / 1.800 = 18,2 Erlang, dan target 80/20 membutuhkan 23 agen. Itu dua lebih sedikit dari 25, pengurangan agen 8% untuk pengurangan kontak 30%. Dengan shrinkage 30%, itu sekitar 33 terjadwal, bukan 36.
Intinya: ramalkan volume dan waktu penanganan secara terpisah, menurut alasan kontak. Latih ulang atau tetapkan ulang baseline setelah setiap peluncuran atau perubahan pada agen AI, karena riwayat sebelum peluncuran kini adalah sistem yang berbeda. Dan ketika agen mendapat alat seperti AI agent assist yang mempersingkat waktu penanganan pada kontak yang tersisa, itu muncul di AHT, bukan di volume, jadi tetap lacak sebagai masukan tersendiri.
Cara Membangunnya, Langkah demi Langkah
- Tarik riwayat yang bersih. Setidaknya satu tahun jumlah kontak per interval, kanal, dan alasan kontak, ditambah waktu penanganan. Tandai gangguan, peluncuran, dan hari libur agar model dapat belajar darinya. Menyiapkan data dukungan untuk AI membahas pekerjaan pembersihannya.
- Tentukan granularitas ramalan. Total harian untuk perekrutan bulanan, per jam atau per setengah jam untuk penjadwalan. Jangan pakai satu model untuk keduanya.
- Tetapkan baseline. Seasonal naive pada setiap antrean. Catat MAE dan MASE-nya. Itulah angka yang harus dikalahkan.
- Tambahkan pemicu. Masukkan peristiwa terencana, kalender penagihan, dan penanda insiden. Cobalah model statistik dengan regresor eksternal sebelum model ML yang lebih berat.
- Lakukan backtest. Bandingkan metode pada minggu data uji yang disisihkan, termasuk setidaknya satu minggu peluncuran atau gangguan. Pilih per antrean, bukan secara global.
- Konversi ke jumlah staf. Jalankan Erlang C (atau alat simulasi jika Anda memerlukan penanganan pembatalan antrean dan multikontak) per interval, lalu bagi dengan (1 - shrinkage) untuk jumlah staf terjadwal.
- Tambahkan penyangga dan putaran intrahari. Tempatkan staf sedikit di atas angka Erlang pada jam puncak, dan beri perencana peringatan ketika volume aktual berjalan jauh di atas ramalan agar mereka bisa memindahkan orang, menawarkan lembur, atau menggeser pekerjaan ke kanal asinkron.
- Tinjau setiap bulan. Lacak MASE, bias, dan tingkat ketercapaian tingkat layanan per antrean. Tetapkan ulang baseline setiap kali cakupan agen AI berubah.
Jebakan yang Perlu Dihindari
Memakai MAPE saja. Ia menyembunyikan bias dan gagal pada interval bervolume rendah. Padukan dengan MAE, MASE, dan galat bertanda.
Meramal hanya total kontak. Total yang datar menyembunyikan pergeseran komposisi. Ramalkan menurut alasan kontak dan kanal.
Memercayai angka Erlang sebagai persis. Itu perkiraan yang dibangun di atas asumsi yang dilanggar antrean nyata. Pertahankan penyangga dan awasi pembatalan antrean.
Menempatkan staf menurut rata-rata harian. Tingkat layanan dimenangkan atau hilang pada interval puncak. Rencanakan interval demi interval.
Mengabaikan pergeseran shrinkage. Minggu pelatihan, musim flu, dan masa adaptasi karyawan baru mengubah shrinkage. Angka tetap 30% dalam model hanyalah tebakan.
Melewatkan baseline. Jika Anda tak bisa menunjukkan bahwa ramalan AI mengalahkan seasonal naive, Anda membayar kerumitan. Gunakan keputusan otomatisasi atau bantu untuk membatasi di mana deflection AI berlaku sebelum Anda memangkas rencana jumlah staf di sekitarnya.
Pertanyaan yang Sering Diajukan tentang Peramalan Volume Dukungan AI
Apa itu Erlang C dalam dukungan pelanggan?
Erlang C adalah rumus antrean yang memperkirakan berapa agen yang Anda butuhkan dalam suatu interval untuk mencapai tingkat layanan, dengan volume kontak dan rata-rata waktu penanganan tertentu. Ia mengasumsikan kedatangan Poisson dan waktu layanan eksponensial, dan mengabaikan pembatalan antrean serta percobaan ulang, jadi anggap jawabannya titik awal dengan penyangga.
Seberapa akurat ramalan volume dukungan yang diperlukan?
Tidak ada angka universal, karena bergantung pada seberapa dekat Anda beroperasi dengan kapasitas. Semakin dekat okupansi Anda ke 100%, semakin besar kerugian akibat meleset kecil: dalam tinjauan yang banyak dikutip, pusat kontak yang direncanakan untuk utilisasi 95% dan mendapat volume 5% lebih banyak berakhir pada utilisasi 99,75%. Ukur galat dan bias Anda sendiri per antrean dan tetapkan target dari situ.
Apa itu shrinkage dan mengapa penting untuk perencanaan staf?
Shrinkage adalah porsi waktu berbayar ketika agen tidak tersedia untuk menangani kontak, karena istirahat, pelatihan, rapat, dan ketidakhadiran. NICE menyebut shrinkage pusat kontak yang lazim sebesar 25% hingga 40%. Anda membagi agen produktif yang diberikan Erlang C dengan (1 dikurangi shrinkage) untuk mendapatkan jumlah staf yang benar-benar perlu dijadwalkan.
Apakah machine learning lebih baik daripada metode sederhana untuk meramal volume dukungan?
Tidak otomatis. Panduan peramalan menyatakan metode baru harus dibandingkan dengan tolok ukur sederhana seperti seasonal naive, dan studi perbandingan besar menemukan metode machine learning kalah dalam akurasi sambil memerlukan komputasi jauh lebih banyak. ML cenderung membantu ketika pemicu dari luar (peluncuran, proses penagihan, insiden) menjelaskan ayunannya, jadi ujilah terhadap baseline antrean demi antrean.
Ukuran akurasi ramalan mana yang sebaiknya saya gunakan?
Gunakan lebih dari satu. MAE mudah dijelaskan, MASE memberi tahu apakah Anda mengalahkan tolok ukur naif (di bawah 1 berarti ya), dan MAPE berguna untuk membandingkan antrean berukuran berbeda tetapi gagal pada interval mendekati nol. Lacak juga galat bertanda, agar Anda bisa melihat apakah Anda konsisten terlalu tinggi atau terlalu rendah.
Bagaimana deflection AI mengubah ramalan jumlah staf?
Ia menurunkan volume kontak tetapi biasanya menaikkan waktu penanganan pada kontak yang tersisa, karena yang sederhana sudah hilang. Ramalkan volume dan waktu penanganan secara terpisah menurut alasan kontak, dan tetapkan ulang baseline setelah setiap perubahan cakupan agen AI.

Customer Success Operations Manager
On this page
- Fakta Utama
- Dari Ramalan ke Jumlah Staf: Apa yang Dilakukan Erlang C
- Contoh perhitungan
- Di Mana Erlang C Gagal
- Mengukur Akurasi Ramalan
- Kapan Machine Learning Mengalahkan Baseline Sederhana
- Bagaimana Deflection AI Mengubah Volume dan Komposisi
- Cara Membangunnya, Langkah demi Langkah
- Jebakan yang Perlu Dihindari